A Interactive Multimodal Information Retrieval System for BUPT Information and Knowledge Acquisition (2025 Spring)
Python
1
3 commits
updated Jun 30, 2025
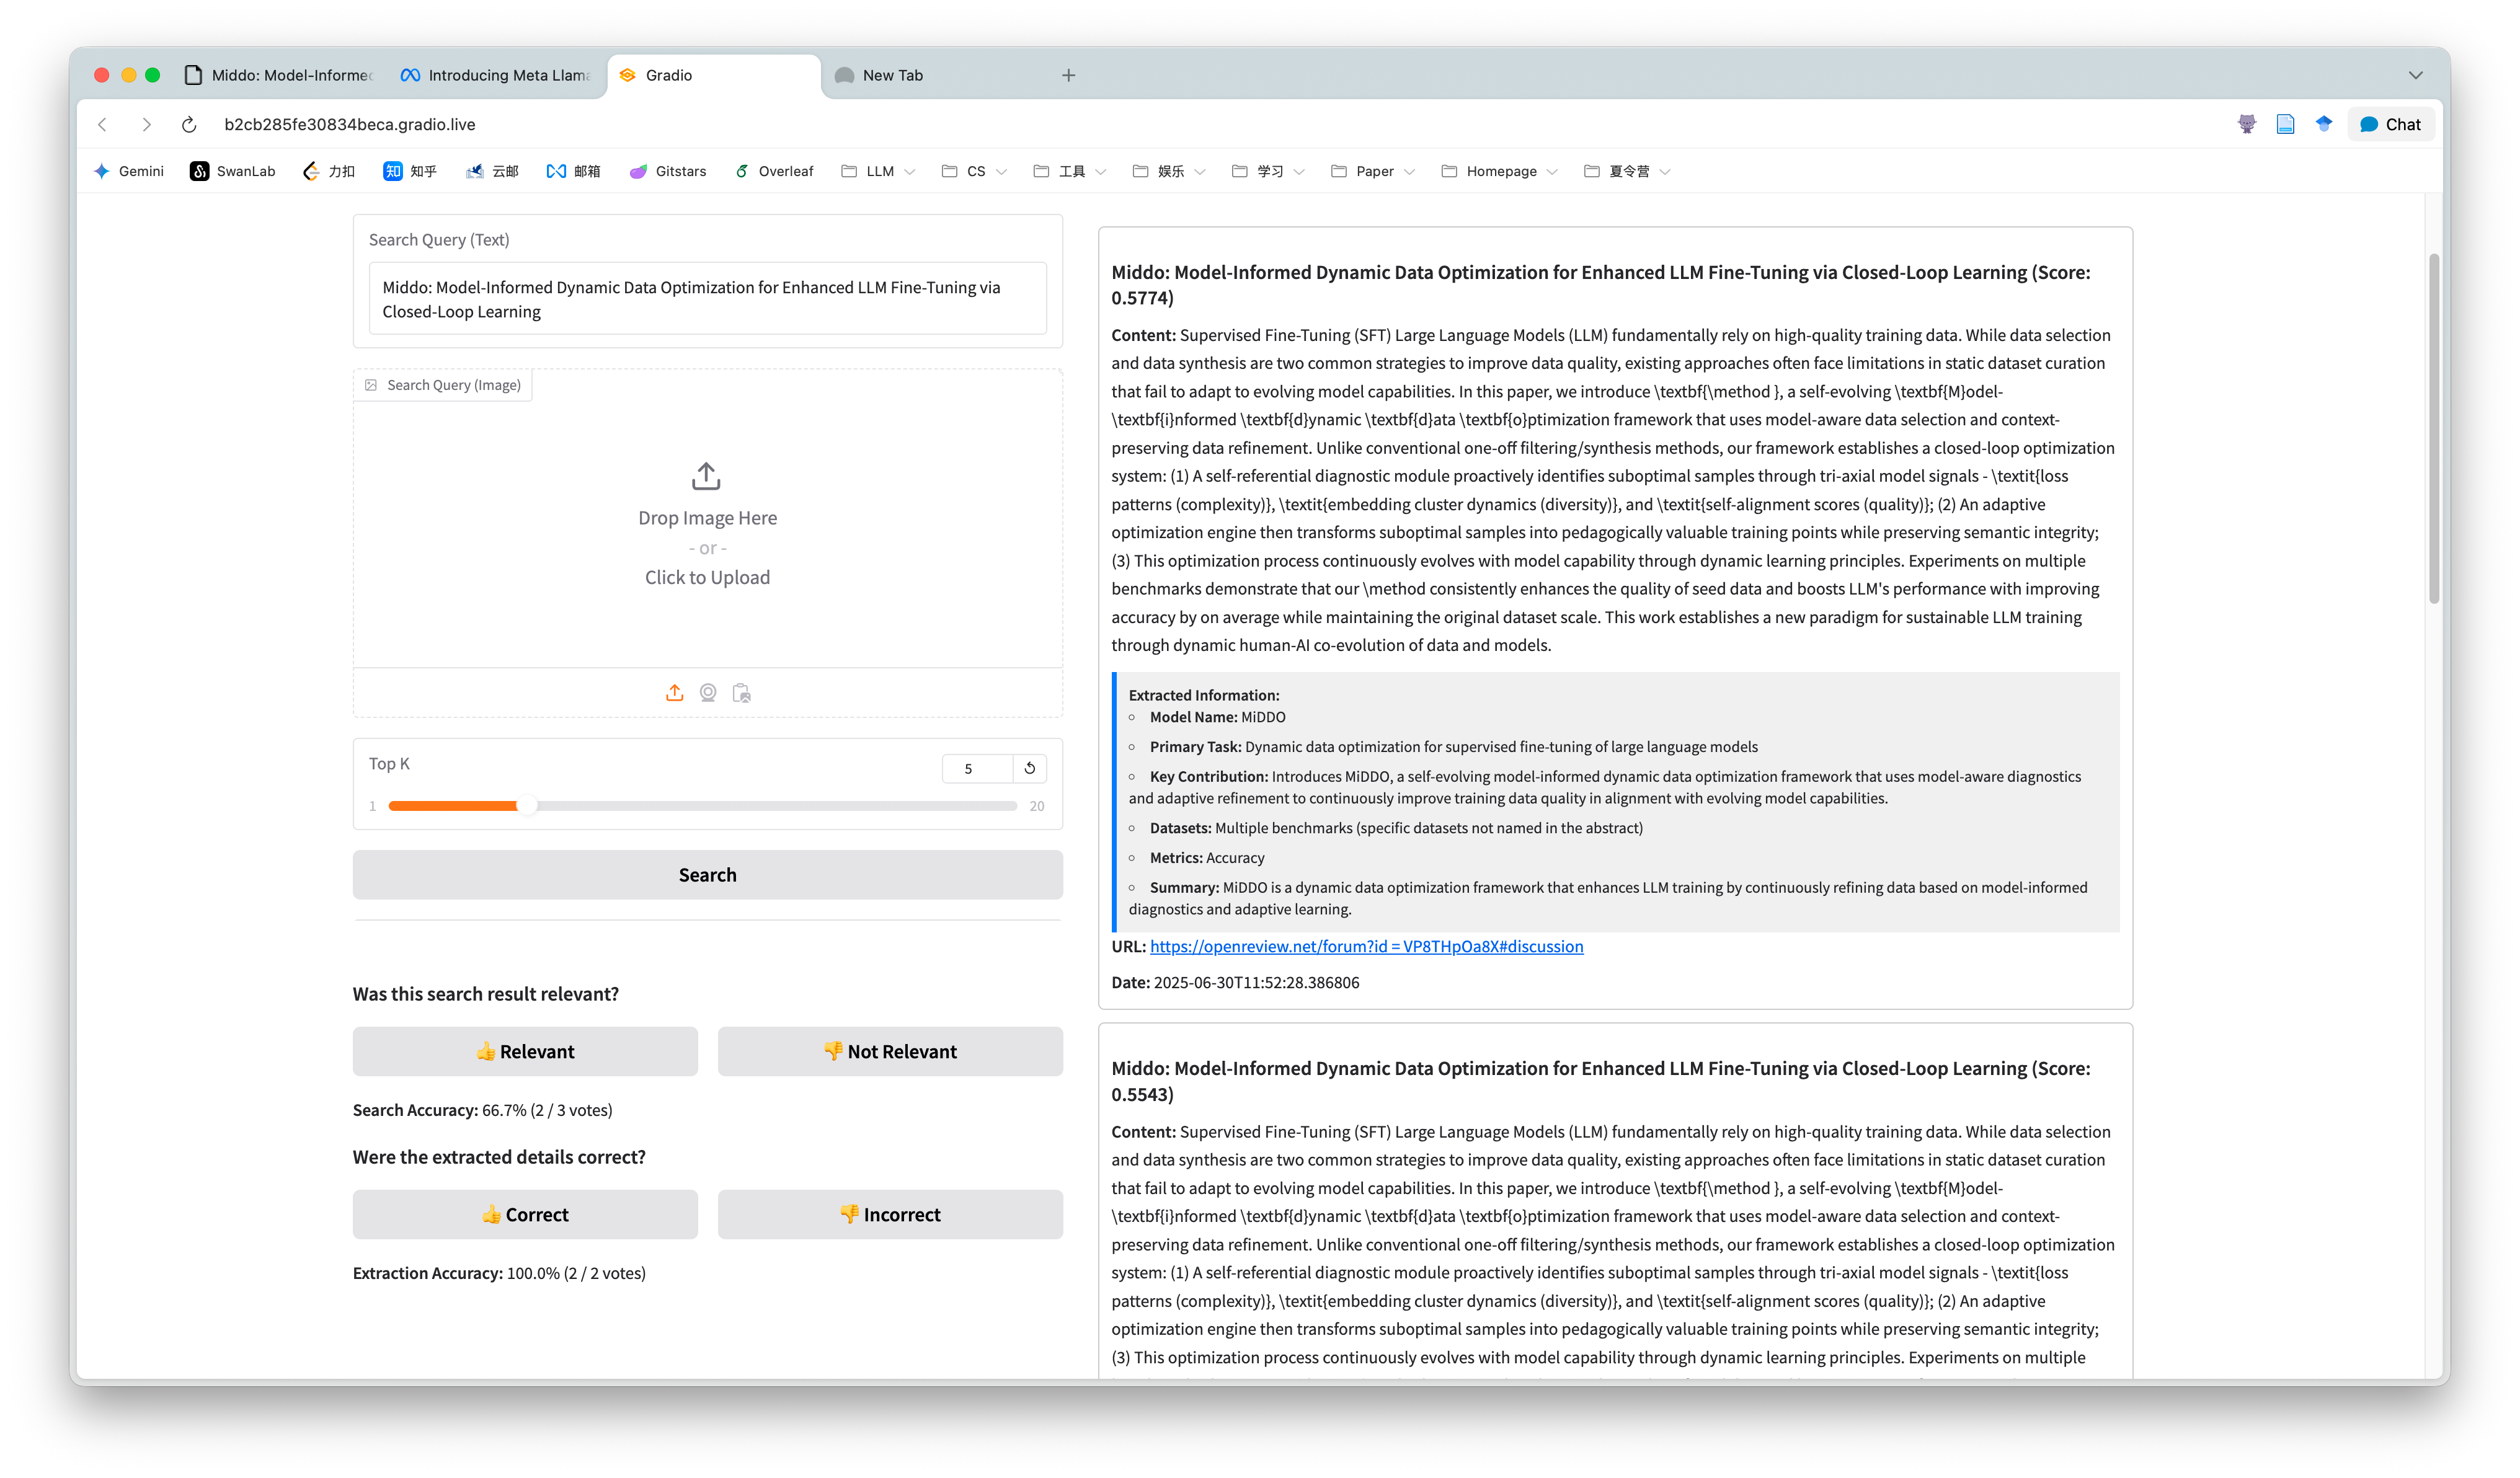
这是一个基于GME-Qwen2-VL大型视觉语言模型构建的交互式多模态信息检索系统。它支持对文本、图像以及图文混合内容进行统一的语义检索,并集成了基于GPT-4o的智能信息抽取和多维度评估功能。
Gradio 构建,操作直观方便。ChromaDB 存储和检索由 GME-Qwen2-VL 模型生成的向量嵌入。本次重大更新为系统引入了"理解与分析"的能力,核心内容如下:
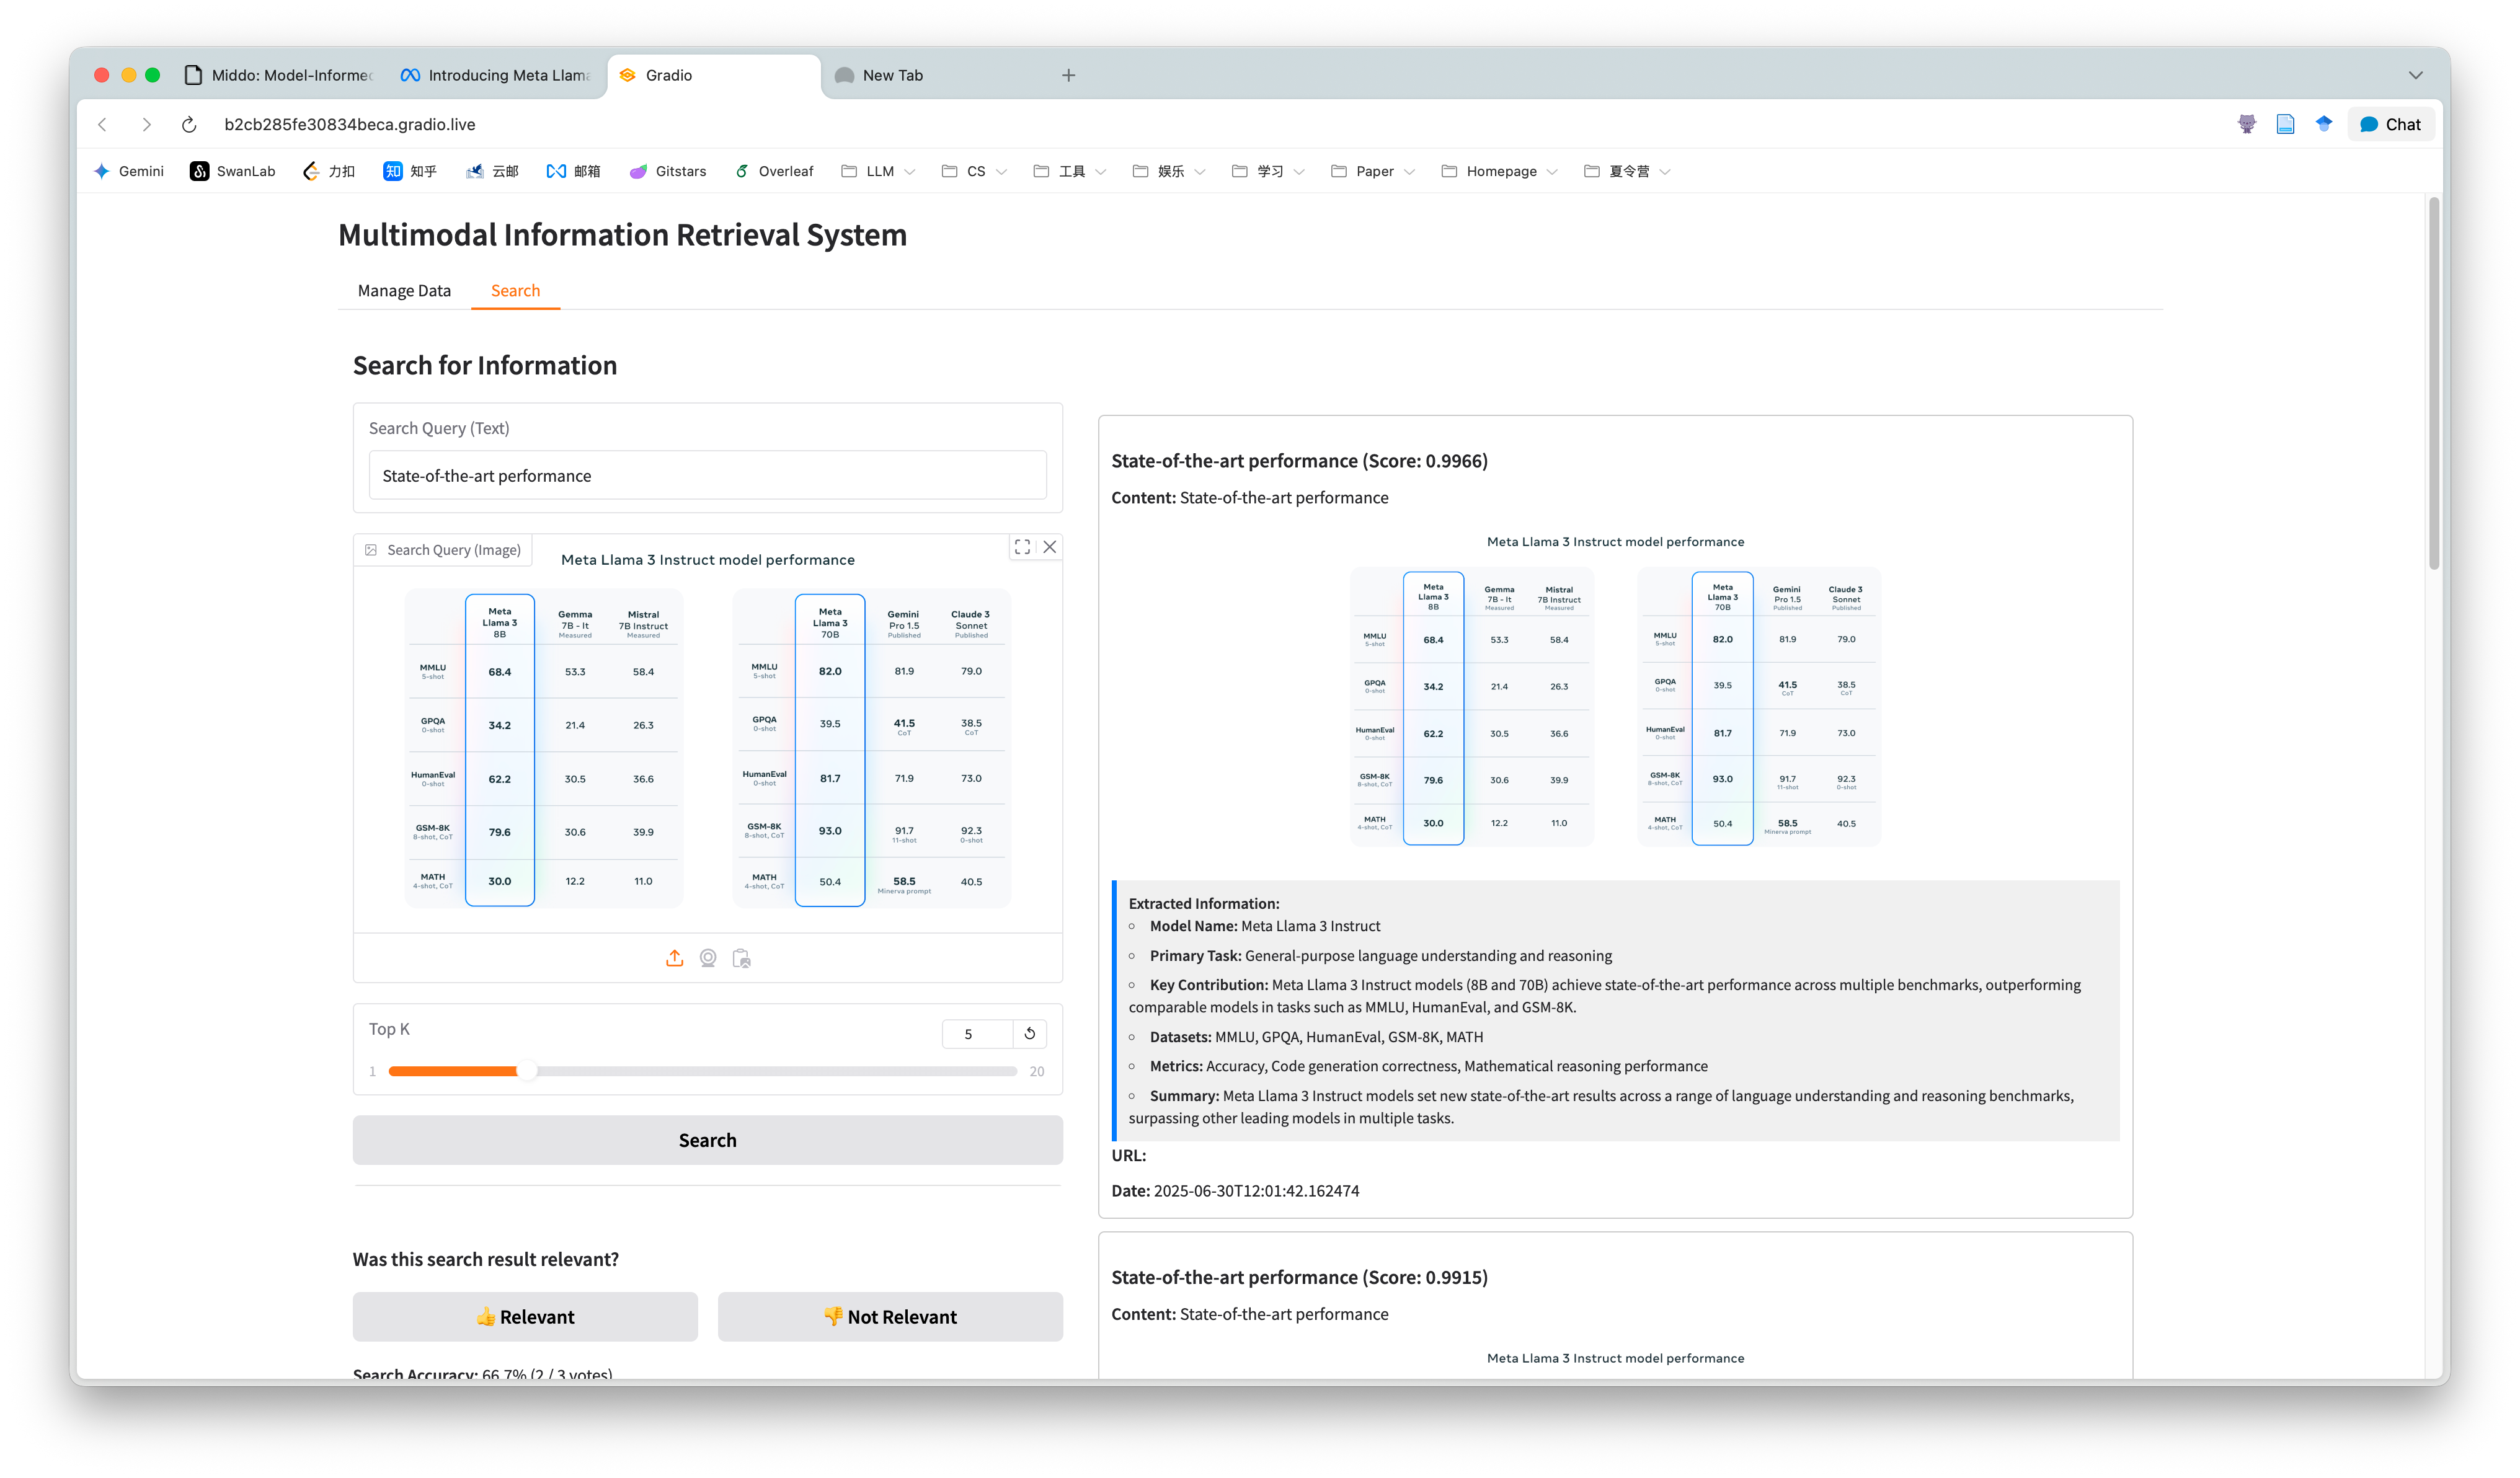
集成了基于GPT-4o的信息抽取功能:
openai_extractor.py: 专门用于调用大模型API,内置了包含Schema验证和重试机制的健壮逻辑。新增了对信息抽取的评价体系:
search_feedback.json 和 extraction_feedback.json 文件中,互不干扰。增加了批量处理脚本:
import_data.py: 用于从一个大的JSON文件批量导入数据到系统中。backfill_data.py: 一个支持并发和强制刷新功能的强大脚本,用于为数据库中所有已存在的"老数据"追补和更新其信息抽取结果。Alibaba-NLP/gme-Qwen2-VL-7B-Instruct, gpt-4o-latestGradio, PyTorch, Transformers, accelerateChromaDBOpenAI, Pillow, Numpy克隆仓库
# git clone <repository-url>
# cd <repository-name>
创建虚拟环境并安装依赖
# 建议使用conda或venv创建虚拟环境
# conda create -n rag_env python=3.10
# conda activate rag_env
pip install -r requirements.txt
设置OpenAI API Key 信息抽取功能需要使用OpenAI的API。请在您的环境中设置环境变量:
export OPENAI_API_KEY='your_openai_api_key'
您也可以在 app.py 和 backfill_data.py 等文件的顶部直接修改API Key和Base URL。
硬件要求
GmeQwen2-VL-7B-Instruct 模型,该模型参数量为70亿,推荐在高性能的NVIDIA GPU(例如 A100 / A800)上运行以获得最佳体验。启动应用 在终端中运行以下命令:
python app.py
访问界面
程序启动后,会输出一个本地URL (通常是 http://127.0.0.1:10099 或 http://0.0.0.0:10099)。在浏览器中打开此地址即可访问系统。
功能介绍
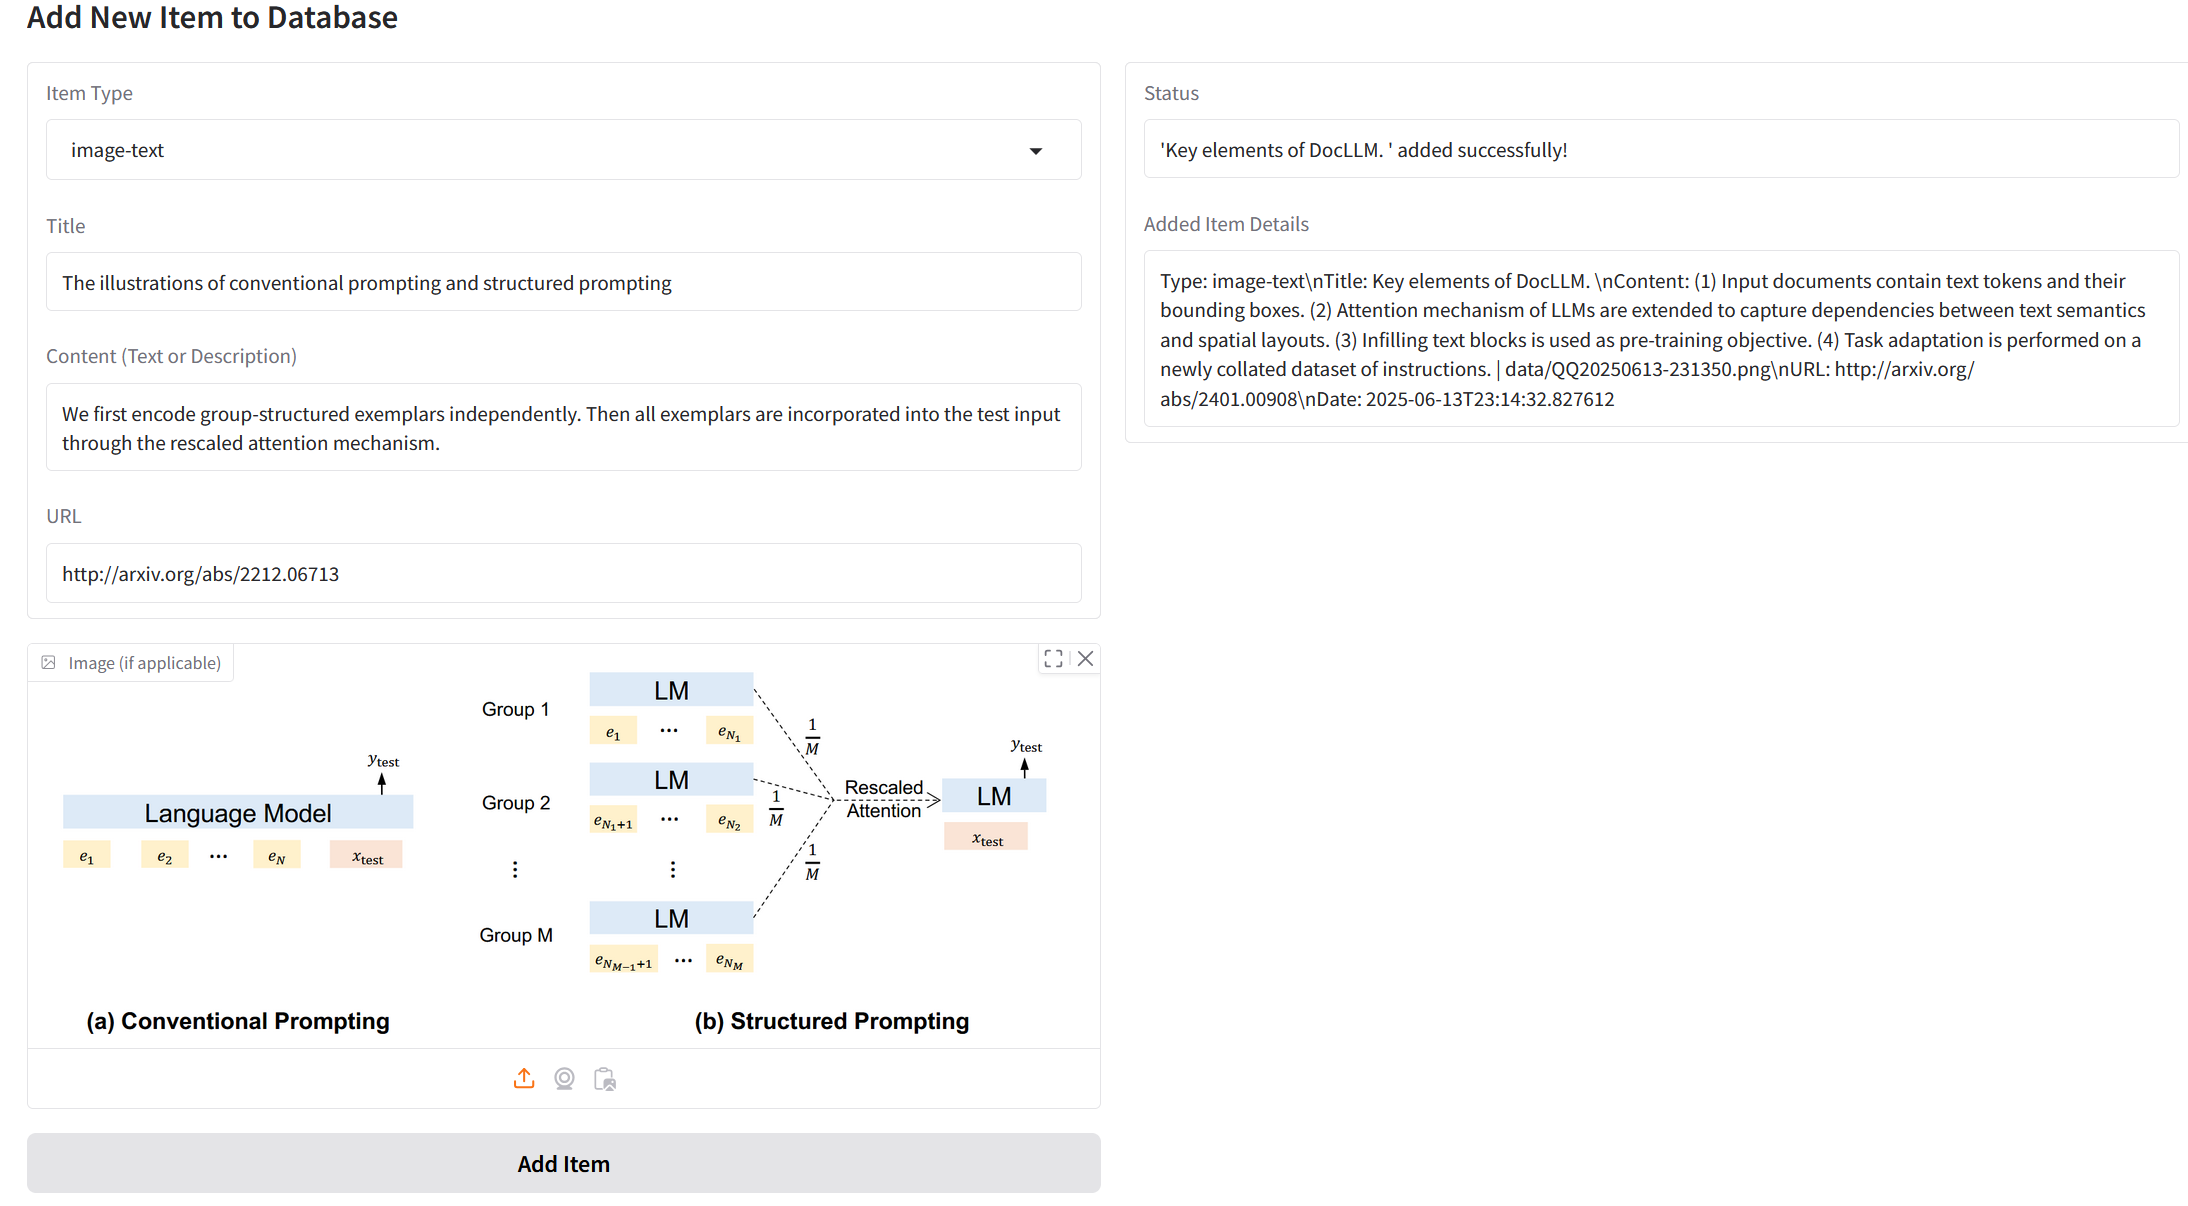
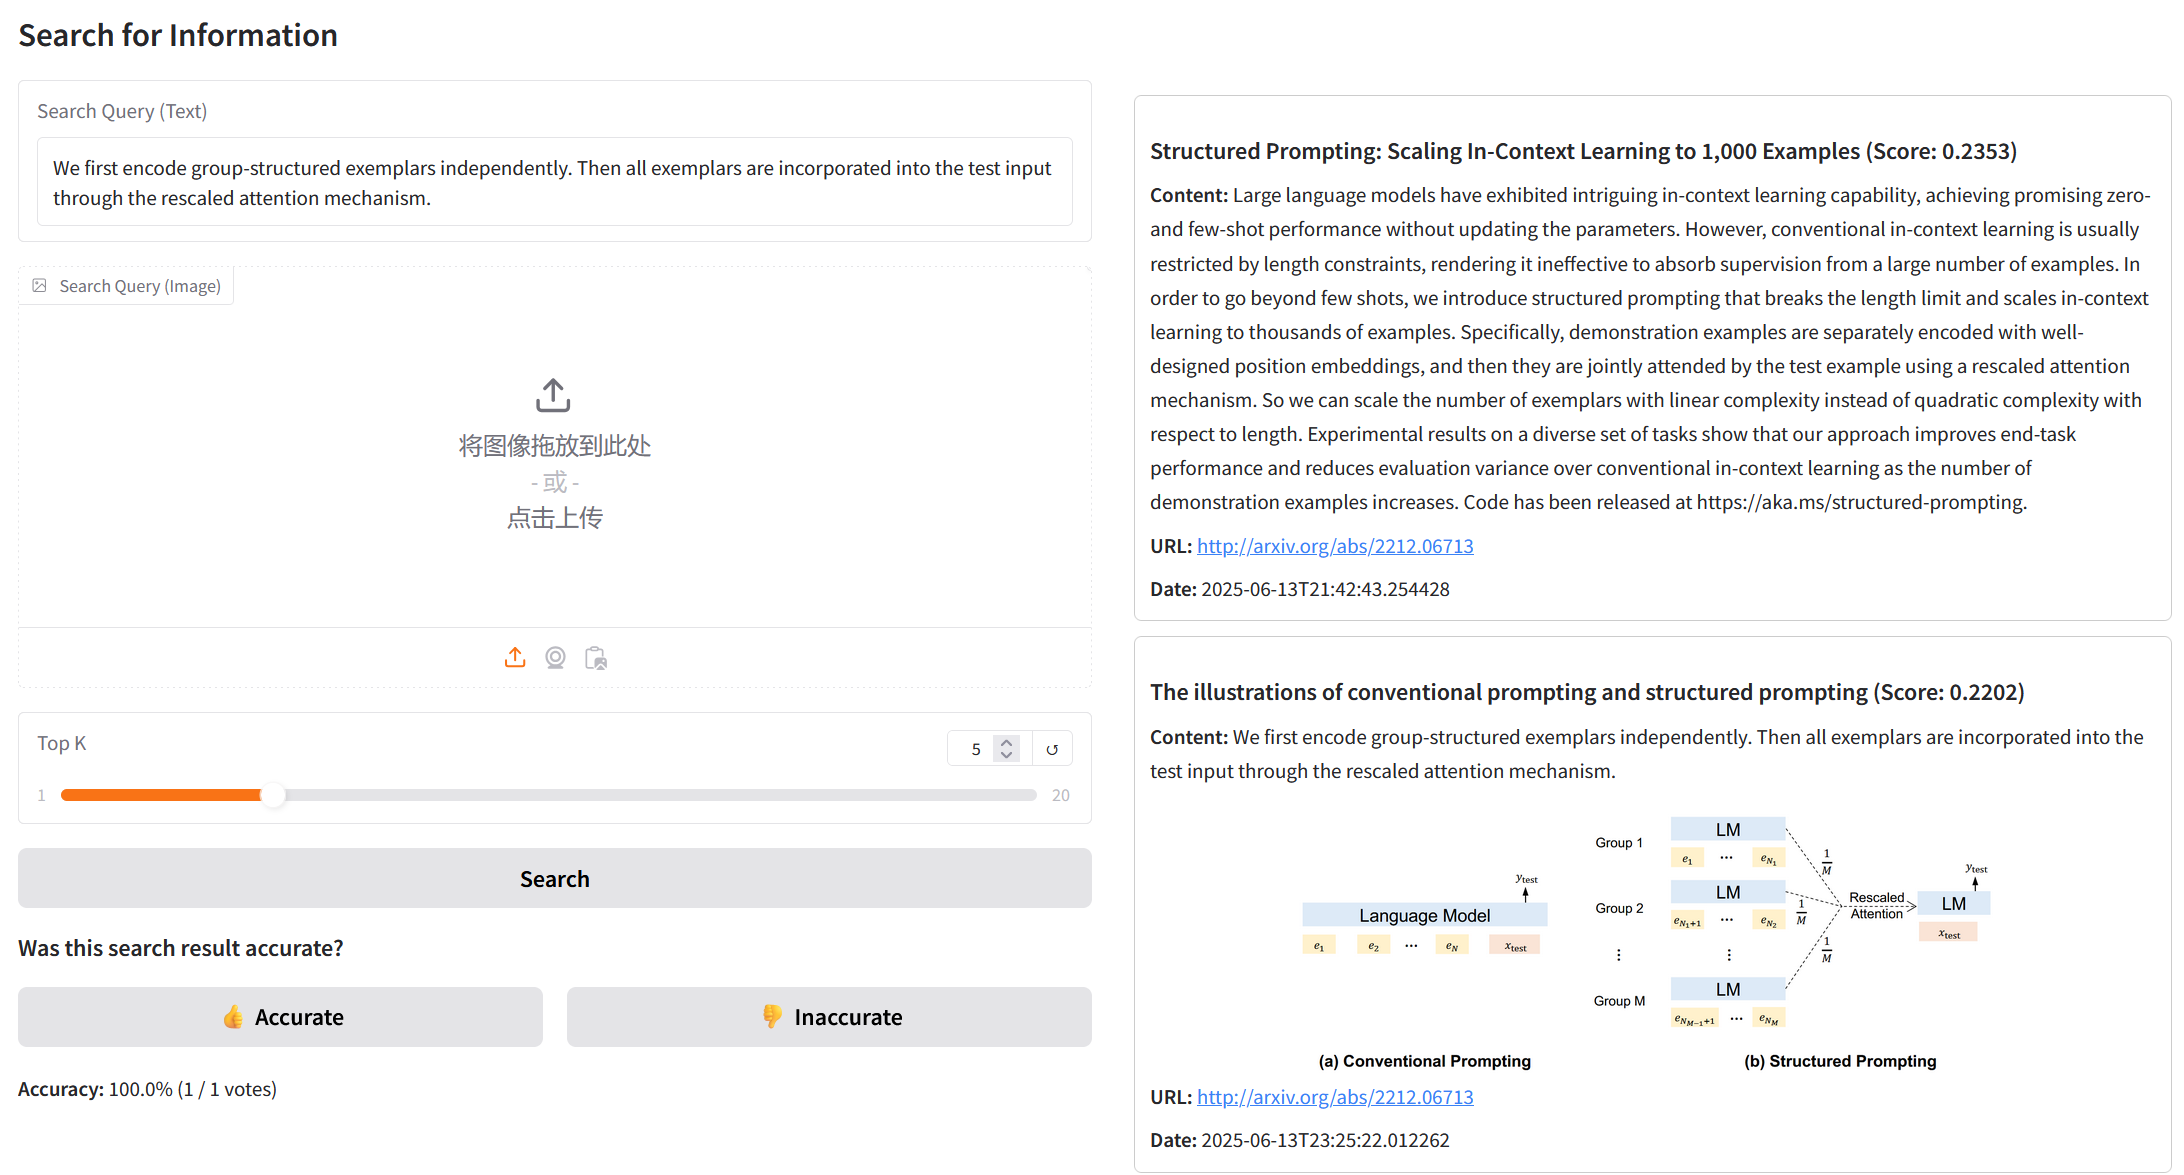
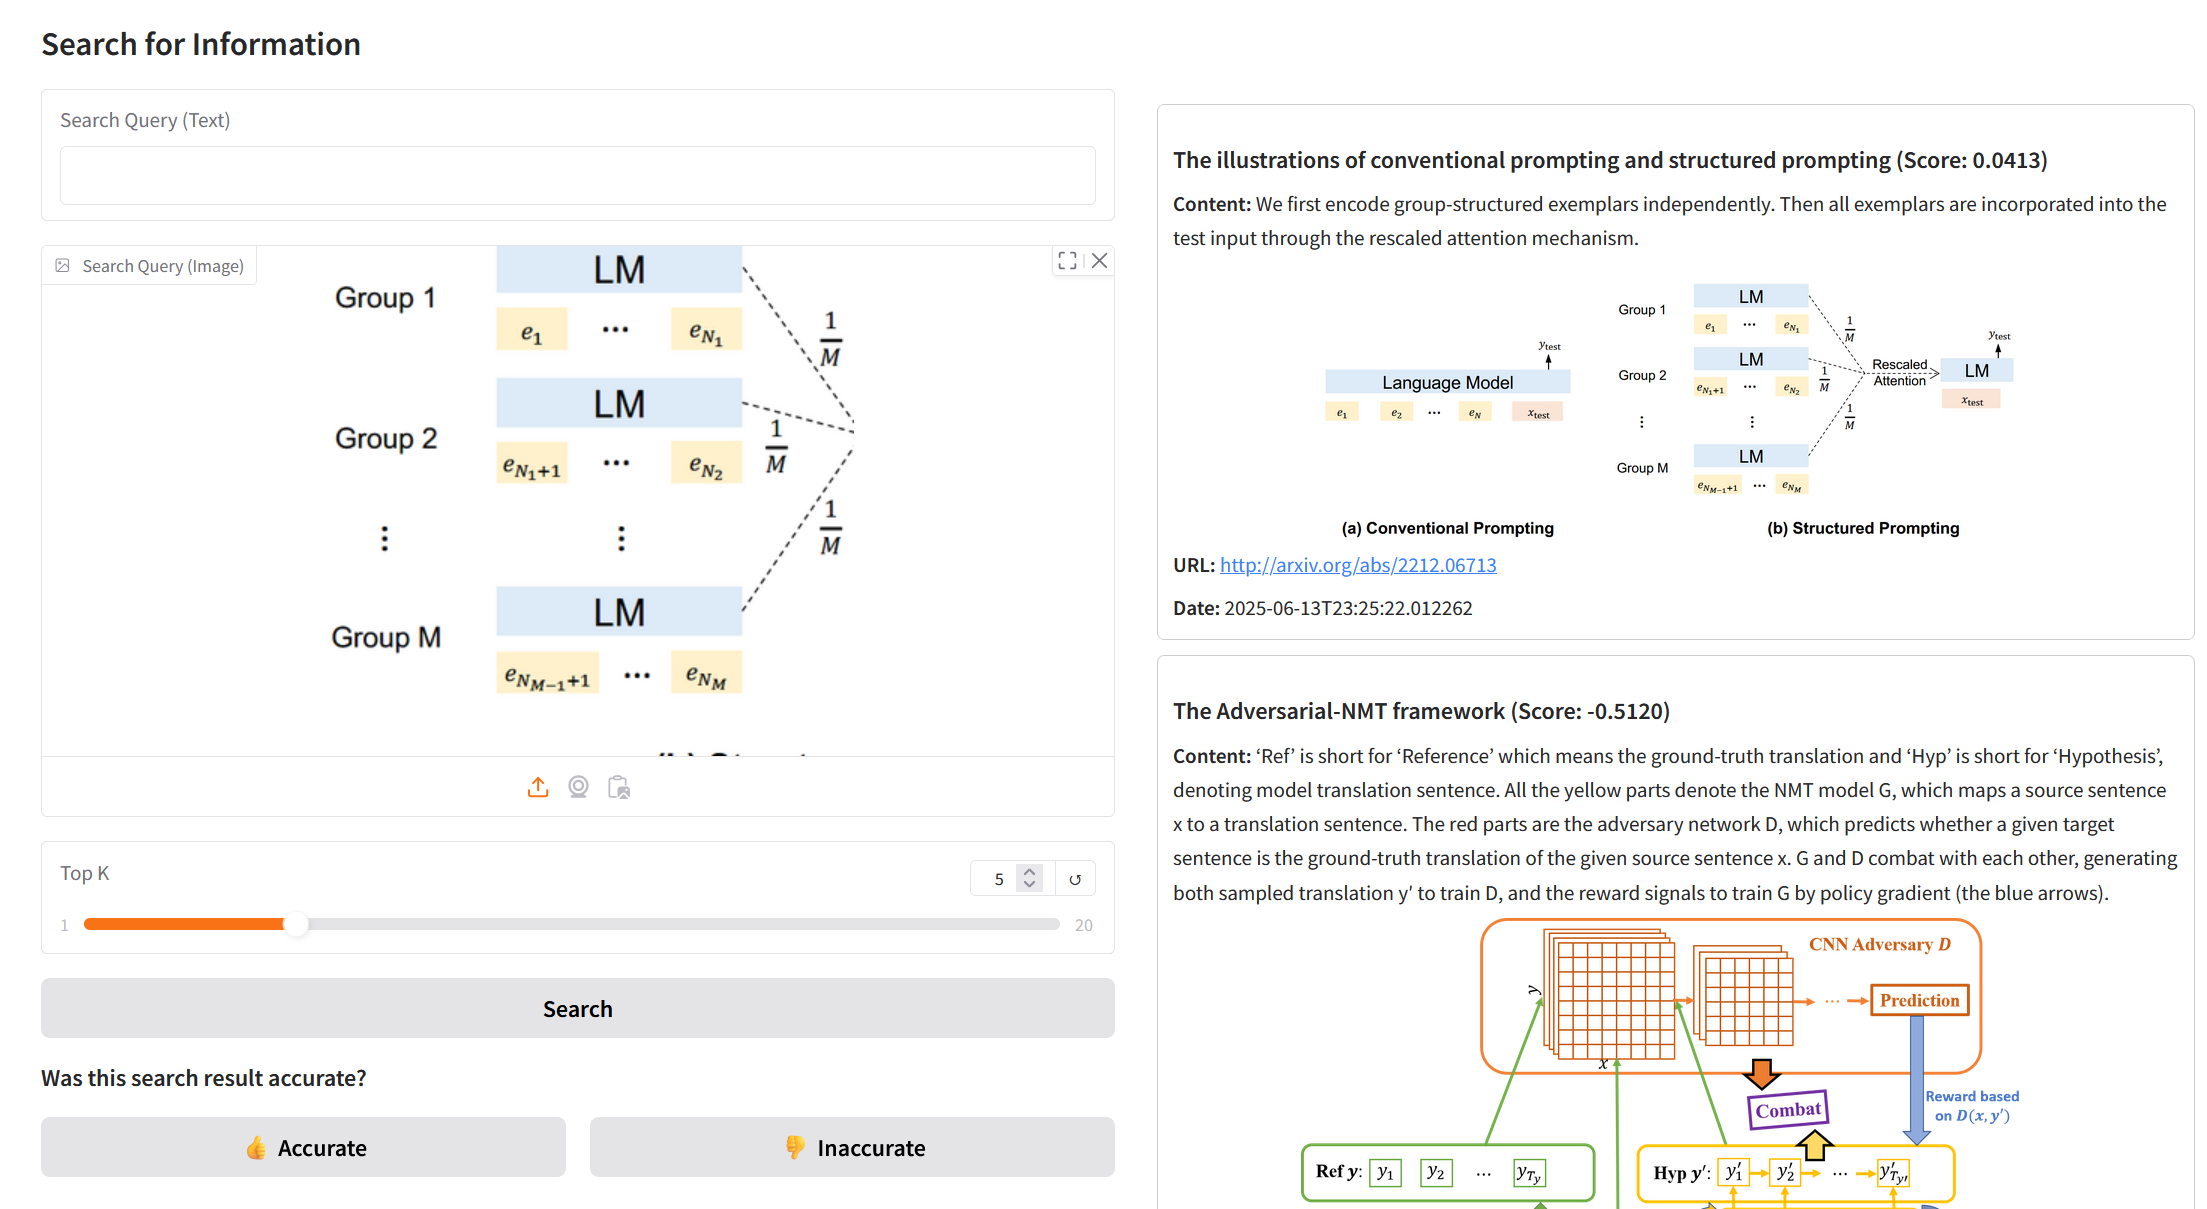
Manage Data: 添加新条目。系统会在后台自动为其提取结构化信息。Search: 执行检索。结果将以图文和信息卡片的形式展示。在结果下方,您现在可以对"检索相关性"和"抽取准确性"进行双重评价。.
├── app.py # Gradio Web应用入口
├── retriever.py # 封装了GME-Qwen2-VL模型的检索逻辑
├── database.py # 封装了ChromaDB数据库操作
├── openai_extractor.py # 封装了调用GPT-4o进行信息抽取的逻辑
├── import_data.py # 批量导入数据的脚本
├── backfill_data.py # 为老数据追补信息抽取的脚本
├── requirements.txt # 项目依赖
├── data/ # (自动创建) 存储上传的原始图片
├── database/ # (自动创建) ChromaDB 持久化数据存储目录
├── search_feedback.json # (自动创建) 存储检索评价数据
├── extraction_feedback.json # (自动创建) 存储抽取评价数据
└── README.md # 本说明文件
A Interactive Multimodal Information Retrieval System for BUPT Information and Knowledge Acquisition (2025 Spring)
Python
1
3 commits
updated Jun 30, 2025
这是一个基于GME-Qwen2-VL大型视觉语言模型构建的交互式多模态信息检索系统。它支持对文本、图像以及图文混合内容进行统一的语义检索,并集成了基于GPT-4o的智能信息抽取和多维度评估功能。
Gradio 构建,操作直观方便。ChromaDB 存储和检索由 GME-Qwen2-VL 模型生成的向量嵌入。本次重大更新为系统引入了"理解与分析"的能力,核心内容如下:
集成了基于GPT-4o的信息抽取功能:
openai_extractor.py: 专门用于调用大模型API,内置了包含Schema验证和重试机制的健壮逻辑。新增了对信息抽取的评价体系:
search_feedback.json 和 extraction_feedback.json 文件中,互不干扰。增加了批量处理脚本:
import_data.py: 用于从一个大的JSON文件批量导入数据到系统中。backfill_data.py: 一个支持并发和强制刷新功能的强大脚本,用于为数据库中所有已存在的"老数据"追补和更新其信息抽取结果。Alibaba-NLP/gme-Qwen2-VL-7B-Instruct, gpt-4o-latestGradio, PyTorch, Transformers, accelerateChromaDBOpenAI, Pillow, Numpy克隆仓库
# git clone <repository-url>
# cd <repository-name>
创建虚拟环境并安装依赖
# 建议使用conda或venv创建虚拟环境
# conda create -n rag_env python=3.10
# conda activate rag_env
pip install -r requirements.txt
设置OpenAI API Key 信息抽取功能需要使用OpenAI的API。请在您的环境中设置环境变量:
export OPENAI_API_KEY='your_openai_api_key'
您也可以在 app.py 和 backfill_data.py 等文件的顶部直接修改API Key和Base URL。
硬件要求
GmeQwen2-VL-7B-Instruct 模型,该模型参数量为70亿,推荐在高性能的NVIDIA GPU(例如 A100 / A800)上运行以获得最佳体验。启动应用 在终端中运行以下命令:
python app.py
访问界面
程序启动后,会输出一个本地URL (通常是 http://127.0.0.1:10099 或 http://0.0.0.0:10099)。在浏览器中打开此地址即可访问系统。
功能介绍
Manage Data: 添加新条目。系统会在后台自动为其提取结构化信息。Search: 执行检索。结果将以图文和信息卡片的形式展示。在结果下方,您现在可以对"检索相关性"和"抽取准确性"进行双重评价。.
├── app.py # Gradio Web应用入口
├── retriever.py # 封装了GME-Qwen2-VL模型的检索逻辑
├── database.py # 封装了ChromaDB数据库操作
├── openai_extractor.py # 封装了调用GPT-4o进行信息抽取的逻辑
├── import_data.py # 批量导入数据的脚本
├── backfill_data.py # 为老数据追补信息抽取的脚本
├── requirements.txt # 项目依赖
├── data/ # (自动创建) 存储上传的原始图片
├── database/ # (自动创建) ChromaDB 持久化数据存储目录
├── search_feedback.json # (自动创建) 存储检索评价数据
├── extraction_feedback.json # (自动创建) 存储抽取评价数据
└── README.md # 本说明文件



