This repository contains the implementation code for the research paper "Refining Text Generation for Realistic Conversational Recommendation via Direct Preference Optimization". We propose a method to improve text generation in Conversational Recommender Systems (CRSs) using Direct Preference Optimization (DPO).
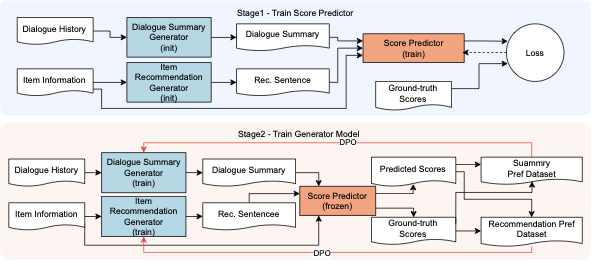 View high-resolution diagram (PDF)
Traditional Conversational Recommender Systems (CRSs) face challenges such as hasty recommendations in short conversations and insufficient integration of implicit information. This research extends SumRec by applying DPO to optimize both dialogue summary generation and item recommendation information generation models, achieving more realistic and natural conversational recommendation.
Description: Travel agent recommendation dialogues (realistic long conversations)
Download and Placement:
data/Tabidachi/annotation_data/Directory structure after placement:
data/Tabidachi/
└── annotation_data/
    ├── annotations/          # Directory containing dialogue annotation files
    │   └── *.json           # Individual dialogue session files
    ├── spot_info.json        # Tourist spot information
    └── タグ一覧.docx         # Tag list document
Description: Multi-category recommendation dialogues (for comparison)
Download and Placement:
data/ChatRec/chat_and_rec/Directory structure after placement:
data/ChatRec/
└── chat_and_rec/
    ├── except_for_travel/    # Non-travel recommendation dialogues
    │   └── *.json
    ├── travel/               # Travel recommendation dialogues
    │   └── *.json
    └── no_restriction/       # General recommendation dialogues
        └── *.json
# Create virtual environment
python -m venv .venv

# Activate environment
source .venv/bin/activate  # Linux/Mac
# or .venv\Scripts\activate  # Windows

# Install dependencies
pip install -r requirements.txt
requirements.txt for complete detailsThis project uses four types of dataset formats:
# Download Tabidachi dataset and place in data/Tabidachi/annotation_data/
# Then preprocess the raw data
python src/Tabidachi/data_preprocessing.py
# Execute in order to create all dataset formats
python src/Tabidachi/create_dataset_1.py  # Basic recommendation dataset
python src/Tabidachi/create_dataset_2.py  # Score predictor training data
python src/Tabidachi/create_dataset_3.py  # DPO data for dialogue summary generation
python src/Tabidachi/create_dataset_4.py  # DPO data for item recommendation information
# Train DeBERTa with method selection
# Method options: proposal, baseline1, baseline2
# - proposal/baseline1: Uses 3 inputs (dialogue summary, item recommendation information, candidate info)
# - baseline2: Uses 2 inputs (dialogue summary, candidate info)
python src/Tabidachi/train_deberta.py --method proposal&baseline1
# Or:
python src/Tabidachi/train_deberta.py --method baseline2

# Output: Model saved to src/Tabidachi/deberta_best_model_[method]/
# Train dialogue summary generation model with hyperparameter optimization
python src/Tabidachi/dpo_summary_llm.py         # Creates model 1
python src/Tabidachi/dpo_summary_llm_more.py    # Creates models 2-5
# Output: Models saved as dpo-summary-results_1/, dpo-summary-results_2/, etc.

# Train item recommendation information generation model with hyperparameter optimization
python src/Tabidachi/dpo_recommendation_llm.py      # Creates model 1
python src/Tabidachi/dpo_recommendation_llm_more.py  # Creates models 2-5
# Output: Models saved as dpo-recommendation-results_1/, dpo-recommendation-results_2/, etc.
# Proposed method (using DPO-trained models)
python src/Tabidachi/create_recommend_data_proposal.py

# Baseline methods for comparison
python src/Tabidachi/create_recommend_data_baseline1.py  # baseline1 = SumRec (from paper)
python src/Tabidachi/create_recommend_data_baseline2.py  # baseline2 = Baseline (from paper)

# Ablation studies (optional)
python src/Tabidachi/create_recommend_data_ablation1.py  # w/o Rec-DPO
python src/Tabidachi/create_recommend_data_ablation2.py  # w/o Sum-DPO
# Evaluate with method selection
# For proposal/ablation methods: automatically evaluates models 1-5 and computes average
# For baseline methods: evaluates single dataset

# Proposed method (evaluates all 5 models)
python src/Tabidachi/evaluate_from_recommend_data.py --method proposal

# Baseline methods (single dataset each)
python src/Tabidachi/evaluate_from_recommend_data.py --method baseline1
python src/Tabidachi/evaluate_from_recommend_data.py --method baseline2

# Ablation studies (evaluates all 5 models)
python src/Tabidachi/evaluate_from_recommend_data.py --method ablation1
python src/Tabidachi/evaluate_from_recommend_data.py --method ablation2

# Output: HR@k and MRR@k metrics for selected method
# Download ChatRec dataset and place in data/ChatRec/chat_and_rec/
# Then preprocess the raw data
python src/ChatRec/data_preprocessing.py
# Execute in order
python src/ChatRec/create_dataset_1.py  # Basic recommendation dataset
python src/ChatRec/create_dataset_2.py  # Score predictor training data
python src/ChatRec/create_dataset_3.py  # DPO data for dialogue summary generation
python src/ChatRec/create_dataset_4.py  # DPO data for item recommendation information
# Train DeBERTa with method selection
# Method options: proposal, baseline1, baseline2
# - proposal/baseline1: Uses 3 inputs (dialogue summary, item recommendation information, candidate info)
# - baseline2: Uses 2 inputs (dialogue summary, candidate info)
python src/ChatRec/train_deberta.py --method proposal&baseline1
# Or:
python src/ChatRec/train_deberta.py --method baseline2

# Output: Model saved to src/ChatRec/ChatRec_deberta_best_model_[method]/
# DPO Training
python src/ChatRec/dpo_summary_llm.py         # Creates model 1
python src/ChatRec/dpo_summary_llm_more.py    # Creates models 2-5
python src/ChatRec/dpo_recommendation_llm.py      # Creates model 1
python src/ChatRec/dpo_recommendation_llm_more.py  # Creates models 2-5
# Generate recommendation data
python src/ChatRec/create_recommend_data_proposal.py    # Proposed method
python src/ChatRec/create_recommend_data_baseline1.py   # baseline1 = SumRec (from paper)
python src/ChatRec/create_recommend_data_baseline2.py   # baseline2 = Baseline (from paper)

# Evaluate performance with method selection
# For proposal: automatically evaluates models 1-5 and computes average
# For baseline methods: evaluates single dataset

# Proposed method (evaluates all 5 models)
python src/ChatRec/evaluate_from_recommend_data.py --method proposal

# Baseline methods (single dataset each)
python src/ChatRec/evaluate_from_recommend_data.py --method baseline1
python src/ChatRec/evaluate_from_recommend_data.py --method baseline2
# Train model with different data split for crowdworker evaluation
python src/Tabidachi/dpo_summary_llm_cloudworker.py
# Output: Model saved as src/Tabidachi/dpo-summary-results_cloudworker/
# For baseline method (SumRec - without DPO)
python src/Tabidachi/create_cloudworker_dataset.py --method baseline1
# Output: data/Tabidachi/cloudworker-dataset-baseline1/

# For proposed method (with DPO-trained models)
python src/Tabidachi/create_cloudworker_dataset.py --method proposal
# Output: data/Tabidachi/cloudworker-dataset-proposal/

# Note: The script automatically selects appropriate models:
# - baseline1: Uses base Llama-Swallow models without DPO
# - proposal: Uses DPO-trained models (dpo-recommendation-results_1 and dpo-summary-results_cloudworker)
cloud_worker_tabidachi_datasets.xlsx# Analyze crowdworker evaluation results
python metrics_sentence.py
# Computes:
# - Average character length of summaries and recommendations
# - Distinct-1/2 scores for text diversity
# - BLEU and ROUGE scores for text similarity
# - Statistical significance tests
Note: In the source code, baseline1 corresponds to "SumRec" and baseline2 corresponds to "Baseline" as described in the paper.
metrics_sentence.py for statistical validation├── src/
│ ├── Tabidachi/ # Main implementation for Tabidachi
│ │ ├── data_preprocessing.py # Raw data preprocessing
│ │ ├── create_dataset_1.py # Basic recommendation dataset creation
│ │ ├── create_dataset_2.py # Score predictor dataset creation
│ │ ├── create_dataset_3.py # DPO dataset for dialogue summary generation
│ │ ├── create_dataset_4.py # DPO dataset for item recommendation information
│ │ ├── train_deberta.py # DeBERTa score predictor training
│ │ ├── inference_deberta.py # DeBERTa inference utilities
│ │ ├── dpo_summary_llm.py # DPO training for dialogue summary generation model (creates model 1)
│ │ ├── dpo_summary_llm_more.py # Additional DPO training for dialogue summary generation models (creates models 2-5)
│ │ ├── dpo_summary_llm_cloudworker.py # DPO training for crowdworker eval
│ │ ├── dpo_recommendation_llm.py # DPO training for item recommendation information generation model (creates model 1)
│ │ ├── dpo_recommendation_llm_more.py # Additional DPO training for item recommendation information generation models (creates models 2-5)
│ │ ├── create_recommend_data_proposal.py # Proposed method recommendation
│ │ ├── create_recommend_data_baseline1.py # Baseline 1 (SumRec)
│ │ ├── create_recommend_data_baseline2.py # Baseline 2 (Simple)
│ │ ├── create_recommend_data_ablation1.py # Ablation: w/o Rec-DPO
│ │ ├── create_recommend_data_ablation2.py # Ablation: w/o Sum-DPO
│ │ ├── create_cloudworker_dataset.py # Crowdworker evaluation dataset
│ │ ├── evaluate_from_recommend_data.py # HR@k, MRR@k evaluation
│ │ ├── oss_llm.py # Base LLM wrapper
│ │ ├── rec_model.py # Item recommendation information generation model wrapper
│ │ ├── summary_model.py # Dialogue summary generation model wrapper
│ │ └── [utility scripts] # create_csv*.py, count_*.py, etc.
│ └── ChatRec/ # ChatRec implementation
│ ├── data_preprocessing.py # Raw data preprocessing
│ ├── create_dataset_1.py # Basic recommendation dataset
│ ├── create_dataset_2.py # Score predictor dataset
│ ├── create_dataset_3.py # DPO dataset for dialogue summary generation
│ ├── create_dataset_4.py # DPO dataset for item recommendation information
│ ├── train_deberta.py # DeBERTa training
│ ├── inference_deberta.py # DeBERTa inference
│ ├── dpo_summary_llm.py # DPO training for dialogue summary generation model (creates model 1)
│ ├── dpo_summary_llm_more.py # Additional DPO training for dialogue summary generation models (creates models 2-5)
│ ├── dpo_recommendation_llm.py # DPO training for item recommendation information generation model (creates model 1)
│ ├── dpo_recommendation_llm_more.py # Additional DPO training for item recommendation information generation models (creates models 2-5)
│ ├── create_recommend_data_proposal.py # Proposed method
│ ├── create_recommend_data_baseline1.py # Baseline 1
│ ├── create_recommend_data_baseline2.py # Baseline 2
│ ├── evaluate_from_recommend_data.py # Evaluation
│ ├── oss_llm.py # Base LLM wrapper
│ ├── rec_model.py # Item recommendation information generation model
│ ├── summary_model.py # Dialogue summary generation model
│ └── [utility scripts] # count_*.py, logger.py
├── data/
│ ├── Tabidachi/ # Tabidachi datasets
│ │ ├── annotation_data/ # Original downloaded dataset
│ │ ├── processed_data/ # Preprocessed data
│ │ ├── datasets_1/ # Recommendation datasets
│ │ ├── datasets_2/ # Score predictor training datasets
│ │ ├── datasets_3/ # DPO datasets for summarization
│ │ ├── datasets_4/ # DPO datasets for recommendation
│ │ ├── recommend_data_*/ # Generated recommendation results
│ │ └── cloudworker-dataset*/ # Crowdworker evaluation data
│ └── ChatRec/ # ChatRec datasets
│ ├── chat_and_rec/ # Original downloaded dataset
│ ├── processed_data/ # Preprocessed data
│ ├── datasets_1/ # Recommendation datasets
│ ├── datasets_2/ # Score predictor training datasets
│ ├── datasets_3/ # DPO datasets for summarization
│ ├── datasets_4/ # DPO datasets for recommendation
│ └── recommend_data_*/ # Generated recommendation results
├── images/ # Documentation images
│ ├── proposal_flow.pdf # Method flow diagram (PDF)
│ └── proposal_flow.png # Method flow diagram (PNG)
├── metrics_sentence.py # Text quality analysis tool
├── cloud_worker_tabidachi_datasets.xlsx # Crowdworker evaluation results
├── requirements.txt # Python dependencies
└── README.md # This file
data_preprocessing.py: Converts raw annotation data into structured format for experimentscreate_dataset_1.py: Creates basic recommendation dataset with dialogue-candidate pairscreate_dataset_2.py: Generates training data for score predictor (DeBERTa)create_dataset_3.py: Creates preference pairs for dialogue summary generation DPO trainingcreate_dataset_4.py: Creates preference pairs for item recommendation information DPO trainingtrain_deberta.py: Trains DeBERTa-based score predictor for recommendation scoring
--method [proposal&baseline1|baseline2]dpo_summary_llm.py: DPO training for dialogue summary generation model with Optuna hyperparameter optimization (creates model 1)dpo_summary_llm_more.py: Additional DPO training for dialogue summary generation models (creates models 2-5)dpo_summary_llm_cloudworker.py: Special training for crowdworker evaluation with different data splitdpo_recommendation_llm.py: DPO training for item recommendation information generation model with Optuna (creates model 1)dpo_recommendation_llm_more.py: Additional DPO training for item recommendation information generation models (creates models 2-5)create_recommend_data_proposal.py: Generates recommendations using the proposed DPO-trained modelscreate_recommend_data_baseline1.py: baseline1 = SumRec implementation from paper (no DPO)create_recommend_data_baseline2.py: baseline2 = Baseline from paper (simple method without item recommendation information)create_recommend_data_ablation1.py: Ablation study without recommendation DPO (w/o Rec-DPO)create_recommend_data_ablation2.py: Ablation study without summarization DPO (w/o Sum-DPO)create_cloudworker_dataset.py: Creates specialized dataset for human evaluationevaluate_from_recommend_data.py: Computes HR@k and MRR@k metrics for all methods
--method for method selectionmetrics_sentence.py: Analyzes text quality with multiple metrics:
cloud_worker_tabidachi_datasets.xlsxoss_llm.py: Base wrapper for Llama-3.1-Swallow modelrec_model.py: Wrapper for item recommendation information generation modelsummary_model.py: Wrapper for dialogue summary generation modelinference_deberta.py: Utilities for DeBERTa score prediction# 1. Prepare environment
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
# 2. Download and place dataset
# Download from https://www.nii.ac.jp/dsc/idr/rdata/Tabidachi/
# Place in data/Tabidachi/annotation_data/
# 3. Run complete pipeline
cd src/Tabidachi
bash ../../scripts/run_tabidachi_experiments.sh # If script exists
# Or run manually:
python data_preprocessing.py
python create_dataset_1.py && python create_dataset_2.py
python create_dataset_3.py && python create_dataset_4.py
python train_deberta.py --method proposal&baseline1 # or baseline2
python dpo_summary_llm.py # Creates model 1
python dpo_summary_llm_more.py # Creates models 2-5
python dpo_recommendation_llm.py # Creates model 1
python dpo_recommendation_llm_more.py # Creates models 2-5
python create_recommend_data_proposal.py
python create_recommend_data_baseline1.py
python create_recommend_data_baseline2.py
python evaluate_from_recommend_data.py --method proposal # Evaluate proposed method
# 1. Download and place dataset
# Clone from https://github.com/Ryutaro-A/SumRec
# Place data in data/ChatRec/chat_and_rec/

# 2. Run complete pipeline
cd src/ChatRec
python data_preprocessing.py
python create_dataset_1.py && python create_dataset_2.py
python create_dataset_3.py && python create_dataset_4.py
python train_deberta.py --method proposal&baseline1  # or baseline2
python dpo_summary_llm.py          # Creates model 1
python dpo_summary_llm_more.py     # Creates models 2-5
python dpo_recommendation_llm.py       # Creates model 1
python dpo_recommendation_llm_more.py  # Creates models 2-5
python create_recommend_data_proposal.py
python create_recommend_data_baseline1.py
python create_recommend_data_baseline2.py
python evaluate_from_recommend_data.py --method proposal  # Evaluate proposed method
src/Tabidachi/deberta_best_model_proposal&baseline1/ or deberta_best_model_baseline2/src/Tabidachi/dpo-summary-results_[1-5]/src/Tabidachi/dpo-recommendation-results_[1-5]/src/Tabidachi/dpo-summary-results_cloudworker/src/ChatRec/ChatRec_deberta_best_model_proposal&baseline1/ or ChatRec_deberta_best_model_baseline2/src/ChatRec/dpo-summary-results_[1-5]/src/ChatRec/dpo-recommendation-results_[1-5]/data/Tabidachi/recommend_data_[method]/data/ChatRec/recommend_data_[method]/To be added
Note: This implementation is created for research purposes. For commercial use, please verify the licenses of each model and dataset.
This repository contains the implementation code for the research paper "Refining Text Generation for Realistic Conversational Recommendation via Direct Preference Optimization". We propose a method to improve text generation in Conversational Recommender Systems (CRSs) using Direct Preference Optimization (DPO).
View high-resolution diagram (PDF)
Traditional Conversational Recommender Systems (CRSs) face challenges such as hasty recommendations in short conversations and insufficient integration of implicit information. This research extends SumRec by applying DPO to optimize both dialogue summary generation and item recommendation information generation models, achieving more realistic and natural conversational recommendation.
Description: Travel agent recommendation dialogues (realistic long conversations)
Download and Placement:
data/Tabidachi/annotation_data/Directory structure after placement:
data/Tabidachi/
└── annotation_data/
    ├── annotations/          # Directory containing dialogue annotation files
    │   └── *.json           # Individual dialogue session files
    ├── spot_info.json        # Tourist spot information
    └── タグ一覧.docx         # Tag list document
Description: Multi-category recommendation dialogues (for comparison)
Download and Placement:
data/ChatRec/chat_and_rec/Directory structure after placement:
data/ChatRec/
└── chat_and_rec/
    ├── except_for_travel/    # Non-travel recommendation dialogues
    │   └── *.json
    ├── travel/               # Travel recommendation dialogues
    │   └── *.json
    └── no_restriction/       # General recommendation dialogues
        └── *.json
# Create virtual environment
python -m venv .venv

# Activate environment
source .venv/bin/activate  # Linux/Mac
# or .venv\Scripts\activate  # Windows

# Install dependencies
pip install -r requirements.txt
requirements.txt for complete detailsThis project uses four types of dataset formats:
# Download Tabidachi dataset and place in data/Tabidachi/annotation_data/
# Then preprocess the raw data
python src/Tabidachi/data_preprocessing.py
# Execute in order to create all dataset formats
python src/Tabidachi/create_dataset_1.py  # Basic recommendation dataset
python src/Tabidachi/create_dataset_2.py  # Score predictor training data
python src/Tabidachi/create_dataset_3.py  # DPO data for dialogue summary generation
python src/Tabidachi/create_dataset_4.py  # DPO data for item recommendation information
# Train DeBERTa with method selection
# Method options: proposal, baseline1, baseline2
# - proposal/baseline1: Uses 3 inputs (dialogue summary, item recommendation information, candidate info)
# - baseline2: Uses 2 inputs (dialogue summary, candidate info)
python src/Tabidachi/train_deberta.py --method proposal&baseline1
# Or:
python src/Tabidachi/train_deberta.py --method baseline2

# Output: Model saved to src/Tabidachi/deberta_best_model_[method]/
# Train dialogue summary generation model with hyperparameter optimization
python src/Tabidachi/dpo_summary_llm.py         # Creates model 1
python src/Tabidachi/dpo_summary_llm_more.py    # Creates models 2-5
# Output: Models saved as dpo-summary-results_1/, dpo-summary-results_2/, etc.

# Train item recommendation information generation model with hyperparameter optimization
python src/Tabidachi/dpo_recommendation_llm.py      # Creates model 1
python src/Tabidachi/dpo_recommendation_llm_more.py  # Creates models 2-5
# Output: Models saved as dpo-recommendation-results_1/, dpo-recommendation-results_2/, etc.
# Proposed method (using DPO-trained models)
python src/Tabidachi/create_recommend_data_proposal.py

# Baseline methods for comparison
python src/Tabidachi/create_recommend_data_baseline1.py  # baseline1 = SumRec (from paper)
python src/Tabidachi/create_recommend_data_baseline2.py  # baseline2 = Baseline (from paper)

# Ablation studies (optional)
python src/Tabidachi/create_recommend_data_ablation1.py  # w/o Rec-DPO
python src/Tabidachi/create_recommend_data_ablation2.py  # w/o Sum-DPO
# Evaluate with method selection
# For proposal/ablation methods: automatically evaluates models 1-5 and computes average
# For baseline methods: evaluates single dataset

# Proposed method (evaluates all 5 models)
python src/Tabidachi/evaluate_from_recommend_data.py --method proposal

# Baseline methods (single dataset each)
python src/Tabidachi/evaluate_from_recommend_data.py --method baseline1
python src/Tabidachi/evaluate_from_recommend_data.py --method baseline2

# Ablation studies (evaluates all 5 models)
python src/Tabidachi/evaluate_from_recommend_data.py --method ablation1
python src/Tabidachi/evaluate_from_recommend_data.py --method ablation2

# Output: HR@k and MRR@k metrics for selected method
# Download ChatRec dataset and place in data/ChatRec/chat_and_rec/
# Then preprocess the raw data
python src/ChatRec/data_preprocessing.py
# Execute in order
python src/ChatRec/create_dataset_1.py  # Basic recommendation dataset
python src/ChatRec/create_dataset_2.py  # Score predictor training data
python src/ChatRec/create_dataset_3.py  # DPO data for dialogue summary generation
python src/ChatRec/create_dataset_4.py  # DPO data for item recommendation information
# Train DeBERTa with method selection
# Method options: proposal, baseline1, baseline2
# - proposal/baseline1: Uses 3 inputs (dialogue summary, item recommendation information, candidate info)
# - baseline2: Uses 2 inputs (dialogue summary, candidate info)
python src/ChatRec/train_deberta.py --method proposal&baseline1
# Or:
python src/ChatRec/train_deberta.py --method baseline2

# Output: Model saved to src/ChatRec/ChatRec_deberta_best_model_[method]/
# DPO Training
python src/ChatRec/dpo_summary_llm.py         # Creates model 1
python src/ChatRec/dpo_summary_llm_more.py    # Creates models 2-5
python src/ChatRec/dpo_recommendation_llm.py      # Creates model 1
python src/ChatRec/dpo_recommendation_llm_more.py  # Creates models 2-5
# Generate recommendation data
python src/ChatRec/create_recommend_data_proposal.py    # Proposed method
python src/ChatRec/create_recommend_data_baseline1.py   # baseline1 = SumRec (from paper)
python src/ChatRec/create_recommend_data_baseline2.py   # baseline2 = Baseline (from paper)

# Evaluate performance with method selection
# For proposal: automatically evaluates models 1-5 and computes average
# For baseline methods: evaluates single dataset

# Proposed method (evaluates all 5 models)
python src/ChatRec/evaluate_from_recommend_data.py --method proposal

# Baseline methods (single dataset each)
python src/ChatRec/evaluate_from_recommend_data.py --method baseline1
python src/ChatRec/evaluate_from_recommend_data.py --method baseline2
# Train model with different data split for crowdworker evaluation
python src/Tabidachi/dpo_summary_llm_cloudworker.py
# Output: Model saved as src/Tabidachi/dpo-summary-results_cloudworker/
# For baseline method (SumRec - without DPO)
python src/Tabidachi/create_cloudworker_dataset.py --method baseline1
# Output: data/Tabidachi/cloudworker-dataset-baseline1/

# For proposed method (with DPO-trained models)
python src/Tabidachi/create_cloudworker_dataset.py --method proposal
# Output: data/Tabidachi/cloudworker-dataset-proposal/

# Note: The script automatically selects appropriate models:
# - baseline1: Uses base Llama-Swallow models without DPO
# - proposal: Uses DPO-trained models (dpo-recommendation-results_1 and dpo-summary-results_cloudworker)
cloud_worker_tabidachi_datasets.xlsx# Analyze crowdworker evaluation results
python metrics_sentence.py
# Computes:
# - Average character length of summaries and recommendations
# - Distinct-1/2 scores for text diversity
# - BLEU and ROUGE scores for text similarity
# - Statistical significance tests
Note: In the source code, baseline1 corresponds to "SumRec" and baseline2 corresponds to "Baseline" as described in the paper.
metrics_sentence.py for statistical validation├── src/
│ ├── Tabidachi/ # Main implementation for Tabidachi
│ │ ├── data_preprocessing.py # Raw data preprocessing
│ │ ├── create_dataset_1.py # Basic recommendation dataset creation
│ │ ├── create_dataset_2.py # Score predictor dataset creation
│ │ ├── create_dataset_3.py # DPO dataset for dialogue summary generation
│ │ ├── create_dataset_4.py # DPO dataset for item recommendation information
│ │ ├── train_deberta.py # DeBERTa score predictor training
│ │ ├── inference_deberta.py # DeBERTa inference utilities
│ │ ├── dpo_summary_llm.py # DPO training for dialogue summary generation model (creates model 1)
│ │ ├── dpo_summary_llm_more.py # Additional DPO training for dialogue summary generation models (creates models 2-5)
│ │ ├── dpo_summary_llm_cloudworker.py # DPO training for crowdworker eval
│ │ ├── dpo_recommendation_llm.py # DPO training for item recommendation information generation model (creates model 1)
│ │ ├── dpo_recommendation_llm_more.py # Additional DPO training for item recommendation information generation models (creates models 2-5)
│ │ ├── create_recommend_data_proposal.py # Proposed method recommendation
│ │ ├── create_recommend_data_baseline1.py # Baseline 1 (SumRec)
│ │ ├── create_recommend_data_baseline2.py # Baseline 2 (Simple)
│ │ ├── create_recommend_data_ablation1.py # Ablation: w/o Rec-DPO
│ │ ├── create_recommend_data_ablation2.py # Ablation: w/o Sum-DPO
│ │ ├── create_cloudworker_dataset.py # Crowdworker evaluation dataset
│ │ ├── evaluate_from_recommend_data.py # HR@k, MRR@k evaluation
│ │ ├── oss_llm.py # Base LLM wrapper
│ │ ├── rec_model.py # Item recommendation information generation model wrapper
│ │ ├── summary_model.py # Dialogue summary generation model wrapper
│ │ └── [utility scripts] # create_csv*.py, count_*.py, etc.
│ └── ChatRec/ # ChatRec implementation
│ ├── data_preprocessing.py # Raw data preprocessing
│ ├── create_dataset_1.py # Basic recommendation dataset
│ ├── create_dataset_2.py # Score predictor dataset
│ ├── create_dataset_3.py # DPO dataset for dialogue summary generation
│ ├── create_dataset_4.py # DPO dataset for item recommendation information
│ ├── train_deberta.py # DeBERTa training
│ ├── inference_deberta.py # DeBERTa inference
│ ├── dpo_summary_llm.py # DPO training for dialogue summary generation model (creates model 1)
│ ├── dpo_summary_llm_more.py # Additional DPO training for dialogue summary generation models (creates models 2-5)
│ ├── dpo_recommendation_llm.py # DPO training for item recommendation information generation model (creates model 1)
│ ├── dpo_recommendation_llm_more.py # Additional DPO training for item recommendation information generation models (creates models 2-5)
│ ├── create_recommend_data_proposal.py # Proposed method
│ ├── create_recommend_data_baseline1.py # Baseline 1
│ ├── create_recommend_data_baseline2.py # Baseline 2
│ ├── evaluate_from_recommend_data.py # Evaluation
│ ├── oss_llm.py # Base LLM wrapper
│ ├── rec_model.py # Item recommendation information generation model
│ ├── summary_model.py # Dialogue summary generation model
│ └── [utility scripts] # count_*.py, logger.py
├── data/
│ ├── Tabidachi/ # Tabidachi datasets
│ │ ├── annotation_data/ # Original downloaded dataset
│ │ ├── processed_data/ # Preprocessed data
│ │ ├── datasets_1/ # Recommendation datasets
│ │ ├── datasets_2/ # Score predictor training datasets
│ │ ├── datasets_3/ # DPO datasets for summarization
│ │ ├── datasets_4/ # DPO datasets for recommendation
│ │ ├── recommend_data_*/ # Generated recommendation results
│ │ └── cloudworker-dataset*/ # Crowdworker evaluation data
│ └── ChatRec/ # ChatRec datasets
│ ├── chat_and_rec/ # Original downloaded dataset
│ ├── processed_data/ # Preprocessed data
│ ├── datasets_1/ # Recommendation datasets
│ ├── datasets_2/ # Score predictor training datasets
│ ├── datasets_3/ # DPO datasets for summarization
│ ├── datasets_4/ # DPO datasets for recommendation
│ └── recommend_data_*/ # Generated recommendation results
├── images/ # Documentation images
│ ├── proposal_flow.pdf # Method flow diagram (PDF)
│ └── proposal_flow.png # Method flow diagram (PNG)
├── metrics_sentence.py # Text quality analysis tool
├── cloud_worker_tabidachi_datasets.xlsx # Crowdworker evaluation results
├── requirements.txt # Python dependencies
└── README.md # This file
data_preprocessing.py: Converts raw annotation data into structured format for experimentscreate_dataset_1.py: Creates basic recommendation dataset with dialogue-candidate pairscreate_dataset_2.py: Generates training data for score predictor (DeBERTa)create_dataset_3.py: Creates preference pairs for dialogue summary generation DPO trainingcreate_dataset_4.py: Creates preference pairs for item recommendation information DPO trainingtrain_deberta.py: Trains DeBERTa-based score predictor for recommendation scoring
--method [proposal&baseline1|baseline2]dpo_summary_llm.py: DPO training for dialogue summary generation model with Optuna hyperparameter optimization (creates model 1)dpo_summary_llm_more.py: Additional DPO training for dialogue summary generation models (creates models 2-5)dpo_summary_llm_cloudworker.py: Special training for crowdworker evaluation with different data splitdpo_recommendation_llm.py: DPO training for item recommendation information generation model with Optuna (creates model 1)dpo_recommendation_llm_more.py: Additional DPO training for item recommendation information generation models (creates models 2-5)create_recommend_data_proposal.py: Generates recommendations using the proposed DPO-trained modelscreate_recommend_data_baseline1.py: baseline1 = SumRec implementation from paper (no DPO)create_recommend_data_baseline2.py: baseline2 = Baseline from paper (simple method without item recommendation information)create_recommend_data_ablation1.py: Ablation study without recommendation DPO (w/o Rec-DPO)create_recommend_data_ablation2.py: Ablation study without summarization DPO (w/o Sum-DPO)create_cloudworker_dataset.py: Creates specialized dataset for human evaluationevaluate_from_recommend_data.py: Computes HR@k and MRR@k metrics for all methods
--method for method selectionmetrics_sentence.py: Analyzes text quality with multiple metrics:
cloud_worker_tabidachi_datasets.xlsxoss_llm.py: Base wrapper for Llama-3.1-Swallow modelrec_model.py: Wrapper for item recommendation information generation modelsummary_model.py: Wrapper for dialogue summary generation modelinference_deberta.py: Utilities for DeBERTa score prediction# 1. Prepare environment
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
# 2. Download and place dataset
# Download from https://www.nii.ac.jp/dsc/idr/rdata/Tabidachi/
# Place in data/Tabidachi/annotation_data/
# 3. Run complete pipeline
cd src/Tabidachi
bash ../../scripts/run_tabidachi_experiments.sh # If script exists
# Or run manually:
python data_preprocessing.py
python create_dataset_1.py && python create_dataset_2.py
python create_dataset_3.py && python create_dataset_4.py
python train_deberta.py --method proposal&baseline1 # or baseline2
python dpo_summary_llm.py # Creates model 1
python dpo_summary_llm_more.py # Creates models 2-5
python dpo_recommendation_llm.py # Creates model 1
python dpo_recommendation_llm_more.py # Creates models 2-5
python create_recommend_data_proposal.py
python create_recommend_data_baseline1.py
python create_recommend_data_baseline2.py
python evaluate_from_recommend_data.py --method proposal # Evaluate proposed method
# 1. Download and place dataset
# Clone from https://github.com/Ryutaro-A/SumRec
# Place data in data/ChatRec/chat_and_rec/

# 2. Run complete pipeline
cd src/ChatRec
python data_preprocessing.py
python create_dataset_1.py && python create_dataset_2.py
python create_dataset_3.py && python create_dataset_4.py
python train_deberta.py --method proposal&baseline1  # or baseline2
python dpo_summary_llm.py          # Creates model 1
python dpo_summary_llm_more.py     # Creates models 2-5
python dpo_recommendation_llm.py       # Creates model 1
python dpo_recommendation_llm_more.py  # Creates models 2-5
python create_recommend_data_proposal.py
python create_recommend_data_baseline1.py
python create_recommend_data_baseline2.py
python evaluate_from_recommend_data.py --method proposal  # Evaluate proposed method
src/Tabidachi/deberta_best_model_proposal&baseline1/ or deberta_best_model_baseline2/src/Tabidachi/dpo-summary-results_[1-5]/src/Tabidachi/dpo-recommendation-results_[1-5]/src/Tabidachi/dpo-summary-results_cloudworker/src/ChatRec/ChatRec_deberta_best_model_proposal&baseline1/ or ChatRec_deberta_best_model_baseline2/src/ChatRec/dpo-summary-results_[1-5]/src/ChatRec/dpo-recommendation-results_[1-5]/data/Tabidachi/recommend_data_[method]/data/ChatRec/recommend_data_[method]/To be added
Note: This implementation is created for research purposes. For commercial use, please verify the licenses of each model and dataset.



