
README
Unnamed - 智能文件搜索引擎
一个基于 Rust 构建的智能文件搜索系统,结合了传统全文搜索(Tantivy)和 AI 语义搜索(BERT)能力,提供高效的本地文件索引和检索功能。
✨ 主要特性
- 🔍 全文搜索: 基于 Tantivy 倒排索引,支持中文分词(jieba)
- 🧠 AI 语义搜索: 使用 BERT 模型进行关键词提取和语义理解
- 📁 实时文件监控: 使用 notify 库实现增量索引
- 🚀 高性能 RPC: 基于 tarpc 框架,使用 Unix Domain Socket 通信
- 🖥️ 跨平台 GUI: 基于 egui 的图形界面客户端
- 📦 多格式支持: 支持 TXT、PDF、DOCX、Markdown 等文件格式的文本提取
- 🧪 性能基准测试: 包含两个内置benchmark测试套件
效果展示
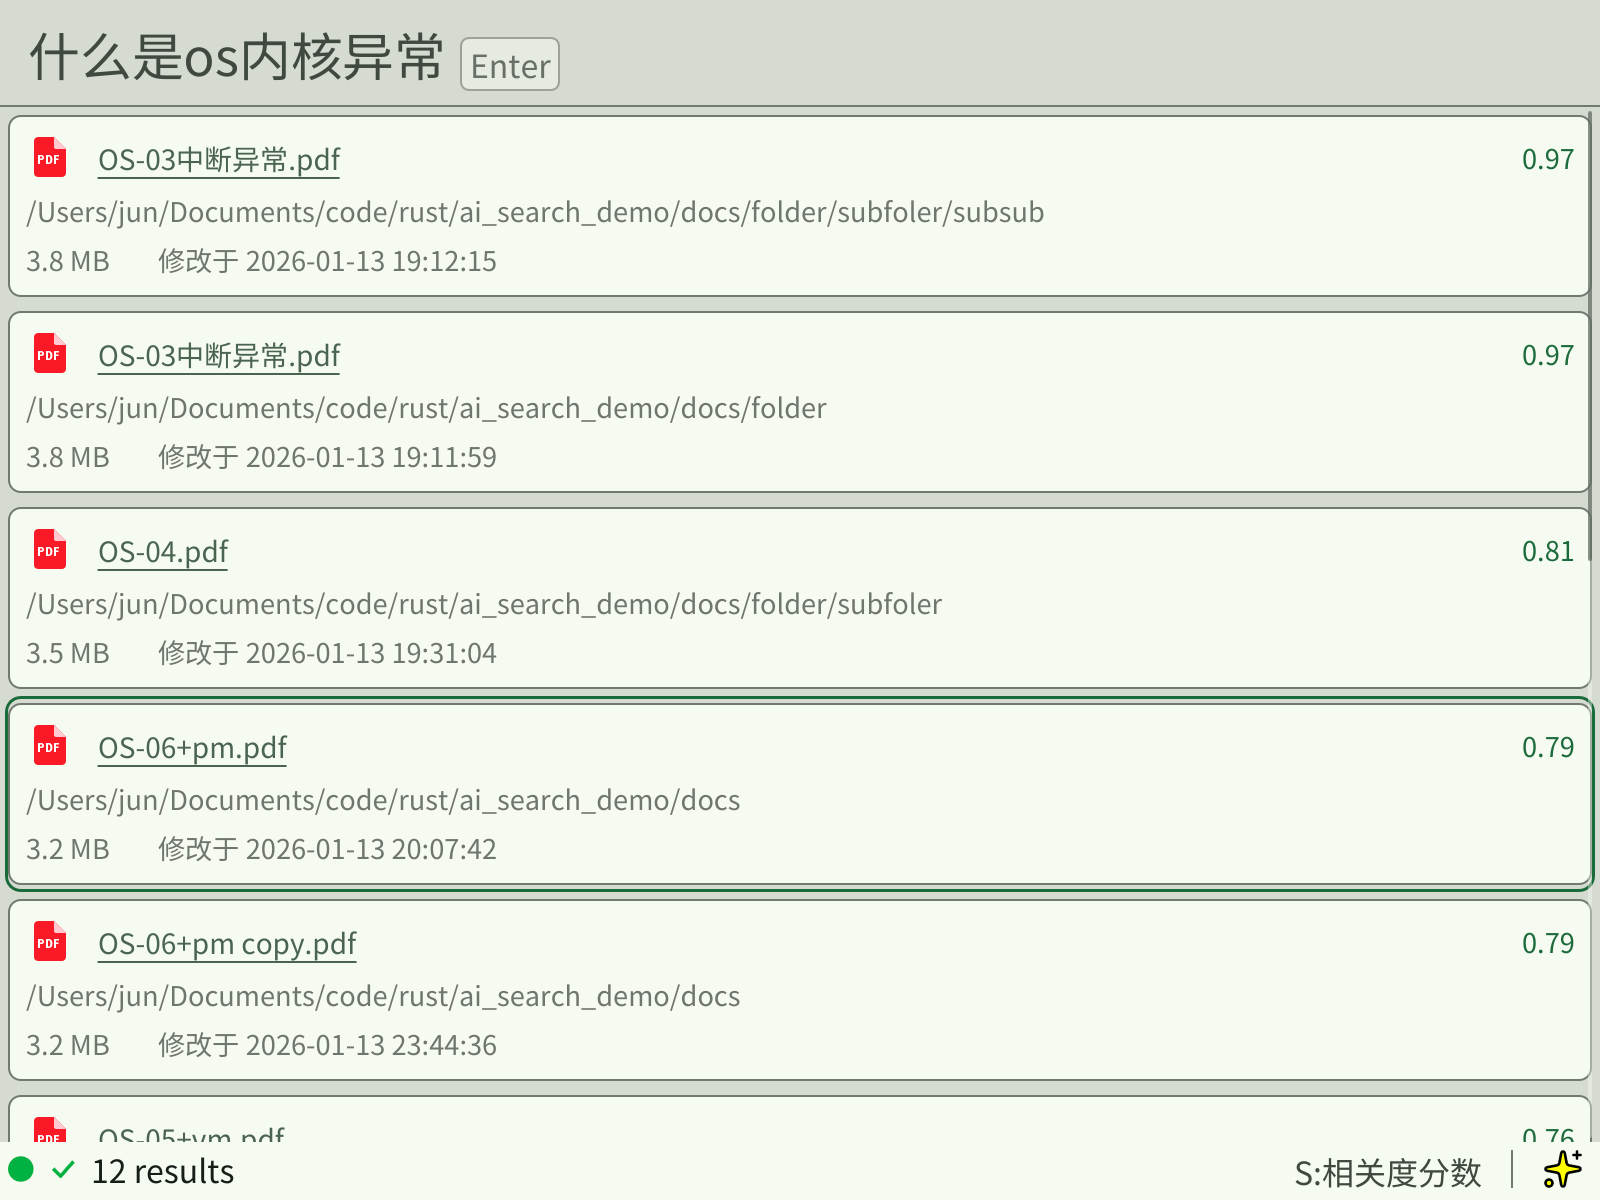
自然语言搜索
使用 AI 语义理解进行智能搜索:
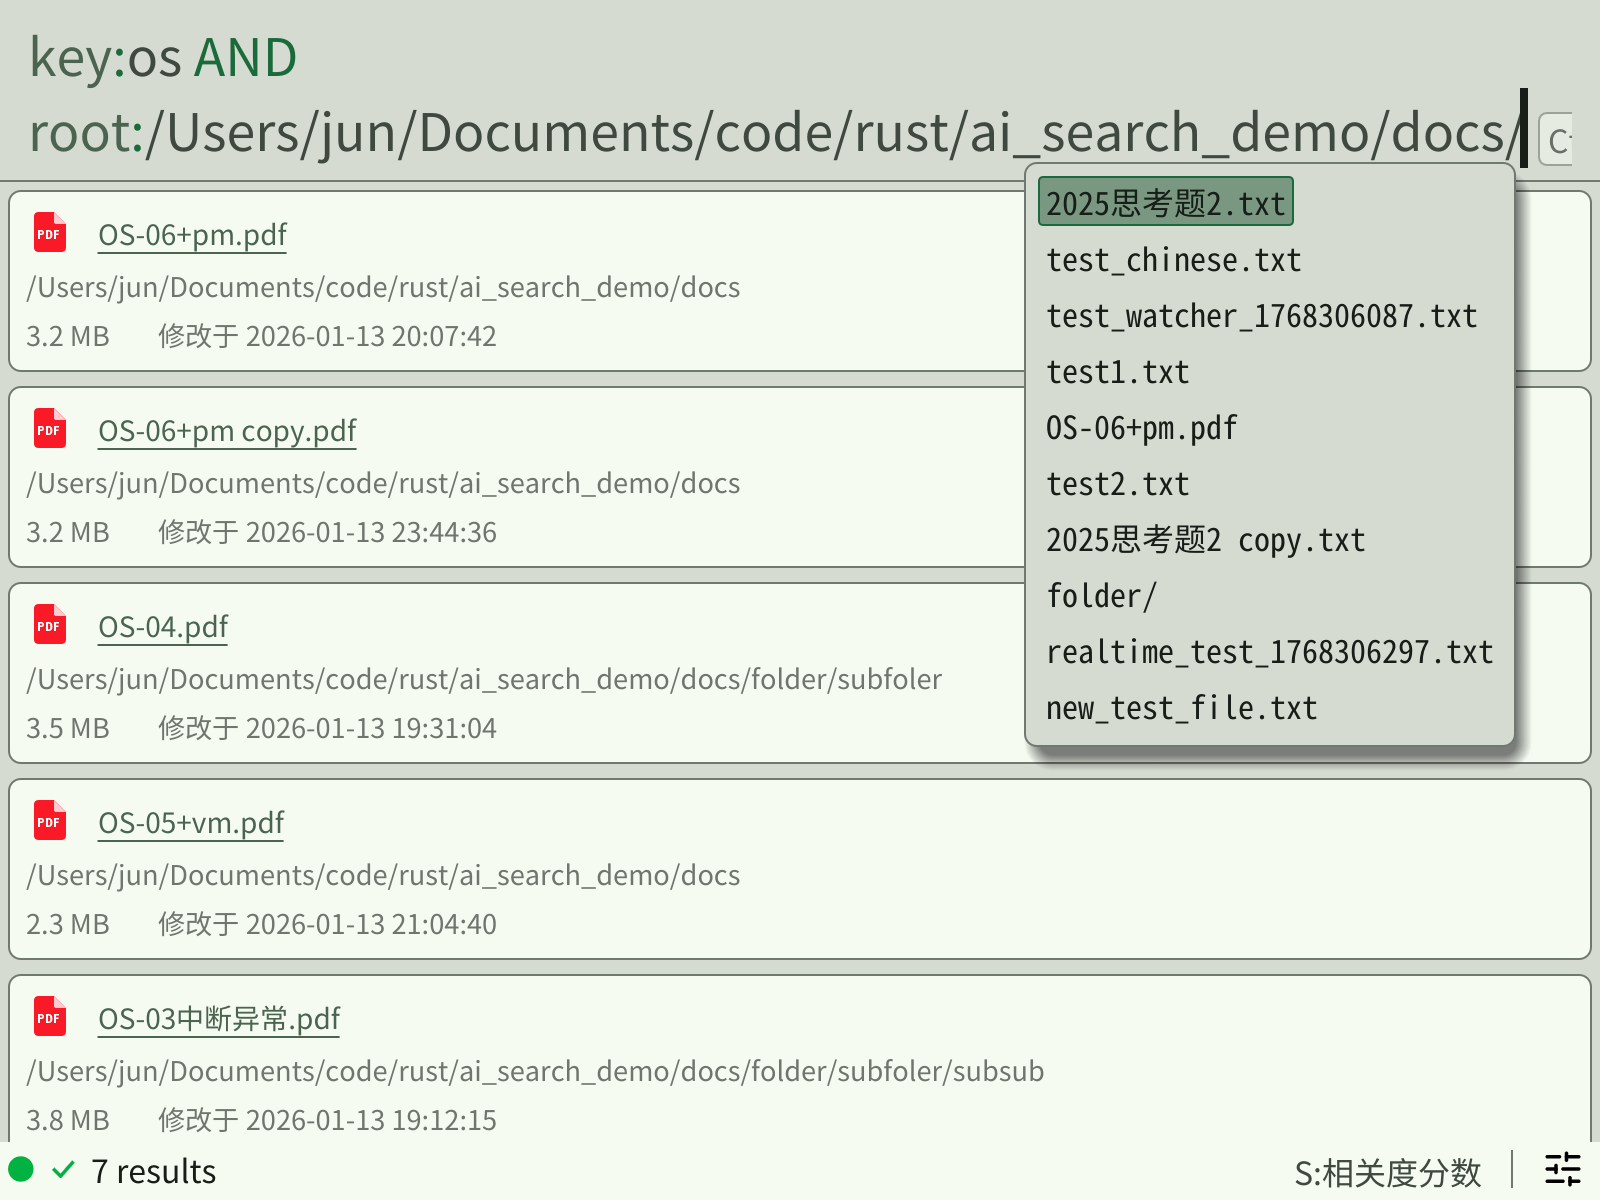
规则搜索
支持精确匹配、Glob 模式、文件过滤等高级语法:
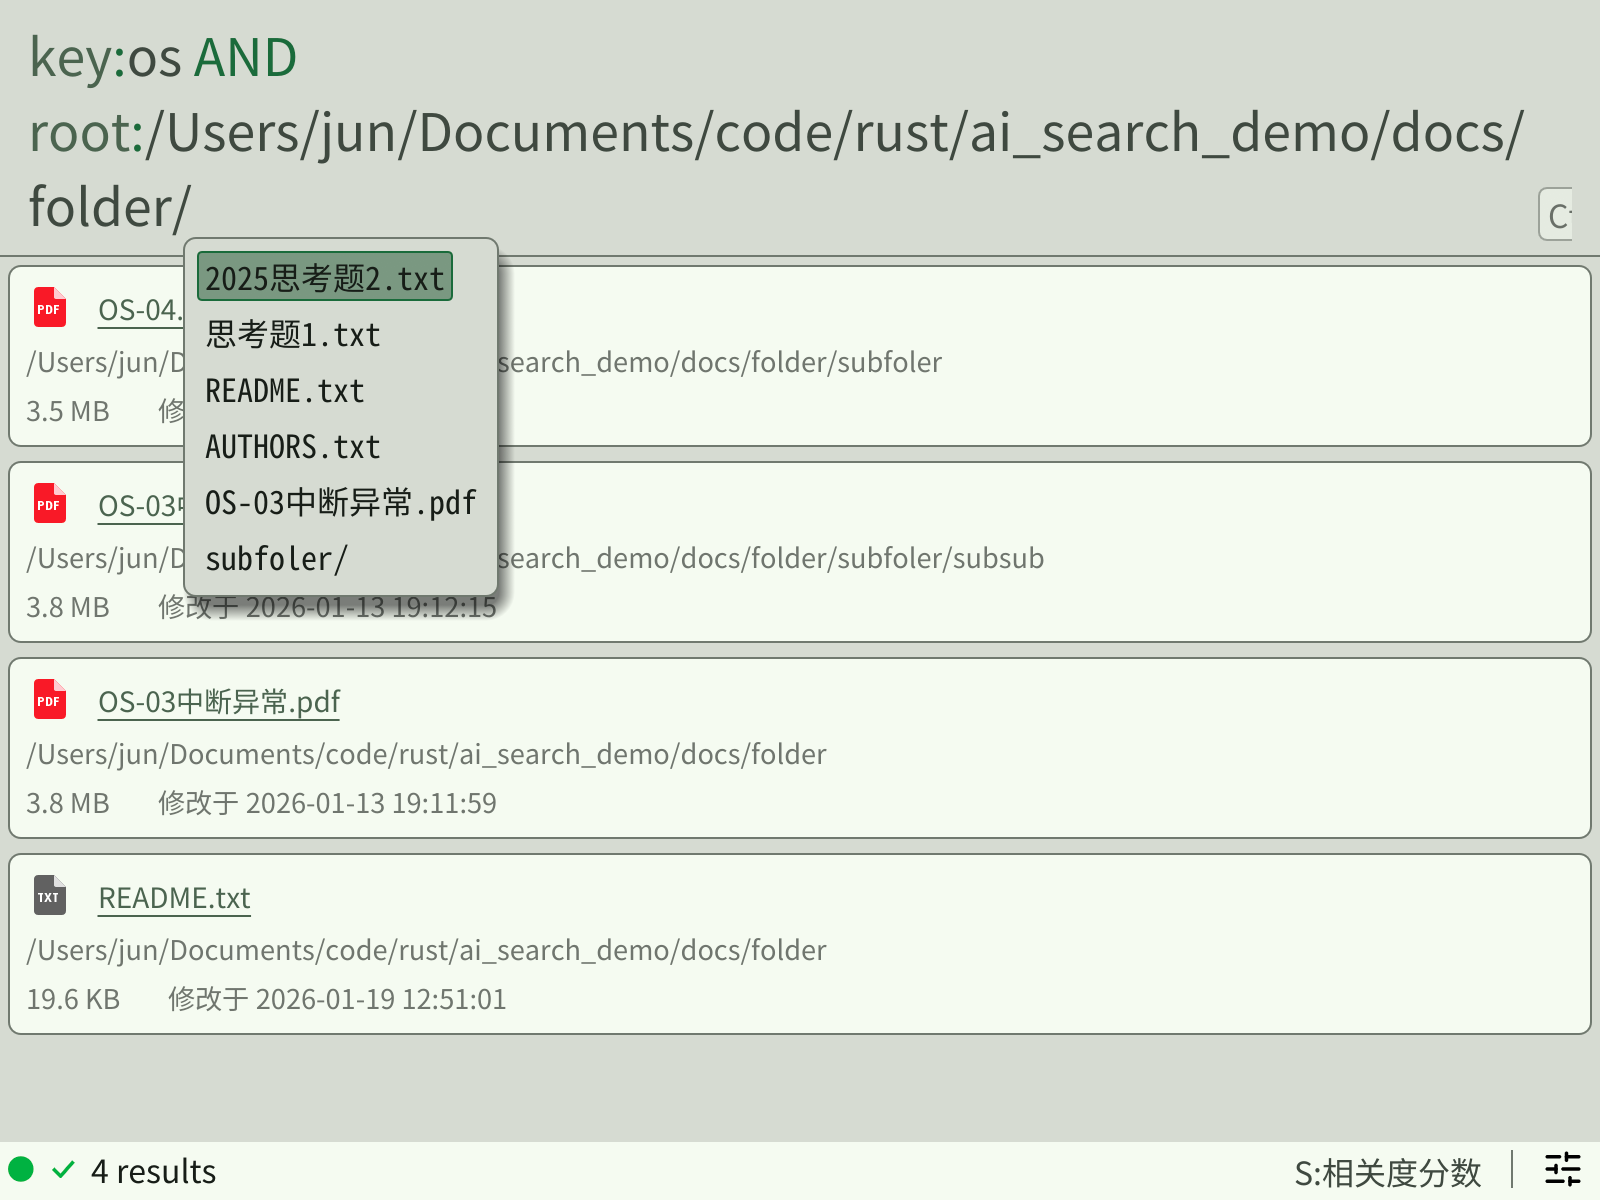
规则搜索(筛选 + 自动补全)
支持时间、大小过滤和智能补全:
🚀 快速开始
安装依赖
确保已安装 Rust 工具链(推荐使用 rustup)。
运行服务器
# 启动搜索服务
cargo run -- serve

# 或者先建立索引
cargo run -- index /path/to/documents
注意程序会从 HuggingFace 下载模型。如果遇到网络问题,可以手动下载模型 BAAI/bge-small-zh-v1.5 到 ~/.cache/huggingface/hub/models--BAAI--bge-small-zh-v1.5 目录下。
Linux inotify 限制配置
在 Linux 系统上,notify 库底层使用 inotify 机制进行文件系统事件监听。默认情况下,Linux 内核对单个用户可监控的文件/目录数量存在限制(通常为 8192),当监控大型目录树时可能会遇到 "No space left on device" 或 "Too many open files" 错误。
查看当前限制
cat /proc/sys/fs/inotify/max_user_watches
提高监控限制
若需监控大量文件,建议临时或永久提高该限制:
# 临时生效(重启后失效)
sudo sysctl fs.inotify.max_user_watches=524288

# 永久生效
echo "fs.inotify.max_user_watches=524288" | sudo tee -a /etc/sysctl.conf
sudo sysctl -p
清除缓存
cargo run -- clear-cache
运行 GUI 客户端
注意在构建运行客户端前需要下载字体到 ./apps/gui/assets 目录下。字体的 Google Drive 地址。详细可以参考 ./apps/gui/README.md。
cargo run -p gui
运行 benchmark
# 测试中文数据集
cargo run -p server --example benchmark_test -- --lang ZH

# 测试英文数据集
cargo run -p server --example benchmark_test -- --lang EN
🔧 跨平台编译
使用 cargo-zigbuild 进行交叉编译(推荐):
# 编译到 RISC-V 64 位
cargo zigbuild --release --target riscv64gc-unknown-linux-gnu
或使用 cross:
CROSS_CONTAINER_UID=0 CROSS_CONTAINER_GID=0 cross build --release --target riscv64gc-unknown-linux-gnu

# 或使用 just
just build-riscv
🧪 性能基准测试 (Benchmark)
项目包含自动化的基准测试工具,用于评估搜索引擎在不同数据集上的性能表现。
支持的数据集
📚 中文 (ZH) - DuReader
- 位置:
benchmark/ZH/ - 数据格式: JSON (keyword → [answers])
- 测试用例: 100 个关键词查询
- 文档集:
docs/extracted/中的中文文档 - 正确率表现 : 91%
🔬 英文 (EN) - 医学领域
- 位置:
benchmark/EN/ - 数据格式: JSON (keyword → [multiple_file_answers])
- 测试用例: 853 个医学术语查询
- 文档集:
processed/中的英文医学文档 - 正确率表现 : 98.01%
快速开始
运行完整基准测试
# 测试中文数据集
cargo run -p server --example benchmark_test -- --lang ZH

# 测试英文数据集
cargo run -p server --example benchmark_test -- --lang EN
Debug 模式(快速验证)
使用 --limit N 参数只测试前 N 个用例:
# 仅测试前 5 个中文用例
cargo run -p server --example benchmark_test -- --lang ZH --limit 5

# 仅测试前 10 个英文用例
cargo run -p server --example benchmark_test -- --lang EN --limit 10
工作流程
基准测试工具会自动执行以下步骤:
- 备份原有数据 - 保存现有索引和缓存
- 准备测试文档 - 将测试集文件复制到临时目录
- 建立索引 - 对测试文件集创建搜索索引
- 启动服务器 - 启动搜索服务(包括 AI 模型加载)
- 执行测试 - 运行所有测试查询,测量准确率和搜索时间
- 生成报告 - 输出结果统计和详细日志
- 恢复数据 - 删除临时文件,恢复原有索引
测试输出
基准测试会生成以下结果文件:
benchmark/<lang>/
├── result.csv          # 详细测试结果(CSV 格式)
├── report.txt          # 人类可读的测试报告
└── test_temp/          # 临时测试目录(测试后清理)
性能指标
报告包含以下关键指标:
| 指标 | 说明 |
|---|---|
| 成功率 | 成功找到目标文档的查询比例(%) |
| Top-K | 目标文档在搜索结果中排名前 K 的比例 |
| 平均搜索时间 | 所有查询的平均响应时间(ms) |
| 准确率分布 | Top-1, Top-3, Top-5, Top-10 的命中数 |
数据格式
测试数据采用统一的 JSON 格式(位于keyword_index.json中):
{
  "keyword_or_question": ["expected_answer_1", "expected_answer_2", "..."],
  "another_query": ["expected_file_name"],
  "...": ["..."]
}
- 键: 搜索关键词或问题
- 值: 预期答案文件名数组(支持多个正确答案)
生成和管理测试数据
从 CSV 生成 JSON (中文)
cd benchmark/ZH
python3 generate_keyword_index.py
从 JSON 导出 CSV (英文)
cd benchmark/EN
python3 generate_card.py
RISC-V 性能测试
本项目已在 RISC-V 64 位平台上进行测试,以下是 CPU 占用情况:
基准状态(系统空闲)

仅运行 GUI 客户端

Server 索引构建中

Server 运行中(等待请求)

Server + GUI 空闲状态

Server + GUI 搜索中

📂 项目结构
unnamed/
├── apps/                      # 应用层(可执行程序)
│   ├── server/               # 搜索服务器 🖥️
│   └── gui/                  # GUI 客户端 🎨
├── crates/                   # 核心库(可复用)
│   ├── search-core/          # 搜索引擎核心 🔍
│   ├── rpc/                  # RPC 接口定义 📡
│   ├── query/                # 查询解析器 📝
│   └── config/               # 配置管理 ⚙️
└── docs/                     # 文档 📚
    ├── ARCHITECTURE.md       # 架构文档
    └── API_REFERENCE.md      # API 参考
📂 目录详解
apps/ - 应用程序
apps/server/ - 搜索服务器
后台服务进程,负责文件索引和搜索请求处理。
| 文件/目录 | 说明 |
|---|---|
src/main.rs | 入口:CLI 解析 + 命令分发 |
src/cli.rs | Clap 命令行定义 |
src/config.rs | 配置加载(server.toml) |
src/session.rs | 会话管理器(管理搜索会话) |
src/command/serve.rs | serve 命令:启动 RPC 服务 |
src/command/index.rs | index 命令:建立文件索引 |
src/command/clear_cache.rs | clear-cache 命令:清除缓存 |
src/indexer/ | 索引辅助模块 |
examples/ | 示例客户端(test_client.rs, interactive_client.rs) |
apps/gui/ - 图形界面客户端
基于 egui 框架的跨平台桌面客户端。
| 文件/目录 | 说明 |
|---|---|
src/main.rs | 入口:eframe 初始化 |
src/app/ | 应用逻辑(状态管理、命令处理) |
src/backend/ | 后端通信(服务器状态检测) |
src/component/ | UI 组件(搜索栏、状态栏) |
src/ui/ | UI 配置(主题、字体、图标) |
src/util/ | 工具函数(查询高亮、自动补全) |
assets/icons/ | 图标资源 |
assets/trans/ | 多语言翻译文件(en.ftl, zh-hans.ftl) |
crates/ - 核心库
crates/search-core/ - 搜索引擎核心
项目的核心引擎,提供索引和搜索功能。
| 模块 | 说明 |
|---|---|
lib.rs | 库入口,定义 SearchEngine 结构体 |
ai.rs | BERT 模型封装(关键词提取) |
cache.rs | sled KV 数据库缓存(Embedding 缓存) |
indexer.rs | 索引构建与文件监控 |
search.rs | 搜索执行逻辑 |
extract.rs | 文本提取器(PDF/TXT) |
registry.rs | 文件处理协调器 |
rpc_compat.rs | RPC 类型适配层 |
models.rs | 数据模型定义 |
config.rs | 配置结构定义 |
schema/ | Tantivy 索引 Schema 构建 |
crates/rpc/ - RPC 接口定义
定义客户端与服务器之间的通信协议。
| 模块 | 说明 |
|---|---|
lib.rs | tarpc 服务 trait 定义 |
search.rs | 搜索相关类型(SearchRequest, SearchHit 等) |
API 特点:
- 异步搜索 + Offset-based 分页
- 支持流式返回和无限滚动
crates/query/ - 查询解析器
解析和验证用户查询语法。
| 模块 | 说明 |
|---|---|
lexer.rs | 词法分析器(Token 化) |
parser.rs | 语法解析器 |
validator/ | 查询验证器(时间、文件大小等) |
crates/config/ - 配置管理
提供跨平台配置路径解析。
| 模块 | 说明 |
|---|---|
lib.rs | 配置路径解析(基于 etcetera) |
constants.rs | 应用常量(名称、域名等) |
docs/ - 文档
| 文件 | 说明 |
|---|---|
ARCHITECTURE.md | 详细的项目架构文档(含时序图、依赖关系) |
API_REFERENCE.md | RPC API 接口参考文档 |
🏗️ 技术栈
📖 开发指南
环境配置
安装 EditorConfig 插件以保持代码风格一致。
项目依赖
# 主要 workspace 依赖
tokio = "1.48.0"      # 异步运行时
serde = "1.0"         # 序列化
tarpc = "0.37"        # RPC 框架
tantivy              # 全文搜索(通过 search-core)
配置文件
服务器配置示例见 server.toml.example。
📚 学习资源
- Google's Comprehensive Rust
- Rust Design Patterns
许可证
本项目采用 GNU General Public License v3 (GPLv3) 许可证。详见 LICENSE 文件。
CONTRIBUTE
欢迎提交 Issue 和 Pull Request!
Contributors


Similar repos





Languages
Rust
97.3%
Python
1.3%
README
Unnamed - 智能文件搜索引擎
一个基于 Rust 构建的智能文件搜索系统,结合了传统全文搜索(Tantivy)和 AI 语义搜索(BERT)能力,提供高效的本地文件索引和检索功能。
✨ 主要特性
- 🔍 全文搜索: 基于 Tantivy 倒排索引,支持中文分词(jieba)
- 🧠 AI 语义搜索: 使用 BERT 模型进行关键词提取和语义理解
- 📁 实时文件监控: 使用 notify 库实现增量索引
- 🚀 高性能 RPC: 基于 tarpc 框架,使用 Unix Domain Socket 通信
- 🖥️ 跨平台 GUI: 基于 egui 的图形界面客户端
- 📦 多格式支持: 支持 TXT、PDF、DOCX、Markdown 等文件格式的文本提取
- 🧪 性能基准测试: 包含两个内置benchmark测试套件
效果展示
自然语言搜索
使用 AI 语义理解进行智能搜索:
规则搜索
支持精确匹配、Glob 模式、文件过滤等高级语法:
规则搜索(筛选 + 自动补全)
支持时间、大小过滤和智能补全:
🚀 快速开始
安装依赖
确保已安装 Rust 工具链(推荐使用 rustup)。
运行服务器
# 启动搜索服务
cargo run -- serve

# 或者先建立索引
cargo run -- index /path/to/documents
注意程序会从 HuggingFace 下载模型。如果遇到网络问题,可以手动下载模型 BAAI/bge-small-zh-v1.5 到 ~/.cache/huggingface/hub/models--BAAI--bge-small-zh-v1.5 目录下。
Linux inotify 限制配置
在 Linux 系统上,notify 库底层使用 inotify 机制进行文件系统事件监听。默认情况下,Linux 内核对单个用户可监控的文件/目录数量存在限制(通常为 8192),当监控大型目录树时可能会遇到 "No space left on device" 或 "Too many open files" 错误。
查看当前限制
cat /proc/sys/fs/inotify/max_user_watches
提高监控限制
若需监控大量文件,建议临时或永久提高该限制:
# 临时生效(重启后失效)
sudo sysctl fs.inotify.max_user_watches=524288

# 永久生效
echo "fs.inotify.max_user_watches=524288" | sudo tee -a /etc/sysctl.conf
sudo sysctl -p
清除缓存
cargo run -- clear-cache
运行 GUI 客户端
注意在构建运行客户端前需要下载字体到 ./apps/gui/assets 目录下。字体的 Google Drive 地址。详细可以参考 ./apps/gui/README.md。
cargo run -p gui
运行 benchmark
# 测试中文数据集
cargo run -p server --example benchmark_test -- --lang ZH

# 测试英文数据集
cargo run -p server --example benchmark_test -- --lang EN
🔧 跨平台编译
使用 cargo-zigbuild 进行交叉编译(推荐):
# 编译到 RISC-V 64 位
cargo zigbuild --release --target riscv64gc-unknown-linux-gnu
或使用 cross:
CROSS_CONTAINER_UID=0 CROSS_CONTAINER_GID=0 cross build --release --target riscv64gc-unknown-linux-gnu

# 或使用 just
just build-riscv
🧪 性能基准测试 (Benchmark)
项目包含自动化的基准测试工具,用于评估搜索引擎在不同数据集上的性能表现。
支持的数据集
📚 中文 (ZH) - DuReader
- 位置:
benchmark/ZH/ - 数据格式: JSON (keyword → [answers])
- 测试用例: 100 个关键词查询
- 文档集:
docs/extracted/中的中文文档 - 正确率表现 : 91%
🔬 英文 (EN) - 医学领域
- 位置:
benchmark/EN/ - 数据格式: JSON (keyword → [multiple_file_answers])
- 测试用例: 853 个医学术语查询
- 文档集:
processed/中的英文医学文档 - 正确率表现 : 98.01%
快速开始
运行完整基准测试
# 测试中文数据集
cargo run -p server --example benchmark_test -- --lang ZH

# 测试英文数据集
cargo run -p server --example benchmark_test -- --lang EN
Debug 模式(快速验证)
使用 --limit N 参数只测试前 N 个用例:
# 仅测试前 5 个中文用例
cargo run -p server --example benchmark_test -- --lang ZH --limit 5

# 仅测试前 10 个英文用例
cargo run -p server --example benchmark_test -- --lang EN --limit 10
工作流程
基准测试工具会自动执行以下步骤:
- 备份原有数据 - 保存现有索引和缓存
- 准备测试文档 - 将测试集文件复制到临时目录
- 建立索引 - 对测试文件集创建搜索索引
- 启动服务器 - 启动搜索服务(包括 AI 模型加载)
- 执行测试 - 运行所有测试查询,测量准确率和搜索时间
- 生成报告 - 输出结果统计和详细日志
- 恢复数据 - 删除临时文件,恢复原有索引
测试输出
基准测试会生成以下结果文件:
benchmark/<lang>/
├── result.csv          # 详细测试结果(CSV 格式)
├── report.txt          # 人类可读的测试报告
└── test_temp/          # 临时测试目录(测试后清理)
性能指标
报告包含以下关键指标:
| 指标 | 说明 |
|---|---|
| 成功率 | 成功找到目标文档的查询比例(%) |
| Top-K | 目标文档在搜索结果中排名前 K 的比例 |
| 平均搜索时间 | 所有查询的平均响应时间(ms) |
| 准确率分布 | Top-1, Top-3, Top-5, Top-10 的命中数 |
数据格式
测试数据采用统一的 JSON 格式(位于keyword_index.json中):
{
  "keyword_or_question": ["expected_answer_1", "expected_answer_2", "..."],
  "another_query": ["expected_file_name"],
  "...": ["..."]
}
- 键: 搜索关键词或问题
- 值: 预期答案文件名数组(支持多个正确答案)
生成和管理测试数据
从 CSV 生成 JSON (中文)
cd benchmark/ZH
python3 generate_keyword_index.py
从 JSON 导出 CSV (英文)
cd benchmark/EN
python3 generate_card.py
RISC-V 性能测试
本项目已在 RISC-V 64 位平台上进行测试,以下是 CPU 占用情况:
基准状态(系统空闲)
仅运行 GUI 客户端
Server 索引构建中
Server 运行中(等待请求)
Server + GUI 空闲状态
Server + GUI 搜索中
📂 项目结构
unnamed/
├── apps/                      # 应用层(可执行程序)
│   ├── server/               # 搜索服务器 🖥️
│   └── gui/                  # GUI 客户端 🎨
├── crates/                   # 核心库(可复用)
│   ├── search-core/          # 搜索引擎核心 🔍
│   ├── rpc/                  # RPC 接口定义 📡
│   ├── query/                # 查询解析器 📝
│   └── config/               # 配置管理 ⚙️
└── docs/                     # 文档 📚
    ├── ARCHITECTURE.md       # 架构文档
    └── API_REFERENCE.md      # API 参考
📂 目录详解
apps/ - 应用程序
apps/server/ - 搜索服务器
后台服务进程,负责文件索引和搜索请求处理。
| 文件/目录 | 说明 |
|---|---|
src/main.rs | 入口:CLI 解析 + 命令分发 |
src/cli.rs | Clap 命令行定义 |
src/config.rs | 配置加载(server.toml) |
src/session.rs | 会话管理器(管理搜索会话) |
src/command/serve.rs | serve 命令:启动 RPC 服务 |
src/command/index.rs | index 命令:建立文件索引 |
src/command/clear_cache.rs | clear-cache 命令:清除缓存 |
src/indexer/ | 索引辅助模块 |
examples/ | 示例客户端(test_client.rs, interactive_client.rs) |
apps/gui/ - 图形界面客户端
基于 egui 框架的跨平台桌面客户端。
| 文件/目录 | 说明 |
|---|---|
src/main.rs | 入口:eframe 初始化 |
src/app/ | 应用逻辑(状态管理、命令处理) |
src/backend/ | 后端通信(服务器状态检测) |
src/component/ | UI 组件(搜索栏、状态栏) |
src/ui/ | UI 配置(主题、字体、图标) |
src/util/ | 工具函数(查询高亮、自动补全) |
assets/icons/ | 图标资源 |
assets/trans/ | 多语言翻译文件(en.ftl, zh-hans.ftl) |
crates/ - 核心库
crates/search-core/ - 搜索引擎核心
项目的核心引擎,提供索引和搜索功能。
| 模块 | 说明 |
|---|---|
lib.rs | 库入口,定义 SearchEngine 结构体 |
ai.rs | BERT 模型封装(关键词提取) |
cache.rs | sled KV 数据库缓存(Embedding 缓存) |
indexer.rs | 索引构建与文件监控 |
search.rs | 搜索执行逻辑 |
extract.rs | 文本提取器(PDF/TXT) |
registry.rs | 文件处理协调器 |
rpc_compat.rs | RPC 类型适配层 |
models.rs | 数据模型定义 |
config.rs | 配置结构定义 |
schema/ | Tantivy 索引 Schema 构建 |
crates/rpc/ - RPC 接口定义
定义客户端与服务器之间的通信协议。
| 模块 | 说明 |
|---|---|
lib.rs | tarpc 服务 trait 定义 |
search.rs | 搜索相关类型(SearchRequest, SearchHit 等) |
API 特点:
- 异步搜索 + Offset-based 分页
- 支持流式返回和无限滚动
crates/query/ - 查询解析器
解析和验证用户查询语法。
| 模块 | 说明 |
|---|---|
lexer.rs | 词法分析器(Token 化) |
parser.rs | 语法解析器 |
validator/ | 查询验证器(时间、文件大小等) |
crates/config/ - 配置管理
提供跨平台配置路径解析。
| 模块 | 说明 |
|---|---|
lib.rs | 配置路径解析(基于 etcetera) |
constants.rs | 应用常量(名称、域名等) |
docs/ - 文档
| 文件 | 说明 |
|---|---|
ARCHITECTURE.md | 详细的项目架构文档(含时序图、依赖关系) |
API_REFERENCE.md | RPC API 接口参考文档 |
🏗️ 技术栈
📖 开发指南
环境配置
安装 EditorConfig 插件以保持代码风格一致。
项目依赖
# 主要 workspace 依赖
tokio = "1.48.0"      # 异步运行时
serde = "1.0"         # 序列化
tarpc = "0.37"        # RPC 框架
tantivy              # 全文搜索(通过 search-core)
配置文件
服务器配置示例见 server.toml.example。
📚 学习资源
- Google's Comprehensive Rust
- Rust Design Patterns
许可证
本项目采用 GNU General Public License v3 (GPLv3) 许可证。详见 LICENSE 文件。
CONTRIBUTE
欢迎提交 Issue 和 Pull Request!
Similar repos
Contributors
Languages
Rust
97.3%
Python
1.3%