
README
Typora / Vscode打开体验感更好
大模型八股
阅读导航
Part A:基础架构与推理机制
- 输入处理与编码:Tokenizer、RoPE、RoPE扩展策略、RMSNorm、PreNorm/PostNorm
- 注意力机制与缓存:Causal Mask/Attention Mask、MHA、KV Cache、MQA、GQA、CrossAttention、MLA、Flash Attention
- 激活函数与专家结构:SwiGLU、DeepSeekMOE
- 推理加速:DeepSeekMTP
Part B:训练与对齐
- 训练流程与损失:DeepSeek R1 训练流程、预训练和 SFT 的损失函数
- 无参适配能力:上下文学习(ICL)
- 能力回灌机制:自蒸馏(Self-Distillation)
- 监督微调:SFT、LoRA(含 LoRI、QLoRA、HiRA)
- 偏好对齐与强化学习:RLHF、DPO、PPO、GRPO、DAPO、GSPO
Part C:模型系列深度调研
- Qwen 系列完整技术演进深度调研报告 — 覆盖 Qwen-VL → Qwen2-VL → Qwen2.5-VL → Qwen3-VL → Qwen3-Omni 全系列架构演进与多模态面试考点
大模型基础架构与推理机制
大模型整体结构
从工程实现视角看,一个标准 Decoder-only 大模型通常由以下模块串联而成:
1、输入与嵌入层(Embedding)
- Tokenizer:将原始文本切分为 token 序列,并完成 token id 映射。
- Token Embedding:把离散 token 映射到连续向量空间。
- Positional 信息注入:常见是 RoPE,把位置信息编码进 Q/K。
2、Transformer 主干(重复堆叠 N 层)
- Attention 子层:建模 token 间依赖关系。
- FFN 子层:做非线性特征变换(常见激活函数是 SwiGLU)。
- Norm 与残差:常见 PreNorm 结构,保证深层训练稳定。
3、输出层(LM Head)
- 将隐藏状态投影到词表维度,得到每个 token 的 logits。
- 经过 softmax 得到下一 token 概率分布。
4、可选增强模块
- MoE:用稀疏激活专家提升参数规模与性能上限。
- MTP/Speculative 类思路:优化解码阶段吞吐。
- KV Cache/Flash Attention:优化长序列推理的延迟与显存。
一句话理解:Embedding 负责“看懂输入”,Transformer 负责“加工语义”,LM Head 负责“给出下一个 token 的概率”。
编码与归一化
Tokenizer(分词器)
Tokenizer 是大模型输入链路的第一步,作用是把自然语言文本转成模型可计算的离散 token id 序列。
1、为什么 Tokenizer 很关键?
- 它决定了“一个词被切成几个 token”,直接影响序列长度、推理成本和训练效率。
- 它影响多语言、代码、符号场景下的表达能力。
- 它与词表大小共同决定 Embedding/LM Head 参数规模。
2、常见分词算法
- BPE(Byte Pair Encoding):通过频繁子串合并构建词表,工程上非常常见。
- WordPiece:与 BPE 相近,但采用不同的合并评分策略。
- Unigram:基于概率模型选择子词集合,常见于 SentencePiece。
3、训练与推理中的影响
- 训练:同一语料下,分词粒度会影响 token 总量和训练吞吐。
- 推理:更细粒度通常带来更长上下文长度与更高时延。
- 对齐:特殊 token(如 BOS/EOS、系统标记)会影响指令跟随与模板稳定性。
一句话理解:Tokenizer 不只是“切词工具”,而是决定模型输入空间形态与计算成本的底层组件。
RoPE旋转位置编码
基础概念
RoPE(Rotary Position Embedding)的核心在于用旋转矩阵在复数域进行操作替代传统的位置向量叠加操作,既能保留绝对位置信息,又能显式建模相对位置关系。传统绝对位置编码直接与词向量叠加,经过线性变换后,位置信息的远程衰减特性易被破坏。
核心优势
1、远程衰减性:内积结果随相对距离增大呈震荡衰减趋势,符合自然语言中邻近词关联更强的特性。
2、外推能力:旋转操作的周期性允许模型处理超过训练长度的序列,如训练时使用4K长度,推理可扩展至32K。
3、正交性保持:旋转矩阵是正交矩阵,保持向量模长不变,增强模型训练稳定性。
长上下文扩展策略(RoPE 怎么扩)
当训练长度较短、推理长度更长时,常见做法不是完全重训,而是对 RoPE 频率或位置映射做伸缩。
1、位置插值(Position Interpolation)
- 核心思想:把长上下文的位置索引压缩映射回训练时的有效区间。
- 直观理解:把“更长的尺子”按比例缩放后再喂给 RoPE。
- 优点是实现简单、成本低;缺点是过长时可能损失局部细节。
2、NTK-aware Scaling
- 核心思想:按神经切线核(NTK)视角重标定 RoPE 的频率分布,减缓长距离外推失真。
- 实践上常表现为对 base 或频率项做分段/比例缩放。
- 相比简单插值,通常在更长上下文下稳定性更好。
3、YaRN(Yet another RoPE extension)
- 核心思想:在 RoPE 扩展时采用更平滑、分段的缩放策略,兼顾短上下文性能与长上下文外推。
- 常见做法是结合“短段保真 + 长段拉伸”,减少直接硬缩放带来的退化。
- 工程上常用于把 4K/8K 模型扩到更长上下文,同时尽量不牺牲原能力。
一句话总结:位置插值偏“简单可用”,NTK-aware 偏“理论一致性”,YaRN 偏“工程折中与鲁棒性”。
手撕代码
import torch
from typing import Tuple

def precompute_freqs_cis(dim: int, seq_len: int, freqs: float = 10000.0):
    # 计算词向量元素两两分组之后,每组元素对应的旋转角度
    theta = 1.0 / (freqs ** (torch.arange(0, dim, 2).float() / dim))

    # 生成 token 序列索引 t = [0, 1,..., seq_len-1]
    t = torch.arange(seq_len)
    # theta.shape = [seq_len, dim // 2]
    theta = torch.outer(t, theta).float()
    # torch.polar的文档, https://pytorch.org/docs/stable/generated/torch.polar.html
    # torch.polar输入参数是abs和angle,abs所有值都一样,abs和angle的shape都一样
    # torch.polar输入参数是abs和angle,则theta_cis = abs*(cos(angle) + sin(angle)i)
    theta_cis = torch.polar(torch.ones_like(theta), theta)
    return theta_cis

def apply_rotary_emb(
    xq: torch.Tensor,
    xk: torch.Tensor,
    theta_cis: torch.Tensor,
) -> Tuple[torch.Tensor, torch.Tensor]:
    # xq.shape = [batch_size, seq_len, dim]
    # xq_.shape = [batch_size, seq_len, dim // 2, 2]
    xq_ = xq.float().reshape(*xq.shape[:-1], -1, 2)
    xk_ = xk.float().reshape(*xk.shape[:-1], -1, 2)

    # 转为复数域,  xq_.shape = [batch_size, seq_len, dim // 2]
    xq_ = torch.view_as_complex(xq_)
    xk_ = torch.view_as_complex(xk_)
    # 应用旋转操作,然后将结果转回实数域
    # xq_out.shape = [batch_size, seq_len, dim]
    xq_out = torch.view_as_real(xq_ * theta_cis).flatten(2) #从dim=2维度开始拍平
    xk_out = torch.view_as_real(xk_ * theta_cis).flatten(2)

    return xq_out.type_as(xq), xk_out.type_as(xk)

if __name__ == '__main__':
    seq_len,dim=3,4
    freqs_cis = precompute_freqs_cis(dim=dim, seq_len=seq_len)
    xq = torch.rand(1, seq_len, dim)
    xk = torch.rand(1, seq_len, dim)
    res = apply_rotary_emb(xq, xk, freqs_cis)
RMSNorm
基础概念
归一化的核心目标是缓解内部协变量偏移问题,即网络中间层输入分布随参数更新而发生改变。主要有以下好处:
1、提升训练效率:归一化使每一层的输入分布更加稳定,从而允许使用更高的学习率,加快收敛速度。
2、保持梯度稳定:通过控制激活值的尺度,减少梯度消失或者梯度爆炸,适合深层网络的训练。
3、引入归纳偏置:归一化在一定程度上对输入进行标准化,降低了模型对输入尺度的敏感性,增强了泛化能力。
核心优势
为什么现在的大模型都用RMSNorm,而不使用BatchNorm和LayerNorm?
1、任务特性不匹配: 大模型多用于NLP,输入为变长序列,BatchNorm依赖batch统计量,在batch size小和序列长度不固定时不稳定。
LayerNorm和RMSNorm按样本独立归一化,天然适配序列建模。
2、训练稳定性:
BatchNorm在训练和推理阶段行为不同(训练用batch统计量,推理用移动平均),引入不确定性。
LayerNorm和RMSNorm训练推理一致,更稳定。
3、可扩展性与效率:
BatchNorm在分布式训练中需跨设备同步统计量,通信开销大。
LayerNorm和RMSNorm无需跨batch通信,更适合大规模并行训练。
RMSNorm进一步简化计算(只有缩放因子gamma,没有中心化beta),减少参数量,提高吞吐。
手撕代码
$$ \mathrm{RMSNorm}(\mathbf{x}) = \frac{\mathbf{x}}{\sqrt{\frac{1}{d} \sum_{i=1}^{d} x_i^2 + \epsilon}} \odot \mathbf{g} $$
import torch
from torch import nn

class RMSNorm(torch.nn.Module):
    def __init__(self, dim: int, eps: float = 1e-6):
        super().__init__()
        self.eps = eps
        self.weights = nn.Parameter(torch.ones(dim))

    def _norm(self, x):
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim = True) + self.eps)

    def forward(self, x):
        output = self._norm(x.float()).type_as(x)
        return output * self.weights
归一化模块位置的影响
| 特征 | PostNorm | PreNorm |
|---|---|---|
| 归一化位置 | 残差连接之后 | 残差连接之前 |
| 公式形式 | y = Norm( x + F(x) ) | y = F( Norm( x ) ) + x |
| 梯度传播 | 初始阶段梯度较大,后期稳定 | 梯度更平滑,训练更稳定 |
| 收敛速度 | 较慢,需小心调参 | 更快,对学习率更鲁棒 |
| 最终性能 | 可达最优,但训练难度高 | 更易训练,性能更稳定 |
大模型使用PreNorm的优势: 每个子层输入都被归一化,信号尺度更可控。
残差连接保持“恒等映射”主导,梯度传播更平滑。
显著提升训练稳定性,尤其在深层网络中。
注意力机制与缓存
Causal Mask / Attention Mask
在自回归大模型中,Mask 的作用是约束“哪些位置可以互相注意到”,防止信息泄漏并屏蔽无效 token。
1、Causal Mask(因果掩码)
- 目标:保证第 $t$ 个 token 只能看见 $\le t$ 的历史位置,不能看到未来位置。
- 常见实现:上三角置为 $-\infty$,在 softmax 后未来位置权重变为 0。
- 作用:满足自回归训练目标,避免训练时“偷看答案”。
2、Attention Mask(注意力掩码)
- 目标:屏蔽 padding、无效区段或不应关注的 token。
- 在实际系统中,常与 Causal Mask 叠加使用。
- 在多轮对话或长文档场景,可扩展为更复杂的块状/窗口式掩码。
一句话理解:Causal Mask 决定“时间方向约束”,Attention Mask 决定“有效内容边界”。
大模型推理过程(Inference Pipeline)
从在线服务角度,推理通常分为两个阶段:
1、Prefill(上下文编码阶段)
- 输入完整 prompt,一次性并行计算所有历史 token 的表示。
- 这个阶段计算密集,耗时通常与 prompt 长度近似线性相关。
- 同时会把各层的 K/V 写入缓存(KV Cache),供后续复用。
2、Decode(自回归生成阶段)
- 每一步只生成 1 个新 token(或少量 token)。
- 新 token 的 Q 与历史 KV 做注意力,避免重复计算历史部分。
- 直到命中 EOS、长度上限或停止词。
3、采样与生成策略
- Greedy:每步取最大概率 token,稳定但保守。
- Top-k / Top-p:限制候选集合后采样,提升多样性。
- Temperature:控制分布平滑度,越大越发散,越小越确定。
4、性能瓶颈与优化点
- 长 prompt 场景瓶颈常在 Prefill。
- 长输出场景瓶颈常在 Decode 与 KV 读写。
- 常见优化:Flash Attention、Paged KV Cache、MQA/GQA、连续批处理(Continuous Batching)。
这也是为什么很多推理优化论文都在围绕“减少内存访问 + 增强并行利用率”展开。
MHA多头注意力机制
基础概念
$$ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V $$
因为这里矩阵的点积,是对矩阵元素逐个相乘再相加,如果序列过长会导致结果过大,除以sqrt(d)是为了进行缩放,防止点积结果过大导致softmax函数梯度消失。简单来说,就是需要压缩softmax输入值,以免输入值过大,进入了softmax的饱和区,导致梯度值太小而难以训练。
核心优势
多个头能够在训练中学会注意到不同的内容。例如在翻译任务中,一些attention head可以关注语法特征,另一些attention head可以关注单词特性。这样模型就可以从不同角度来分析和理解输入信息。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiHeadAttention(nn.Module):
    def __init__(self, dim:int, head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        assert self.dim % head_num == 0
        self.head_dim = self.dim // self.head_num

        self.q = nn.Linear(dim, dim)
        self.k = nn.Linear(dim, dim)
        self.v = nn.Linear(dim, dim)

        self.fc = nn.Linear(dim, dim)
    def forward(self, x, mask = None):
        b, s, d = x.shape

        q = self.q(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)
        k = self.k(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)
        v = self.v(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)

        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        attn_weight = F.softmax(attn_score, dim = -1)
        output = torch.matmul(attn_weight, v)

        output = output.transpose(1, 2).contiguous().view(b, s ,d)

        return self.fc(output)
解码中的KV Cache
1、什么是 KV cache?
在 Transformer 推理中,把历史生成的 Key (K) 和 Value (V) 缓存在显存里,供后续新 token 的注意力计算使用。
2、KV 的优势是什么?
避免重复计算历史 token 的 K/V,大幅降低推理开销;Prefill 阶段后,每一步只需计算新 token 的 Q,再用缓存的 K/V,就能做到 从 O(n²) 降到 O(n) 的计算量。
3、为什么缓存 K/V,而不缓存 Q?
-
Q 只对当前 token 生效,用完即弃,不会在未来复用。
-
K/V 会被所有后续 token 的注意力查询重复使用,所以必须缓存。
MQA多Query注意力机制
基础概念
MQA 是对 多头注意力(Multi-Head Attention, MHA) 的一种优化:
传统 MHA:每个头都有独立的 Q、K、V 投影矩阵,每个头的 Key/Value 都单独计算并缓存。
MQA:每个头仍然有自己的 Q(保持不同注意力模式),但 所有头共享同一份 K/V。
这样,每个头使用不同的 Q 对同一份 K/V 做注意力计算,显著减少计算量和显存占用。
核心优势
- 显存占用大幅降低
- 推理时需要缓存 KV(KV cache)以加速生成。
- MHA 每个头都要缓存 K/V,显存占用高;MQA 只缓存一份 K/V,显存降低约为头数倍。
- 推理速度更快
- KV 只计算一次,多头共享,减少重复计算,尤其对长序列生成效果明显。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiQueryAttention(nn.Module):
    def __init__(self, dim: int, head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        assert self.dim % head_num == 0
        self.head_dim = self.dim // self.head_num

        # Q 仍然有多个 head
        self.q = nn.Linear(dim, dim)
        # K 和 V 只有一个 head,由所有 query heads 共享
        self.k = nn.Linear(dim, self.head_dim)
        self.v = nn.Linear(dim, self.head_dim)

        self.fc = nn.Linear(dim, dim)

    def forward(self, x, mask=None):
        b, s, d = x.shape

        # Q 有多个 head: (batch, head_num, seq_len, head_dim)
        q = self.q(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)

        # K 和 V 只有一个 head: (batch, seq_len, head_dim)
        k = self.k(x)  # (b, s, head_dim)
        v = self.v(x)  # (b, s, head_dim)

        # 将 K 和 V 扩展到所有 head: (batch, head_num, seq_len, head_dim)
        k = k.unsqueeze(1).expand(b, self.head_num, s, self.head_dim)
        v = v.unsqueeze(1).expand(b, self.head_num, s, self.head_dim)

        # 计算注意力分数
        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        attn_weight = F.softmax(attn_score, dim=-1)
        output = torch.matmul(attn_weight, v)

        # 重新组合所有 head 的输出
        output = output.transpose(1, 2).contiguous().view(b, s, d)

        return self.fc(output)
GQA组注意力机制
把多个头划分成若干组(group),每组内的头共享同一份 K/V,但不同组之间的 K/V 还是独立的。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class GroupedQueryAttention(nn.Module):
    def __init__(self, dim: int, head_num: int, kv_head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        self.kv_head_num = kv_head_num

        assert self.dim % head_num == 0
        assert head_num % kv_head_num == 0, "head_num must be divisible by kv_head_num"

        self.head_dim = self.dim // self.head_num
        self.group_size = self.head_num // self.kv_head_num  # 每组的 query head 数量

        # Q 有 head_num 个 head
        self.q = nn.Linear(dim, dim)
        # K 和 V 有 kv_head_num 个 head
        self.k = nn.Linear(dim, kv_head_num * self.head_dim)
        self.v = nn.Linear(dim, kv_head_num * self.head_dim)

        self.fc = nn.Linear(dim, dim)

    def forward(self, x, mask=None):
        b, s, d = x.shape

        # Q: (batch, head_num, seq_len, head_dim)
        q = self.q(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)

        # K, V: (batch, kv_head_num, seq_len, head_dim)
        k = self.k(x).view(b, s, self.kv_head_num, self.head_dim).transpose(1, 2)
        v = self.v(x).view(b, s, self.kv_head_num, self.head_dim).transpose(1, 2)

        # 将 K 和 V 重复以匹配 Q 的 head 数量
        # 每个 KV head 对应 group_size 个 Q head
        k = k.repeat_interleave(self.group_size, dim=1)  # (batch, head_num, seq_len, head_dim)
        v = v.repeat_interleave(self.group_size, dim=1)  # (batch, head_num, seq_len, head_dim)

        # 计算注意力分数
        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        attn_weight = F.softmax(attn_score, dim=-1)
        output = torch.matmul(attn_weight, v)

        # 重新组合所有 head 的输出
        output = output.transpose(1, 2).contiguous().view(b, s, d)

        return self.fc(output)
CrossAttention交叉注意力机制
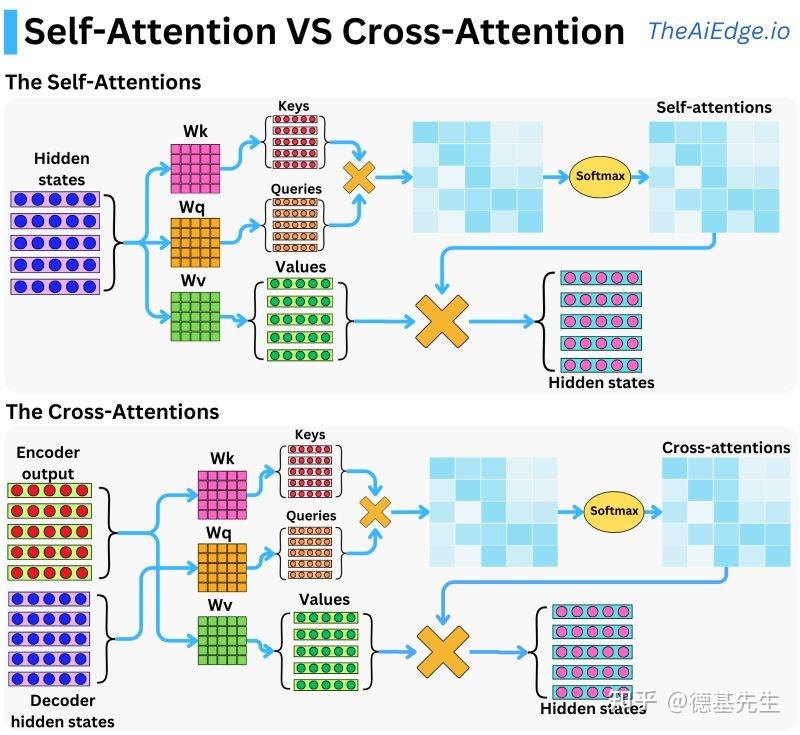
交叉注意力机制一般用于在多模态的学习中,融合多个部分的信息,在这里面一般以查询方的信息作为Q(Decoder的输入),信息的提供方作为KV,然后Q与K计算得出信息相关度,再与V进行相乘得到最终的值。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class CrossAttention(nn.Module):
    """
    交叉注意力机制实现
    - Query来自目标序列(如decoder的输入)
    - Key和Value来自源序列(如encoder的输出)
    """
    def __init__(self, dim: int, head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        assert self.dim % head_num == 0
        self.head_dim = self.dim // self.head_num

        # Query投影层 - 来自目标序列
        self.q = nn.Linear(dim, dim)
        # Key和Value投影层 - 来自源序列
        self.k = nn.Linear(dim, dim)
        self.v = nn.Linear(dim, dim)

        # 输出投影层
        self.fc = nn.Linear(dim, dim)

    def forward(self, query_seq, key_value_seq, mask=None):
        """
        前向传播
        Args:
            query_seq: 查询序列 (batch_size, query_len, dim)
            key_value_seq: 键值序列 (batch_size, kv_len, dim)
            mask: 注意力掩码 (batch_size, head_num, query_len, kv_len) 或可广播的形状
        Returns:
            输出序列 (batch_size, query_len, dim)
        """
        b, query_len, d = query_seq.shape
        _, kv_len, _ = key_value_seq.shape

        # 计算Q, K, V
        q = self.q(query_seq).view(b, query_len, self.head_num, self.head_dim).transpose(1, 2)
        k = self.k(key_value_seq).view(b, kv_len, self.head_num, self.head_dim).transpose(1, 2)
        v = self.v(key_value_seq).view(b, kv_len, self.head_num, self.head_dim).transpose(1, 2)

        # 计算注意力分数
        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        # 应用掩码
        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        # 计算注意力权重
        attn_weight = F.softmax(attn_score, dim=-1)

        # 应用注意力权重
        output = torch.matmul(attn_weight, v)

        # 重新整形并通过输出投影
        output = output.transpose(1, 2).contiguous().view(b, query_len, d)

        return self.fc(output)
MLA多头隐藏空间注意力
基础概念
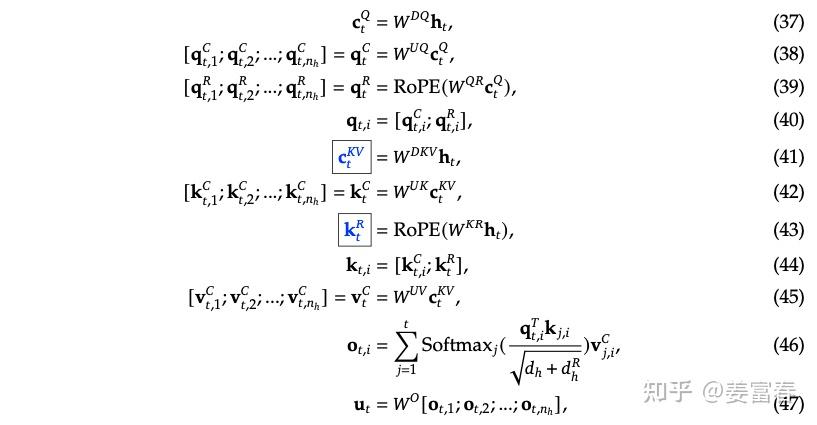
在论文中提到,每个Transformer层,只缓存了上述公式蓝框的向量: $c_t^{KV}$ 和 $k_t^R$ ,这两个向量的大小分别为 $4 \times d_h$ 和 $d_h / 2$
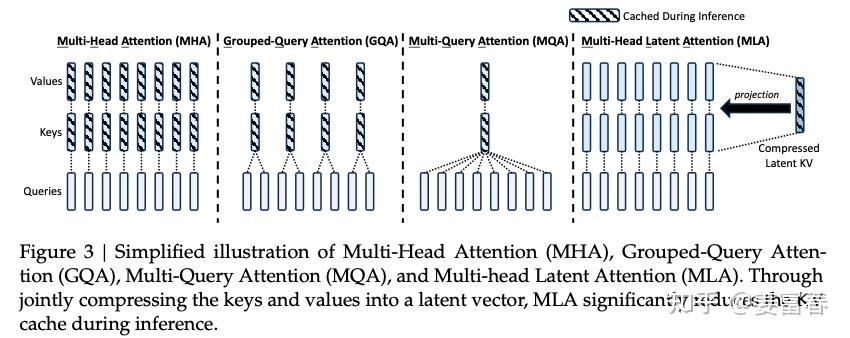
对比MQA(每层有一个 $d_h$ 维度的 $k$ 和 一个 $d_h$ 维度的 $v$ ,共 $2d_h$ 个元素),MLA相当于增加了2.25倍的存储,但DeepSeek描述自己的方法不仅比MQA强,而且比非共享KV的原始MHA也要强.
kv的计算过程
1、首先公式(41)对输入 $h_t$ 做一个低秩压缩,将 $d$ 维的输入经过 $W^{DKV}$ 变换后压缩成 $d_c$ 维的 。DeepSeek-V3中 $d = 7168$ $d_c = 512$
2、然后通过公式(42)和公式(45)两个变换矩阵 $( W^{UK} , W^{UV} \in \mathbb{R}^{d_h n_h \times d_c} ) ,$,将KV的维度扩展回 $d = d_hn_h$,也就是每个Head有一个单独的 $k,v$(跟MHA的KV数量一致)
经过上述的变换,非常类似LoRA做低参数微调的逻辑。通过两个低秩矩阵先做压缩、再做扩展,最终能降低参数的数量。但MLA本质是要做到减少KV-cache的存储。LoRA强调的是参数量的减少,类似MLA这操作确实也减少了参数量,按DeepSeek-V3的参数配置,两个低秩矩阵参数量 $2 \times d_c \times d = 2 \times 512 \times 7168$: ,而正常MHA的参数矩阵参数量: $d \times d = 7168 \times 7168$
Q的计算过程
公式(37),(38)类似KV的逻辑,通过两个矩阵$( W^{DQ} , W^{UQ} \in \mathbb{R}^{d_h n_h \times d_q} )$也做了一层低秩变换,这一步Q的变换看起来是为了减少模型参数数量。在DeepSeek-V3里 $d_q = 1536$,是KV压缩维度的3倍。但相对于 $d = 7168$ 还是压缩了不少。
q,k增加RoPE位置编码
我们注意到在增加RoPE位置编码并没有在上述计算出的 $q_t^C,k_t^C$ 的基础上乘以RoPE的对角矩阵。而是单独计算了两个带着位置编码的 $q_t^R,k_t^R$ 如公式(39)和公式(43)所示
-
$q_t^R,k_t^R$的向量维度 $d_h^R$ 是个比较小的维度,DeepSeek设置为单Attention Head维度的一半: $d_h^R = d_h / 2 = 64$
-
这部分计算的 $k_t^R$ 实际是个MQA的计算方式,同一层中,所有的Head共享同一 $k$
然后按如下公式(40),(44)跟已经计算的 $q_t^C,k_t^C$拼接,构成完整的 $q_t,k_t$ 向量。
所以到目前为止,我们得到的 $q,k$ 包括两部分拼接而成:一部分是做了低秩压缩得到的 $q,k$ 向量,一部分是增加了RoPE位置编码的 $q,k$ 向量。(后面这部分向量是基于MQA方式计算得到的,所有Head共享1个 )。
核心优势
1.MLA引入变换矩阵对输入做变换。这个变换矩阵可以通过 $c = f(x)$ 来获得,其中 $f$ 是一个线性变换。通过矩阵乘法的交换律来优化 $c'W_{qc}$ 和$cW_{kc}$,通过预计算 $W_{qc} W_{kc}$,推理时只需要存储变换后的 $c$,而不需要存储 $k$ 和 $v$,从而减少KV Cache的大小。
2.由于这个设计在推理的时候无法直接应用RoPE。MLA巧妙地引入了两个部分:
- 非RoPE部分: 使用$c'W_{qc}$和$cW_{kc}$计算Q和K,保留内容特征
- RoPE部分: 引入 $W_{qr}$ 和 $W_{kr}$ 来处理位置信息
3.在DeepSeek实现RoPE部分时,MLA使用原始输入 $x$ 而不是 $c$ 来计算K的RoPE部分 $(xW_{kr})$,大概是因为使用原始的 $x$ 不会破坏位置信息。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F
import math
from typing import Dict


class MultiheadLatentAttention(nn.Module):
    def __init__(self, args: Dict):
        super().__init__()

        # 基本参数设置
        self.n_heads = args.n_heads # 头数=128
        self.d_k = args.d_k  # 非RoPE部分的维度 (128)
        self.d_r = args.d_r  # RoPE部分的维度 (64)
        self.d_c = args.d_c  # 低秩投影维度 (512)
        self.d_c_prime = args.d_c_prime  # Q的低秩投影维度 (1536)
        self.d_v = args.d_v  # V的输出维度 (128)


        # 定义投影矩阵
        # 低秩投影 d_c_prime * d_c
        self.W_c = nn.Linear(args.dim, self.d_c, bias=False)  # W_c
        # 低秩投影 d_c_prime * d_c_prime
        self.W_c_prime = nn.Linear(args.dim, self.d_c_prime, bias=False)  # W_c'

        # Q的投影矩阵 d_c_prime * d_k
        self.W_qc = nn.ModuleList([
            nn.Linear(self.d_c_prime, self.d_k, bias=False)
            for _ in range(self.n_heads)
        ])  # W_qc^(s)
        # Q的RoPE投影矩阵 d_c_prime * d_r
        self.W_qr = nn.ModuleList([
            nn.Linear(self.d_c_prime, self.d_r, bias=False)
            for _ in range(self.n_heads)
        ])  # W_qr^(s)

        # K的投影矩阵 d_c * d_k
        self.W_kc = nn.ModuleList([
            nn.Linear(self.d_c, self.d_k, bias=False)
            for _ in range(self.n_heads)
        ])  # W_kc^(s)
        # K的RoPE投影矩阵 d_c * d_r
        self.W_kr = nn.Linear(args.dim, self.d_r, bias=False)  # W_kr

        # V的投影矩阵 d_c * d_v
        self.W_v = nn.ModuleList([
            nn.Linear(self.d_c, self.d_v, bias=False)
            for _ in range(self.n_heads)
        ])  # W_v^(s)

        # Dropout层
        self.attn_dropout = nn.Dropout(args.dropout)
        self.resid_dropout = nn.Dropout(args.dropout)

        # KV缓存
        self.c_cache = None  # 低秩投影后的缓存
        self.x_cache = None  # 原始输入的缓存

        # 注意力掩码
        max_seq_len = args.max_seq_len
        attn_mask = torch.full((1, 1, max_seq_len, max_seq_len), float("-inf"))
        self.register_buffer("attn_mask", torch.triu(attn_mask, diagonal=1), persistent=False)

    def precompute_matrices(self):
        # 推理阶段使用的预计算矩阵, W_qc^(s) * W_kc^(s)
        self.merged_W_qc_kc = [
            torch.matmul(self.W_qc[i].weight, self.W_kc[i].weight.t())
            for i in range(self.n_heads)
        ]

    def forward(self, x, rotary_emb=None, kv_cache=False):
        batch_size, seq_len, _ = x.shape

        # 低秩投影
        c = self.W_c(x)  # [batch_size, seq_len, d_c]
        c_prime = self.W_c_prime(x)  # [batch_size, seq_len, d_c_prime]

        # 缓存处理
        if kv_cache and not self.training:
            has_cache = self.c_cache is not None and self.x_cache is not None
            if seq_len == 1 and has_cache:
                c = torch.cat((self.c_cache, c), dim=1)
                x = torch.cat((self.x_cache, x), dim=1)
            self.c_cache = c
            self.x_cache = x

        outputs = []
        for head in range(self.n_heads):
            if not self.training:  # 推理模式
                # 使用预计算的矩阵计算非RoPE部分的注意力得分
                q_c = torch.matmul(c_prime, self.merged_W_qc_kc[head])  # [batch_size, seq_len, d_c]
                # 注意: 这里直接使用c而不是k_c,因为我们已经预计算了W_q和W_k的乘积
                k_c = c
            else:  # 训练模式
                # 计算Q和K的非RoPE部分
                q_c = self.W_qc[head](c_prime)  # c'W_qc^(s)
                k_c = self.W_kc[head](c)  # cW_kc^(s)

            # 计算RoPE部分
            q_r = self.W_qr[head](c_prime)  # c'W_qr^(s)
            k_r = self.W_kr(x)  # xW_kr

            # 应用RoPE
            if rotary_emb is not None:
                q_r = apply_rope(q_r, rotary_emb)  # c'W_qr^(s)R_i
                k_r = apply_rope(k_r, rotary_emb)  # xW_krR_i

            # 拼接Q和K的两个部分
            q = torch.cat([q_c, q_r], dim=-1)  # [batch_size, seq_len, d_k + d_r]
            k = torch.cat([k_c, k_r], dim=-1)  # [batch_size, seq_len, d_k + d_r]

            # 计算注意力分数
            scale = 1.0 / math.sqrt(self.d_k + self.d_r)
            attn_scores = torch.matmul(q, k.transpose(-2, -1)) * scale

            # 添加注意力掩码
            attn_scores = attn_scores + self.attn_mask[:, :, :seq_len, :seq_len]

            # 计算注意力概率
            attn_probs = F.softmax(attn_scores.float(), dim=-1).type_as(q_c)
            attn_probs = self.attn_dropout(attn_probs)

            # 计算V和输出
            v = self.W_v[head](c)  # cW_v^(s)
            head_output = torch.matmul(attn_probs, v)

            outputs.append(head_output)

        # 拼接所有头的输出
        output = torch.cat(outputs, dim=-1)
        return self.resid_dropout(output)
Flash Attention
Flash Attention 是一种对 Transformer 中注意力机制计算过程的优化算法。它不改变注意力机制的数学公式(输出数值近似一致),而是通过分块计算和重计算策略,优化了 GPU 显存IO的效率。
为什么能起效果: 因为GPU 计算能力(算力)其实非常强,瓶颈不在于“算得不够快”,而在于“数据搬运得太慢”
核心思想:IO 复杂度优化
Flash Attention 的核心在于减少 GPU HBM(高带宽内存)与 SRAM(片上高速缓存)之间的数据交换次数。
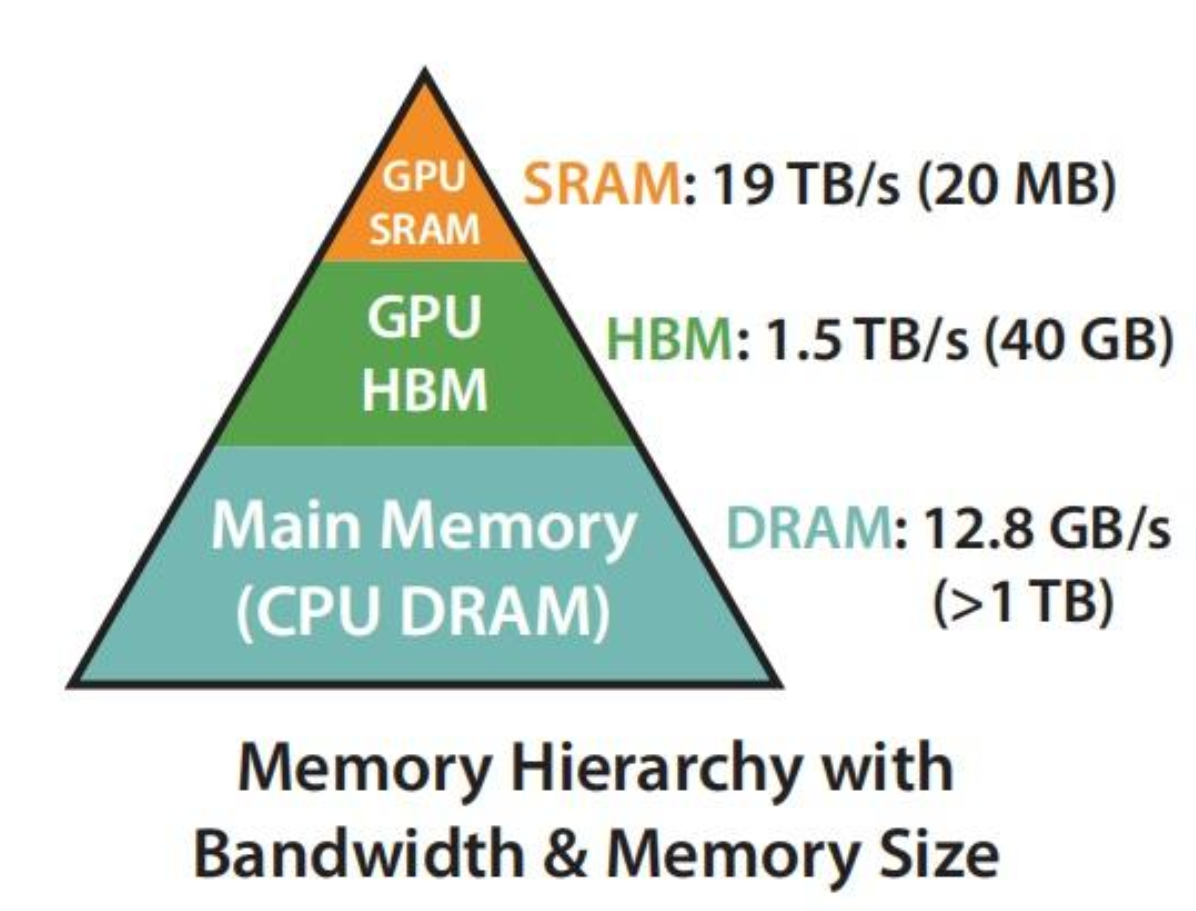
- 标准 Attention:需要多次读写 $N \times N$ 的注意力矩阵到 HBM,显存复杂度为 $O(N^2)$。
- Flash Attention:利用 SRAM 进行分块计算,避免将完整的注意力矩阵写回 HBM,将显存复杂度降低到 $O(N)$。
关键技术
-
分块计算 (Tiling) 将输入矩阵 Q, K, V 切分为小块,加载到 SRAM 中使用 Online Softmax 进行计算。
-
重计算 (Recomputation) 在反向传播时,不存储前向传播的注意力矩阵,而是利用存储在 HBM 中的输出和统计量在 SRAM 中重新计算(和前向过程一样),以时间换空间。
-
Online Softmax (基于 Safe Softmax) 为了在分块计算中保持数值稳定性,Flash Attention 使用了 Online Softmax 技巧。下面简要说一下,详细原理见:FlashAttention 中的 Safe Softmax
- Safe Softmax 原理:为了防止计算 $e^{x_i}$ 时溢出,通常会减去最大值:$\text{Softmax}(x) = \text{Softmax}(x - \max(x))$。
- Online Softmax:由于分块计算无法一次性知道全局最大值,Flash Attention 维护局部的最大值和归一化因子,随着块的推进动态更新结果,最终等价于全局 Safe Softmax。
激活函数与专家结构
SwiGLU激活函数
基础概念
公式为$\text{SwiGLU}(a, b) = a \otimes \text{Swish}(b)$,SwiGLU由Swish激活函数和门控线性单元(GLU)组成,有通过门控过滤信息的特性。
核心优势
**平滑性:**Swish函数的平滑性,比ReLU、Leaky Relu更平滑,处处可导,有利于模型更稳定、收敛速度更快;
**非单调性:**Swish函数的非单调性,能够捕捉到更复杂的模式;
**门控机制:**引入门控机制,使得模型能够选择性地通过信息,从而提高模型的表达能力;
**计算效率:**相比GeLU这种复杂的激活函数计算效率要高
1、为什么SwiGLU在Transformer的FFN层中比ReLU更有效?
ReLU的硬截断特性可能导致梯度消失,而SwiGLU的Swish门控平滑且保留负区间的部分信息,增强了梯度的稳定性;同时,门控机制通过参数化选择重要特征,提升了模型表达能力。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class SwiGLU(nn.Module):
    def __init__(self, dim: int, hidden_dim: int):
        super().__init__()
        self.w1 = nn.Linear(dim, hidden_dim)
        self.w2 = nn.Linear(hidden_dim, dim)
        self.w3 = nn.Linear(dim, hidden_dim)

    def forward(self, x):
        return self.w2(F.silu(self.w1(x)) * self.w3(x))
DeepSeekMOE
MOE 架构的基本思想是在传统 Transformer 模型中,将每个前馈网络(FFN)层替换为一个 MOE 层。一个 MOE 层通常由两个关键部分组成:
- 专家网络(Experts) 每个专家是一个独立的子网络(通常是 FFN),在实际计算中只有部分专家会被激活参与处理。通过让多个专家分担不同数据子集的计算,模型在预训练时可以以较低的计算开销获得大参数量带来的表示能力。
- 门控网络(Gating/Router) 自学成才,并不是不动的 该模块负责根据输入 token 的特征动态选择激活哪些专家。门控网络一般采用一个带 softmax 的简单前馈网络来计算每个专家的权重。经过训练后,门控网络会逐步学会将相似的输入路由到表现更好的专家。
如何避免“过热”与“过冷”专家?
1、辅助负载均衡损失:在整体的损失函数中增加一个辅助项,专门用于衡量各专家在一个 batch 中的激活数量的均衡性。根据该batch在所有专家的token的分布情况去算这个辅助项,token分布的方差越大,损失越高。
2、专家容量限制:通过为每个专家设定一个处理 token 的上限(容量因子),当某个专家达到上限时,额外的 token 会被分配到其他专家或溢出处理。
3、随机路由与噪声策略:噪声的引入使得初始路由决策具有随机性,降低了某些专家因早期优势而被持续选中的风险。同时,一些方法采用随机抽样机制,进一步鼓励低激活率的专家获得机会。
在DeepSeek‐V3 的 MoE 模块中,主要包含两类专家:
路由专家(Routed Experts):每个 MoE 层包含 256 个路由专家,这些专家主要负责处理输入中某些特定、专业化的特征。
共享专家(Shared Expert):每个 MoE 层中还有 1 个共享专家,用于捕捉通用的、全局性的知识,为所有输入提供基本的特征提取支持。
在DeepSeek-V3中解决负载均衡问题的创新设计:
**引入偏置(Bias)**每个路由专家都会有一个可学习的偏置项。当某个专家长期处于低使用状态时,其偏置会自适应地上调,从而增加其被选中的概率;反之,对于被频繁激活的专家,其偏置会下降,从而降低激活概率。值得注意的是,这个偏置项只用于专家选择过程,即在计算得分时加上偏置,而不会在专家输出加权求和时使用,从而确保了最终输出不受不必要的干扰。
推理加速
DeepSeekMTP
核心思想:通过解码阶段的优化,将1-token的生成,转变成multi-token的生成,从而提升训练和推理的性能。具体来说,在训练阶段,一次生成多个后续token,可以一次学习多个位置的label,进而有效提升样本的利用效率,提升训练速度;在推理阶段通过一次生成多个token,实现成倍的推理加速来提升推理性能。
通过 D 个顺序模块预测 D 个额外的token。每个MTP模块由以下组成:
- 共享Embedding层
- 共享Transformer块
- 投影矩阵
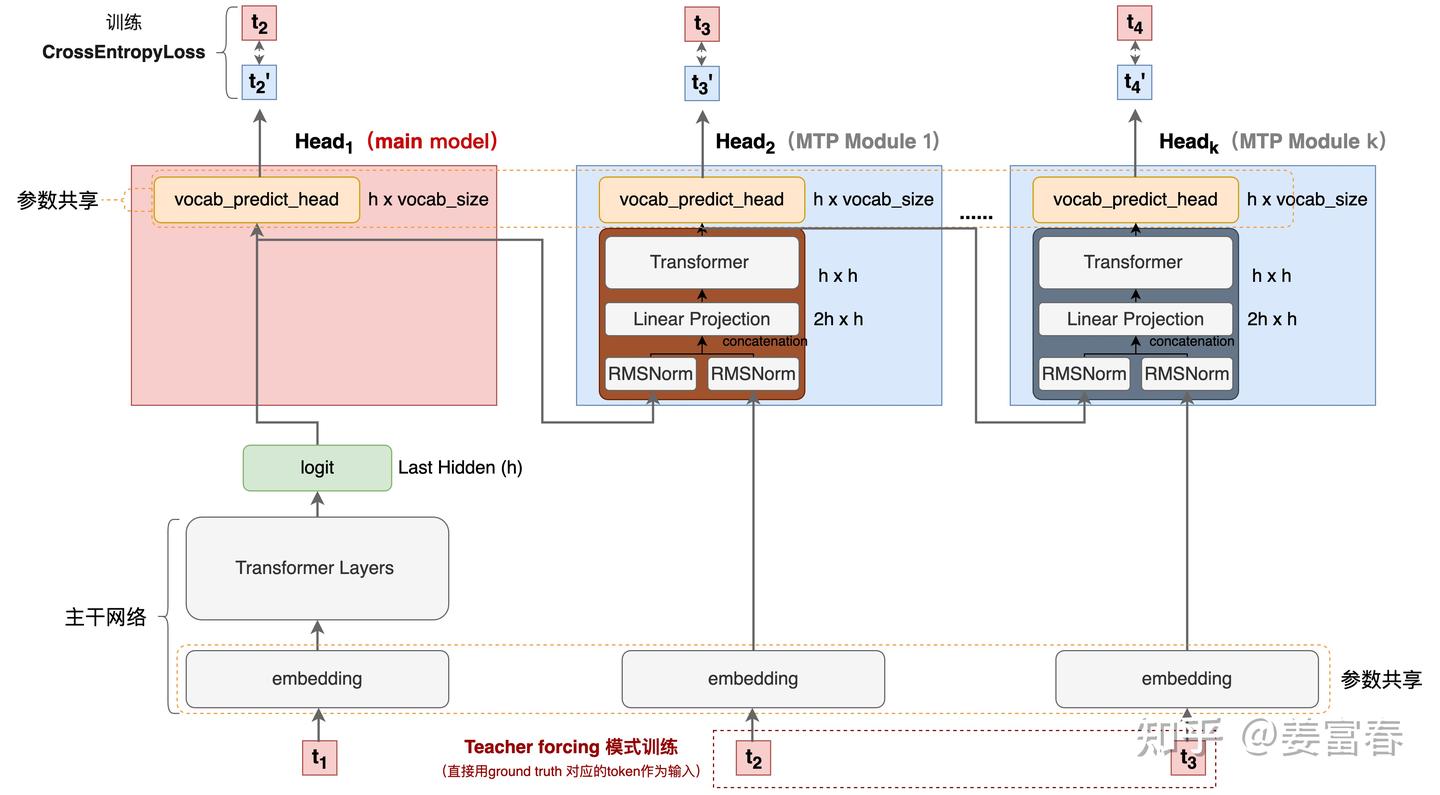
使用MTP主要有两方面的优点:
- 密集训练信号:通过MTP目标,训练信号更加密集,有助于提高数据利用率。
- 预规划表示:MTP能够提升模型对未来token编码的预规划能力,从而实现更好的预测性能。
- **推理加速:**在推理的时候,如果不删除Head,那么将能够一次预测多个token,然后再根据一些校验规则(如部分前向计算或 logprob 比较)选择保留哪些token作为下一次推理。
大模型训练与对齐
大模型训练全流程(Training Pipeline)
从 0 到可用模型,一般经历三层递进:
1、预训练(Pretraining)
- 目标:学习通用语言与知识分布。
- 数据:大规模无标注文本(网页、书籍、代码等)。
- 损失:下一 token 预测的交叉熵。
2、指令微调(SFT)
- 目标:让模型学会“按指令完成任务”。
- 数据:高质量指令-回答对。
- 结果:可用性显著提升,但“偏好对齐”能力仍有限。
3、偏好对齐(RLHF/DPO/GRPO 等)
- 目标:让回答更符合人类偏好(有用、真实、安全)。
- 方法:奖励建模 + 强化学习,或直接偏好优化(如 DPO)。
- 结果:从“能回答”走向“回答更像人希望的样子”。
实践中通常还会补充:
- 课程式数据配比(先易后难)。
- 持续评测与回流(线上 badcase -> 训练集)。
- 安全策略训练(拒答边界、风险内容约束)。
一句话理解:预训练解决“懂不懂”,SFT 解决“会不会做”,对齐训练解决“做得像不像人希望的样子”。
上下文学习(ICL)
上下文学习(In-Context Learning)是指模型在不更新参数的情况下,只依赖 prompt 中的任务描述、示例和格式约束,在当前上下文中临时学会任务并完成泛化。
1、核心机制
- 本质上利用了大模型在预训练阶段学到的“从上下文归纳规则”的能力。
- 模型通过 attention 读取前文示例,把示例中的输入输出映射关系迁移到当前样本。
2、典型使用方式
- Zero-shot:只给任务描述,不给示例。
- Few-shot:给少量高质量示例,约束输出风格和格式。
- 指令 + 结构化模板:通过固定字段或步骤提示提高稳定性。
3、优缺点
- 优点:灵活、低成本、无需训练、上线迭代快。
- 局限:对提示词质量敏感,稳定性通常不如 SFT;上下文变长时还会带来额外推理成本。
一句话理解:ICL 是“把学习过程放到上下文里临时完成”,而不是把能力写入参数。
自蒸馏(Self-Distillation)
自蒸馏(Self-Distillation)是指模型用自己更强阶段或更高质量输出继续监督自己训练:先通过高成本推理得到更优答案,再把这些结果作为伪标签回灌训练。
1、核心机制
- 先获得“教师信号”:例如多次采样、长链推理、搜索增强,或用更强版本模型生成更优答案。
- 再做“学生训练”:将高质量输出转成监督数据,继续训练同体系模型。
2、常见收益
- 把“高成本推理时表现出的能力”压缩回参数中。
- 提升推理能力,减少人工标注依赖。
- 在部署侧用更低成本获得接近高成本推理的效果。
3、实践注意点
- 伪标签质量决定上限,需做过滤、去重和一致性校验。
- 要避免错误答案反复回灌导致能力漂移。
- 常与 SFT、偏好优化联合使用,形成闭环迭代。
一句话理解:自蒸馏是一种“能力回灌与压缩”机制,把昂贵推理能力沉淀成廉价推理能力。
训练流程与损失函数
DeepSeek R1的训练流程
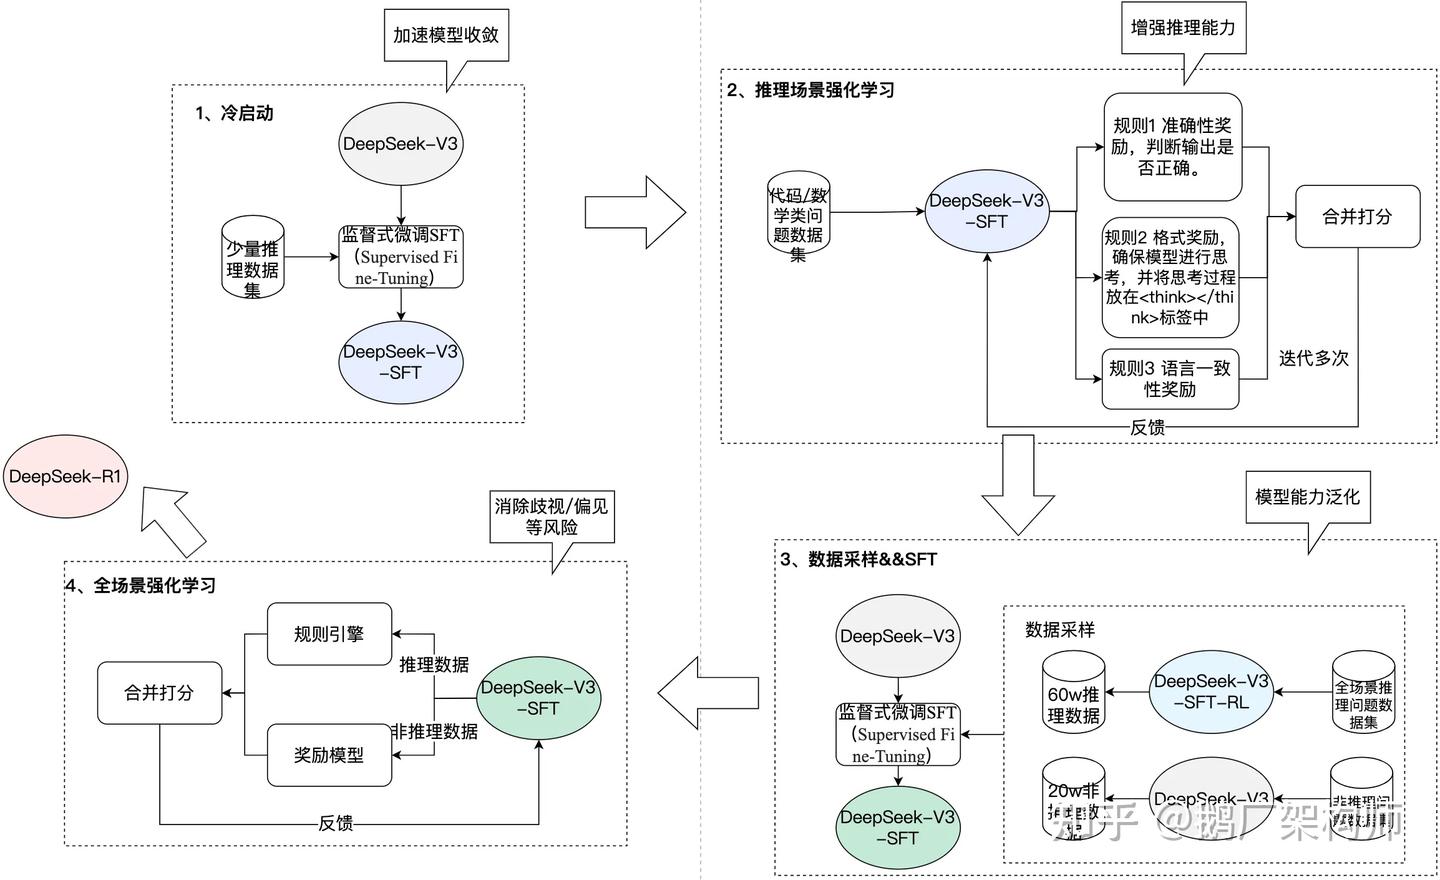
1、冷启动:冷启动的训练数据,采用包含思考过程(CoT)的数据,目的是初步教会模型如何思考,如何“符合人类口味习惯”的思考。加速第二阶段推理场景强化学习的收敛速度。
2、推理场景强化学习:这个阶段的强化学习方法和DeepSeek-R1-Zero的方法保持一致,仅新增了一条规则——语言一致性规则,减轻多语言混杂的情况。这一步的目的是增强模型的推理能力。
3、数据采样与SFT:
阶段 2 强化学习后得到的模型,我们暂且称为DeepSeek-V3-SFT-RL。阶段 3 的采样分为两种数据,一种是推理数据,一种是非推理数据。
推理数据:对DeepSeek-V3-SFT-RL进行拒绝采样。采样的过程中,除了数学/代码等具有确定性结果的问题,也扩充了一些非确定性结果的数据,由DeepSeek-V3作为奖励模型进行判断。最终收集了60w个与推理相关的数据样本。
**非推理数据:**从DeepSeek-V3提取了20w个非推理的数据样本。包含写作、事实问答、自我认知、翻译等任务。
4、全场景强化学习:
第四个步骤,旨在提升模型的有用性和无害性,消除模型的歧视偏见等风险。同时,也精炼其推理能力。具体来说,对于推理数据,沿用阶段2的规则。对于非推理数据,采用奖励模型进行反馈。奖励模型同样基于DeepSeek-V3进行构建,评估模型输出是否符合人类的偏好。经过强化学习后,得到最终的DeepSeek-R1模型。
预训练和SFT的损失函数
在大模型中,无论是预训练阶段还是SFT阶段,使用的都是如公式(2)所示的交叉熵损失,从信息论的角度,交叉熵衡量的是两个概率分布 $p$(真实分布)和 $q$(预测分布)之间的差异。input token 期望预测出的下一个 token 为真实 token 的平均交叉熵最小。 $$ H(p, q) = - \sum_{x} p(x) \log(q(x)) $$ 预训练: 1、模型输入是整个句子序列的一部分
2、它学习根据之前的tokens预测下一个token
3、是自回归语言建模(但next token的预测很像在一个大词表上做下一个词的分类,从词表中选一个单词)
**监督微调(SFT): **
1、模型输入是指令 $x$;
2、模型输出是回答 $y$;
3、只对回答部分计算损失(输入 prompt 不参与 loss)
4、本质仍是交叉熵,但带条件输入。
大模型的训练是自回归的任务,为什么用交叉熵损失?
一个自回归语言模型的目标是:$P_{\theta}(x_1, x_2, \ldots, x_T) = \prod_{t=1}^{T} P_{\theta}(x_t \mid x_{<t})$ ,也就是说,模型要最大化整个句子的联合概率,通过分解成一连串“下一个 token”的条件概率。于是训练目标就是最大化似然。当我们在语言模型中,每个时间步的目标是“正确的下一个词”,这本质上是一个多分类问题(在词表 vocab 上分类,自回归语言模型的训练目标是最大化下一个 token 的似然)。所以,交叉熵损失 = 负对数似然(NLL)损失。
为什么不用MSE?
1、MSE(均方误差)通常用于连续值的回归任务,而语言模型的输出是概率分布(离散分类)。
2、梯度不稳定,Softmax 输出接近 0/1 时,MSE 的梯度几乎消失;交叉熵仍能提供强梯度。
3、惩罚方式不合理,MSE 对错误的 token 惩罚线性,而交叉熵是对数级别惩罚,更符合概率意义。
SFT(监督微调)
LoRA
LoRA的做法是在LLM的某些矩阵( $W \in \mathbb{R}^{d \times k}$ )旁插入一个和它并行的新的权值矩阵 $\Delta W \in \mathbb{R}^{d \times k}$ ,但是因为模型的低秩性的存在(个人理解:深度学习的矩阵往往是过参数化的,许多问题的内在维度比人们认为的要小的多,而对于某个数据集,内在维度在不同参数量级的模型上差距并不大。),我们可以将$\Delta W $ 拆分成降维矩阵 $A \in \mathbb{R}^{r \times k}$ 和升维矩阵 $B \in \mathbb{R}^{d \times r}$(如图所示),其中 $r \ll \min(d, k)$ ,从而实现了以极小的参数数量训练LLM。在训练时,我们将LLM的参数固定,只训练矩阵 $A$ 和 $B$。根据式(1),在模型训练完成之后,我们可以直接将 $A$ 和 $B$ 加到原参数上,从而在推理时不会产生额外的推理时延。
$$
h = W_0 x + \Delta W x = (W_0 + \Delta W) x = W x + B A x
$$
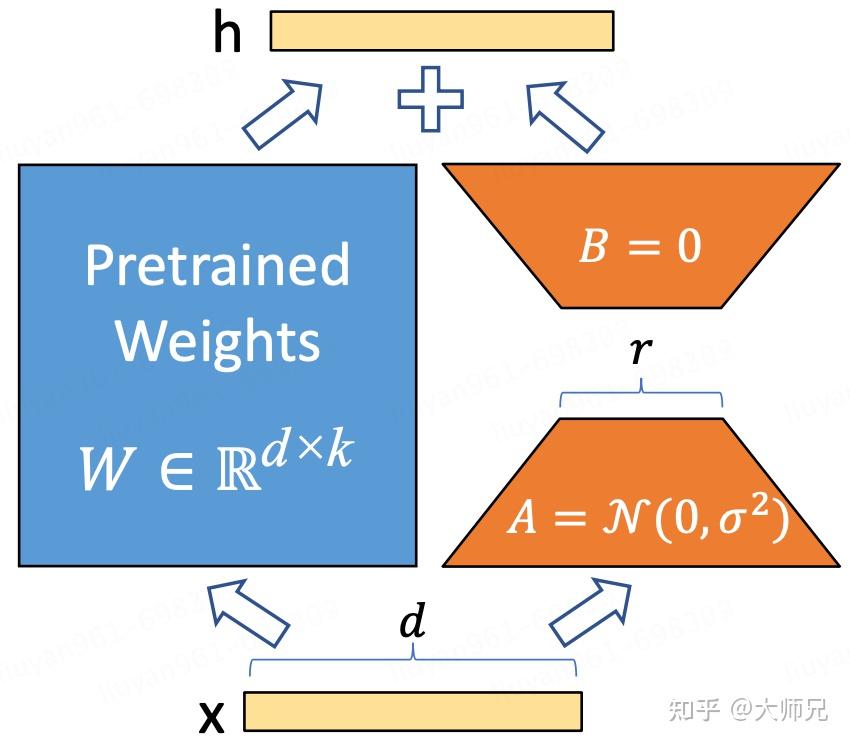
在初始化时,$A$ 使用高斯初始化,$B$ 使用零矩阵进行初始化。因为 $r$ 通常是一个非常小的值(实验证明1,2,4,8的效果就非常好),所以LoRA在训练时引入的参数量是非常小的,因此它的训练也是非常高效的,也不会带来显著的显存增加。LoRA要求 $A$ 或者 $B$ 其中之一必须使用零矩阵进行初始化,这样当数据第一次通过网络时,它和预训练的结果是一致的,不至于直接训歪导致模型坍塌。
LoRA的 $\alpha$ 作用是什么:缩放系数,用于调节低秩更新项的影响力,防止低秩更新的扰动过大。
LoRI:通过将投影矩阵 A 冻结为随机投影,并使用任务特定掩码对矩阵 B 进行稀疏化处理,LoRI 在自然语言理解、数学推理、代码生成和安全对齐等多个领域都取得了出色的单任务性能,与 LoRA 相比,其可训练参数最多可减少 95%。
QLoRA:在微调之前,将原模型量化为4-Bit,冻结量化后的模型参数,量化后的主权重不再训练,只保留反量化用于前向传播。LoRA 模块仍保持高精度(FP16/BF16),只训练这些小矩阵。显存中保存的依然是 4-bit 权重;反量化仅在计算时使用小块 FP16 缓冲区(几 MB 级别);完成计算后立即释放。
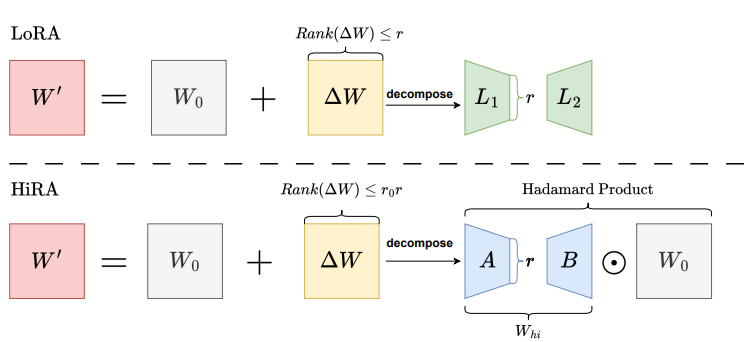
HiRA:
-
提出了一种新的高秩适配方法 HiRA(Hadamard High-Rank Adaptation),用于大语言模型(LLM)的参数高效微调(PEFT)。
不同于传统的 LoRA 采用低秩分解(低秩矩阵乘法)来更新参数,HiRA 使用 Hadamard(逐元素)积 来构造更新矩阵,从而在保持相同参数量的情况下获得更高的秩和更强的表达能力。
-
突破了 LoRA 的低秩瓶颈。
LoRA 的更新矩阵最大秩受限于设定的低秩 r;
HiRA 利用 Hadamard 乘法的性质,使更新矩阵的秩理论上可达到原参数矩阵与低秩矩阵秩的乘积,大幅提升模型的适应性。
LoRA伪代码
input_dim = 768 # 例如,预训练模型的隐藏大小
output_dim = 768 # 例如,层的输出大小
rank = 8 # 低秩适应的等级'r'
W = ... # 来自预训练网络的权重,形状为 input_dim x output_dim
W_A = nn.Parameter(torch.empty(input_dim, rank)) # LoRA权重A
W_B = nn.Parameter(torch.empty(rank, output_dim)) # LoRA权重B
# 初始化LoRA权重
nn.init.kaiming_uniform_(W_A, a=math.sqrt(5))
nn.init.zeros_(W_B)

def regular_forward_matmul(x, W):
  h = x @ W
  return h

def lora_forward_matmul(x, W, W_A, W_B):
  h = x @ W # 常规矩阵乘法
  h += x @ (W_A @ W_B) * alpha # 使用缩放的LoRA权重
  return h
RLHF(基于人类反馈的强化学习)
RFT vs 监督微调(SFT)
| 特征 | 监督式微调(SFT) | 强化微调(RFT) |
|---|---|---|
| 核心思想 | 直接在标记数据上训练模型以匹配期望输出 | 使用奖励信号引导模型有更好的输出 |
| 数据需求 | 需要大量标记的示例数据 | 可能只需要少量的数据标注,无需大规模标注 |
| 学习方式 | 通过模仿学习已有的输入-输出对 | 通过试错和反馈发现最优策略 |
| 创新能力 | 受限于数据的多样性 | 可以发现创造性的解决方案 |
| 人工参与 | 主要在初始数据标注阶段 | 主要在设计奖励阶段 |
DPO
PPO的单样本损失为: $$ \mathcal{L}{\text{DPO}}(\theta) = - \log \sigma \left[ \beta \left( \log \pi{\theta}(y^{+} \mid x) - \log \pi_{\theta}(y^{-} \mid x) \right) - \left( \log \pi_{\text{ref}}(y^{+} \mid x) - \log \pi_{\text{ref}}(y^{-} \mid x) \right) \right] $$ DPO源于强化学习中的RLHF思想,但训练方式是监督学习式的偏好对齐。
它是非交互式的(无需环境采样或在线rollout)。
因此,DPO是一种静态、离线的偏好优化方法。
本质上属于监督微调范式,而非传统在线强化学习。
1、目标:求出“偏好概率”怎么与策略 $\pi_\theta$怎么联系起来
我们希望求出:在给定输入(x)下,模型输出( $y_1$)比( $y_2$)更被偏好的概率是多少?也就是:$p^{*}(y_1 \succ y_2 \mid x)$
根据BT模型,这个概率大小与两个输出的reward大小有关: $$ p^{}(y_1 \succ y_2 \mid x) = \frac{\exp(r^{}(x, y_1))}{\exp(r^{}(x, y_1)) + \exp(r^{}(x, y_2))} $$ 越大的reward表示越“被偏好”;
用softmax形式写偏好概率,是很自然的选择。
2、接下来要做的:把reward表达成策略的形式,在DPO论文中已经说明,最优策略与reward存在如下关系: $$ r^{}(x, y) = \beta \log \frac{\pi^{}(y \mid x)}{\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x) $$ 3、把这个 $r^$ 带入偏好概率公式: $$ p^{}(y_1 \succ y_2 \mid x) = \frac{\exp\left(\beta \log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} + \beta \log Z(x)\right)}{\exp\left(\beta \log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} + \beta \log Z(x)\right) + \exp\left(\beta \log \frac{\pi^{}(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)} + \beta \log Z(x)\right)} $$ 4、分子归一化: $$ p^{}(y_1 \succ y_2 \mid x) = \frac{1}{1 + \exp\left(\beta \log \frac{\pi^{}(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)} - \beta \log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)}\right)} $$ 5、识别sigmoid( $\sigma$)形式 $$ p^{}(y_1 \succ y_2 \mid x) = \sigma\left(\beta\left[\log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} - \log \frac{\pi^{*}(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)}\right]\right) $$ 6、转换为损失形式,其实就是个二分类的交叉熵:$L = -\big[y \log(\sigma(z)) + (1-y)\log(1-\sigma(z))\big]$,在这里里面y始终为1,简化为 $L = -\log(\sigma(z))$
最大化5中的公式可以转换为最小化如下: $$ \mathcal{L}{\text{DPO}} = - \log \sigma \left( \beta \left[ \log \frac{\pi{\theta}(y^{+} \mid x)}{\pi_{\text{ref}}(y^{+} \mid x)} - \log \frac{\pi_{\theta}(y^{-} \mid x)}{\pi_{\text{ref}}(y^{-} \mid x)} \right] \right) $$
简单手撕
# Pseudocode for Direct Preference Optimization (DPO)
Initialize reference model π_ref (frozen)
Initialize policy model πθ

for each batch (x, y_w, y_l) in preference_dataset:
    # compute log probs under both models
    logp_w = log πθ(y_w | x)
    logp_l = log πθ(y_l | x)
    logp_w_ref = log π_ref(y_w | x)
    logp_l_ref = log π_ref(y_l | x)

    # compute the DPO loss
    logits = β * ((logp_w - logp_l) - (logp_w_ref - logp_l_ref))
    loss = -mean(log_sigmoid(logits))  # maximize preference consistency

    # gradient descent
    update θ ← θ - η * ∇θ(loss)
PPO
PPO代表近端策略优化,它需要以下组件:
1、策略(Actor、Policy)模型($\pi_{\theta}$):经过预训练或SFT后的模型,该模型是可学习的,需要打开训练。
2、约束模型($\pi_{ref}$):该模型是冻结的,不需要参与训练,用来做KL散度约束,用来防止Actor模型的分布偏离原始模型太远。
3、奖励模型($R_{\phi}$):一个经过训练并冻结的模型,它为给定 prompt 的完整响应提供奖励分值,有时不需要,基于规则也可以给奖励。
4、价值模型($V_{\Phi}$):它是一个可学习的模型,它为给定 prompt 的部分响应提供奖励分值。
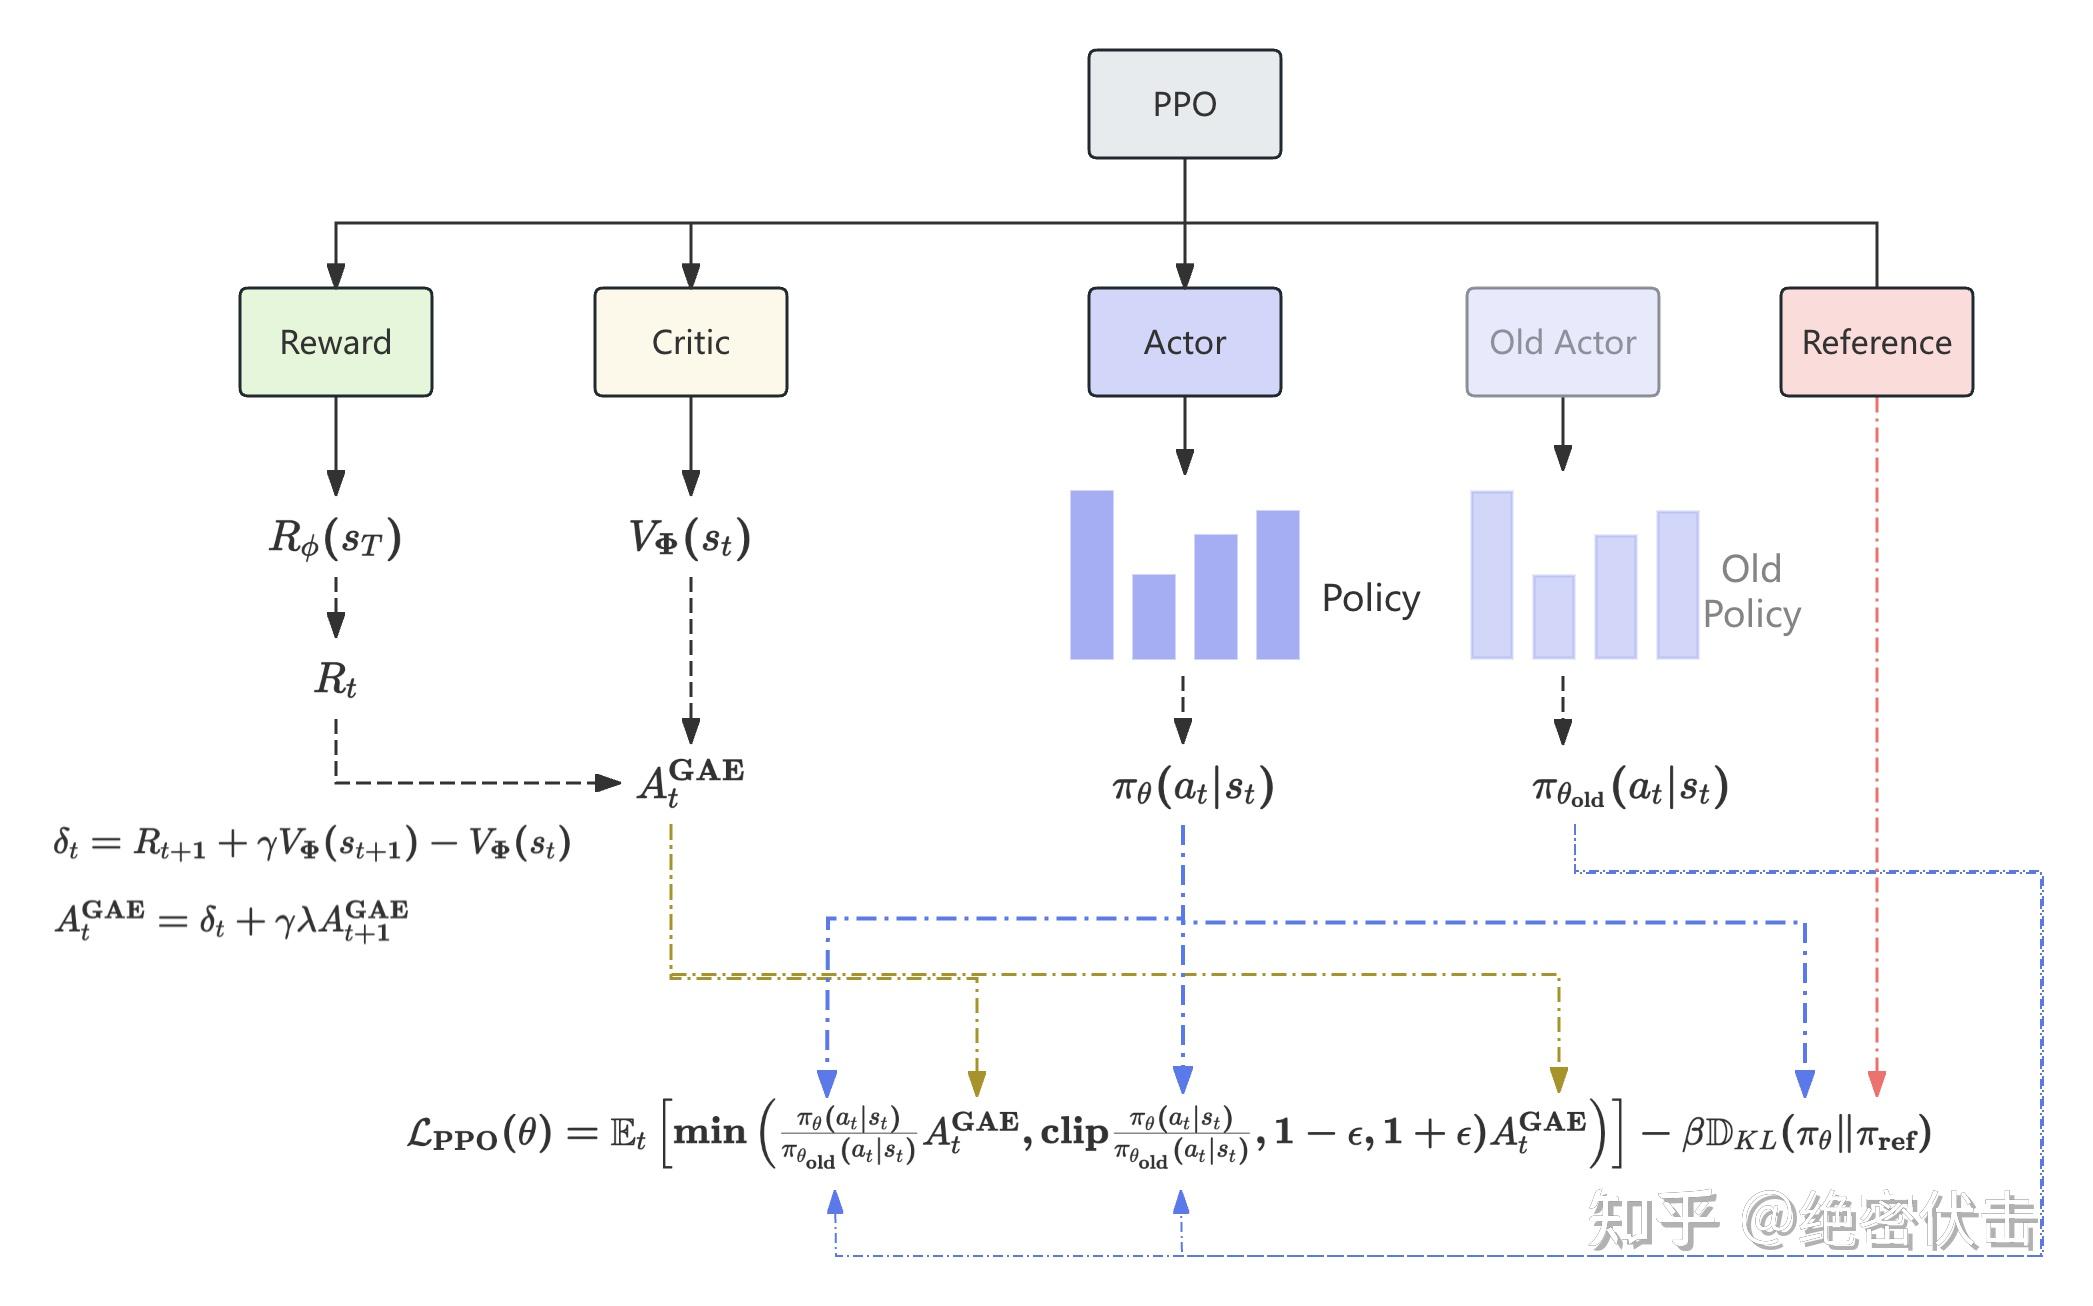
PPO的整个流程包含以下六个部分:
1、生成响应:LLM为给定单个prompt生成单个响应;
2、响应打分:奖励模型为每个响应分配奖励;
3、响应价值:价值模型给出多步响应对应的价值
4、计算优势(advantages):使用 GAE(广义优势估计)计算优势;
5、**优化策略(policy):**通过优化总目标来更新 LLM;
6、更新价值函数(critic):训练价值函数,使其更好地预测给定部分响应的奖励。
广义优势估计(GAE)
我们的策略通过优化优势函数(advantage function)来更新。直观地讲,优势函数定义了在特定状态$s_{t}$(即提示 prompt + 到目前为止生成的词)下选择某个动作$a_{t}$(即词)相较于平均动作的优越程度。优势函数的定义如下: $$ A_{t} = Q(s_{t}, a_{t}) - V(s_{t}) $$ $Q(s_{t}, a_{t}))$: 动作价值(action value),表示在状态$s_{t}$下选择动作$a_{t}$的期望回报;
$V(s_{t})$: 状态价值(state value),表示状态$s_{t}$下的期望回报。
为了估计这个优势函数$A_t$,通常有两种主要方法,每种方法都有其优缺点:
-
蒙特卡洛方法(Monte-Carlo, MC):
-
- 方法:使用完整轨迹的奖励(即完整响应的奖励)来估计优势。
- 优点:这种方法具有低偏差(low bias),因为它能准确地反映完整轨迹的真实奖励。
- 缺点:由于奖励稀疏,需要采样足够多的完整轨迹才能进行优化。这会导致高方差(high variance),并且代价昂贵。
-
时序差分方法(Temporal Difference, TD):
-
- 方法:使用一步轨迹奖励(即刚生成的 token 的奖励)来估计优势。
- 优点:这种方法能在 token 级别计算奖励,显著减少了方差(low variance)。
- 缺点:由于无法准确预测完整响应的最终奖励,这种方法会引入较高的偏差(high bias)。
-
为了在偏差和方差之间取得平衡,引入了 General Advantage Estimation (GAE)。GAE 通过多步 TD 来实现这一目标。
TD误差(步长为1):$\delta_{t} = R_{t+1} + \gamma V_{\Phi}(s_{t+1}) - V_{\Phi}(s_{t})$
GAE(步长为n): $$ \begin{aligned} A_{t}^{n} &= R_{t+1} + \gamma^2 R_{t+2} + \dots + \gamma^n V_{\Phi}(s_{t+n}) - V_{\Phi}(s_{t}) \ &= \sum_{l=1}^{n} \gamma^{l-1} \delta_{t+l-1} \end{aligned} $$ 最终形式:$A_{t}^{\text{GAE}} = \sum_{l=0}^{\infty} (\gamma\lambda)^{l} \delta_{t+l}$
PPO 的主要目标是最大化 advantage($A_{t}^{\text{GAE}}$ ) 地方,也就是说,我们希望让 LLM 生成的每一个 token 都能够最大化 reward(或者说,最大化 advantage——即每个 token 要比它“平均水平”的表现更好)。这个目标通过以下公式实现: $$ \mathcal{L}{\text{clip}}(\theta) = \mathbb{E}{t}\left[\min\left(c_{t}(\pi_{\theta})A_{t}^{\text{GAE}}, \operatorname{clip}(c_{t}(\pi_{\theta}), 1 - \epsilon, 1 + \epsilon)A_{t}^{\text{GAE}}\right)\right] $$ $c_{t}(\pi_{\theta}) = \frac{\pi_{\theta}(a_{t} \mid s_{t})}{\pi_{\theta_{\text{old}}}(a_{t} \mid s_{t})}$: 是在给定累计状态 $s_t$下,策略更新前后的概率比值;
$\epsilon$: 是一个超参数,用于控制 clip 范围;
$A_{t}^{\text{GAE}}$: 是之前通过 GAE 计算得到的优势值。
Critic loss
理论上,我们并没有办法获得真实的折扣回报,因此无法获取 Critic 的明确标签。而在 Actor-Critic 范式中使用包含了真实奖励的折扣回报$\hat{G_t}$ 作为标签。下面是 Critic loss 的计算公式: $$ \mathcal{L}(\Phi) = \mathbb{E}{t}\left[\max\left(\left(V{\Phi}(s_{t}) - \hat{G}{t}\right)^2, \left(\operatorname{clip}\left(V{\Phi}(s_{t}), V_{\Phi}^{\text{old}}(s_{t}) - \epsilon, V_{\Phi}^{\text{old}}(s_{t}) + \epsilon\right) - \hat{G}_{t}\right)^2\right)\right] $$
KL散度
除了最大化 advantage,PPO 还引入了 KL 惩罚,防止当前策略偏离我们微调前的原始模型太远: $$ \operatorname{KL}(\theta) = \mathbb{E}{s_t}\left[\mathbb{D}{\text{KL}}\left(\pi_{\theta}(\cdot \mid s_t) | \pi_{\text{ref}}(\cdot \mid s_t)\right)\right] $$
$$ \mathbb{D}{\mathrm{KL}}(P | Q) = \sum{x} P(x) \log \frac{P(x)}{Q(x)} $$
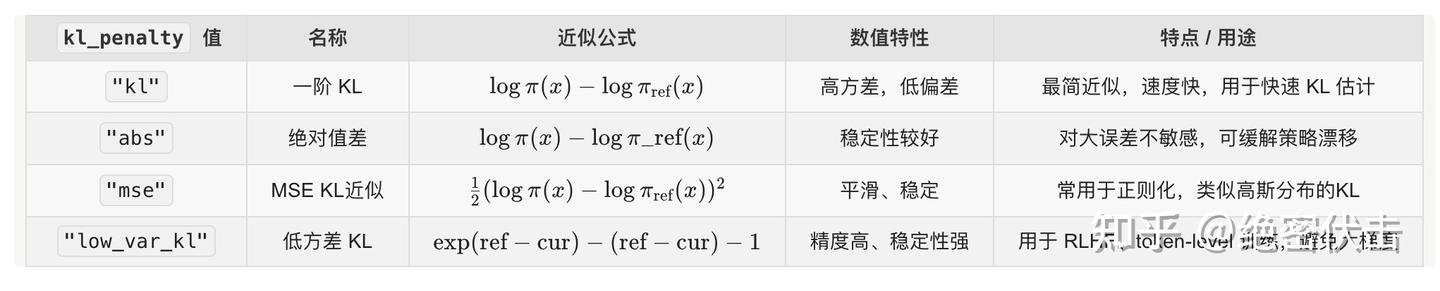
在计算 KL 散度时需要计算两个模型在整个词表上的概率,为了简化计算过程,在实现时通常采用近似计算。如下图所示
熵奖励(Entropy Bonus)
熵奖励用于鼓励 LLM 探索更多的输出,而不是一味选择概率最高的词:$H(\theta) = -\mathbb{E}{a_i \sim \pi{\theta}}\left[\log \pi_{\theta}(a_i \mid s)\right]$
PPO最终的损失loss:
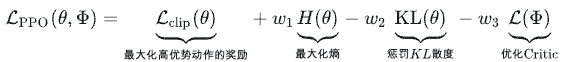
简单手撕
# Pseudocode for PPO (simplified)
Initialize policy πθ, value function Vϕ

for iteration in range(K):
    trajectories = collect_trajectories(πθ_old)
    for each trajectory:
        compute advantage A_t = R_t - Vϕ(s_t)

    for epoch in range(update_epochs):
        for batch in sample_minibatches(trajectories):
            r_t = πθ(a_t|s_t) / πθ_old(a_t|s_t)
            L_clip = min(r_t * A_t, clip(r_t, 1-ε, 1+ε) * A_t)
            L_vf = (Vϕ(s_t) - R_t)^2
            loss = -E[L_clip - c1 * L_vf + c2 * entropy(πθ)]

            update θ, ϕ by gradient descent
    θ_old ← θ
GRPO
GRPO 相较于 PPO 的主要改进为:
- 使用对同一问题的多个采样输出的平均奖励作为基线**;**
- 优势计算中去掉了对值函数$V_{\Phi}(s_{t})$的依赖**。**
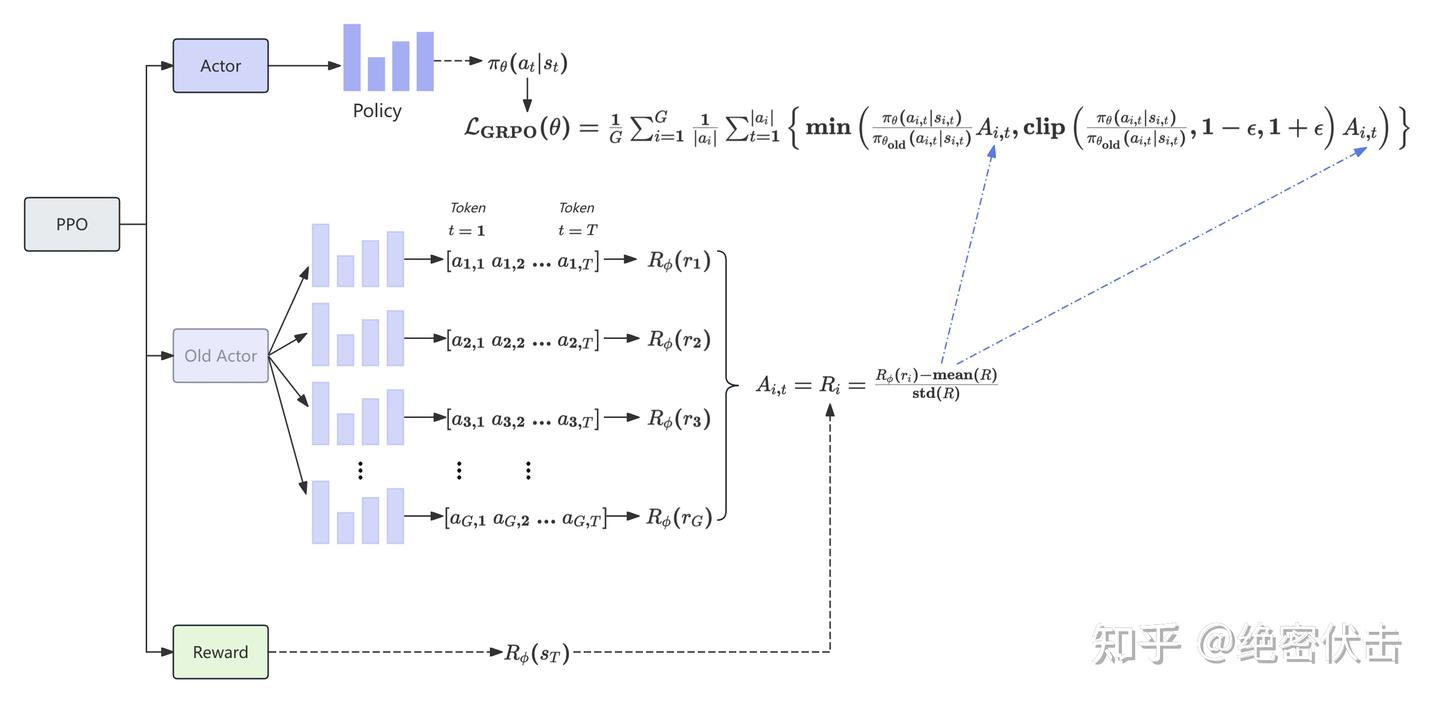
下面是 GRPO 计算 advantage 的具体流程:
-
采样多个响应:对每个 prompt,采样一组 response:$r = {r_{1}, r_{2}, \dots, r_{G}}$
-
通过 Reward Model 打分:对每个响应$r_i$,使用奖励模型$R_{\phi}(r_{i})$得到一个分数。对应的产生$G$个奖励分值为$r = {R_{1}, R_{2}, \dots, R_{G}}$
-
用 group 内标准化估计 Advantage:$A_{i,t} = R_{i} = \frac{R_{\phi}(r_{i}) - \text{mean}(R)}{\text{std}(R)}$
下面是 GRPO 的具体流程,对比图PPO 的流程,二者的主要区别在于 advantage 的计算。
简单手撕
Initialize policy πθ

for iteration in range(K):
    samples = collect_responses(πθ_old)
    rewards = reward_model(samples)
    for each prompt group g:
        r_g = rewards[g]
        A_g = (r_g - mean(r_g)) / std(r_g)   # normalize within each group

    for epoch in range(update_epochs):
        for batch in sample_minibatches(samples):
            r_t = πθ(a_t|s_t) / πθ_old(a_t|s_t)

            L_clip = min(
                r_t * A_t,
                clip(r_t, 1 - ε, 1 + ε) * A_t
            )

            loss = -E[L_clip + c2 * entropy(πθ)]

            update θ by gradient descent

    θ_old ← θ
DAPO
DAPO 的出发点非常直接:在实际训练中,GRPO 往往因 clip 范围设置不合理、采样冗余以及长序列梯度被稀释等问题,导致大量训练信号被浪费。针对这些问题,DAPO 逐一提出改进,形成了四个核心优化点。 $$ \begin{aligned} \mathcal{J}{\text{DAPO}}(\theta) = ; & \mathbb{E}{\substack{(q,a) \sim P(Q) \ {o_i}{i=1}^G \sim \pi{\theta_{\text{old}}}(O \mid q)}} \left[ \frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \right. \ & \left. \min\left(r_{i,t}(\theta)A_i, \operatorname{clip}(r_{i,t}(\theta), 1 - \epsilon_{\text{low}}, 1 + \epsilon_{\text{high}})A_i\right) \right] \ & \text{s.t.,} \quad 0 < \left| {o_i \mid \text{is_equivalent}(a, o_i)} \right| < G \end{aligned} $$
为什么 DAPO 提高了 $ 1 + \epsilon_{high}$ 的上界?
作者发现,如果 clip 的上界$\epsilon$设置过小,会出现这样的问题:当 old policy 对某个 token 的概率很低,而该 token 的 advantage 又是正值(即 old model 恰好采样得非常好),此时当前 policy model 的上涨空间就会受到很大限制,而上涨恰恰是我们希望发生的。
举例来说,如果 old policy 的概率是 0.9, $\epsilon = 0.2$,clip 上界为$0.9 \times 1.2 = 1.08$ ,已超过概率的最大值 1.0,这种情况是绝对不会被 clip 的;但如果 old policy 的概率是 0.2,clip 上界仅为 0.24,即便当前模型将其概率提升到 0.4(一个不是非常激进且恰到好处的改进),也会因$\epsilon$过小而被 clip,导致该 token 的训练信号被废弃。为了解决这一问题,DAPO 引入 Clip-Higher,提高上界以提升 token 利用效率。
这类似于“马太效应”——富人越来越富,穷人很难翻身。如果 old policy 难得采到一个关键 token(例如 「Wait」)且概率极低,而当前模型对此 token 的概率提升显著,却因为 clip 限制过紧被抹掉,那么模型几乎没有翻盘的机会。
Clip-Higher 解决了“好 token 涨幅受限”的问题,但并未触及另一个浪费来源——采样多样性不足。为此,DAPO 引入了 动态采样。
DAPO - 动态采样
DAPO 的第二个创新是 动态采样(Dynamic Sampling)。这项技术的背景是:假如一个 query 我们 sample 了 10 次,这 10 次每次都答得很好/或者很差,都取得了 max reward / zero reward,这个时候由于 GRPO 的计算方法,导致这 10 次采样的 advantage 都是 0,所以这些采样所带来的 gradient 就也都是 0;这样做的一个后果就是,实际的有梯度的 sample 要远低于没有梯度 sample 数,导致最后梯度汇集的时候没有收集到足够的信息,从而形成高方差、不稳定的训练,以及 sample 的浪费。需要注意的是,这种现象是在训练初期;以及后期随着训练的进行在不断加强的,因为刚开始时模型效果很差,而训练越到后边模型效果越好,给出满分回答的几率就越大。因此,DAPO 在采集样本时,额外做了一件事:保证每次采样出来的回答,reward 不全是 0 或者 1,如果采样出来的回答全是 0 或者 1 就继续采样,直到不满足为止。这也是损失函数中$\text{s.t.,} \quad 0 < \left| {o_i \mid \text{is_equivalent}(a, o_i)} \right| < G$的来源,它保证同一输入下的采样集合中既包含正确回答,也包含错误回答。
除了多样性问题,GRPO 在长回答训练中还有一个隐性缺陷——token 梯度权重随回答长度增加而被稀释。DAPO 的第三个改进正是 Token-Level Gradient Loss。
DAPO - Token-Level Gradient Loss
DAPO 第三个方面的创新是为了解决 GRPO 在训练长回答时 gradient 的权重会随着采样回答的长度变长而下降的问题。首先解释为什么采样长度变长权重会下降。假设采样了 2 次,有一次回答一共有 200 个 token,而另一次回答有 10 个 token。那么根据 GRPO 的计算公式,每次回答的梯度先在 sample 内求平均,再在 batch 内求平均。第一次回答每个 token 的权重是$(1/200) * (1/2)$,而第二个回答每个 token 的权重是$(1/10) * (1/2)$,所以第二次回答的 token 的影响要明显高于第一次回答。再来说采样长度变长权重下降的危害:对于一些比较难的问题,长回答本身就很正常,如果这些回答本身非常好,那么由于长度平均就会导致本来非常有用的梯度信号被稀释;假如回答是不好的,长度长仅仅也是因为重复单词,或者回答冗余词太多,长度归一就导致这次采样本该带来的纠正信号没法正确传递到 policy model 上。总结来说就是:
这会带来两个问题:
- 长高质量回答的有用信号被稀释;
- 长低质量回答的纠正信号也被稀释(长只是因为冗余或重复)。
所以 DAPO 采用的方法是:把一次梯度计算时所有采样生成的 token 总数加起来求平均,回到上边这个例子,第一次采样和第二次采样每个 token 的权重都是 $(1/200) * (1/2)$,即对不同回答中的 token 一视同仁。这样就能改善 GRPO 在长样本训练中的效率低下的问题。这对应着损失函数中的改变,公式上,对于 loss 的 aggregation 方式由原来 GRPO 的$\frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|}$改为$\frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|}$实验证明,token-level loss 不仅训练更稳定,还能有效控制 entropy:过高会导致策略趋于随机,过低则探索不足(Clip-Higher 可缓解该问题)。通过将 sample-level loss 改为 token-level loss,DAPO 让长回答能够按比例影响最终梯度,每个 token 的损失都直接参与整体更新。
最后一个改进同样与回答长度相关,但关注点不同——它处理的是过长回答对整体奖励的负面影响。
DAPO - Overlong Reward Shaping
DAPO 的第四个改进是在奖励设计中引入 软惩罚机制(Soft Punishment)来处理过长回答。具体来说,当生成长度超过第一个预设阈值时,惩罚会随长度线性增加;一旦超过第二个阈值,惩罚将抵消因回答正确获得的所有奖励,相当于将该回答视为无效。这种惩罚是按 token 作用在 reward(即 advantage)上的。
综上,DAPO 在 Clip-Higher、动态采样、Token-Level Gradient Loss 和 Overlong Reward Shaping 四个方面,对 GRPO 进行了精细化改造,显著提升了训练的效率与稳定性。不过在某些特定架构(尤其是 MoE)下,GRPO 的结构性问题依然存在,这就引出了下一节的 GSPO。
GSPO
如果说 DAPO 是在 GRPO 框架内做“微调与优化”,那么 GSPO 则是直接调整了优化目标的颗粒度——从 token-level 跳到 sequence-level。这一变化的动机,主要源于在 MoE 架构训练时,GRPO 的重要性采样会引入巨大方差和不稳定性。GSPO 的核心思想是:优化奖励时不再依赖逐个 token 的比值,而是关注整个生成序列的表现,从而降低噪声并提升稳定性。
Importance ratio 到底在起什么作用?在 GRPO 里会带来什么问题?
重要性采样存在的意义在于:我们想要估计一个预期的分布,但是我们手上只有另一个 behavior 分布,我们就只能在 behavior policy 下进行采样,通过这个样本,赋予这个重要性权重,来估计出 target policy 下函数的值。但是这种采样的前提在于多次采样,如果只有一次采样,并不能起到分布矫正的作用。问题在于大模型训练过程中,重要性采样都是 per-token 进行的,单个 token 进行的重要性采样是无法起到分布矫正的作用的,相反,这种采样手段反而会带来很大方差的噪声,尤其是在 MoE 这种不稳定的结构下。所以 GRPO 本身这种逐 token 的计算可能不太合理。
Per-token 采样和奖励回复的不匹配:我们的奖励其实是对每个回答整体给出的评价,但是在 per-token 的操作中,我们又把这个奖励平摊到每个 token 上(reward shaping),然后试图在 token 层面逐个做调整,所以这里就发生了一个优化的目标和奖励目标的颗粒度的差异。所以既然我们有了 sequence-level 的 reward,我们能不能也把 GRPO 的优化过程改成 sequence-level 的。
GRPO 在 MoE 结构上为什么难以收敛?(GRPO 的局限性)
专家激活波动性是关键问题。因为新旧策略可能激活不同的专家,带来结构性偏差,引起噪声。当更新时${\pi_{{\theta}_{old}}}$,很有可能 Router 也发生了变化,导致新旧策略激活了不同的专家。虽然模型参数只更新了一步,但实际参与计算的专家组合完全不同,导致非常大的输出概率的波动,导致 clipping 被异常地、频繁地触发。Clip 过后的 token 往往就没有梯度,而最终留下来的 token 往往是有噪音的。所以这两个概率根本不是在相同结构下产生的,理想中的重要性比率应该反应模型在同一结构下参数变化导致的输出概率变化,但这个比率现在由于专家变化,导致高方差的波动,不可预测,与优化方向无关的噪声。这种高方差会导致梯度估计严重失真,训练不稳定甚至崩溃。
GSPO 之前的做法:Routing Replay
Routing Replay 会记录 ${\pi_{{\theta}{old}}}$ 推理时的路由激活,并在训练时强制 ${\pi{\theta}}$ 使用相同激活路径。这虽能保证一致性,但对 AI infra 带来非常大的开发工作量和开销;同时对于${\pi_{\theta}}$ ,有可能已经有了更好的 routing path,但是现在却一定要走 的 routing path,导致 training 不是很高效。传统方法会尝试通过 Routing Replay 来缓解专家激活的不一致,但这会带来工程复杂性与效率损失。GSPO 则选择直接规避这一依赖,从根本上降低了训练过程中的结构性方差。
GSPO 的损失函数设计
$$ \mathcal{J}{\text{GSPO}}(\theta) = \mathbb{E}{x \sim \mathcal{D}, {y_i}{i=1}^G \sim \pi{\theta_{\text{old}}}(\cdot \mid x)} \left[ \frac{1}{G} \sum_{i=1}^G \min \left( \left( \frac{\pi_{\theta}(y_i \mid x)}{\pi_{\theta_{\text{old}}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}} \hat{A}i, \text{clip}\left(\left( \frac{\pi{\theta}(y_i \mid x)}{\pi_{\theta_{\text{old}}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}}, 1-\epsilon, 1+\epsilon\right) \hat{A}_i \right) \right] $$
$$ s_i(\theta) = \left( \frac{\pi_{\theta}(y_i \mid x)}{\pi_{\theta_{\text{old}}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}} = \exp \left( \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \log \frac{\pi_{\theta}(y_{i,t} \mid x, y_{i,<t})}{\pi_{\theta_{\text{old}}}(y_{i,t} \mid x, y_{i,<t})} \right). $$
GSPO 的算法希望抛弃掉 GRPO 的 token-level objective,而是把 importance rate 直接用在 sequence-level 上,这也就自然得引入了 GSPO 的优化算法目标,即把 token-level 的 importance rate 换成了 sequence-level 的 importance rate。这里对 sequence-level 的重要性做了长度归一化,这里主要是为了减少方差和统一数值范围。如果不做长度归一化,不同的问题可能回答长度是不一样的,因此 importance rate 可能会对长度很敏感。这里,由于所有属于同一采样的 token 用到的 importance ratio 都是一样的,所以一旦 clipping 发生,所 clip 掉的将是整个采样到的 sequence,而不是一次采样中的某些 token。长度归一化 $\frac{1}{|y_i|}$ 避免长句子几个 token 波动就导致 ratio 爆炸。
GSPO 与 GRPO 在梯度上的理论分析
从优化目标的定义出发,GSPO 与 GRPO 的主要区别在于重要性比值的定义及其在梯度计算中的作用。
如果忽略掉 clip 机制,那么二者梯度本质上的区别在于,是否要对一个回复里边的不同 token,他们的梯度做加权平均。GRPO 是会对一个回复里边的不同 token 根据他们各自的重要性权重做加权,但是 GSPO 对一整个句子做相同 importance ratio 的放缩。具体而言,GSPO 的梯度为: $$ \nabla_\theta J_{\text{GSPO}}(\theta) = \mathbb{E} \left[ \frac{1}{G} \sum_{i=1}^G s_i(\theta) A_i \cdot \frac{1}{|o_i|} \sum_{t=1}^{|o_i|} \nabla_\theta \log \pi_{\theta}(o_{i,t} \mid q, o_{i,<t}) \right]. $$ 可以看出,GSPO 对同一条回复中的所有 token 赋予相同的权重 $s_i(\theta) A_i / |o_i|$ ,从而保证了序列内部梯度权重的一致性。相比之下,GRPO 的梯度为: $$ \nabla_\theta J_{\text{GRPO}}(\theta) = \mathbb{E} \left[ \frac{1}{G} \sum_{i=1}^{G} \frac{\hat{A}i}{|o_i|} \sum{t=1}^{|o_i|} r_{i,t}(\theta) \nabla_\theta \log \pi_{\theta}(o_{i,t} \mid q, o_{i,<t}) \right]. $$ 可以看出,GRPO 在同一条回复的不同 token 上采用不同的权重 $r_{i,t}(\theta)\frac{\hat{A}_i}{|o_i|}$ ,这些权重会随 token 位置和上下文变化而波动,且可能出现较大方差,尤其在长序列或 MoE 模型中更为严重。
另外一个区别在于 GRPO 原本的重要性采样权重对 clip 范围的影响。对于大于零的 advantage 的样本,GRPO 允许的范围是零到一点几,但是对于 advantage 小于 0 的样本,clip 的数值范围是零点几到正无穷,这是个很大的波动范围。当序列变长的时候,这个时候所携带的噪声是会不断积累的。这也是 MoE 模型在用 GRPO 训练时候崩溃的原因之一。而 Reward 监控指标对于模型学偏这件事情是有一定滞后性的,就是模型学偏了一段时间以后,指标上才会有反馈。从实验结果上来看,GSPO 实际用于训练的 token 比 GRPO 少很多(由于 clipping),但同时达到了更高的训练效率。
Contributors


Similar repos


README
Typora / Vscode打开体验感更好
大模型八股
阅读导航
Part A:基础架构与推理机制
- 输入处理与编码:Tokenizer、RoPE、RoPE扩展策略、RMSNorm、PreNorm/PostNorm
- 注意力机制与缓存:Causal Mask/Attention Mask、MHA、KV Cache、MQA、GQA、CrossAttention、MLA、Flash Attention
- 激活函数与专家结构:SwiGLU、DeepSeekMOE
- 推理加速:DeepSeekMTP
Part B:训练与对齐
- 训练流程与损失:DeepSeek R1 训练流程、预训练和 SFT 的损失函数
- 无参适配能力:上下文学习(ICL)
- 能力回灌机制:自蒸馏(Self-Distillation)
- 监督微调:SFT、LoRA(含 LoRI、QLoRA、HiRA)
- 偏好对齐与强化学习:RLHF、DPO、PPO、GRPO、DAPO、GSPO
Part C:模型系列深度调研
- Qwen 系列完整技术演进深度调研报告 — 覆盖 Qwen-VL → Qwen2-VL → Qwen2.5-VL → Qwen3-VL → Qwen3-Omni 全系列架构演进与多模态面试考点
大模型基础架构与推理机制
大模型整体结构
从工程实现视角看,一个标准 Decoder-only 大模型通常由以下模块串联而成:
1、输入与嵌入层(Embedding)
- Tokenizer:将原始文本切分为 token 序列,并完成 token id 映射。
- Token Embedding:把离散 token 映射到连续向量空间。
- Positional 信息注入:常见是 RoPE,把位置信息编码进 Q/K。
2、Transformer 主干(重复堆叠 N 层)
- Attention 子层:建模 token 间依赖关系。
- FFN 子层:做非线性特征变换(常见激活函数是 SwiGLU)。
- Norm 与残差:常见 PreNorm 结构,保证深层训练稳定。
3、输出层(LM Head)
- 将隐藏状态投影到词表维度,得到每个 token 的 logits。
- 经过 softmax 得到下一 token 概率分布。
4、可选增强模块
- MoE:用稀疏激活专家提升参数规模与性能上限。
- MTP/Speculative 类思路:优化解码阶段吞吐。
- KV Cache/Flash Attention:优化长序列推理的延迟与显存。
一句话理解:Embedding 负责“看懂输入”,Transformer 负责“加工语义”,LM Head 负责“给出下一个 token 的概率”。
编码与归一化
Tokenizer(分词器)
Tokenizer 是大模型输入链路的第一步,作用是把自然语言文本转成模型可计算的离散 token id 序列。
1、为什么 Tokenizer 很关键?
- 它决定了“一个词被切成几个 token”,直接影响序列长度、推理成本和训练效率。
- 它影响多语言、代码、符号场景下的表达能力。
- 它与词表大小共同决定 Embedding/LM Head 参数规模。
2、常见分词算法
- BPE(Byte Pair Encoding):通过频繁子串合并构建词表,工程上非常常见。
- WordPiece:与 BPE 相近,但采用不同的合并评分策略。
- Unigram:基于概率模型选择子词集合,常见于 SentencePiece。
3、训练与推理中的影响
- 训练:同一语料下,分词粒度会影响 token 总量和训练吞吐。
- 推理:更细粒度通常带来更长上下文长度与更高时延。
- 对齐:特殊 token(如 BOS/EOS、系统标记)会影响指令跟随与模板稳定性。
一句话理解:Tokenizer 不只是“切词工具”,而是决定模型输入空间形态与计算成本的底层组件。
RoPE旋转位置编码
基础概念
RoPE(Rotary Position Embedding)的核心在于用旋转矩阵在复数域进行操作替代传统的位置向量叠加操作,既能保留绝对位置信息,又能显式建模相对位置关系。传统绝对位置编码直接与词向量叠加,经过线性变换后,位置信息的远程衰减特性易被破坏。
核心优势
1、远程衰减性:内积结果随相对距离增大呈震荡衰减趋势,符合自然语言中邻近词关联更强的特性。
2、外推能力:旋转操作的周期性允许模型处理超过训练长度的序列,如训练时使用4K长度,推理可扩展至32K。
3、正交性保持:旋转矩阵是正交矩阵,保持向量模长不变,增强模型训练稳定性。
长上下文扩展策略(RoPE 怎么扩)
当训练长度较短、推理长度更长时,常见做法不是完全重训,而是对 RoPE 频率或位置映射做伸缩。
1、位置插值(Position Interpolation)
- 核心思想:把长上下文的位置索引压缩映射回训练时的有效区间。
- 直观理解:把“更长的尺子”按比例缩放后再喂给 RoPE。
- 优点是实现简单、成本低;缺点是过长时可能损失局部细节。
2、NTK-aware Scaling
- 核心思想:按神经切线核(NTK)视角重标定 RoPE 的频率分布,减缓长距离外推失真。
- 实践上常表现为对 base 或频率项做分段/比例缩放。
- 相比简单插值,通常在更长上下文下稳定性更好。
3、YaRN(Yet another RoPE extension)
- 核心思想:在 RoPE 扩展时采用更平滑、分段的缩放策略,兼顾短上下文性能与长上下文外推。
- 常见做法是结合“短段保真 + 长段拉伸”,减少直接硬缩放带来的退化。
- 工程上常用于把 4K/8K 模型扩到更长上下文,同时尽量不牺牲原能力。
一句话总结:位置插值偏“简单可用”,NTK-aware 偏“理论一致性”,YaRN 偏“工程折中与鲁棒性”。
手撕代码
import torch
from typing import Tuple

def precompute_freqs_cis(dim: int, seq_len: int, freqs: float = 10000.0):
    # 计算词向量元素两两分组之后,每组元素对应的旋转角度
    theta = 1.0 / (freqs ** (torch.arange(0, dim, 2).float() / dim))

    # 生成 token 序列索引 t = [0, 1,..., seq_len-1]
    t = torch.arange(seq_len)
    # theta.shape = [seq_len, dim // 2]
    theta = torch.outer(t, theta).float()
    # torch.polar的文档, https://pytorch.org/docs/stable/generated/torch.polar.html
    # torch.polar输入参数是abs和angle,abs所有值都一样,abs和angle的shape都一样
    # torch.polar输入参数是abs和angle,则theta_cis = abs*(cos(angle) + sin(angle)i)
    theta_cis = torch.polar(torch.ones_like(theta), theta)
    return theta_cis

def apply_rotary_emb(
    xq: torch.Tensor,
    xk: torch.Tensor,
    theta_cis: torch.Tensor,
) -> Tuple[torch.Tensor, torch.Tensor]:
    # xq.shape = [batch_size, seq_len, dim]
    # xq_.shape = [batch_size, seq_len, dim // 2, 2]
    xq_ = xq.float().reshape(*xq.shape[:-1], -1, 2)
    xk_ = xk.float().reshape(*xk.shape[:-1], -1, 2)

    # 转为复数域,  xq_.shape = [batch_size, seq_len, dim // 2]
    xq_ = torch.view_as_complex(xq_)
    xk_ = torch.view_as_complex(xk_)
    # 应用旋转操作,然后将结果转回实数域
    # xq_out.shape = [batch_size, seq_len, dim]
    xq_out = torch.view_as_real(xq_ * theta_cis).flatten(2) #从dim=2维度开始拍平
    xk_out = torch.view_as_real(xk_ * theta_cis).flatten(2)

    return xq_out.type_as(xq), xk_out.type_as(xk)

if __name__ == '__main__':
    seq_len,dim=3,4
    freqs_cis = precompute_freqs_cis(dim=dim, seq_len=seq_len)
    xq = torch.rand(1, seq_len, dim)
    xk = torch.rand(1, seq_len, dim)
    res = apply_rotary_emb(xq, xk, freqs_cis)
RMSNorm
基础概念
归一化的核心目标是缓解内部协变量偏移问题,即网络中间层输入分布随参数更新而发生改变。主要有以下好处:
1、提升训练效率:归一化使每一层的输入分布更加稳定,从而允许使用更高的学习率,加快收敛速度。
2、保持梯度稳定:通过控制激活值的尺度,减少梯度消失或者梯度爆炸,适合深层网络的训练。
3、引入归纳偏置:归一化在一定程度上对输入进行标准化,降低了模型对输入尺度的敏感性,增强了泛化能力。
核心优势
为什么现在的大模型都用RMSNorm,而不使用BatchNorm和LayerNorm?
1、任务特性不匹配: 大模型多用于NLP,输入为变长序列,BatchNorm依赖batch统计量,在batch size小和序列长度不固定时不稳定。
LayerNorm和RMSNorm按样本独立归一化,天然适配序列建模。
2、训练稳定性:
BatchNorm在训练和推理阶段行为不同(训练用batch统计量,推理用移动平均),引入不确定性。
LayerNorm和RMSNorm训练推理一致,更稳定。
3、可扩展性与效率:
BatchNorm在分布式训练中需跨设备同步统计量,通信开销大。
LayerNorm和RMSNorm无需跨batch通信,更适合大规模并行训练。
RMSNorm进一步简化计算(只有缩放因子gamma,没有中心化beta),减少参数量,提高吞吐。
手撕代码
$$ \mathrm{RMSNorm}(\mathbf{x}) = \frac{\mathbf{x}}{\sqrt{\frac{1}{d} \sum_{i=1}^{d} x_i^2 + \epsilon}} \odot \mathbf{g} $$
import torch
from torch import nn

class RMSNorm(torch.nn.Module):
    def __init__(self, dim: int, eps: float = 1e-6):
        super().__init__()
        self.eps = eps
        self.weights = nn.Parameter(torch.ones(dim))

    def _norm(self, x):
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim = True) + self.eps)

    def forward(self, x):
        output = self._norm(x.float()).type_as(x)
        return output * self.weights
归一化模块位置的影响
| 特征 | PostNorm | PreNorm |
|---|---|---|
| 归一化位置 | 残差连接之后 | 残差连接之前 |
| 公式形式 | y = Norm( x + F(x) ) | y = F( Norm( x ) ) + x |
| 梯度传播 | 初始阶段梯度较大,后期稳定 | 梯度更平滑,训练更稳定 |
| 收敛速度 | 较慢,需小心调参 | 更快,对学习率更鲁棒 |
| 最终性能 | 可达最优,但训练难度高 | 更易训练,性能更稳定 |
大模型使用PreNorm的优势: 每个子层输入都被归一化,信号尺度更可控。
残差连接保持“恒等映射”主导,梯度传播更平滑。
显著提升训练稳定性,尤其在深层网络中。
注意力机制与缓存
Causal Mask / Attention Mask
在自回归大模型中,Mask 的作用是约束“哪些位置可以互相注意到”,防止信息泄漏并屏蔽无效 token。
1、Causal Mask(因果掩码)
- 目标:保证第 $t$ 个 token 只能看见 $\le t$ 的历史位置,不能看到未来位置。
- 常见实现:上三角置为 $-\infty$,在 softmax 后未来位置权重变为 0。
- 作用:满足自回归训练目标,避免训练时“偷看答案”。
2、Attention Mask(注意力掩码)
- 目标:屏蔽 padding、无效区段或不应关注的 token。
- 在实际系统中,常与 Causal Mask 叠加使用。
- 在多轮对话或长文档场景,可扩展为更复杂的块状/窗口式掩码。
一句话理解:Causal Mask 决定“时间方向约束”,Attention Mask 决定“有效内容边界”。
大模型推理过程(Inference Pipeline)
从在线服务角度,推理通常分为两个阶段:
1、Prefill(上下文编码阶段)
- 输入完整 prompt,一次性并行计算所有历史 token 的表示。
- 这个阶段计算密集,耗时通常与 prompt 长度近似线性相关。
- 同时会把各层的 K/V 写入缓存(KV Cache),供后续复用。
2、Decode(自回归生成阶段)
- 每一步只生成 1 个新 token(或少量 token)。
- 新 token 的 Q 与历史 KV 做注意力,避免重复计算历史部分。
- 直到命中 EOS、长度上限或停止词。
3、采样与生成策略
- Greedy:每步取最大概率 token,稳定但保守。
- Top-k / Top-p:限制候选集合后采样,提升多样性。
- Temperature:控制分布平滑度,越大越发散,越小越确定。
4、性能瓶颈与优化点
- 长 prompt 场景瓶颈常在 Prefill。
- 长输出场景瓶颈常在 Decode 与 KV 读写。
- 常见优化:Flash Attention、Paged KV Cache、MQA/GQA、连续批处理(Continuous Batching)。
这也是为什么很多推理优化论文都在围绕“减少内存访问 + 增强并行利用率”展开。
MHA多头注意力机制
基础概念
$$ \text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V $$
因为这里矩阵的点积,是对矩阵元素逐个相乘再相加,如果序列过长会导致结果过大,除以sqrt(d)是为了进行缩放,防止点积结果过大导致softmax函数梯度消失。简单来说,就是需要压缩softmax输入值,以免输入值过大,进入了softmax的饱和区,导致梯度值太小而难以训练。
核心优势
多个头能够在训练中学会注意到不同的内容。例如在翻译任务中,一些attention head可以关注语法特征,另一些attention head可以关注单词特性。这样模型就可以从不同角度来分析和理解输入信息。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiHeadAttention(nn.Module):
    def __init__(self, dim:int, head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        assert self.dim % head_num == 0
        self.head_dim = self.dim // self.head_num

        self.q = nn.Linear(dim, dim)
        self.k = nn.Linear(dim, dim)
        self.v = nn.Linear(dim, dim)

        self.fc = nn.Linear(dim, dim)
    def forward(self, x, mask = None):
        b, s, d = x.shape

        q = self.q(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)
        k = self.k(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)
        v = self.v(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)

        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        attn_weight = F.softmax(attn_score, dim = -1)
        output = torch.matmul(attn_weight, v)

        output = output.transpose(1, 2).contiguous().view(b, s ,d)

        return self.fc(output)
解码中的KV Cache
1、什么是 KV cache?
在 Transformer 推理中,把历史生成的 Key (K) 和 Value (V) 缓存在显存里,供后续新 token 的注意力计算使用。
2、KV 的优势是什么?
避免重复计算历史 token 的 K/V,大幅降低推理开销;Prefill 阶段后,每一步只需计算新 token 的 Q,再用缓存的 K/V,就能做到 从 O(n²) 降到 O(n) 的计算量。
3、为什么缓存 K/V,而不缓存 Q?
-
Q 只对当前 token 生效,用完即弃,不会在未来复用。
-
K/V 会被所有后续 token 的注意力查询重复使用,所以必须缓存。
MQA多Query注意力机制
基础概念
MQA 是对 多头注意力(Multi-Head Attention, MHA) 的一种优化:
传统 MHA:每个头都有独立的 Q、K、V 投影矩阵,每个头的 Key/Value 都单独计算并缓存。
MQA:每个头仍然有自己的 Q(保持不同注意力模式),但 所有头共享同一份 K/V。
这样,每个头使用不同的 Q 对同一份 K/V 做注意力计算,显著减少计算量和显存占用。
核心优势
- 显存占用大幅降低
- 推理时需要缓存 KV(KV cache)以加速生成。
- MHA 每个头都要缓存 K/V,显存占用高;MQA 只缓存一份 K/V,显存降低约为头数倍。
- 推理速度更快
- KV 只计算一次,多头共享,减少重复计算,尤其对长序列生成效果明显。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiQueryAttention(nn.Module):
    def __init__(self, dim: int, head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        assert self.dim % head_num == 0
        self.head_dim = self.dim // self.head_num

        # Q 仍然有多个 head
        self.q = nn.Linear(dim, dim)
        # K 和 V 只有一个 head,由所有 query heads 共享
        self.k = nn.Linear(dim, self.head_dim)
        self.v = nn.Linear(dim, self.head_dim)

        self.fc = nn.Linear(dim, dim)

    def forward(self, x, mask=None):
        b, s, d = x.shape

        # Q 有多个 head: (batch, head_num, seq_len, head_dim)
        q = self.q(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)

        # K 和 V 只有一个 head: (batch, seq_len, head_dim)
        k = self.k(x)  # (b, s, head_dim)
        v = self.v(x)  # (b, s, head_dim)

        # 将 K 和 V 扩展到所有 head: (batch, head_num, seq_len, head_dim)
        k = k.unsqueeze(1).expand(b, self.head_num, s, self.head_dim)
        v = v.unsqueeze(1).expand(b, self.head_num, s, self.head_dim)

        # 计算注意力分数
        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        attn_weight = F.softmax(attn_score, dim=-1)
        output = torch.matmul(attn_weight, v)

        # 重新组合所有 head 的输出
        output = output.transpose(1, 2).contiguous().view(b, s, d)

        return self.fc(output)
GQA组注意力机制
把多个头划分成若干组(group),每组内的头共享同一份 K/V,但不同组之间的 K/V 还是独立的。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class GroupedQueryAttention(nn.Module):
    def __init__(self, dim: int, head_num: int, kv_head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        self.kv_head_num = kv_head_num

        assert self.dim % head_num == 0
        assert head_num % kv_head_num == 0, "head_num must be divisible by kv_head_num"

        self.head_dim = self.dim // self.head_num
        self.group_size = self.head_num // self.kv_head_num  # 每组的 query head 数量

        # Q 有 head_num 个 head
        self.q = nn.Linear(dim, dim)
        # K 和 V 有 kv_head_num 个 head
        self.k = nn.Linear(dim, kv_head_num * self.head_dim)
        self.v = nn.Linear(dim, kv_head_num * self.head_dim)

        self.fc = nn.Linear(dim, dim)

    def forward(self, x, mask=None):
        b, s, d = x.shape

        # Q: (batch, head_num, seq_len, head_dim)
        q = self.q(x).view(b, s, self.head_num, self.head_dim).transpose(1, 2)

        # K, V: (batch, kv_head_num, seq_len, head_dim)
        k = self.k(x).view(b, s, self.kv_head_num, self.head_dim).transpose(1, 2)
        v = self.v(x).view(b, s, self.kv_head_num, self.head_dim).transpose(1, 2)

        # 将 K 和 V 重复以匹配 Q 的 head 数量
        # 每个 KV head 对应 group_size 个 Q head
        k = k.repeat_interleave(self.group_size, dim=1)  # (batch, head_num, seq_len, head_dim)
        v = v.repeat_interleave(self.group_size, dim=1)  # (batch, head_num, seq_len, head_dim)

        # 计算注意力分数
        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        attn_weight = F.softmax(attn_score, dim=-1)
        output = torch.matmul(attn_weight, v)

        # 重新组合所有 head 的输出
        output = output.transpose(1, 2).contiguous().view(b, s, d)

        return self.fc(output)
CrossAttention交叉注意力机制
交叉注意力机制一般用于在多模态的学习中,融合多个部分的信息,在这里面一般以查询方的信息作为Q(Decoder的输入),信息的提供方作为KV,然后Q与K计算得出信息相关度,再与V进行相乘得到最终的值。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class CrossAttention(nn.Module):
    """
    交叉注意力机制实现
    - Query来自目标序列(如decoder的输入)
    - Key和Value来自源序列(如encoder的输出)
    """
    def __init__(self, dim: int, head_num: int):
        super().__init__()
        self.dim = dim
        self.head_num = head_num
        assert self.dim % head_num == 0
        self.head_dim = self.dim // self.head_num

        # Query投影层 - 来自目标序列
        self.q = nn.Linear(dim, dim)
        # Key和Value投影层 - 来自源序列
        self.k = nn.Linear(dim, dim)
        self.v = nn.Linear(dim, dim)

        # 输出投影层
        self.fc = nn.Linear(dim, dim)

    def forward(self, query_seq, key_value_seq, mask=None):
        """
        前向传播
        Args:
            query_seq: 查询序列 (batch_size, query_len, dim)
            key_value_seq: 键值序列 (batch_size, kv_len, dim)
            mask: 注意力掩码 (batch_size, head_num, query_len, kv_len) 或可广播的形状
        Returns:
            输出序列 (batch_size, query_len, dim)
        """
        b, query_len, d = query_seq.shape
        _, kv_len, _ = key_value_seq.shape

        # 计算Q, K, V
        q = self.q(query_seq).view(b, query_len, self.head_num, self.head_dim).transpose(1, 2)
        k = self.k(key_value_seq).view(b, kv_len, self.head_num, self.head_dim).transpose(1, 2)
        v = self.v(key_value_seq).view(b, kv_len, self.head_num, self.head_dim).transpose(1, 2)

        # 计算注意力分数
        attn_score = torch.matmul(q, k.transpose(-2, -1)) / (self.head_dim ** 0.5)

        # 应用掩码
        if mask is not None:
            attn_score = attn_score.masked_fill(mask == 0, -1e9)

        # 计算注意力权重
        attn_weight = F.softmax(attn_score, dim=-1)

        # 应用注意力权重
        output = torch.matmul(attn_weight, v)

        # 重新整形并通过输出投影
        output = output.transpose(1, 2).contiguous().view(b, query_len, d)

        return self.fc(output)
MLA多头隐藏空间注意力
基础概念
在论文中提到,每个Transformer层,只缓存了上述公式蓝框的向量: $c_t^{KV}$ 和 $k_t^R$ ,这两个向量的大小分别为 $4 \times d_h$ 和 $d_h / 2$
对比MQA(每层有一个 $d_h$ 维度的 $k$ 和 一个 $d_h$ 维度的 $v$ ,共 $2d_h$ 个元素),MLA相当于增加了2.25倍的存储,但DeepSeek描述自己的方法不仅比MQA强,而且比非共享KV的原始MHA也要强.
kv的计算过程
1、首先公式(41)对输入 $h_t$ 做一个低秩压缩,将 $d$ 维的输入经过 $W^{DKV}$ 变换后压缩成 $d_c$ 维的 。DeepSeek-V3中 $d = 7168$ $d_c = 512$
2、然后通过公式(42)和公式(45)两个变换矩阵 $( W^{UK} , W^{UV} \in \mathbb{R}^{d_h n_h \times d_c} ) ,$,将KV的维度扩展回 $d = d_hn_h$,也就是每个Head有一个单独的 $k,v$(跟MHA的KV数量一致)
经过上述的变换,非常类似LoRA做低参数微调的逻辑。通过两个低秩矩阵先做压缩、再做扩展,最终能降低参数的数量。但MLA本质是要做到减少KV-cache的存储。LoRA强调的是参数量的减少,类似MLA这操作确实也减少了参数量,按DeepSeek-V3的参数配置,两个低秩矩阵参数量 $2 \times d_c \times d = 2 \times 512 \times 7168$: ,而正常MHA的参数矩阵参数量: $d \times d = 7168 \times 7168$
Q的计算过程
公式(37),(38)类似KV的逻辑,通过两个矩阵$( W^{DQ} , W^{UQ} \in \mathbb{R}^{d_h n_h \times d_q} )$也做了一层低秩变换,这一步Q的变换看起来是为了减少模型参数数量。在DeepSeek-V3里 $d_q = 1536$,是KV压缩维度的3倍。但相对于 $d = 7168$ 还是压缩了不少。
q,k增加RoPE位置编码
我们注意到在增加RoPE位置编码并没有在上述计算出的 $q_t^C,k_t^C$ 的基础上乘以RoPE的对角矩阵。而是单独计算了两个带着位置编码的 $q_t^R,k_t^R$ 如公式(39)和公式(43)所示
-
$q_t^R,k_t^R$的向量维度 $d_h^R$ 是个比较小的维度,DeepSeek设置为单Attention Head维度的一半: $d_h^R = d_h / 2 = 64$
-
这部分计算的 $k_t^R$ 实际是个MQA的计算方式,同一层中,所有的Head共享同一 $k$
然后按如下公式(40),(44)跟已经计算的 $q_t^C,k_t^C$拼接,构成完整的 $q_t,k_t$ 向量。
所以到目前为止,我们得到的 $q,k$ 包括两部分拼接而成:一部分是做了低秩压缩得到的 $q,k$ 向量,一部分是增加了RoPE位置编码的 $q,k$ 向量。(后面这部分向量是基于MQA方式计算得到的,所有Head共享1个 )。
核心优势
1.MLA引入变换矩阵对输入做变换。这个变换矩阵可以通过 $c = f(x)$ 来获得,其中 $f$ 是一个线性变换。通过矩阵乘法的交换律来优化 $c'W_{qc}$ 和$cW_{kc}$,通过预计算 $W_{qc} W_{kc}$,推理时只需要存储变换后的 $c$,而不需要存储 $k$ 和 $v$,从而减少KV Cache的大小。
2.由于这个设计在推理的时候无法直接应用RoPE。MLA巧妙地引入了两个部分:
- 非RoPE部分: 使用$c'W_{qc}$和$cW_{kc}$计算Q和K,保留内容特征
- RoPE部分: 引入 $W_{qr}$ 和 $W_{kr}$ 来处理位置信息
3.在DeepSeek实现RoPE部分时,MLA使用原始输入 $x$ 而不是 $c$ 来计算K的RoPE部分 $(xW_{kr})$,大概是因为使用原始的 $x$ 不会破坏位置信息。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F
import math
from typing import Dict


class MultiheadLatentAttention(nn.Module):
    def __init__(self, args: Dict):
        super().__init__()

        # 基本参数设置
        self.n_heads = args.n_heads # 头数=128
        self.d_k = args.d_k  # 非RoPE部分的维度 (128)
        self.d_r = args.d_r  # RoPE部分的维度 (64)
        self.d_c = args.d_c  # 低秩投影维度 (512)
        self.d_c_prime = args.d_c_prime  # Q的低秩投影维度 (1536)
        self.d_v = args.d_v  # V的输出维度 (128)


        # 定义投影矩阵
        # 低秩投影 d_c_prime * d_c
        self.W_c = nn.Linear(args.dim, self.d_c, bias=False)  # W_c
        # 低秩投影 d_c_prime * d_c_prime
        self.W_c_prime = nn.Linear(args.dim, self.d_c_prime, bias=False)  # W_c'

        # Q的投影矩阵 d_c_prime * d_k
        self.W_qc = nn.ModuleList([
            nn.Linear(self.d_c_prime, self.d_k, bias=False)
            for _ in range(self.n_heads)
        ])  # W_qc^(s)
        # Q的RoPE投影矩阵 d_c_prime * d_r
        self.W_qr = nn.ModuleList([
            nn.Linear(self.d_c_prime, self.d_r, bias=False)
            for _ in range(self.n_heads)
        ])  # W_qr^(s)

        # K的投影矩阵 d_c * d_k
        self.W_kc = nn.ModuleList([
            nn.Linear(self.d_c, self.d_k, bias=False)
            for _ in range(self.n_heads)
        ])  # W_kc^(s)
        # K的RoPE投影矩阵 d_c * d_r
        self.W_kr = nn.Linear(args.dim, self.d_r, bias=False)  # W_kr

        # V的投影矩阵 d_c * d_v
        self.W_v = nn.ModuleList([
            nn.Linear(self.d_c, self.d_v, bias=False)
            for _ in range(self.n_heads)
        ])  # W_v^(s)

        # Dropout层
        self.attn_dropout = nn.Dropout(args.dropout)
        self.resid_dropout = nn.Dropout(args.dropout)

        # KV缓存
        self.c_cache = None  # 低秩投影后的缓存
        self.x_cache = None  # 原始输入的缓存

        # 注意力掩码
        max_seq_len = args.max_seq_len
        attn_mask = torch.full((1, 1, max_seq_len, max_seq_len), float("-inf"))
        self.register_buffer("attn_mask", torch.triu(attn_mask, diagonal=1), persistent=False)

    def precompute_matrices(self):
        # 推理阶段使用的预计算矩阵, W_qc^(s) * W_kc^(s)
        self.merged_W_qc_kc = [
            torch.matmul(self.W_qc[i].weight, self.W_kc[i].weight.t())
            for i in range(self.n_heads)
        ]

    def forward(self, x, rotary_emb=None, kv_cache=False):
        batch_size, seq_len, _ = x.shape

        # 低秩投影
        c = self.W_c(x)  # [batch_size, seq_len, d_c]
        c_prime = self.W_c_prime(x)  # [batch_size, seq_len, d_c_prime]

        # 缓存处理
        if kv_cache and not self.training:
            has_cache = self.c_cache is not None and self.x_cache is not None
            if seq_len == 1 and has_cache:
                c = torch.cat((self.c_cache, c), dim=1)
                x = torch.cat((self.x_cache, x), dim=1)
            self.c_cache = c
            self.x_cache = x

        outputs = []
        for head in range(self.n_heads):
            if not self.training:  # 推理模式
                # 使用预计算的矩阵计算非RoPE部分的注意力得分
                q_c = torch.matmul(c_prime, self.merged_W_qc_kc[head])  # [batch_size, seq_len, d_c]
                # 注意: 这里直接使用c而不是k_c,因为我们已经预计算了W_q和W_k的乘积
                k_c = c
            else:  # 训练模式
                # 计算Q和K的非RoPE部分
                q_c = self.W_qc[head](c_prime)  # c'W_qc^(s)
                k_c = self.W_kc[head](c)  # cW_kc^(s)

            # 计算RoPE部分
            q_r = self.W_qr[head](c_prime)  # c'W_qr^(s)
            k_r = self.W_kr(x)  # xW_kr

            # 应用RoPE
            if rotary_emb is not None:
                q_r = apply_rope(q_r, rotary_emb)  # c'W_qr^(s)R_i
                k_r = apply_rope(k_r, rotary_emb)  # xW_krR_i

            # 拼接Q和K的两个部分
            q = torch.cat([q_c, q_r], dim=-1)  # [batch_size, seq_len, d_k + d_r]
            k = torch.cat([k_c, k_r], dim=-1)  # [batch_size, seq_len, d_k + d_r]

            # 计算注意力分数
            scale = 1.0 / math.sqrt(self.d_k + self.d_r)
            attn_scores = torch.matmul(q, k.transpose(-2, -1)) * scale

            # 添加注意力掩码
            attn_scores = attn_scores + self.attn_mask[:, :, :seq_len, :seq_len]

            # 计算注意力概率
            attn_probs = F.softmax(attn_scores.float(), dim=-1).type_as(q_c)
            attn_probs = self.attn_dropout(attn_probs)

            # 计算V和输出
            v = self.W_v[head](c)  # cW_v^(s)
            head_output = torch.matmul(attn_probs, v)

            outputs.append(head_output)

        # 拼接所有头的输出
        output = torch.cat(outputs, dim=-1)
        return self.resid_dropout(output)
Flash Attention
Flash Attention 是一种对 Transformer 中注意力机制计算过程的优化算法。它不改变注意力机制的数学公式(输出数值近似一致),而是通过分块计算和重计算策略,优化了 GPU 显存IO的效率。
为什么能起效果: 因为GPU 计算能力(算力)其实非常强,瓶颈不在于“算得不够快”,而在于“数据搬运得太慢”
核心思想:IO 复杂度优化
Flash Attention 的核心在于减少 GPU HBM(高带宽内存)与 SRAM(片上高速缓存)之间的数据交换次数。
- 标准 Attention:需要多次读写 $N \times N$ 的注意力矩阵到 HBM,显存复杂度为 $O(N^2)$。
- Flash Attention:利用 SRAM 进行分块计算,避免将完整的注意力矩阵写回 HBM,将显存复杂度降低到 $O(N)$。
关键技术
-
分块计算 (Tiling) 将输入矩阵 Q, K, V 切分为小块,加载到 SRAM 中使用 Online Softmax 进行计算。
-
重计算 (Recomputation) 在反向传播时,不存储前向传播的注意力矩阵,而是利用存储在 HBM 中的输出和统计量在 SRAM 中重新计算(和前向过程一样),以时间换空间。
-
Online Softmax (基于 Safe Softmax) 为了在分块计算中保持数值稳定性,Flash Attention 使用了 Online Softmax 技巧。下面简要说一下,详细原理见:FlashAttention 中的 Safe Softmax
- Safe Softmax 原理:为了防止计算 $e^{x_i}$ 时溢出,通常会减去最大值:$\text{Softmax}(x) = \text{Softmax}(x - \max(x))$。
- Online Softmax:由于分块计算无法一次性知道全局最大值,Flash Attention 维护局部的最大值和归一化因子,随着块的推进动态更新结果,最终等价于全局 Safe Softmax。
激活函数与专家结构
SwiGLU激活函数
基础概念
公式为$\text{SwiGLU}(a, b) = a \otimes \text{Swish}(b)$,SwiGLU由Swish激活函数和门控线性单元(GLU)组成,有通过门控过滤信息的特性。
核心优势
**平滑性:**Swish函数的平滑性,比ReLU、Leaky Relu更平滑,处处可导,有利于模型更稳定、收敛速度更快;
**非单调性:**Swish函数的非单调性,能够捕捉到更复杂的模式;
**门控机制:**引入门控机制,使得模型能够选择性地通过信息,从而提高模型的表达能力;
**计算效率:**相比GeLU这种复杂的激活函数计算效率要高
1、为什么SwiGLU在Transformer的FFN层中比ReLU更有效?
ReLU的硬截断特性可能导致梯度消失,而SwiGLU的Swish门控平滑且保留负区间的部分信息,增强了梯度的稳定性;同时,门控机制通过参数化选择重要特征,提升了模型表达能力。
手撕代码
import torch
import torch.nn as nn
import torch.nn.functional as F

class SwiGLU(nn.Module):
    def __init__(self, dim: int, hidden_dim: int):
        super().__init__()
        self.w1 = nn.Linear(dim, hidden_dim)
        self.w2 = nn.Linear(hidden_dim, dim)
        self.w3 = nn.Linear(dim, hidden_dim)

    def forward(self, x):
        return self.w2(F.silu(self.w1(x)) * self.w3(x))
DeepSeekMOE
MOE 架构的基本思想是在传统 Transformer 模型中,将每个前馈网络(FFN)层替换为一个 MOE 层。一个 MOE 层通常由两个关键部分组成:
- 专家网络(Experts) 每个专家是一个独立的子网络(通常是 FFN),在实际计算中只有部分专家会被激活参与处理。通过让多个专家分担不同数据子集的计算,模型在预训练时可以以较低的计算开销获得大参数量带来的表示能力。
- 门控网络(Gating/Router) 自学成才,并不是不动的 该模块负责根据输入 token 的特征动态选择激活哪些专家。门控网络一般采用一个带 softmax 的简单前馈网络来计算每个专家的权重。经过训练后,门控网络会逐步学会将相似的输入路由到表现更好的专家。
如何避免“过热”与“过冷”专家?
1、辅助负载均衡损失:在整体的损失函数中增加一个辅助项,专门用于衡量各专家在一个 batch 中的激活数量的均衡性。根据该batch在所有专家的token的分布情况去算这个辅助项,token分布的方差越大,损失越高。
2、专家容量限制:通过为每个专家设定一个处理 token 的上限(容量因子),当某个专家达到上限时,额外的 token 会被分配到其他专家或溢出处理。
3、随机路由与噪声策略:噪声的引入使得初始路由决策具有随机性,降低了某些专家因早期优势而被持续选中的风险。同时,一些方法采用随机抽样机制,进一步鼓励低激活率的专家获得机会。
在DeepSeek‐V3 的 MoE 模块中,主要包含两类专家:
路由专家(Routed Experts):每个 MoE 层包含 256 个路由专家,这些专家主要负责处理输入中某些特定、专业化的特征。
共享专家(Shared Expert):每个 MoE 层中还有 1 个共享专家,用于捕捉通用的、全局性的知识,为所有输入提供基本的特征提取支持。
在DeepSeek-V3中解决负载均衡问题的创新设计:
**引入偏置(Bias)**每个路由专家都会有一个可学习的偏置项。当某个专家长期处于低使用状态时,其偏置会自适应地上调,从而增加其被选中的概率;反之,对于被频繁激活的专家,其偏置会下降,从而降低激活概率。值得注意的是,这个偏置项只用于专家选择过程,即在计算得分时加上偏置,而不会在专家输出加权求和时使用,从而确保了最终输出不受不必要的干扰。
推理加速
DeepSeekMTP
核心思想:通过解码阶段的优化,将1-token的生成,转变成multi-token的生成,从而提升训练和推理的性能。具体来说,在训练阶段,一次生成多个后续token,可以一次学习多个位置的label,进而有效提升样本的利用效率,提升训练速度;在推理阶段通过一次生成多个token,实现成倍的推理加速来提升推理性能。
通过 D 个顺序模块预测 D 个额外的token。每个MTP模块由以下组成:
- 共享Embedding层
- 共享Transformer块
- 投影矩阵
使用MTP主要有两方面的优点:
- 密集训练信号:通过MTP目标,训练信号更加密集,有助于提高数据利用率。
- 预规划表示:MTP能够提升模型对未来token编码的预规划能力,从而实现更好的预测性能。
- **推理加速:**在推理的时候,如果不删除Head,那么将能够一次预测多个token,然后再根据一些校验规则(如部分前向计算或 logprob 比较)选择保留哪些token作为下一次推理。
大模型训练与对齐
大模型训练全流程(Training Pipeline)
从 0 到可用模型,一般经历三层递进:
1、预训练(Pretraining)
- 目标:学习通用语言与知识分布。
- 数据:大规模无标注文本(网页、书籍、代码等)。
- 损失:下一 token 预测的交叉熵。
2、指令微调(SFT)
- 目标:让模型学会“按指令完成任务”。
- 数据:高质量指令-回答对。
- 结果:可用性显著提升,但“偏好对齐”能力仍有限。
3、偏好对齐(RLHF/DPO/GRPO 等)
- 目标:让回答更符合人类偏好(有用、真实、安全)。
- 方法:奖励建模 + 强化学习,或直接偏好优化(如 DPO)。
- 结果:从“能回答”走向“回答更像人希望的样子”。
实践中通常还会补充:
- 课程式数据配比(先易后难)。
- 持续评测与回流(线上 badcase -> 训练集)。
- 安全策略训练(拒答边界、风险内容约束)。
一句话理解:预训练解决“懂不懂”,SFT 解决“会不会做”,对齐训练解决“做得像不像人希望的样子”。
上下文学习(ICL)
上下文学习(In-Context Learning)是指模型在不更新参数的情况下,只依赖 prompt 中的任务描述、示例和格式约束,在当前上下文中临时学会任务并完成泛化。
1、核心机制
- 本质上利用了大模型在预训练阶段学到的“从上下文归纳规则”的能力。
- 模型通过 attention 读取前文示例,把示例中的输入输出映射关系迁移到当前样本。
2、典型使用方式
- Zero-shot:只给任务描述,不给示例。
- Few-shot:给少量高质量示例,约束输出风格和格式。
- 指令 + 结构化模板:通过固定字段或步骤提示提高稳定性。
3、优缺点
- 优点:灵活、低成本、无需训练、上线迭代快。
- 局限:对提示词质量敏感,稳定性通常不如 SFT;上下文变长时还会带来额外推理成本。
一句话理解:ICL 是“把学习过程放到上下文里临时完成”,而不是把能力写入参数。
自蒸馏(Self-Distillation)
自蒸馏(Self-Distillation)是指模型用自己更强阶段或更高质量输出继续监督自己训练:先通过高成本推理得到更优答案,再把这些结果作为伪标签回灌训练。
1、核心机制
- 先获得“教师信号”:例如多次采样、长链推理、搜索增强,或用更强版本模型生成更优答案。
- 再做“学生训练”:将高质量输出转成监督数据,继续训练同体系模型。
2、常见收益
- 把“高成本推理时表现出的能力”压缩回参数中。
- 提升推理能力,减少人工标注依赖。
- 在部署侧用更低成本获得接近高成本推理的效果。
3、实践注意点
- 伪标签质量决定上限,需做过滤、去重和一致性校验。
- 要避免错误答案反复回灌导致能力漂移。
- 常与 SFT、偏好优化联合使用,形成闭环迭代。
一句话理解:自蒸馏是一种“能力回灌与压缩”机制,把昂贵推理能力沉淀成廉价推理能力。
训练流程与损失函数
DeepSeek R1的训练流程
1、冷启动:冷启动的训练数据,采用包含思考过程(CoT)的数据,目的是初步教会模型如何思考,如何“符合人类口味习惯”的思考。加速第二阶段推理场景强化学习的收敛速度。
2、推理场景强化学习:这个阶段的强化学习方法和DeepSeek-R1-Zero的方法保持一致,仅新增了一条规则——语言一致性规则,减轻多语言混杂的情况。这一步的目的是增强模型的推理能力。
3、数据采样与SFT:
阶段 2 强化学习后得到的模型,我们暂且称为DeepSeek-V3-SFT-RL。阶段 3 的采样分为两种数据,一种是推理数据,一种是非推理数据。
推理数据:对DeepSeek-V3-SFT-RL进行拒绝采样。采样的过程中,除了数学/代码等具有确定性结果的问题,也扩充了一些非确定性结果的数据,由DeepSeek-V3作为奖励模型进行判断。最终收集了60w个与推理相关的数据样本。
**非推理数据:**从DeepSeek-V3提取了20w个非推理的数据样本。包含写作、事实问答、自我认知、翻译等任务。
4、全场景强化学习:
第四个步骤,旨在提升模型的有用性和无害性,消除模型的歧视偏见等风险。同时,也精炼其推理能力。具体来说,对于推理数据,沿用阶段2的规则。对于非推理数据,采用奖励模型进行反馈。奖励模型同样基于DeepSeek-V3进行构建,评估模型输出是否符合人类的偏好。经过强化学习后,得到最终的DeepSeek-R1模型。
预训练和SFT的损失函数
在大模型中,无论是预训练阶段还是SFT阶段,使用的都是如公式(2)所示的交叉熵损失,从信息论的角度,交叉熵衡量的是两个概率分布 $p$(真实分布)和 $q$(预测分布)之间的差异。input token 期望预测出的下一个 token 为真实 token 的平均交叉熵最小。 $$ H(p, q) = - \sum_{x} p(x) \log(q(x)) $$ 预训练: 1、模型输入是整个句子序列的一部分
2、它学习根据之前的tokens预测下一个token
3、是自回归语言建模(但next token的预测很像在一个大词表上做下一个词的分类,从词表中选一个单词)
**监督微调(SFT): **
1、模型输入是指令 $x$;
2、模型输出是回答 $y$;
3、只对回答部分计算损失(输入 prompt 不参与 loss)
4、本质仍是交叉熵,但带条件输入。
大模型的训练是自回归的任务,为什么用交叉熵损失?
一个自回归语言模型的目标是:$P_{\theta}(x_1, x_2, \ldots, x_T) = \prod_{t=1}^{T} P_{\theta}(x_t \mid x_{<t})$ ,也就是说,模型要最大化整个句子的联合概率,通过分解成一连串“下一个 token”的条件概率。于是训练目标就是最大化似然。当我们在语言模型中,每个时间步的目标是“正确的下一个词”,这本质上是一个多分类问题(在词表 vocab 上分类,自回归语言模型的训练目标是最大化下一个 token 的似然)。所以,交叉熵损失 = 负对数似然(NLL)损失。
为什么不用MSE?
1、MSE(均方误差)通常用于连续值的回归任务,而语言模型的输出是概率分布(离散分类)。
2、梯度不稳定,Softmax 输出接近 0/1 时,MSE 的梯度几乎消失;交叉熵仍能提供强梯度。
3、惩罚方式不合理,MSE 对错误的 token 惩罚线性,而交叉熵是对数级别惩罚,更符合概率意义。
SFT(监督微调)
LoRA
LoRA的做法是在LLM的某些矩阵( $W \in \mathbb{R}^{d \times k}$ )旁插入一个和它并行的新的权值矩阵 $\Delta W \in \mathbb{R}^{d \times k}$ ,但是因为模型的低秩性的存在(个人理解:深度学习的矩阵往往是过参数化的,许多问题的内在维度比人们认为的要小的多,而对于某个数据集,内在维度在不同参数量级的模型上差距并不大。),我们可以将$\Delta W $ 拆分成降维矩阵 $A \in \mathbb{R}^{r \times k}$ 和升维矩阵 $B \in \mathbb{R}^{d \times r}$(如图所示),其中 $r \ll \min(d, k)$ ,从而实现了以极小的参数数量训练LLM。在训练时,我们将LLM的参数固定,只训练矩阵 $A$ 和 $B$。根据式(1),在模型训练完成之后,我们可以直接将 $A$ 和 $B$ 加到原参数上,从而在推理时不会产生额外的推理时延。
$$
h = W_0 x + \Delta W x = (W_0 + \Delta W) x = W x + B A x
$$
在初始化时,$A$ 使用高斯初始化,$B$ 使用零矩阵进行初始化。因为 $r$ 通常是一个非常小的值(实验证明1,2,4,8的效果就非常好),所以LoRA在训练时引入的参数量是非常小的,因此它的训练也是非常高效的,也不会带来显著的显存增加。LoRA要求 $A$ 或者 $B$ 其中之一必须使用零矩阵进行初始化,这样当数据第一次通过网络时,它和预训练的结果是一致的,不至于直接训歪导致模型坍塌。
LoRA的 $\alpha$ 作用是什么:缩放系数,用于调节低秩更新项的影响力,防止低秩更新的扰动过大。
LoRI:通过将投影矩阵 A 冻结为随机投影,并使用任务特定掩码对矩阵 B 进行稀疏化处理,LoRI 在自然语言理解、数学推理、代码生成和安全对齐等多个领域都取得了出色的单任务性能,与 LoRA 相比,其可训练参数最多可减少 95%。
QLoRA:在微调之前,将原模型量化为4-Bit,冻结量化后的模型参数,量化后的主权重不再训练,只保留反量化用于前向传播。LoRA 模块仍保持高精度(FP16/BF16),只训练这些小矩阵。显存中保存的依然是 4-bit 权重;反量化仅在计算时使用小块 FP16 缓冲区(几 MB 级别);完成计算后立即释放。
HiRA:
-
提出了一种新的高秩适配方法 HiRA(Hadamard High-Rank Adaptation),用于大语言模型(LLM)的参数高效微调(PEFT)。
不同于传统的 LoRA 采用低秩分解(低秩矩阵乘法)来更新参数,HiRA 使用 Hadamard(逐元素)积 来构造更新矩阵,从而在保持相同参数量的情况下获得更高的秩和更强的表达能力。
-
突破了 LoRA 的低秩瓶颈。
LoRA 的更新矩阵最大秩受限于设定的低秩 r;
HiRA 利用 Hadamard 乘法的性质,使更新矩阵的秩理论上可达到原参数矩阵与低秩矩阵秩的乘积,大幅提升模型的适应性。
LoRA伪代码
input_dim = 768 # 例如,预训练模型的隐藏大小
output_dim = 768 # 例如,层的输出大小
rank = 8 # 低秩适应的等级'r'
W = ... # 来自预训练网络的权重,形状为 input_dim x output_dim
W_A = nn.Parameter(torch.empty(input_dim, rank)) # LoRA权重A
W_B = nn.Parameter(torch.empty(rank, output_dim)) # LoRA权重B
# 初始化LoRA权重
nn.init.kaiming_uniform_(W_A, a=math.sqrt(5))
nn.init.zeros_(W_B)

def regular_forward_matmul(x, W):
  h = x @ W
  return h

def lora_forward_matmul(x, W, W_A, W_B):
  h = x @ W # 常规矩阵乘法
  h += x @ (W_A @ W_B) * alpha # 使用缩放的LoRA权重
  return h
RLHF(基于人类反馈的强化学习)
RFT vs 监督微调(SFT)
| 特征 | 监督式微调(SFT) | 强化微调(RFT) |
|---|---|---|
| 核心思想 | 直接在标记数据上训练模型以匹配期望输出 | 使用奖励信号引导模型有更好的输出 |
| 数据需求 | 需要大量标记的示例数据 | 可能只需要少量的数据标注,无需大规模标注 |
| 学习方式 | 通过模仿学习已有的输入-输出对 | 通过试错和反馈发现最优策略 |
| 创新能力 | 受限于数据的多样性 | 可以发现创造性的解决方案 |
| 人工参与 | 主要在初始数据标注阶段 | 主要在设计奖励阶段 |
DPO
PPO的单样本损失为: $$ \mathcal{L}{\text{DPO}}(\theta) = - \log \sigma \left[ \beta \left( \log \pi{\theta}(y^{+} \mid x) - \log \pi_{\theta}(y^{-} \mid x) \right) - \left( \log \pi_{\text{ref}}(y^{+} \mid x) - \log \pi_{\text{ref}}(y^{-} \mid x) \right) \right] $$ DPO源于强化学习中的RLHF思想,但训练方式是监督学习式的偏好对齐。
它是非交互式的(无需环境采样或在线rollout)。
因此,DPO是一种静态、离线的偏好优化方法。
本质上属于监督微调范式,而非传统在线强化学习。
1、目标:求出“偏好概率”怎么与策略 $\pi_\theta$怎么联系起来
我们希望求出:在给定输入(x)下,模型输出( $y_1$)比( $y_2$)更被偏好的概率是多少?也就是:$p^{*}(y_1 \succ y_2 \mid x)$
根据BT模型,这个概率大小与两个输出的reward大小有关: $$ p^{}(y_1 \succ y_2 \mid x) = \frac{\exp(r^{}(x, y_1))}{\exp(r^{}(x, y_1)) + \exp(r^{}(x, y_2))} $$ 越大的reward表示越“被偏好”;
用softmax形式写偏好概率,是很自然的选择。
2、接下来要做的:把reward表达成策略的形式,在DPO论文中已经说明,最优策略与reward存在如下关系: $$ r^{}(x, y) = \beta \log \frac{\pi^{}(y \mid x)}{\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x) $$ 3、把这个 $r^$ 带入偏好概率公式: $$ p^{}(y_1 \succ y_2 \mid x) = \frac{\exp\left(\beta \log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} + \beta \log Z(x)\right)}{\exp\left(\beta \log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} + \beta \log Z(x)\right) + \exp\left(\beta \log \frac{\pi^{}(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)} + \beta \log Z(x)\right)} $$ 4、分子归一化: $$ p^{}(y_1 \succ y_2 \mid x) = \frac{1}{1 + \exp\left(\beta \log \frac{\pi^{}(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)} - \beta \log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)}\right)} $$ 5、识别sigmoid( $\sigma$)形式 $$ p^{}(y_1 \succ y_2 \mid x) = \sigma\left(\beta\left[\log \frac{\pi^{}(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} - \log \frac{\pi^{*}(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)}\right]\right) $$ 6、转换为损失形式,其实就是个二分类的交叉熵:$L = -\big[y \log(\sigma(z)) + (1-y)\log(1-\sigma(z))\big]$,在这里里面y始终为1,简化为 $L = -\log(\sigma(z))$
最大化5中的公式可以转换为最小化如下: $$ \mathcal{L}{\text{DPO}} = - \log \sigma \left( \beta \left[ \log \frac{\pi{\theta}(y^{+} \mid x)}{\pi_{\text{ref}}(y^{+} \mid x)} - \log \frac{\pi_{\theta}(y^{-} \mid x)}{\pi_{\text{ref}}(y^{-} \mid x)} \right] \right) $$
简单手撕
# Pseudocode for Direct Preference Optimization (DPO)
Initialize reference model π_ref (frozen)
Initialize policy model πθ

for each batch (x, y_w, y_l) in preference_dataset:
    # compute log probs under both models
    logp_w = log πθ(y_w | x)
    logp_l = log πθ(y_l | x)
    logp_w_ref = log π_ref(y_w | x)
    logp_l_ref = log π_ref(y_l | x)

    # compute the DPO loss
    logits = β * ((logp_w - logp_l) - (logp_w_ref - logp_l_ref))
    loss = -mean(log_sigmoid(logits))  # maximize preference consistency

    # gradient descent
    update θ ← θ - η * ∇θ(loss)
PPO
PPO代表近端策略优化,它需要以下组件:
1、策略(Actor、Policy)模型($\pi_{\theta}$):经过预训练或SFT后的模型,该模型是可学习的,需要打开训练。
2、约束模型($\pi_{ref}$):该模型是冻结的,不需要参与训练,用来做KL散度约束,用来防止Actor模型的分布偏离原始模型太远。
3、奖励模型($R_{\phi}$):一个经过训练并冻结的模型,它为给定 prompt 的完整响应提供奖励分值,有时不需要,基于规则也可以给奖励。
4、价值模型($V_{\Phi}$):它是一个可学习的模型,它为给定 prompt 的部分响应提供奖励分值。
PPO的整个流程包含以下六个部分:
1、生成响应:LLM为给定单个prompt生成单个响应;
2、响应打分:奖励模型为每个响应分配奖励;
3、响应价值:价值模型给出多步响应对应的价值
4、计算优势(advantages):使用 GAE(广义优势估计)计算优势;
5、**优化策略(policy):**通过优化总目标来更新 LLM;
6、更新价值函数(critic):训练价值函数,使其更好地预测给定部分响应的奖励。
广义优势估计(GAE)
我们的策略通过优化优势函数(advantage function)来更新。直观地讲,优势函数定义了在特定状态$s_{t}$(即提示 prompt + 到目前为止生成的词)下选择某个动作$a_{t}$(即词)相较于平均动作的优越程度。优势函数的定义如下: $$ A_{t} = Q(s_{t}, a_{t}) - V(s_{t}) $$ $Q(s_{t}, a_{t}))$: 动作价值(action value),表示在状态$s_{t}$下选择动作$a_{t}$的期望回报;
$V(s_{t})$: 状态价值(state value),表示状态$s_{t}$下的期望回报。
为了估计这个优势函数$A_t$,通常有两种主要方法,每种方法都有其优缺点:
-
蒙特卡洛方法(Monte-Carlo, MC):
-
- 方法:使用完整轨迹的奖励(即完整响应的奖励)来估计优势。
- 优点:这种方法具有低偏差(low bias),因为它能准确地反映完整轨迹的真实奖励。
- 缺点:由于奖励稀疏,需要采样足够多的完整轨迹才能进行优化。这会导致高方差(high variance),并且代价昂贵。
-
时序差分方法(Temporal Difference, TD):
-
- 方法:使用一步轨迹奖励(即刚生成的 token 的奖励)来估计优势。
- 优点:这种方法能在 token 级别计算奖励,显著减少了方差(low variance)。
- 缺点:由于无法准确预测完整响应的最终奖励,这种方法会引入较高的偏差(high bias)。
-
为了在偏差和方差之间取得平衡,引入了 General Advantage Estimation (GAE)。GAE 通过多步 TD 来实现这一目标。
TD误差(步长为1):$\delta_{t} = R_{t+1} + \gamma V_{\Phi}(s_{t+1}) - V_{\Phi}(s_{t})$
GAE(步长为n): $$ \begin{aligned} A_{t}^{n} &= R_{t+1} + \gamma^2 R_{t+2} + \dots + \gamma^n V_{\Phi}(s_{t+n}) - V_{\Phi}(s_{t}) \ &= \sum_{l=1}^{n} \gamma^{l-1} \delta_{t+l-1} \end{aligned} $$ 最终形式:$A_{t}^{\text{GAE}} = \sum_{l=0}^{\infty} (\gamma\lambda)^{l} \delta_{t+l}$
PPO 的主要目标是最大化 advantage($A_{t}^{\text{GAE}}$ ) 地方,也就是说,我们希望让 LLM 生成的每一个 token 都能够最大化 reward(或者说,最大化 advantage——即每个 token 要比它“平均水平”的表现更好)。这个目标通过以下公式实现: $$ \mathcal{L}{\text{clip}}(\theta) = \mathbb{E}{t}\left[\min\left(c_{t}(\pi_{\theta})A_{t}^{\text{GAE}}, \operatorname{clip}(c_{t}(\pi_{\theta}), 1 - \epsilon, 1 + \epsilon)A_{t}^{\text{GAE}}\right)\right] $$ $c_{t}(\pi_{\theta}) = \frac{\pi_{\theta}(a_{t} \mid s_{t})}{\pi_{\theta_{\text{old}}}(a_{t} \mid s_{t})}$: 是在给定累计状态 $s_t$下,策略更新前后的概率比值;
$\epsilon$: 是一个超参数,用于控制 clip 范围;
$A_{t}^{\text{GAE}}$: 是之前通过 GAE 计算得到的优势值。
Critic loss
理论上,我们并没有办法获得真实的折扣回报,因此无法获取 Critic 的明确标签。而在 Actor-Critic 范式中使用包含了真实奖励的折扣回报$\hat{G_t}$ 作为标签。下面是 Critic loss 的计算公式: $$ \mathcal{L}(\Phi) = \mathbb{E}{t}\left[\max\left(\left(V{\Phi}(s_{t}) - \hat{G}{t}\right)^2, \left(\operatorname{clip}\left(V{\Phi}(s_{t}), V_{\Phi}^{\text{old}}(s_{t}) - \epsilon, V_{\Phi}^{\text{old}}(s_{t}) + \epsilon\right) - \hat{G}_{t}\right)^2\right)\right] $$
KL散度
除了最大化 advantage,PPO 还引入了 KL 惩罚,防止当前策略偏离我们微调前的原始模型太远: $$ \operatorname{KL}(\theta) = \mathbb{E}{s_t}\left[\mathbb{D}{\text{KL}}\left(\pi_{\theta}(\cdot \mid s_t) | \pi_{\text{ref}}(\cdot \mid s_t)\right)\right] $$
$$ \mathbb{D}{\mathrm{KL}}(P | Q) = \sum{x} P(x) \log \frac{P(x)}{Q(x)} $$
在计算 KL 散度时需要计算两个模型在整个词表上的概率,为了简化计算过程,在实现时通常采用近似计算。如下图所示
熵奖励(Entropy Bonus)
熵奖励用于鼓励 LLM 探索更多的输出,而不是一味选择概率最高的词:$H(\theta) = -\mathbb{E}{a_i \sim \pi{\theta}}\left[\log \pi_{\theta}(a_i \mid s)\right]$
PPO最终的损失loss:
简单手撕
# Pseudocode for PPO (simplified)
Initialize policy πθ, value function Vϕ

for iteration in range(K):
    trajectories = collect_trajectories(πθ_old)
    for each trajectory:
        compute advantage A_t = R_t - Vϕ(s_t)

    for epoch in range(update_epochs):
        for batch in sample_minibatches(trajectories):
            r_t = πθ(a_t|s_t) / πθ_old(a_t|s_t)
            L_clip = min(r_t * A_t, clip(r_t, 1-ε, 1+ε) * A_t)
            L_vf = (Vϕ(s_t) - R_t)^2
            loss = -E[L_clip - c1 * L_vf + c2 * entropy(πθ)]

            update θ, ϕ by gradient descent
    θ_old ← θ
GRPO
GRPO 相较于 PPO 的主要改进为:
- 使用对同一问题的多个采样输出的平均奖励作为基线**;**
- 优势计算中去掉了对值函数$V_{\Phi}(s_{t})$的依赖**。**
下面是 GRPO 计算 advantage 的具体流程:
-
采样多个响应:对每个 prompt,采样一组 response:$r = {r_{1}, r_{2}, \dots, r_{G}}$
-
通过 Reward Model 打分:对每个响应$r_i$,使用奖励模型$R_{\phi}(r_{i})$得到一个分数。对应的产生$G$个奖励分值为$r = {R_{1}, R_{2}, \dots, R_{G}}$
-
用 group 内标准化估计 Advantage:$A_{i,t} = R_{i} = \frac{R_{\phi}(r_{i}) - \text{mean}(R)}{\text{std}(R)}$
下面是 GRPO 的具体流程,对比图PPO 的流程,二者的主要区别在于 advantage 的计算。
简单手撕
Initialize policy πθ

for iteration in range(K):
    samples = collect_responses(πθ_old)
    rewards = reward_model(samples)
    for each prompt group g:
        r_g = rewards[g]
        A_g = (r_g - mean(r_g)) / std(r_g)   # normalize within each group

    for epoch in range(update_epochs):
        for batch in sample_minibatches(samples):
            r_t = πθ(a_t|s_t) / πθ_old(a_t|s_t)

            L_clip = min(
                r_t * A_t,
                clip(r_t, 1 - ε, 1 + ε) * A_t
            )

            loss = -E[L_clip + c2 * entropy(πθ)]

            update θ by gradient descent

    θ_old ← θ
DAPO
DAPO 的出发点非常直接:在实际训练中,GRPO 往往因 clip 范围设置不合理、采样冗余以及长序列梯度被稀释等问题,导致大量训练信号被浪费。针对这些问题,DAPO 逐一提出改进,形成了四个核心优化点。 $$ \begin{aligned} \mathcal{J}{\text{DAPO}}(\theta) = ; & \mathbb{E}{\substack{(q,a) \sim P(Q) \ {o_i}{i=1}^G \sim \pi{\theta_{\text{old}}}(O \mid q)}} \left[ \frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \right. \ & \left. \min\left(r_{i,t}(\theta)A_i, \operatorname{clip}(r_{i,t}(\theta), 1 - \epsilon_{\text{low}}, 1 + \epsilon_{\text{high}})A_i\right) \right] \ & \text{s.t.,} \quad 0 < \left| {o_i \mid \text{is_equivalent}(a, o_i)} \right| < G \end{aligned} $$
为什么 DAPO 提高了 $ 1 + \epsilon_{high}$ 的上界?
作者发现,如果 clip 的上界$\epsilon$设置过小,会出现这样的问题:当 old policy 对某个 token 的概率很低,而该 token 的 advantage 又是正值(即 old model 恰好采样得非常好),此时当前 policy model 的上涨空间就会受到很大限制,而上涨恰恰是我们希望发生的。
举例来说,如果 old policy 的概率是 0.9, $\epsilon = 0.2$,clip 上界为$0.9 \times 1.2 = 1.08$ ,已超过概率的最大值 1.0,这种情况是绝对不会被 clip 的;但如果 old policy 的概率是 0.2,clip 上界仅为 0.24,即便当前模型将其概率提升到 0.4(一个不是非常激进且恰到好处的改进),也会因$\epsilon$过小而被 clip,导致该 token 的训练信号被废弃。为了解决这一问题,DAPO 引入 Clip-Higher,提高上界以提升 token 利用效率。
这类似于“马太效应”——富人越来越富,穷人很难翻身。如果 old policy 难得采到一个关键 token(例如 「Wait」)且概率极低,而当前模型对此 token 的概率提升显著,却因为 clip 限制过紧被抹掉,那么模型几乎没有翻盘的机会。
Clip-Higher 解决了“好 token 涨幅受限”的问题,但并未触及另一个浪费来源——采样多样性不足。为此,DAPO 引入了 动态采样。
DAPO - 动态采样
DAPO 的第二个创新是 动态采样(Dynamic Sampling)。这项技术的背景是:假如一个 query 我们 sample 了 10 次,这 10 次每次都答得很好/或者很差,都取得了 max reward / zero reward,这个时候由于 GRPO 的计算方法,导致这 10 次采样的 advantage 都是 0,所以这些采样所带来的 gradient 就也都是 0;这样做的一个后果就是,实际的有梯度的 sample 要远低于没有梯度 sample 数,导致最后梯度汇集的时候没有收集到足够的信息,从而形成高方差、不稳定的训练,以及 sample 的浪费。需要注意的是,这种现象是在训练初期;以及后期随着训练的进行在不断加强的,因为刚开始时模型效果很差,而训练越到后边模型效果越好,给出满分回答的几率就越大。因此,DAPO 在采集样本时,额外做了一件事:保证每次采样出来的回答,reward 不全是 0 或者 1,如果采样出来的回答全是 0 或者 1 就继续采样,直到不满足为止。这也是损失函数中$\text{s.t.,} \quad 0 < \left| {o_i \mid \text{is_equivalent}(a, o_i)} \right| < G$的来源,它保证同一输入下的采样集合中既包含正确回答,也包含错误回答。
除了多样性问题,GRPO 在长回答训练中还有一个隐性缺陷——token 梯度权重随回答长度增加而被稀释。DAPO 的第三个改进正是 Token-Level Gradient Loss。
DAPO - Token-Level Gradient Loss
DAPO 第三个方面的创新是为了解决 GRPO 在训练长回答时 gradient 的权重会随着采样回答的长度变长而下降的问题。首先解释为什么采样长度变长权重会下降。假设采样了 2 次,有一次回答一共有 200 个 token,而另一次回答有 10 个 token。那么根据 GRPO 的计算公式,每次回答的梯度先在 sample 内求平均,再在 batch 内求平均。第一次回答每个 token 的权重是$(1/200) * (1/2)$,而第二个回答每个 token 的权重是$(1/10) * (1/2)$,所以第二次回答的 token 的影响要明显高于第一次回答。再来说采样长度变长权重下降的危害:对于一些比较难的问题,长回答本身就很正常,如果这些回答本身非常好,那么由于长度平均就会导致本来非常有用的梯度信号被稀释;假如回答是不好的,长度长仅仅也是因为重复单词,或者回答冗余词太多,长度归一就导致这次采样本该带来的纠正信号没法正确传递到 policy model 上。总结来说就是:
这会带来两个问题:
- 长高质量回答的有用信号被稀释;
- 长低质量回答的纠正信号也被稀释(长只是因为冗余或重复)。
所以 DAPO 采用的方法是:把一次梯度计算时所有采样生成的 token 总数加起来求平均,回到上边这个例子,第一次采样和第二次采样每个 token 的权重都是 $(1/200) * (1/2)$,即对不同回答中的 token 一视同仁。这样就能改善 GRPO 在长样本训练中的效率低下的问题。这对应着损失函数中的改变,公式上,对于 loss 的 aggregation 方式由原来 GRPO 的$\frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|}$改为$\frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|}$实验证明,token-level loss 不仅训练更稳定,还能有效控制 entropy:过高会导致策略趋于随机,过低则探索不足(Clip-Higher 可缓解该问题)。通过将 sample-level loss 改为 token-level loss,DAPO 让长回答能够按比例影响最终梯度,每个 token 的损失都直接参与整体更新。
最后一个改进同样与回答长度相关,但关注点不同——它处理的是过长回答对整体奖励的负面影响。
DAPO - Overlong Reward Shaping
DAPO 的第四个改进是在奖励设计中引入 软惩罚机制(Soft Punishment)来处理过长回答。具体来说,当生成长度超过第一个预设阈值时,惩罚会随长度线性增加;一旦超过第二个阈值,惩罚将抵消因回答正确获得的所有奖励,相当于将该回答视为无效。这种惩罚是按 token 作用在 reward(即 advantage)上的。
综上,DAPO 在 Clip-Higher、动态采样、Token-Level Gradient Loss 和 Overlong Reward Shaping 四个方面,对 GRPO 进行了精细化改造,显著提升了训练的效率与稳定性。不过在某些特定架构(尤其是 MoE)下,GRPO 的结构性问题依然存在,这就引出了下一节的 GSPO。
GSPO
如果说 DAPO 是在 GRPO 框架内做“微调与优化”,那么 GSPO 则是直接调整了优化目标的颗粒度——从 token-level 跳到 sequence-level。这一变化的动机,主要源于在 MoE 架构训练时,GRPO 的重要性采样会引入巨大方差和不稳定性。GSPO 的核心思想是:优化奖励时不再依赖逐个 token 的比值,而是关注整个生成序列的表现,从而降低噪声并提升稳定性。
Importance ratio 到底在起什么作用?在 GRPO 里会带来什么问题?
重要性采样存在的意义在于:我们想要估计一个预期的分布,但是我们手上只有另一个 behavior 分布,我们就只能在 behavior policy 下进行采样,通过这个样本,赋予这个重要性权重,来估计出 target policy 下函数的值。但是这种采样的前提在于多次采样,如果只有一次采样,并不能起到分布矫正的作用。问题在于大模型训练过程中,重要性采样都是 per-token 进行的,单个 token 进行的重要性采样是无法起到分布矫正的作用的,相反,这种采样手段反而会带来很大方差的噪声,尤其是在 MoE 这种不稳定的结构下。所以 GRPO 本身这种逐 token 的计算可能不太合理。
Per-token 采样和奖励回复的不匹配:我们的奖励其实是对每个回答整体给出的评价,但是在 per-token 的操作中,我们又把这个奖励平摊到每个 token 上(reward shaping),然后试图在 token 层面逐个做调整,所以这里就发生了一个优化的目标和奖励目标的颗粒度的差异。所以既然我们有了 sequence-level 的 reward,我们能不能也把 GRPO 的优化过程改成 sequence-level 的。
GRPO 在 MoE 结构上为什么难以收敛?(GRPO 的局限性)
专家激活波动性是关键问题。因为新旧策略可能激活不同的专家,带来结构性偏差,引起噪声。当更新时${\pi_{{\theta}_{old}}}$,很有可能 Router 也发生了变化,导致新旧策略激活了不同的专家。虽然模型参数只更新了一步,但实际参与计算的专家组合完全不同,导致非常大的输出概率的波动,导致 clipping 被异常地、频繁地触发。Clip 过后的 token 往往就没有梯度,而最终留下来的 token 往往是有噪音的。所以这两个概率根本不是在相同结构下产生的,理想中的重要性比率应该反应模型在同一结构下参数变化导致的输出概率变化,但这个比率现在由于专家变化,导致高方差的波动,不可预测,与优化方向无关的噪声。这种高方差会导致梯度估计严重失真,训练不稳定甚至崩溃。
GSPO 之前的做法:Routing Replay
Routing Replay 会记录 ${\pi_{{\theta}{old}}}$ 推理时的路由激活,并在训练时强制 ${\pi{\theta}}$ 使用相同激活路径。这虽能保证一致性,但对 AI infra 带来非常大的开发工作量和开销;同时对于${\pi_{\theta}}$ ,有可能已经有了更好的 routing path,但是现在却一定要走 的 routing path,导致 training 不是很高效。传统方法会尝试通过 Routing Replay 来缓解专家激活的不一致,但这会带来工程复杂性与效率损失。GSPO 则选择直接规避这一依赖,从根本上降低了训练过程中的结构性方差。
GSPO 的损失函数设计
$$ \mathcal{J}{\text{GSPO}}(\theta) = \mathbb{E}{x \sim \mathcal{D}, {y_i}{i=1}^G \sim \pi{\theta_{\text{old}}}(\cdot \mid x)} \left[ \frac{1}{G} \sum_{i=1}^G \min \left( \left( \frac{\pi_{\theta}(y_i \mid x)}{\pi_{\theta_{\text{old}}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}} \hat{A}i, \text{clip}\left(\left( \frac{\pi{\theta}(y_i \mid x)}{\pi_{\theta_{\text{old}}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}}, 1-\epsilon, 1+\epsilon\right) \hat{A}_i \right) \right] $$
$$ s_i(\theta) = \left( \frac{\pi_{\theta}(y_i \mid x)}{\pi_{\theta_{\text{old}}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}} = \exp \left( \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \log \frac{\pi_{\theta}(y_{i,t} \mid x, y_{i,<t})}{\pi_{\theta_{\text{old}}}(y_{i,t} \mid x, y_{i,<t})} \right). $$
GSPO 的算法希望抛弃掉 GRPO 的 token-level objective,而是把 importance rate 直接用在 sequence-level 上,这也就自然得引入了 GSPO 的优化算法目标,即把 token-level 的 importance rate 换成了 sequence-level 的 importance rate。这里对 sequence-level 的重要性做了长度归一化,这里主要是为了减少方差和统一数值范围。如果不做长度归一化,不同的问题可能回答长度是不一样的,因此 importance rate 可能会对长度很敏感。这里,由于所有属于同一采样的 token 用到的 importance ratio 都是一样的,所以一旦 clipping 发生,所 clip 掉的将是整个采样到的 sequence,而不是一次采样中的某些 token。长度归一化 $\frac{1}{|y_i|}$ 避免长句子几个 token 波动就导致 ratio 爆炸。
GSPO 与 GRPO 在梯度上的理论分析
从优化目标的定义出发,GSPO 与 GRPO 的主要区别在于重要性比值的定义及其在梯度计算中的作用。
如果忽略掉 clip 机制,那么二者梯度本质上的区别在于,是否要对一个回复里边的不同 token,他们的梯度做加权平均。GRPO 是会对一个回复里边的不同 token 根据他们各自的重要性权重做加权,但是 GSPO 对一整个句子做相同 importance ratio 的放缩。具体而言,GSPO 的梯度为: $$ \nabla_\theta J_{\text{GSPO}}(\theta) = \mathbb{E} \left[ \frac{1}{G} \sum_{i=1}^G s_i(\theta) A_i \cdot \frac{1}{|o_i|} \sum_{t=1}^{|o_i|} \nabla_\theta \log \pi_{\theta}(o_{i,t} \mid q, o_{i,<t}) \right]. $$ 可以看出,GSPO 对同一条回复中的所有 token 赋予相同的权重 $s_i(\theta) A_i / |o_i|$ ,从而保证了序列内部梯度权重的一致性。相比之下,GRPO 的梯度为: $$ \nabla_\theta J_{\text{GRPO}}(\theta) = \mathbb{E} \left[ \frac{1}{G} \sum_{i=1}^{G} \frac{\hat{A}i}{|o_i|} \sum{t=1}^{|o_i|} r_{i,t}(\theta) \nabla_\theta \log \pi_{\theta}(o_{i,t} \mid q, o_{i,<t}) \right]. $$ 可以看出,GRPO 在同一条回复的不同 token 上采用不同的权重 $r_{i,t}(\theta)\frac{\hat{A}_i}{|o_i|}$ ,这些权重会随 token 位置和上下文变化而波动,且可能出现较大方差,尤其在长序列或 MoE 模型中更为严重。
另外一个区别在于 GRPO 原本的重要性采样权重对 clip 范围的影响。对于大于零的 advantage 的样本,GRPO 允许的范围是零到一点几,但是对于 advantage 小于 0 的样本,clip 的数值范围是零点几到正无穷,这是个很大的波动范围。当序列变长的时候,这个时候所携带的噪声是会不断积累的。这也是 MoE 模型在用 GRPO 训练时候崩溃的原因之一。而 Reward 监控指标对于模型学偏这件事情是有一定滞后性的,就是模型学偏了一段时间以后,指标上才会有反馈。从实验结果上来看,GSPO 实际用于训练的 token 比 GRPO 少很多(由于 clipping),但同时达到了更高的训练效率。