
🎬 VideoSync - 一键式 AI 视频多语言配音工具。集成 WhisperX (ASR)、Qwen (翻译)、Inde-tts2 (语音克隆) 和 FFmpeg,为 Windows 用户提供开箱即用的本地化视频配音解决方案
Python
164
47 commits
updated May 5, 2026
README
🎬 VideoSync - AI Video Localization Tool
VideoSync 是一个运行在 Windows 和 Linux 上的全自动 AI 视频配音工具。它将业界最强的开源模型整合为一个工作流,旨在实现“一键式”视频语言本地化。
不需要联网 API,不需要高昂的订阅费,利用你的本地显卡即可完成:ASR 识别 -> 文本翻译 -> 语音克隆 -> 音画对齐。
现在已经推出线上免环境配置版本,安装即跑,支持批量并发,https://norgateai.com 欢迎尝试
✨ 核心特性 | Features
-
🎯 精准识别 (ASR)
- 底层集成 WhisperX,支持强制对齐(Forced Alignment)和 VAD(语音活动检测)。
- 彻底解决传统 Whisper 的“幻觉”和“吃字”问题,时间轴精准到毫秒级。
-
🗣️ 零样本语音克隆 (Voice Cloning)
- 内置 MaskGCT (IndexTTS) 模型,无需任何微调训练。
- 直接提取视频原声作为参考,瞬间克隆角色声线。
- 完美复刻语调、情感和说话节奏。
-
🚀 翻译(Translation)
- 内嵌 Qwen 2.5-7B-Instruct(通义千问)大模型。
- 目前完美支持 中文 <-> 英文 互译。
- 具备上下文理解能力,翻译结果自然流畅,像字幕组一样专业。
-
⚡ 极致性能优化
- 独创的分步显存管理策略:翻译时释放 TTS 显存,TTS 时释放 LLM 显存。
- 在消费级显卡(如 RTX 3060)上也能流畅运行全流程。
-
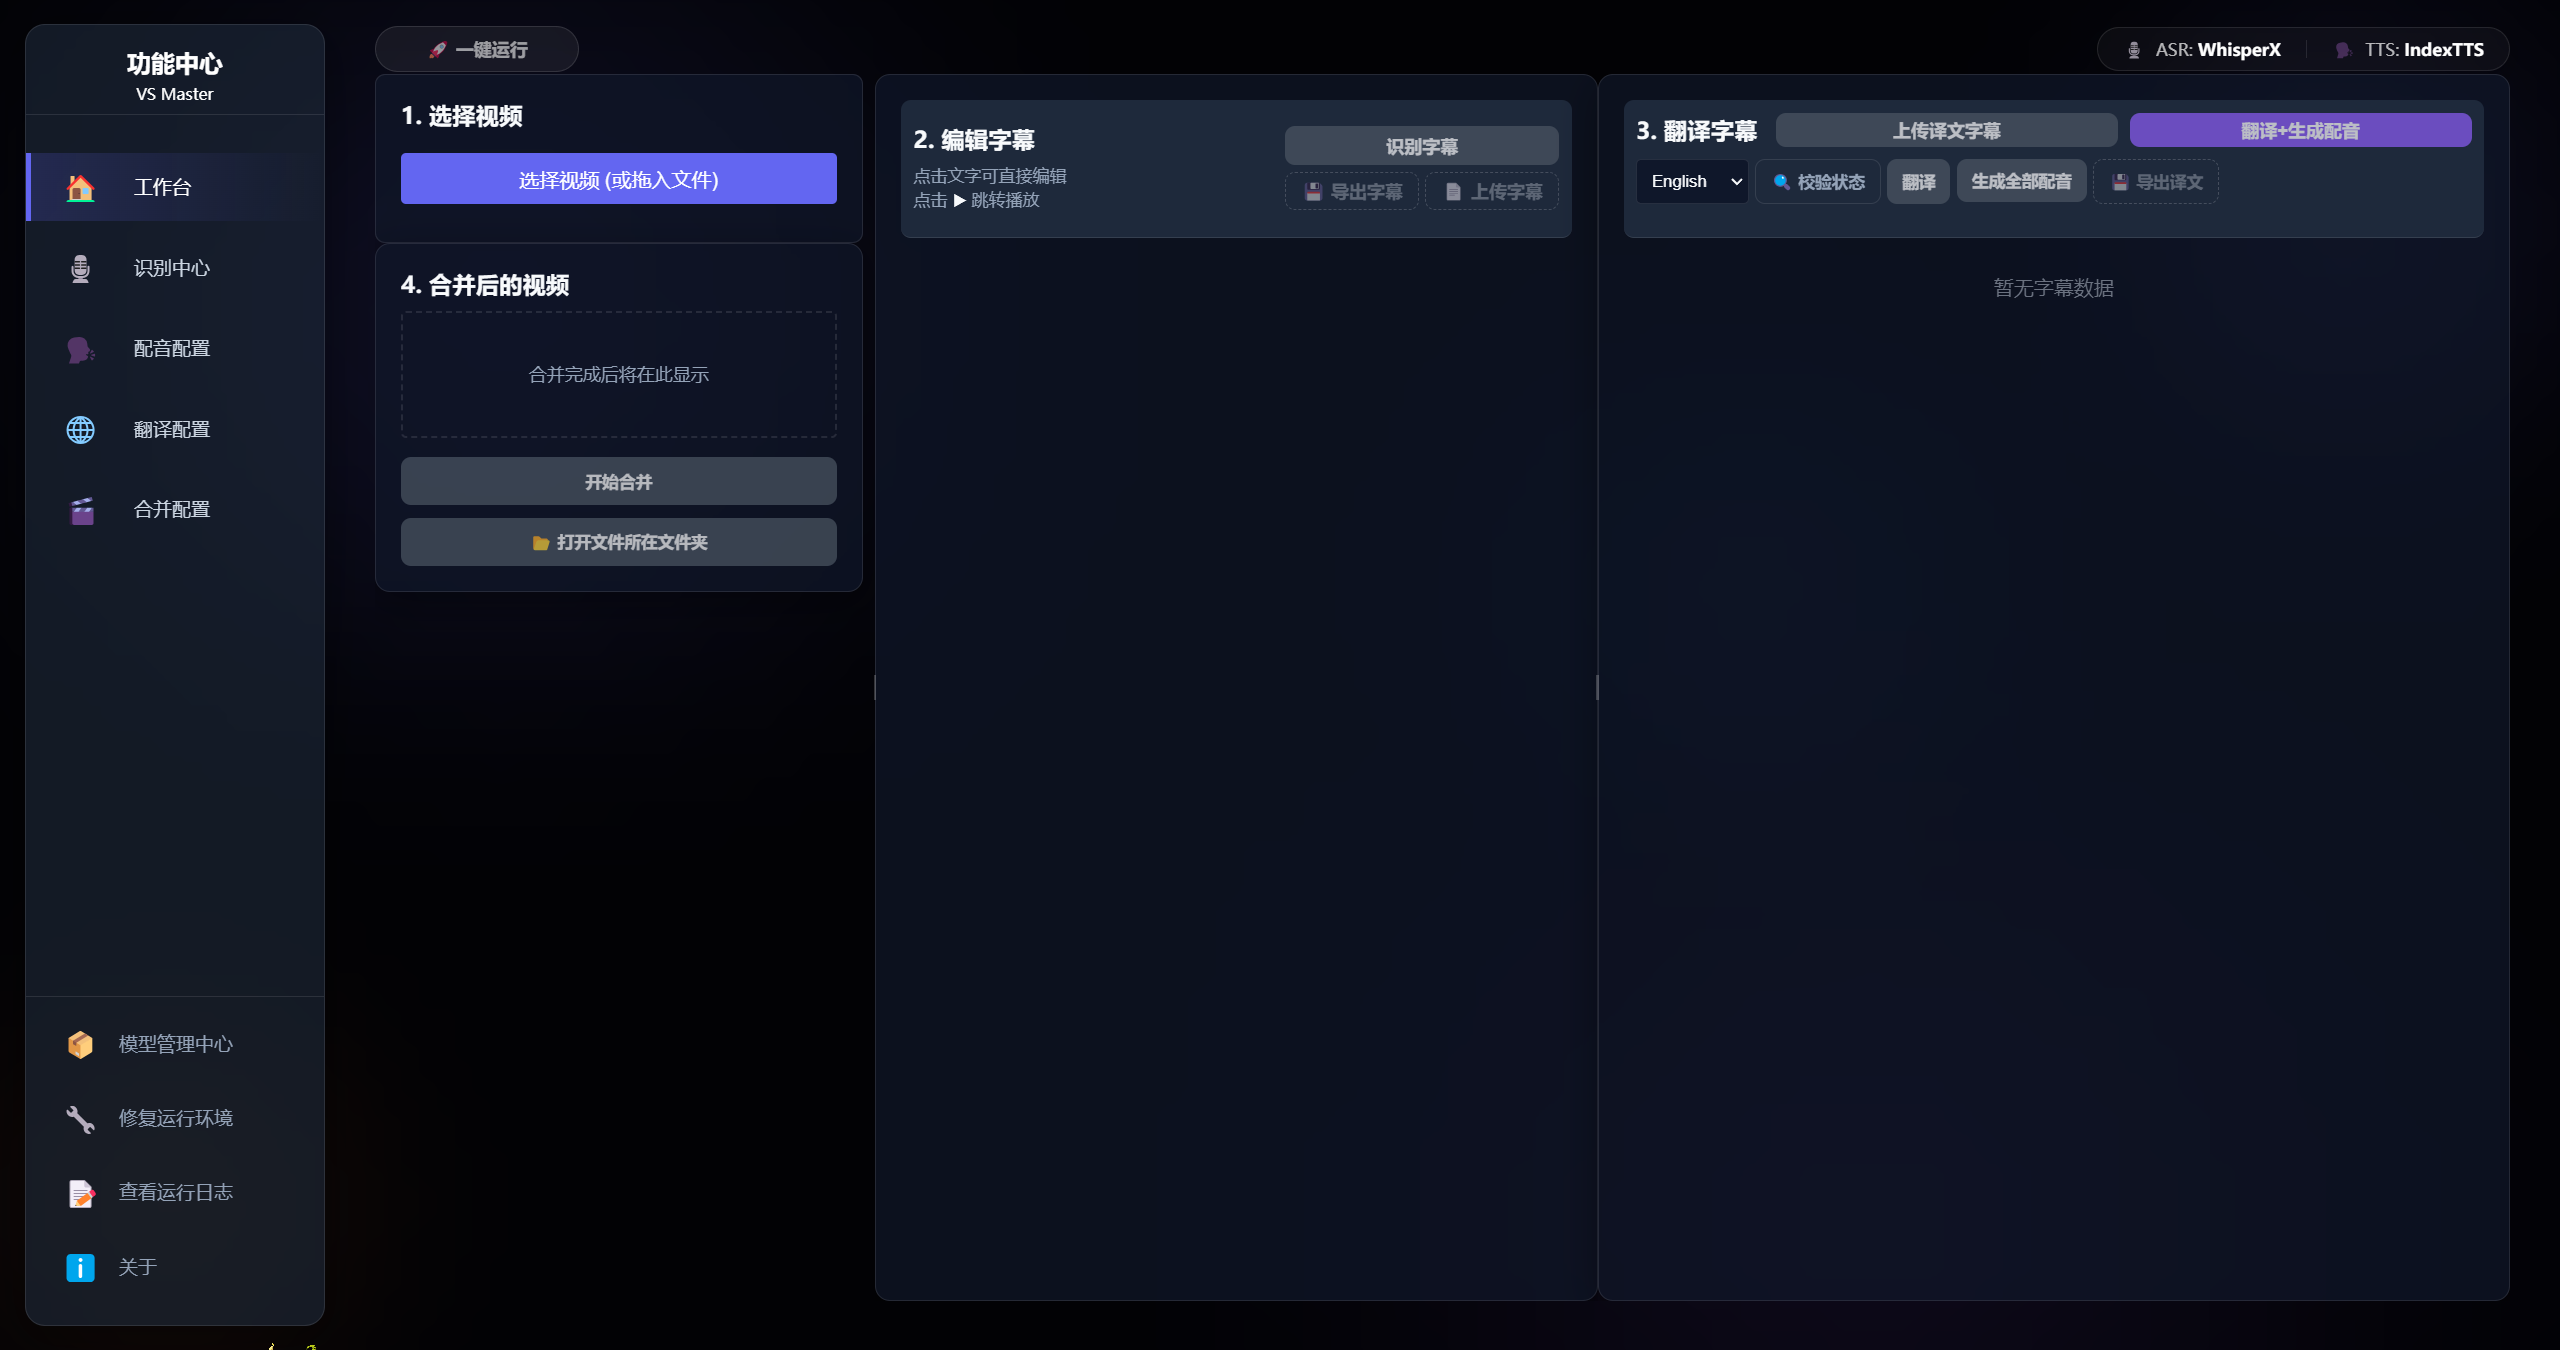
🖥️ 现代化 UI
- 基于 Electron + React 构建的精美界面。
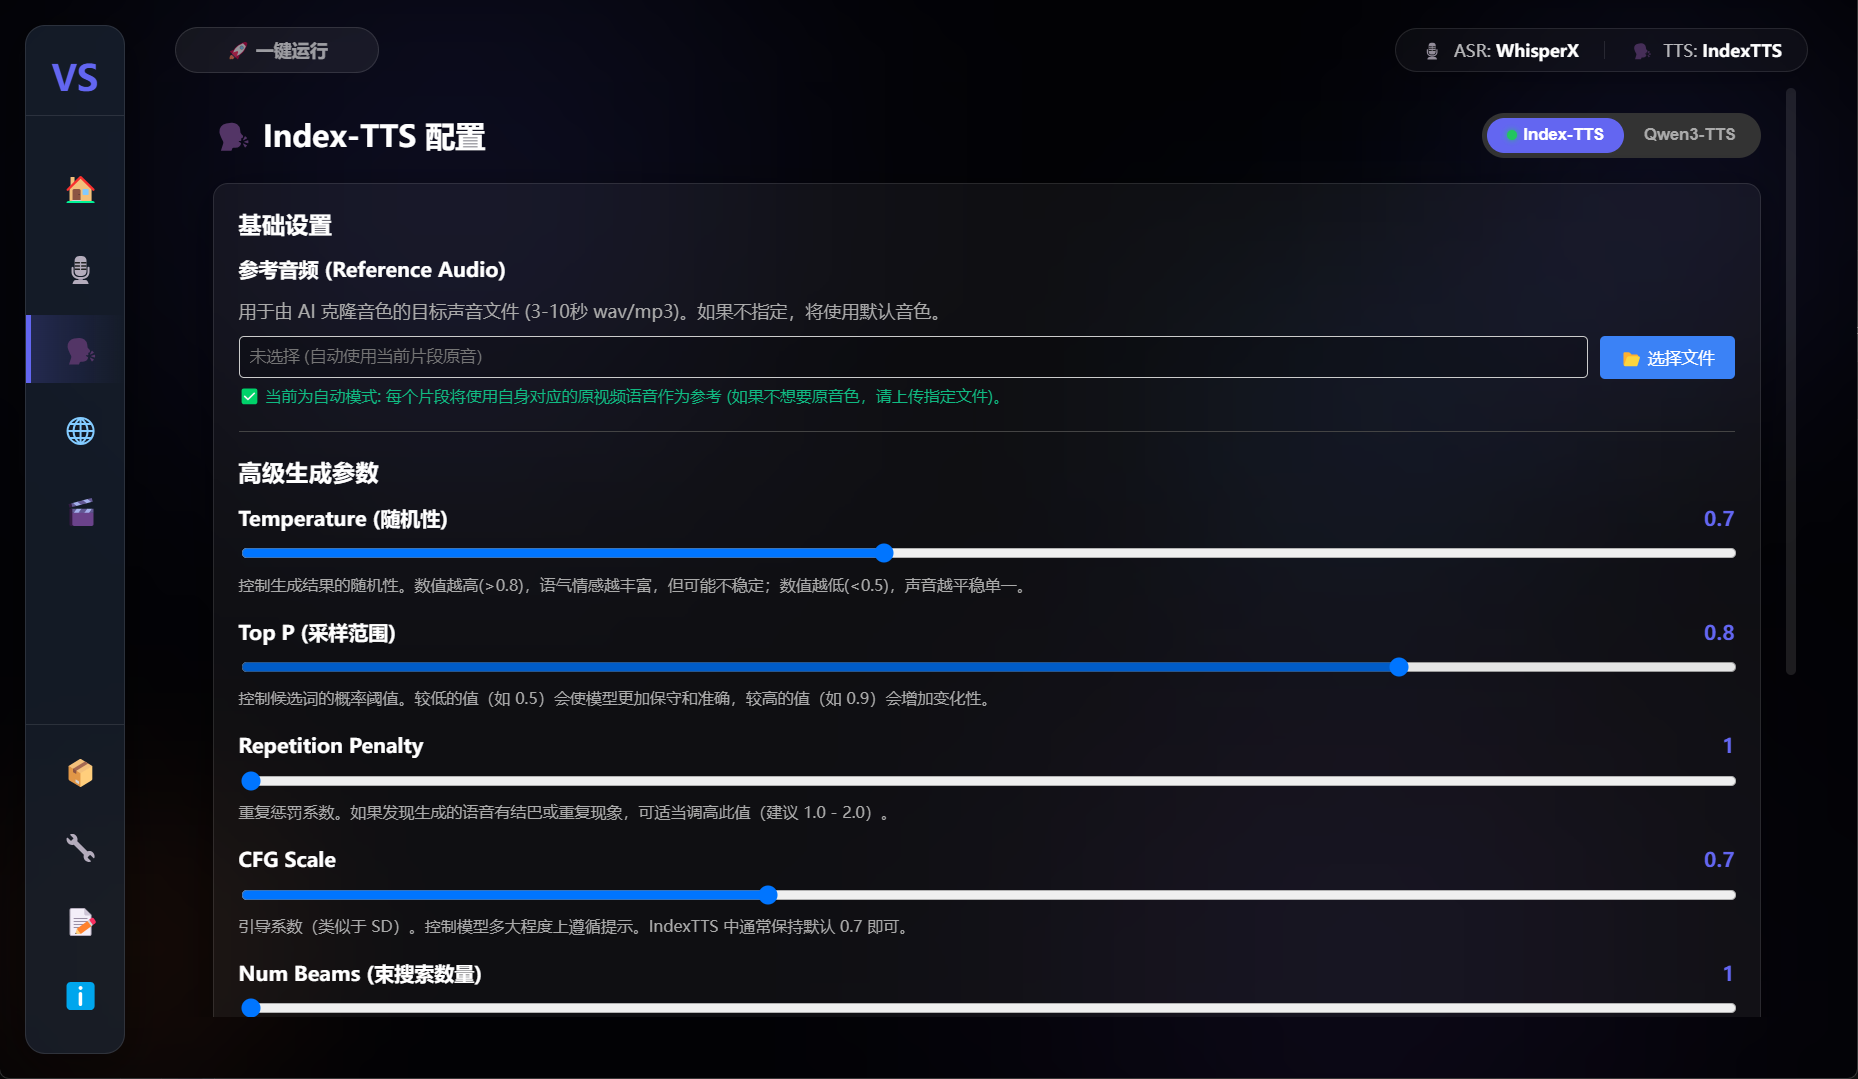
- 实时日志监控、字幕可视化编辑、视频实时预览。
界面预览 | Screenshots
| 主界面 |
|---|
 |
| 字幕编辑 |
 |
🛠️ 环境要求 | Requirements
为了保证流畅运行,建议您的硬件配置如下:
- 操作系统: Windows 10/11 (x64) 或 Linux (源码运行)
- 显卡 (GPU): NVIDIA GeForce RTX 3060 或更高 (显存 ≥ 8GB)
- 驱动: NVIDIA Studio/Game Ready Driver
- 运行库: Python 3.10+, Node.js 16+ (仅源码运行需要)
🚀 快速开始 | Quick Start
1. 克隆仓库
git clone https://github.com/TianDongL/VideoSyncMaster.git
cd VideoSyncMaster
2. 后端配置 (Backend Setup)
我们强烈建议使用 Conda 来管理环境,避免依赖冲突。
# 创建并激活环境
conda create -n videosync python=3.11
conda activate videosync

# 安装核心依赖
pip install -r requirements.txt

# 安装 PyTorch (建议根据您的 CUDA 版本去 pytorch.org 获取安装命令)

pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
3. 前端配置 (Frontend Setup)
cd ui
npm install
4. 模型准备 (Download Models)
由于模型体积巨大,请下载以下模型并按目录结构放置:
模型下载地址: 可以从 HuggingFace 或 ModelScope 下载。
VideoSync/
  ├── models/
  │   ├── faster-whisper-large-v3-turbo-ct2/  # ASR 模型
  │   ├── index-tts/                          # MaskGCT / TTS 模型相关文件
  │   │   ├── config.yaml
  │   │   ├── gpt.pth ...
  │   └── Qwen2.5-7B-Instruct/                # LLM 翻译模型
🚀 使用指南 | Usage
方式一:源码运行 (开发者推荐)
适合 Linux 用户或进行二次开发。
-
启动应用: 在项目根目录运行以下命令,UI 界面启动后会自动拉起后台 Python 进程:
npm run dev注意: 请确保您已在
backend/目录下正确配置了 Python 环境,否则 UI 会因为找不到后台服务而报错。 -
(可选) 单独测试后端: 如果您需要调试后端 Python 代码,可以运行:
python backend/main.py --help
方式二:构建安装包 (Windows)
如果您想生成 .exe 安装程序分享给朋友:
# 在项目根目录
npm run build
生成的安装包将位于 ui/release/ 目录下。
🤝 贡献与致谢 | Acknowledgements
本项目站在巨人的肩膀上,特别感谢以下开源项目的贡献:
如果你喜欢这个项目,欢迎点一个 Star 🌟! 欢迎提交 Pull Request 或 Issue 来帮助改进 VideoSync。
📜 许可证 | License
- ✅ 非商业用途: 您可以自由复制、修改和分发代码,但仅限非商业目的。
- ❌ 禁止商用: 未经作者授权,禁止将本项目或其衍生品用于任何形式的商业盈利活动。
- 🔄 相同方式共享: 如果您修改了代码,您必须使用相同的协议开源您的修改。
© 2024 VideoSync Team
Similar repos


Languages
Python
87.4%
TypeScript
10.4%
🎬 VideoSync - 一键式 AI 视频多语言配音工具。集成 WhisperX (ASR)、Qwen (翻译)、Inde-tts2 (语音克隆) 和 FFmpeg,为 Windows 用户提供开箱即用的本地化视频配音解决方案
Python
164
47 commits
updated May 5, 2026
README
🎬 VideoSync - AI Video Localization Tool
VideoSync 是一个运行在 Windows 和 Linux 上的全自动 AI 视频配音工具。它将业界最强的开源模型整合为一个工作流,旨在实现“一键式”视频语言本地化。
不需要联网 API,不需要高昂的订阅费,利用你的本地显卡即可完成:ASR 识别 -> 文本翻译 -> 语音克隆 -> 音画对齐。
现在已经推出线上免环境配置版本,安装即跑,支持批量并发,https://norgateai.com 欢迎尝试
✨ 核心特性 | Features
-
🎯 精准识别 (ASR)
- 底层集成 WhisperX,支持强制对齐(Forced Alignment)和 VAD(语音活动检测)。
- 彻底解决传统 Whisper 的“幻觉”和“吃字”问题,时间轴精准到毫秒级。
-
🗣️ 零样本语音克隆 (Voice Cloning)
- 内置 MaskGCT (IndexTTS) 模型,无需任何微调训练。
- 直接提取视频原声作为参考,瞬间克隆角色声线。
- 完美复刻语调、情感和说话节奏。
-
🚀 翻译(Translation)
- 内嵌 Qwen 2.5-7B-Instruct(通义千问)大模型。
- 目前完美支持 中文 <-> 英文 互译。
- 具备上下文理解能力,翻译结果自然流畅,像字幕组一样专业。
-
⚡ 极致性能优化
- 独创的分步显存管理策略:翻译时释放 TTS 显存,TTS 时释放 LLM 显存。
- 在消费级显卡(如 RTX 3060)上也能流畅运行全流程。
-
🖥️ 现代化 UI
- 基于 Electron + React 构建的精美界面。
- 实时日志监控、字幕可视化编辑、视频实时预览。
界面预览 | Screenshots
| 主界面 |
|---|
|
| 字幕编辑 |
|
🛠️ 环境要求 | Requirements
为了保证流畅运行,建议您的硬件配置如下:
- 操作系统: Windows 10/11 (x64) 或 Linux (源码运行)
- 显卡 (GPU): NVIDIA GeForce RTX 3060 或更高 (显存 ≥ 8GB)
- 驱动: NVIDIA Studio/Game Ready Driver
- 运行库: Python 3.10+, Node.js 16+ (仅源码运行需要)
🚀 快速开始 | Quick Start
1. 克隆仓库
git clone https://github.com/TianDongL/VideoSyncMaster.git
cd VideoSyncMaster
2. 后端配置 (Backend Setup)
我们强烈建议使用 Conda 来管理环境,避免依赖冲突。
# 创建并激活环境
conda create -n videosync python=3.11
conda activate videosync

# 安装核心依赖
pip install -r requirements.txt

# 安装 PyTorch (建议根据您的 CUDA 版本去 pytorch.org 获取安装命令)

pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
3. 前端配置 (Frontend Setup)
cd ui
npm install
4. 模型准备 (Download Models)
由于模型体积巨大,请下载以下模型并按目录结构放置:
模型下载地址: 可以从 HuggingFace 或 ModelScope 下载。
VideoSync/
  ├── models/
  │   ├── faster-whisper-large-v3-turbo-ct2/  # ASR 模型
  │   ├── index-tts/                          # MaskGCT / TTS 模型相关文件
  │   │   ├── config.yaml
  │   │   ├── gpt.pth ...
  │   └── Qwen2.5-7B-Instruct/                # LLM 翻译模型
🚀 使用指南 | Usage
方式一:源码运行 (开发者推荐)
适合 Linux 用户或进行二次开发。
-
启动应用: 在项目根目录运行以下命令,UI 界面启动后会自动拉起后台 Python 进程:
npm run dev注意: 请确保您已在
backend/目录下正确配置了 Python 环境,否则 UI 会因为找不到后台服务而报错。 -
(可选) 单独测试后端: 如果您需要调试后端 Python 代码,可以运行:
python backend/main.py --help
方式二:构建安装包 (Windows)
如果您想生成 .exe 安装程序分享给朋友:
# 在项目根目录
npm run build
生成的安装包将位于 ui/release/ 目录下。
🤝 贡献与致谢 | Acknowledgements
本项目站在巨人的肩膀上,特别感谢以下开源项目的贡献:
如果你喜欢这个项目,欢迎点一个 Star 🌟! 欢迎提交 Pull Request 或 Issue 来帮助改进 VideoSync。
📜 许可证 | License
- ✅ 非商业用途: 您可以自由复制、修改和分发代码,但仅限非商业目的。
- ❌ 禁止商用: 未经作者授权,禁止将本项目或其衍生品用于任何形式的商业盈利活动。
- 🔄 相同方式共享: 如果您修改了代码,您必须使用相同的协议开源您的修改。
© 2024 VideoSync Team
Similar repos
Languages
Python
87.4%
TypeScript
10.4%