目前大多数针对大模型评测集中在两方面,一个是传统的NLU任务(语义理解,情感分析等)或者传统的NLP指标,另一个是更加与人类对齐的大规模权威性考试,然而实际生活中,我们更加关注模型在中文领域的实用性,即中文领域的大模型是否具有帮助人类解决具体任务的能力,为此,我们设计了中文领域大模型评测,构建了一个能够衡量「模型是否好用」的评测数据集。
我们在评测过程中更加关注模型在中文领域的实用性,具体分为三个部分:
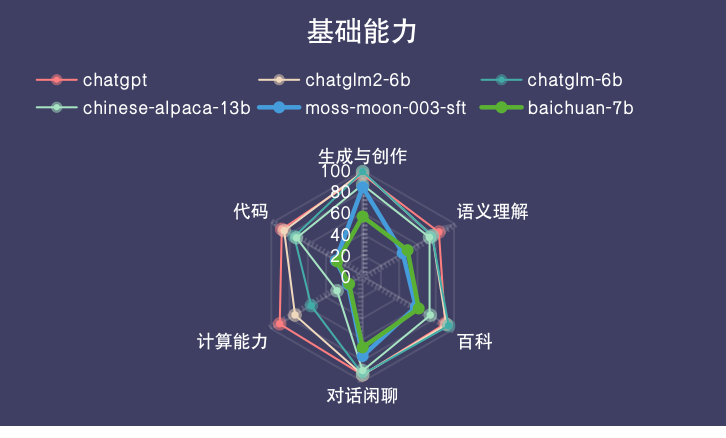
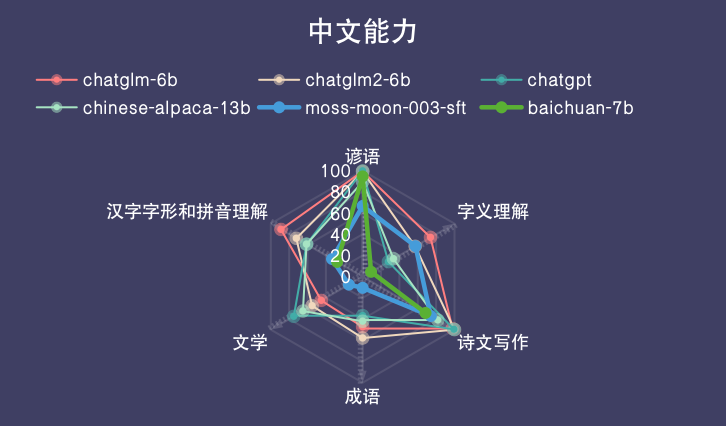
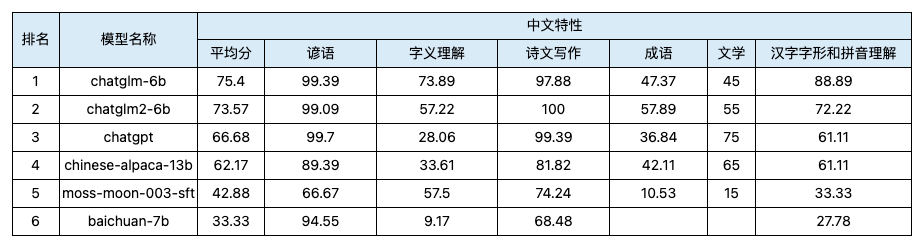
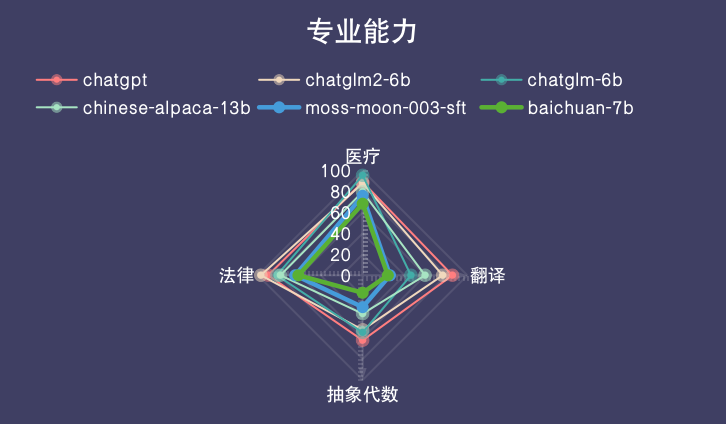
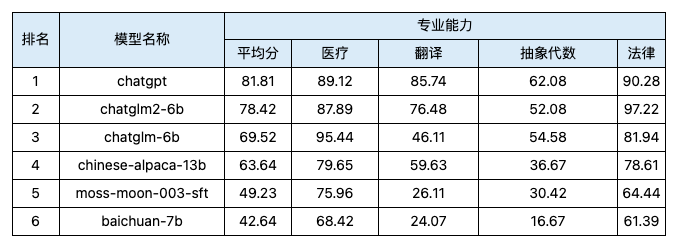
所以我们将关注的模型能力划定为基础能力、中文特性、专业能力三大一级分类,并在每个一级分类下设置了更多的二级小分类,以此为标准建立了我们的评测数据集。
更多数据集的详细信息请点击特赛发LLM评测第一期数据集概要
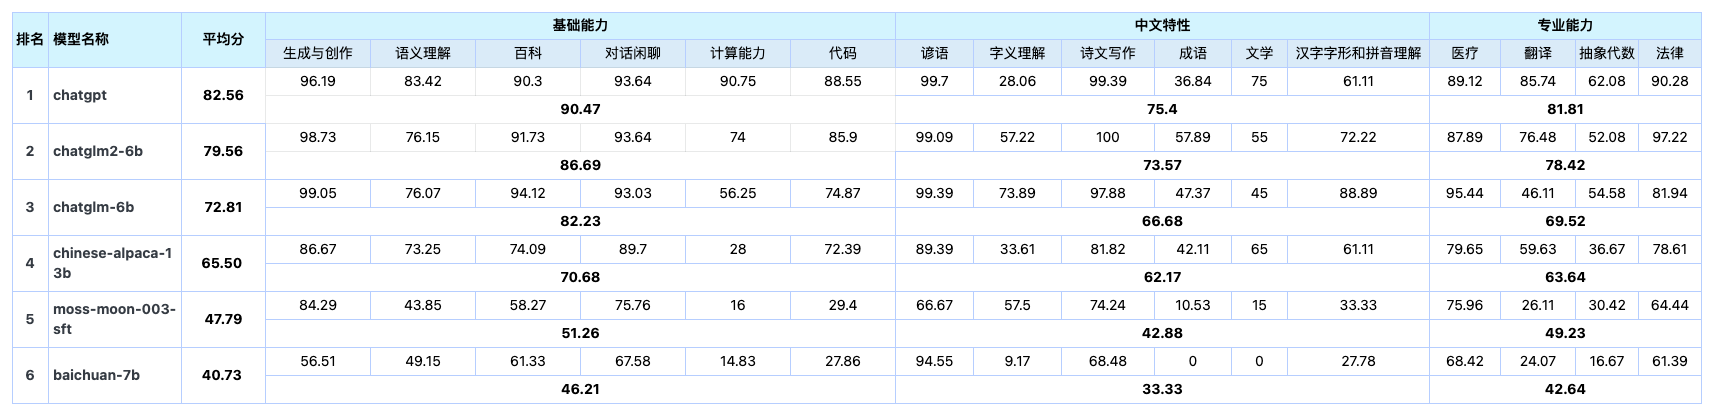
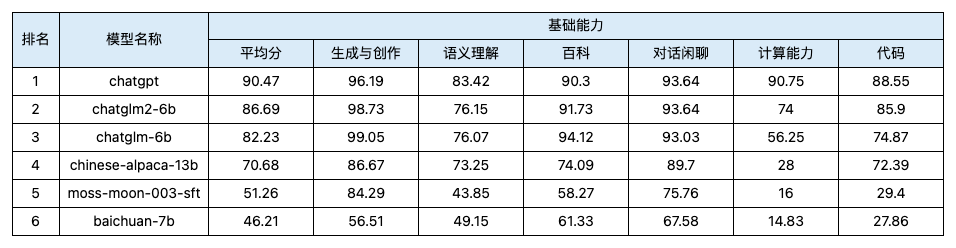
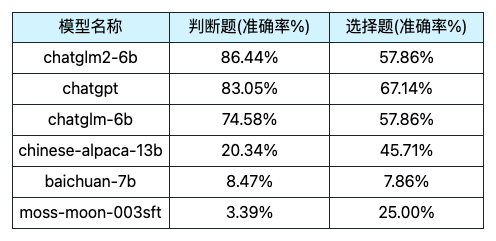
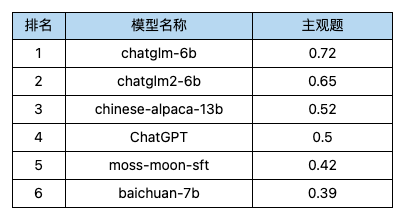
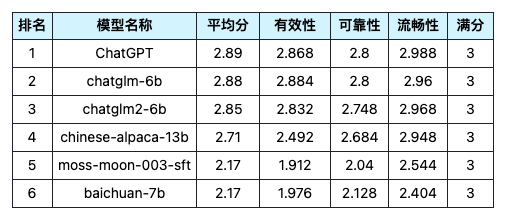
由于时间关系,第一期测评主要评测了5个比较有代表性的中文领域大模型,同时加入了ChatGPT同分支的text-davinci-003(图称ChatGPT)作为比较,采用的方式是客观题使用准确率,主观题的开放性问答采用大模型当评测员的方法。
我们的测评目前仍有许多不足,但会在之后做一些持续工作来不断完善和优化评测的体系和结果的展现,包括但不限于:
主要结果如下,详细结果请参考特赛发LLM第一轮评测结果
当前repo主要包括以下几个部分
参考了Gaokao等benchmark的构建方法,将评测问题的指令类别大致分为判断题、选择题、开放问答题和推理题四种类型,根据类别适配不同的指令,并经过线下实验调优,选择输出结果较好的指令进行测评结果的输出。
详情参考src/prompt。
目前支持llama|moss|glm|baichuan|gptq系模型的推理,推理基于HF框架,也可以支持fastllm框架(针对chatglm系列),后续会兼容更多高效推理框架。
python llm_inference.py --model_name chatglm /
 --model_path your_model_path /
 --model_type [llama|moss|glm|baichuan|gptq] /
 --data_path your_data_path /
 --device 0  /
 --temperature 0 --top_p 1 --top_k 100 --rep_penalty 1.1 /
 --use_fastllm (optional for chatglm only)
我们让ChatGPT从三个维度来评价主观题的答案:有效性、可靠性、流畅性。 参考了Sunweiwei等人的工作RankGPT以及复旦大学的模型评测工作llm-eval,我们最终选择了以下两种大模型评测方式:RankingGPT 和 ScoringGPT。
scr/eval_agent,使用示例见auto-eval-with-chatgpt-examples.ipynb。metrics_calculation.ipynb目前大多数针对大模型评测集中在两方面,一个是传统的NLU任务(语义理解,情感分析等)或者传统的NLP指标,另一个是更加与人类对齐的大规模权威性考试,然而实际生活中,我们更加关注模型在中文领域的实用性,即中文领域的大模型是否具有帮助人类解决具体任务的能力,为此,我们设计了中文领域大模型评测,构建了一个能够衡量「模型是否好用」的评测数据集。
我们在评测过程中更加关注模型在中文领域的实用性,具体分为三个部分:
所以我们将关注的模型能力划定为基础能力、中文特性、专业能力三大一级分类,并在每个一级分类下设置了更多的二级小分类,以此为标准建立了我们的评测数据集。
更多数据集的详细信息请点击特赛发LLM评测第一期数据集概要
由于时间关系,第一期测评主要评测了5个比较有代表性的中文领域大模型,同时加入了ChatGPT同分支的text-davinci-003(图称ChatGPT)作为比较,采用的方式是客观题使用准确率,主观题的开放性问答采用大模型当评测员的方法。
我们的测评目前仍有许多不足,但会在之后做一些持续工作来不断完善和优化评测的体系和结果的展现,包括但不限于:
主要结果如下,详细结果请参考特赛发LLM第一轮评测结果
当前repo主要包括以下几个部分
参考了Gaokao等benchmark的构建方法,将评测问题的指令类别大致分为判断题、选择题、开放问答题和推理题四种类型,根据类别适配不同的指令,并经过线下实验调优,选择输出结果较好的指令进行测评结果的输出。
详情参考src/prompt。
目前支持llama|moss|glm|baichuan|gptq系模型的推理,推理基于HF框架,也可以支持fastllm框架(针对chatglm系列),后续会兼容更多高效推理框架。
python llm_inference.py --model_name chatglm /
 --model_path your_model_path /
 --model_type [llama|moss|glm|baichuan|gptq] /
 --data_path your_data_path /
 --device 0  /
 --temperature 0 --top_p 1 --top_k 100 --rep_penalty 1.1 /
 --use_fastllm (optional for chatglm only)
我们让ChatGPT从三个维度来评价主观题的答案:有效性、可靠性、流畅性。 参考了Sunweiwei等人的工作RankGPT以及复旦大学的模型评测工作llm-eval,我们最终选择了以下两种大模型评测方式:RankingGPT 和 ScoringGPT。
scr/eval_agent,使用示例见auto-eval-with-chatgpt-examples.ipynb。metrics_calculation.ipynb


