
README
Parameter-Efficient Fine-Tuning for Foundation Models


🔥 News
- [2026/08/11] "Parameter-Efficient Fine-Tuning for Foundation Models" has been accepted by the International Journal of Computer Vision (IJCV).
- [2025/01/23] "Parameter-Efficient Fine-Tuning for Foundation Models" repo is created.
📝 Introduction
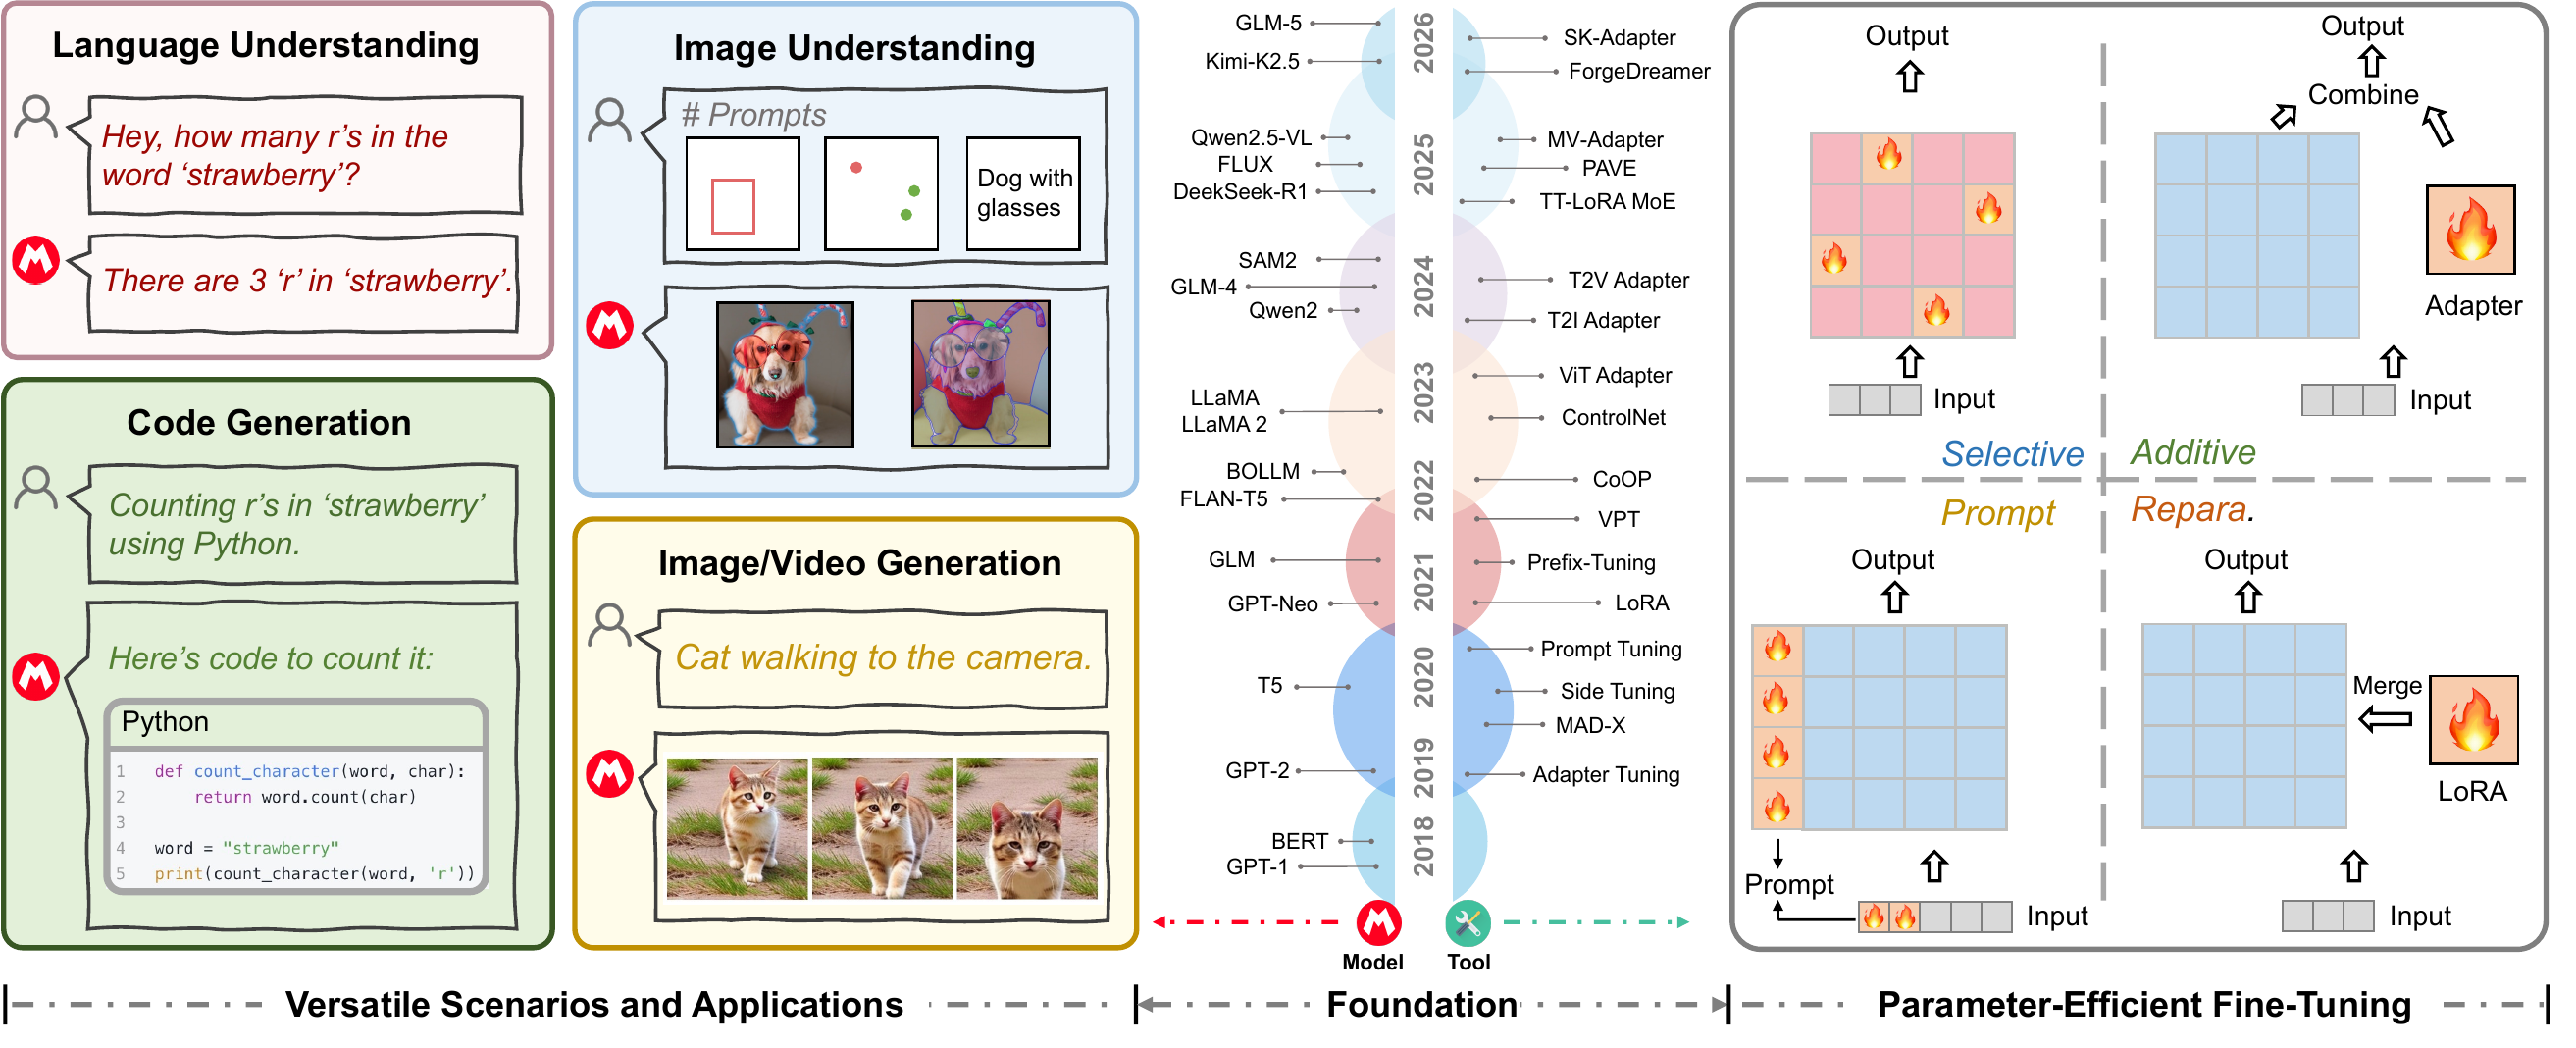
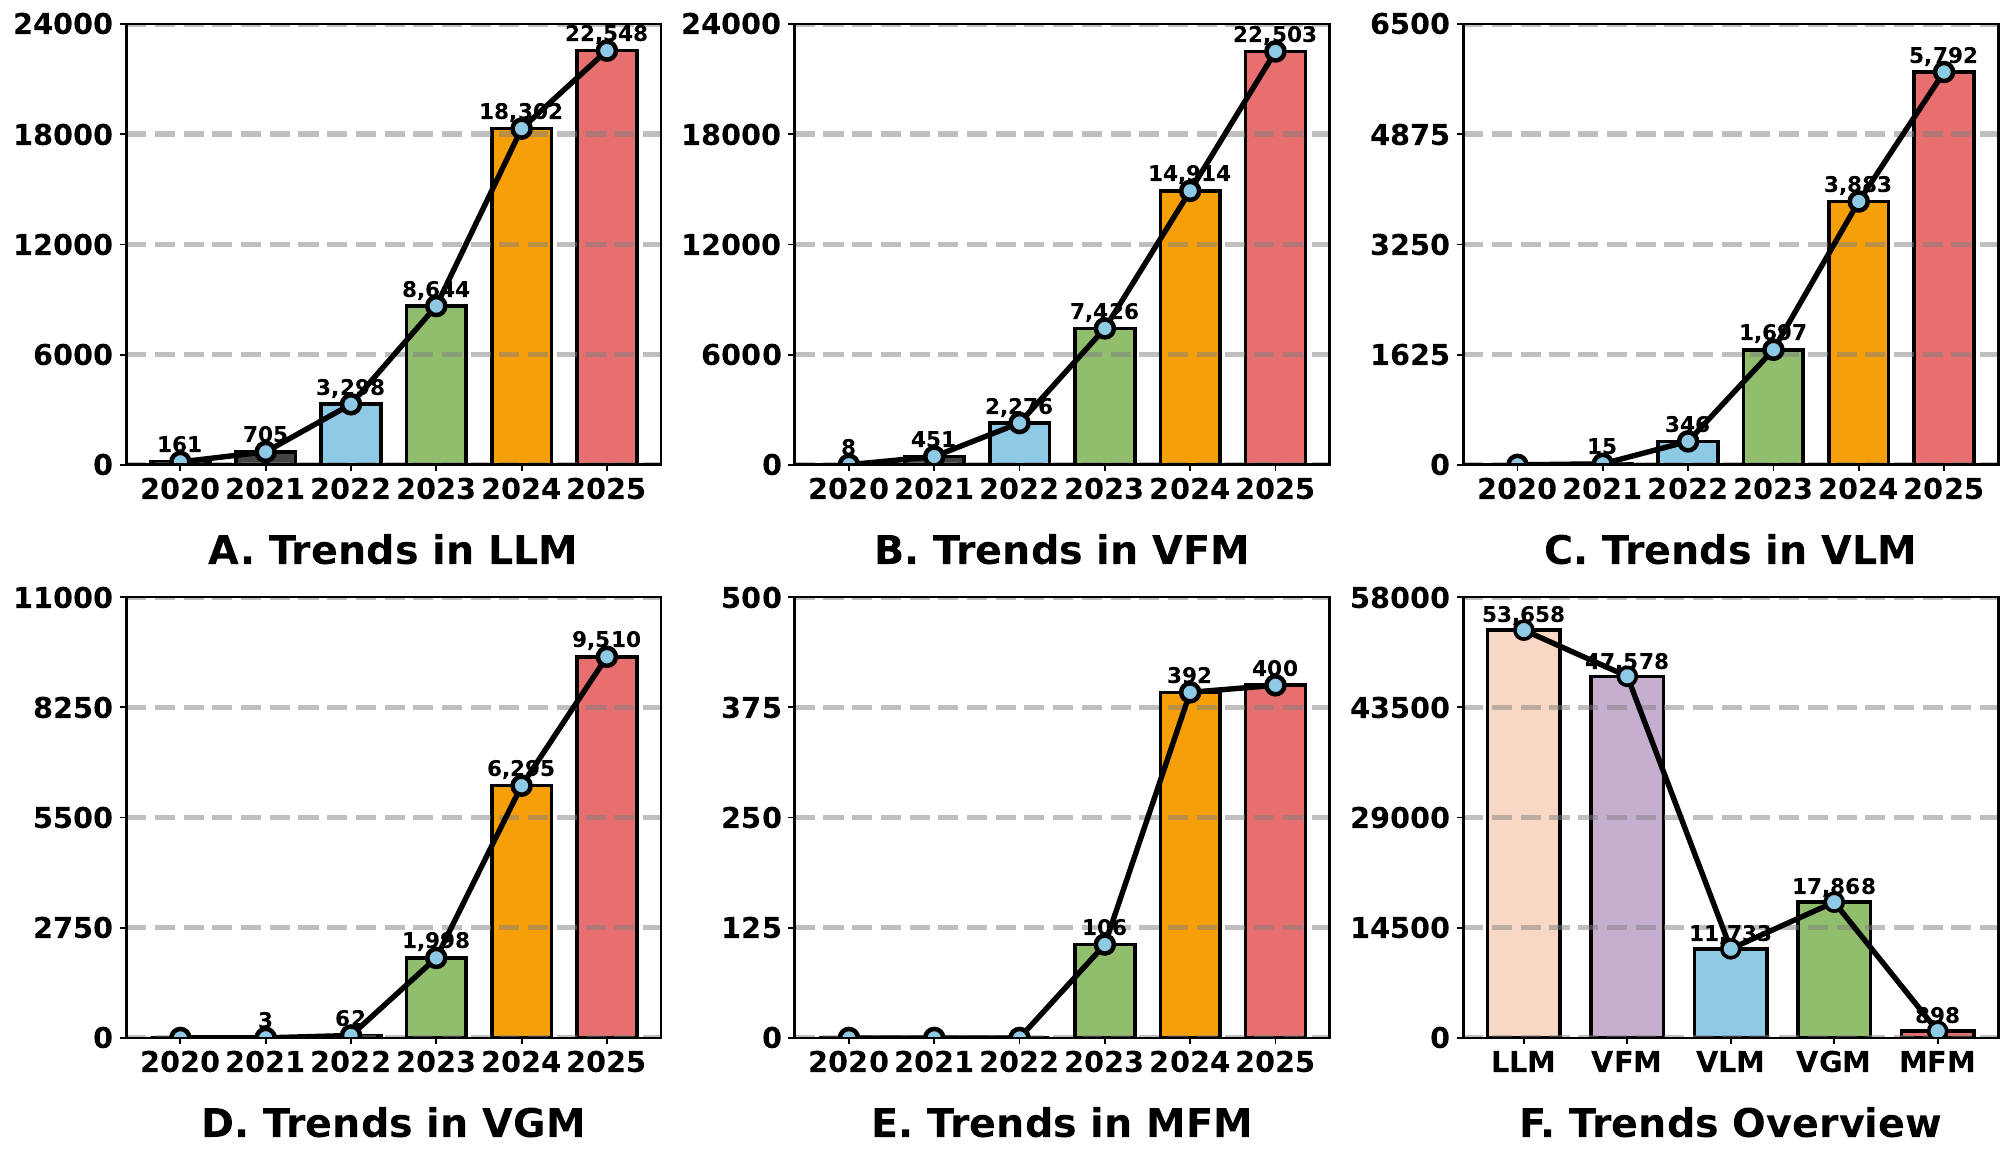
This survey aims to provide a comprehensive overview of PEFT techniques applied to diverse FMs and address critical gaps in understanding the techniques, trends, and applications. This survey provides a valuable resource for both newcomers and experts seeking to understand and use the power of PEFT across FMs.
🖼️ Updated Figures
The revised overview and trend figures are available below.
📚 Table of Contents
Keywords


Selective PEFT
Specific Selection
-
Revealing the Dark Secrets of BERT. EMNLP-IJCNLP 2019.
Olga Kovaleva, Alexey Romanov, Anna Rogers, Anna Rumshisky
[paper] [[code]]
-
BitFit: Simple Parameter-efficient Fine-tuning for Transformer-based Masked Language-models. ACL 2022.
Elad Ben-Zaken, Shauli Ravfogel, Yoav Goldberg
-
Parameter-Efficient Tuning with Special Token Adaptation. EACL 2023.
Xiaocong Yang, James Y. Huang, Wenxuan Zhou, Muhao Chen
Automatic Selection
-
Masking As an Efficient Alternative to Finetuning for Pretrained Language Models. EMNLP 2020.
Mengjie Zhao, Tao Lin, Fei Mi, Martin Jaggi, Hinrich Schutze
[paper] [[code]]
-
AutoFreeze: Automatically Freezing Model Blocks to Accelerate Fine-tuning. arXiv 2021.
Yuhan Liu, Saurabh Agarwal, Shivaram Venkataraman
-
Parameter-Efficient Transfer Learning with Diff Pruning. ACL 2020.
Demi Guo, Alexander M. Rush, Yoon Kim
-
Raise a Child in Large Language Model: Towards Effective and Generalizable Fine-tuning. EMNLP 2021.
Runxin Xu, Fuli Luo, Zhiyuan Zhang, Chuanqi Tan, Baobao Chang, Songfang Huang, Fei Huang
-
Training Neural Networks with Fixed Sparse Masks. NeurIPS 2021.
Yi-Lin Sung, Varun Nair, Colin Raffel
-
Learning Transferable Visual Models From Natural Language Supervision. ICML 2021.
Alec Radford, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, Amanda Askell, Pamela Mishkin, Jack Clark, Gretchen Krueger, Ilya Sutskever
-
Convolutions Die Hard: Open-Vocabulary Segmentation with Single Frozen Convolutional CLIP. NeurIPS 2023.
Qihang Yu, Ju He, Xueqing Deng, Xiaohui Shen, Liang-Chieh Chen
-
Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation. CoRR 2023.
Jay Zhangjie Wu, Yixiao Ge, Xintao Wang, Stan Weixian Lei, Yuchao Gu, Yufei Shi, Wynne Hsu, Ying Shan, Xiaohu Qie, Mike Zheng Shou
-
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM Finetuning. arXiv 2023.
Bingchen Zhao, Haoqin Tu, Chen Wei, Jieru Mei, Cihang Xie
[paper] [[code]]
Additive PEFT
Adapter
-
Parameter-Efficient Transfer Learning for NLP. CoRR 2019.
Neil Houlsby, Andrei Giurgiu, Stanislaw Jastrzebski, Bruna Morrone, Quentin de Laroussilhe, Andrea Gesmundo, Mona Attariyan, Sylvain Gelly.
-
AdapterFusion: Non-Destructive Task Composition for Transfer Learning. CoRR 2021.
Jonas Pfeiffer, Aishwarya Kamath, Andreas Rueckle, Kyunghyun Cho, Iryna Gurevych
-
AdaMix: Mixture-of-Adaptations for Parameter-efficient Model Tuning.EMNLP 2022.
Yaqing Wang, Sahaj Agarwal, Subhabrata Mukherjee, Xiaodong Liu, Jing Gao, Ahmed Hassan Awadallah, Jianfeng Gao.
-
MAD-X: An Adapter-Based Framework for Multi-Task Cross-Lingual Transfer. Intelligent Systems In Accounting, Finance &Management 2020.
Pfeiffer Jonas, Vulić Ivan,Gurevych Iryna, Ruder Sebastian.
-
BAD-X: Bilingual Adapters Improve Zero-Shot Cross-Lingual Transfer.NAACL 2022.
Marinela Parovic, Goran Glavas, Ivan Vulic, Anna Korhonen.
-
AdapterDrop - On the Efficiency of Adapters in Transformers. EMNLP 2021.
Andreas Rücklé, Gregor Geigle, Max Glockner, Tilman Beck, Jonas Pfeiffer, Nils Reimers, Iryna Gurevych.
[paper] [[code]]
-
AdapterBias: Parameter-efficient Token-dependent Representation Shift for Adapters in NLP Tasks. NAACL 2022.
Chin-Lun Fu, Zih-Ching Chen, Yun-Ru Lee, Hung-yi Lee.
-
SparseAdapter: An Easy Approach for Improving the Parameter-Efficiency of Adapters. arXiv 2022.
Shwai He, Liang Ding, Daize Dong, Miao Zhang, Dacheng Tao.
-
LST: Ladder Side-Tuning for Parameter and Memory Efficient Transfer Learning. NeurIPS 2022.
Yi-Lin Sung, Jaemin Cho, Mohit Bansal.
-
Convolutional Bypasses Are Better Vision Transformer Adapters. arXiv 2022.
Shibo Jie, Zhi-Hong Deng
-
AdaptFormer: Adapting Vision Transformers for Scalable Visual Recognition. NeurIPS 2022.
Shoufa Chen, Chongjian Ge, Zhan Tong, Jiangliu Wang, Yibing Song, Jue Wang, Ping Luo
-
Vision Transformer Adapter for Dense Predictions. ICLR 2023.
Zhe Chen, Yuchen Duan, Wenhai Wang, Junjun He, Tong Lu, Jifeng Dai, Yu Qiao
-
Side Adapter Network for Open-Vocabulary Semantic Segmentation. CVPR 2023.
Mengde Xu, Zheng Zhang, Fangyun Wei, Han Hu, Xiang Bai
-
DTL: Disentangled Transfer Learning for Visual Recognition. AAAI 2024.
Minghao Fu, Ke Zhu, Jianxin Wu
-
T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion Models. AAAI 2024.
Chong Mou, Xintao Wang, Liangbin Xie, Yanze Wu, Jian Zhang, Zhongang Qi, Ying Shan
-
IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models. arXiv 2023.
Hu Ye, Jun Zhang, Sibo Liu, Xiao Han, Wei Yang
-
I2V-Adapter: A General Image-to-Video Adapter for Diffusion Models. SIGGRAPH 2024.
Xun Guo, Mingwu Zheng, Liang Hou, Yuan Gao, Yufan Deng, Pengfei Wan, Di Zhang, Yufan Liu, Weiming Hu, Zhengjun Zha, Haibin Huang, Chongyang Ma
-
Adding Conditional Control to Text-to-Image Diffusion Models. ICCV 2023.
Lvmin Zhang, Anyi Rao, Maneesh Agrawala
-
ControlNeXt: Powerful and Efficient Control for Image and Video Generation. arXiv 2024.
Bohao Peng, Jian Wang, Yuechen Zhang, Wenbo Li, Ming-Chang Yang, Jiaya Jia
-
Ctrl-adapter: An Efficient and Versatile Framework for Adapting Diverse Controls to Any Diffusion Model. arXiv 2024.
Hao Lin, Jaemin Cho, Abhishek Zala, Mohit Bansal
-
Side4Video: Spatial-Temporal Side Network for Memory-Efficient Image-to-Video Transfer Learning. arXiv 2023.
Hao Yao, Wenhao Wu, Zhen Li
-
StyleCrafter: Enhancing Stylized Text-to-Video Generation with Style Adapter. SIGGRAPH Asia 2024 (Journal Track).
Gaoqiang Liu, Menghan Xia, Xintao Zhang, Haoran Chen, Junle Wang, Xin Wang, Yingqing He, Ying Shan
-
SimDA: Simple Diffusion Adapter for Efficient Video Generation. CVPR 2024.
Zhen Xing, Qi Dai, Han Hu, Zuxuan Wu, Yu-Gang Jiang
-
ResAdapter: Domain Consistent Resolution Adapter for Diffusion Models. AAAI 2025.
Jiaxiang Cheng, Pan Xie, Xin Xia, Jiashi Li, Jie Wu, Yuxi Ren, Huixia Li, Xuefeng Xiao, Min Zheng, Lean Fu
- NVS-Adapter: Plug-and-Play Novel View Synthesis from a Single Image. ECCV 2024.
Yoonwoo Jeong, Jinwoo Lee, Chiheon Kim, Minsu Cho, Doyup Lee
- 3D-Adapter: Geometry-Consistent Multi-View Diffusion for High-Quality 3D Generation. arXiv 2024.
Hansheng Chen, Bohan Shen, Yuxuan Liu, Rui Shi, Liang Zhou, Chenyang Lin, Jiaqi Gu, Haoyu Su, George Wetzstein, Leonidas Guibas
- MV-Adapter: Multi-View Consistent Image Generation Made Easy. ICCV 2025.
Zehuan Huang, Yuan-Chen Guo, Haoran Wang, Ran Yi, Lizhuang Ma, Yan-Pei Cao, Lu Sheng
Here, MV-Adapter denotes the multi-view image generation method. It is distinct from the video-text retrieval method with the same name listed in the VLM literature.
- SK-Adapter: Skeleton-Based Structural Control for Native 3D Generation. ECCV 2026.
Anbang Wang, Yuzhuo Ao, Shangzhe Wu, Chi-Keung Tang
-
LLaMA-Adapter: Efficient Fine-tuning of Language Models with Zero-init Attention. CVPR 2023.
Renrui Zhang, Jiaming Han, Chris Liu, Peng Gao, Aojun Zhou, Xiangfei Hu, Shilin Yan, Pan Lu, Hongsheng Li, Yu Qiao
-
LLaMA-Adapter V2: Parameter-Efficient Visual Instruction Model. ICLR 2024.
Peng Gao, Jiaming Han, Renrui Zhang, Ziyi Lin, Shijie Geng, Aojun Zhou, Wei Zhang, Pan Lu, Conghui He, Xiangyu Yue, Hongsheng Li, Yu Qiao
-
CLIP-Adapter: Better Vision-Language Models with Feature Adapters. IJCV 2024.
Peng Gao, Shijie Geng, Renrui Zhang, Teli Ma, Rongyao Fang, Yongfeng Zhang, Hongsheng Li, Yu Qiao
-
Tip-Adapter: Training-free CLIP-Adapter for Better Vision-Language Modeling. ECCV 2022.
Renrui Zhang, Rongyao Fang, Peng Gao, Wei Zhang, Kunchang Li, Jifeng Dai, Yu Qiao, Hongsheng Li
-
PAVE: Patching and Adapting Video Large Language Models. CVPR 2025.
Zhuoming Liu, Yiquan Li, Khoi Duc Nguyen, Yiwu Zhong, Yin Li
-
MV-Adapter: Multimodal Video Transfer Learning for Video Text Retrieval. CVPR 2024.
Xiaojie Jin, Bowen Zhang, Weibo Gong, Kai Xu, Xueqing Deng, Peng Wang, Zhao Zhang, Xiaohui Shen, Jiashi Feng
Prompt PEFT
Hard Prompt
-
Exploiting Cloze Questions for Few-Shot Text Classification and Natural Language Inference. EACL 2020.
Timo Schick, Hinrich Schutze
-
Cutting Down on Prompts and Parameters: Simple Few-Shot Learning with Language Models. ACL 2022.
Robert L. Logan, Ivana Balazevic, Eric Wallace, Fabio Petroni, Sameer Singh, Sebastian Riedel
AutoPrompt
-
AutoPrompt: Eliciting Knowledge from Language Models with Automatically Generated Prompts. EMNLP 2020.
Taylor Shin, Yasaman Razeghi, Robert L. Logan, Eric Wallace, Sameer Singh
Soft Prompt
-
Prefix-Tuning: Optimizing Continuous Prompts for Generation. ACL 2021.
Xiang Lisa Li, Percy Liang.
-
The Power of Scale for Parameter-Efficient Prompt Tuning. EMNLP 2021.
Brian Lester, Rami Al-Rfou’, Noah Constant.
-
GPT Understands, Too. CoRR 2024.
Xiao Liu, Yanan Zheng, Zhengxiao Du, Ming Ding, Yujie Qian, Zhilin Yang, Jie Tang
-
Differentiable Prompt Makes Pre-trained Language Models Better Few-shot Learners. CoRR 2021.
Ningyu Zhang, Luoqiu Li, Xiang Chen, Shumin Deng, Zhen Bi, Chuanqi Tan, Fei Huang, Huajun Chen
-
Y-Tuning: an Efficient Tuning Paradigm for Large-Scale Pre-Trained Models Via Label Representation Learning. Frontiers of Computer Science 2024.
Yitao Liu, Chenxin An, Xipeng Qiu
[paper] [[code]]
-
PPT: Pre-trained Prompt Tuning for Few-shot Learning. ACL 2021.
Yuxian Gu, Xu Han, Zhiyuan Liu, Minlie Huang
-
SPoT: Better Frozen Model Adaptation Through Soft Prompt Transfer. ACL 2020.
Yuxian Gu, Xu Han, Zhiyuan Liu, Minlie Huang
-
On Transferability of Prompt Tuning for Natural Language Processing. NAACL 2022.
Yusheng Su, Xiaozhi Wang, Yujia Qin, Chi-Min Chan, Yankai Lin, Huadong Wang, Kaiyue Wen, Zhiyuan Liu, Peng Li, Juanzi Li, Lei Hou, Maosong Sun, Jie Zhou
-
Exploring Visual Prompts for Communicating Directional Awareness to Kindergarten Children. International journal of human-computer studies 2019.
Vicente Nacher, Sandra Jurdi, Javier Jaen, Fernando Garcia-Sanjuan
[paper] [[code]]
-
Visual Prompt Tuning. ECCV 2022.
Menglin Jia, Luming Tang, Bor-Chun Chen, Claire Cardie, Serge Belongie, Bharath Hariharan, Ser-Nam Lim
-
Diversity-Aware Meta Visual Prompting. CVPR 2023.
Qidong Huang, Xiaoyi Dong, Dongdong Chen, Weiming Zhang, Feifei Wang, Gang Hua, Nenghai Yu
-
Understanding and Improving Visual Prompting: A Label-Mapping Perspective. CVPR 2023.
Aochuan Chen, Yuguang Yao, Pin-Yu Chen, Yihua Zhang, Sijia Liu
[paper] [[code]]
-
Unleashing the Power of Visual Prompting at the Pixel Level. CoRR 2022.
Junyang Wu, Xianhang Li, Chen Wei, Huiyu Wang, Alan Yuille, Yuyin Zhou, Cihang Xie
-
LION: Implicit Vision Prompt Tuning. AAAI 2024.
Haixin Wang, Jianlong Chang, Yihang Zhai, Xiao Luo, Jinan Sun, Zhouchen Lin, Qi Tian
[paper] [[code]]
-
An Image is Worth One Word: Personalizing Text-to-Image Generation Using Textual Inversion. arXiv 2022.
Rinon Gal, Yuval Alaluf, Yuval Atzmon, Or Patashnik, Amit H. Bermano, Gal Chechik, Daniel Cohen-Or
-
Learning to Prompt for Vision-Language Models. IJCV 2022.
Zhou, Kaiyang, Yang, Jingkang, Loy, Chen Change, Liu, Ziwei
-
Open-Vocabulary Semantic Segmentation with Mask-adapted CLIP. CVPR 2023.
Feng Liang, Bichen Wu, Xiaoliang Dai, Kunpeng Li, Yinan Zhao, Hang Zhang, Peizhao Zhang, Peter Vajda, Diana Marculescu
-
BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models. ICML 2023.
Junnan Li, DONGXU LI, Silvio Savarese, Steven Hoi
Reparameterization PEFT
-
LoRA: Low-Rank Adaptation of Large Language Models. CoRR 2022.
Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Weizhu Chen
-
QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023.
Tim Dettmers, Artidoro Pagnoni, Ari Holtzman, Luke Zettlemoyer
-
LoRA-FA: Memory-efficient Low-rank Adaptation for Large Language Models Fine-tuning. CoRR 2023.
Longteng Zhang, Lin Zhang, Shaohuai Shi, Xiaowen Chu, Bo Li
[paper] [[code]]
-
Delta-LoRA: Fine-Tuning High-Rank Parameters with the Delta of Low-Rank Matrices. CoRR 2023.
Bojia Zi, Xianbiao Qi, Lingzhi Wang, Jianan Wang, Kam-Fai Wong, Lei Zhang
[paper] [[code]]
-
A Stronger Mixture of Low-Rank Experts for Fine-Tuning Foundation Models. CoRR 2025.
Mengyang Sun, Yihao Wang, Tao Feng, Dan Zhang, Yifan Zhu, Jie Tang
-
TT-LoRA MoE: Unifying Parameter-Efficient Fine-Tuning and Sparse Mixture-of-Experts. arXiv 2025.
Pradip Kunwar, Minh N. Vu, Maanak Gupta, Mahmoud Abdelsalam, Manish Bhattarai
-
Enabling Lightweight Fine-tuning for Pre-trained Language Model Compression Based on Matrix Product Operators. CoRR 2021.
Peiyu Liu, Ze-Feng Gao, Wayne Xin Zhao, Z. Y. Xie, Zhong-Yi Lu, Ji-Rong Wen
-
1% VS 100%: Parameter-Efficient Low Rank Adapter for Dense Predictions. CVPR 2023.
Dongshuo Yin, Yiran Yang, Zhechao Wang, Hongfeng Yu, Kaiwen Wei, Xian Sun
[paper] [[code]]
-
Navigating Text-To-Image Customization: from LyCORIS Fine-Tuning to Model Evaluation. ICLR 2024.
SHIH-YING YEH, Yu-Guan Hsieh, Zhidong Gao, Bernard B W Yang, Giyeong Oh, Yanmin Gong
-
DiffuseKronA: A Parameter Efficient Fine-tuning Method for Personalized Diffusion Models. CoRR 2024.
Shyam Marjit, Harshit Singh, Nityanand Mathur, Sayak Paul, Chia-Mu Yu, Pin-Yu Chen
-
Mix-of-Show: Decentralized Low-Rank Adaptation for Multi-Concept Customization of Diffusion Models. CoRR 2023.
Yuchao Gu, Xintao Wang, Jay Zhangjie Wu, Yujun Shi, Yunpeng Chen, Zihan Fan, WUYOU XIAO, Rui Zhao, Shuning Chang, Weijia Wu, Yixiao Ge, Ying Shan, Mike Zheng Shou
-
Navigating Text-to-Image Generative Bias Across Indic Languages. ECCV 2024.
Surbhi Mittal, Arnav Sudan, MAYANK VATSA, RICHA SINGH, Tamar Glaser, Tal Hassner
-
Low-Rank Approximation for Sparse Attention in Multi-Modal LLMs. CVPR 2024.
Lin Song, Yukang Chen, Shuai Yang, Xiaohan Ding, Yixiao Ge, Ying-Cong Chen, Ying Shan
[paper] [[code]]
Hybrid PEFT
-
UniPELT: A Unified Framework for Parameter-Efficient Language Model Tuning. ACL 2022.
Yuning Mao, Lambert Mathias, Rui Hou, Amjad Almahairi, Hao Ma, Jiawei Han, Wen-tau Yih, Madian Khabsa
-
Compacter: Efficient Low-Rank Hypercomplex Adapter Layers. CoRR 2021.
Rabeeh Karimi Mahabadi, James Henderson, Sebastian Ruder
-
Towards a Unified View of Parameter-Efficient Transfer Learning. CoRR 2022.
Junxian He, Chunting Zhou, Xuezhe Ma, Taylor Berg-Kirkpatrick, Graham Neubig
-
Parameter-Efficient Fine-Tuning Design Spaces. CoRR 2023.
Jiaao Chen, Aston Zhang, Xingjian Shi, Mu Li, Alex Smola, Diyi Yang
-
DiffFit: Unlocking Transferability of Large Diffusion Models Via Simple Parameter-Efficient Fine-Tuning. ICCV 2023.
Enze Xie, Lewei Yao, Han Shi, Zhili Liu, Daquan Zhou, Zhaoqiang Liu, Jiawei Li, Zhenguo Li
-
Towards a Unified View on Visual Parameter-Efficient Transfer Learning. CoRR 2022.
Bruce X. B. Yu, Jianlong Chang, Lingbo Liu, Qi Tian, Chang Wen Chen
-
LoRA-Composer: Leveraging Low-Rank Adaptation for Multi-Concept Customization in Training-Free Diffusion Models. arXiv 2024.
Yang Yang, Wen Wang, Liang Peng, Chaotian Song, Yao Chen, Hengjia Li, Xiaolong Yang, Qinglin Lu, Deng Cai, Boxi Wu, Wei Liu
-
ForgeDreamer: Industrial Text-to-3D Generation with Multi-Expert LoRA and Cross-View Hypergraph. CVPR 2026 Findings.
Junhao Cai, Deyu Zeng, Junhao Pang, Lini Li, Zongze Wu, Xiaopin Zhong
Citation
If you find our survey and repository helpful, please kindly cite our paper:
@article{zhang2025parameter,
  title={Parameter-Efficient Fine-Tuning for Foundation Models},
  author={Zhang, Dan and Feng, Tao and Xue, Lilong and Wang, Yuandong and Dong, Yuxiao and Tang, Jie},
  journal={International Journal of Computer Vision},
  year={2026}
}
Contributors

5 commits
Similar repos


README
Parameter-Efficient Fine-Tuning for Foundation Models
🔥 News
- [2026/08/11] "Parameter-Efficient Fine-Tuning for Foundation Models" has been accepted by the International Journal of Computer Vision (IJCV).
- [2025/01/23] "Parameter-Efficient Fine-Tuning for Foundation Models" repo is created.
📝 Introduction
This survey aims to provide a comprehensive overview of PEFT techniques applied to diverse FMs and address critical gaps in understanding the techniques, trends, and applications. This survey provides a valuable resource for both newcomers and experts seeking to understand and use the power of PEFT across FMs.
🖼️ Updated Figures
The revised overview and trend figures are available below.
📚 Table of Contents
Keywords
Selective PEFT
Specific Selection
-
Revealing the Dark Secrets of BERT. EMNLP-IJCNLP 2019.
Olga Kovaleva, Alexey Romanov, Anna Rogers, Anna Rumshisky
[paper] [[code]]
-
BitFit: Simple Parameter-efficient Fine-tuning for Transformer-based Masked Language-models. ACL 2022.
Elad Ben-Zaken, Shauli Ravfogel, Yoav Goldberg
-
Parameter-Efficient Tuning with Special Token Adaptation. EACL 2023.
Xiaocong Yang, James Y. Huang, Wenxuan Zhou, Muhao Chen
Automatic Selection
-
Masking As an Efficient Alternative to Finetuning for Pretrained Language Models. EMNLP 2020.
Mengjie Zhao, Tao Lin, Fei Mi, Martin Jaggi, Hinrich Schutze
[paper] [[code]]
-
AutoFreeze: Automatically Freezing Model Blocks to Accelerate Fine-tuning. arXiv 2021.
Yuhan Liu, Saurabh Agarwal, Shivaram Venkataraman
-
Parameter-Efficient Transfer Learning with Diff Pruning. ACL 2020.
Demi Guo, Alexander M. Rush, Yoon Kim
-
Raise a Child in Large Language Model: Towards Effective and Generalizable Fine-tuning. EMNLP 2021.
Runxin Xu, Fuli Luo, Zhiyuan Zhang, Chuanqi Tan, Baobao Chang, Songfang Huang, Fei Huang
-
Training Neural Networks with Fixed Sparse Masks. NeurIPS 2021.
Yi-Lin Sung, Varun Nair, Colin Raffel
-
Learning Transferable Visual Models From Natural Language Supervision. ICML 2021.
Alec Radford, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, Amanda Askell, Pamela Mishkin, Jack Clark, Gretchen Krueger, Ilya Sutskever
-
Convolutions Die Hard: Open-Vocabulary Segmentation with Single Frozen Convolutional CLIP. NeurIPS 2023.
Qihang Yu, Ju He, Xueqing Deng, Xiaohui Shen, Liang-Chieh Chen
-
Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation. CoRR 2023.
Jay Zhangjie Wu, Yixiao Ge, Xintao Wang, Stan Weixian Lei, Yuchao Gu, Yufei Shi, Wynne Hsu, Ying Shan, Xiaohu Qie, Mike Zheng Shou
-
Tuning LayerNorm in Attention: Towards Efficient Multi-Modal LLM Finetuning. arXiv 2023.
Bingchen Zhao, Haoqin Tu, Chen Wei, Jieru Mei, Cihang Xie
[paper] [[code]]
Additive PEFT
Adapter
-
Parameter-Efficient Transfer Learning for NLP. CoRR 2019.
Neil Houlsby, Andrei Giurgiu, Stanislaw Jastrzebski, Bruna Morrone, Quentin de Laroussilhe, Andrea Gesmundo, Mona Attariyan, Sylvain Gelly.
-
AdapterFusion: Non-Destructive Task Composition for Transfer Learning. CoRR 2021.
Jonas Pfeiffer, Aishwarya Kamath, Andreas Rueckle, Kyunghyun Cho, Iryna Gurevych
-
AdaMix: Mixture-of-Adaptations for Parameter-efficient Model Tuning.EMNLP 2022.
Yaqing Wang, Sahaj Agarwal, Subhabrata Mukherjee, Xiaodong Liu, Jing Gao, Ahmed Hassan Awadallah, Jianfeng Gao.
-
MAD-X: An Adapter-Based Framework for Multi-Task Cross-Lingual Transfer. Intelligent Systems In Accounting, Finance &Management 2020.
Pfeiffer Jonas, Vulić Ivan,Gurevych Iryna, Ruder Sebastian.
-
BAD-X: Bilingual Adapters Improve Zero-Shot Cross-Lingual Transfer.NAACL 2022.
Marinela Parovic, Goran Glavas, Ivan Vulic, Anna Korhonen.
-
AdapterDrop - On the Efficiency of Adapters in Transformers. EMNLP 2021.
Andreas Rücklé, Gregor Geigle, Max Glockner, Tilman Beck, Jonas Pfeiffer, Nils Reimers, Iryna Gurevych.
[paper] [[code]]
-
AdapterBias: Parameter-efficient Token-dependent Representation Shift for Adapters in NLP Tasks. NAACL 2022.
Chin-Lun Fu, Zih-Ching Chen, Yun-Ru Lee, Hung-yi Lee.
-
SparseAdapter: An Easy Approach for Improving the Parameter-Efficiency of Adapters. arXiv 2022.
Shwai He, Liang Ding, Daize Dong, Miao Zhang, Dacheng Tao.
-
LST: Ladder Side-Tuning for Parameter and Memory Efficient Transfer Learning. NeurIPS 2022.
Yi-Lin Sung, Jaemin Cho, Mohit Bansal.
-
Convolutional Bypasses Are Better Vision Transformer Adapters. arXiv 2022.
Shibo Jie, Zhi-Hong Deng
-
AdaptFormer: Adapting Vision Transformers for Scalable Visual Recognition. NeurIPS 2022.
Shoufa Chen, Chongjian Ge, Zhan Tong, Jiangliu Wang, Yibing Song, Jue Wang, Ping Luo
-
Vision Transformer Adapter for Dense Predictions. ICLR 2023.
Zhe Chen, Yuchen Duan, Wenhai Wang, Junjun He, Tong Lu, Jifeng Dai, Yu Qiao
-
Side Adapter Network for Open-Vocabulary Semantic Segmentation. CVPR 2023.
Mengde Xu, Zheng Zhang, Fangyun Wei, Han Hu, Xiang Bai
-
DTL: Disentangled Transfer Learning for Visual Recognition. AAAI 2024.
Minghao Fu, Ke Zhu, Jianxin Wu
-
T2I-Adapter: Learning Adapters to Dig out More Controllable Ability for Text-to-Image Diffusion Models. AAAI 2024.
Chong Mou, Xintao Wang, Liangbin Xie, Yanze Wu, Jian Zhang, Zhongang Qi, Ying Shan
-
IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models. arXiv 2023.
Hu Ye, Jun Zhang, Sibo Liu, Xiao Han, Wei Yang
-
I2V-Adapter: A General Image-to-Video Adapter for Diffusion Models. SIGGRAPH 2024.
Xun Guo, Mingwu Zheng, Liang Hou, Yuan Gao, Yufan Deng, Pengfei Wan, Di Zhang, Yufan Liu, Weiming Hu, Zhengjun Zha, Haibin Huang, Chongyang Ma
-
Adding Conditional Control to Text-to-Image Diffusion Models. ICCV 2023.
Lvmin Zhang, Anyi Rao, Maneesh Agrawala
-
ControlNeXt: Powerful and Efficient Control for Image and Video Generation. arXiv 2024.
Bohao Peng, Jian Wang, Yuechen Zhang, Wenbo Li, Ming-Chang Yang, Jiaya Jia
-
Ctrl-adapter: An Efficient and Versatile Framework for Adapting Diverse Controls to Any Diffusion Model. arXiv 2024.
Hao Lin, Jaemin Cho, Abhishek Zala, Mohit Bansal
-
Side4Video: Spatial-Temporal Side Network for Memory-Efficient Image-to-Video Transfer Learning. arXiv 2023.
Hao Yao, Wenhao Wu, Zhen Li
-
StyleCrafter: Enhancing Stylized Text-to-Video Generation with Style Adapter. SIGGRAPH Asia 2024 (Journal Track).
Gaoqiang Liu, Menghan Xia, Xintao Zhang, Haoran Chen, Junle Wang, Xin Wang, Yingqing He, Ying Shan
-
SimDA: Simple Diffusion Adapter for Efficient Video Generation. CVPR 2024.
Zhen Xing, Qi Dai, Han Hu, Zuxuan Wu, Yu-Gang Jiang
-
ResAdapter: Domain Consistent Resolution Adapter for Diffusion Models. AAAI 2025.
Jiaxiang Cheng, Pan Xie, Xin Xia, Jiashi Li, Jie Wu, Yuxi Ren, Huixia Li, Xuefeng Xiao, Min Zheng, Lean Fu
- NVS-Adapter: Plug-and-Play Novel View Synthesis from a Single Image. ECCV 2024.
Yoonwoo Jeong, Jinwoo Lee, Chiheon Kim, Minsu Cho, Doyup Lee
- 3D-Adapter: Geometry-Consistent Multi-View Diffusion for High-Quality 3D Generation. arXiv 2024.
Hansheng Chen, Bohan Shen, Yuxuan Liu, Rui Shi, Liang Zhou, Chenyang Lin, Jiaqi Gu, Haoyu Su, George Wetzstein, Leonidas Guibas
- MV-Adapter: Multi-View Consistent Image Generation Made Easy. ICCV 2025.
Zehuan Huang, Yuan-Chen Guo, Haoran Wang, Ran Yi, Lizhuang Ma, Yan-Pei Cao, Lu Sheng
Here, MV-Adapter denotes the multi-view image generation method. It is distinct from the video-text retrieval method with the same name listed in the VLM literature.
- SK-Adapter: Skeleton-Based Structural Control for Native 3D Generation. ECCV 2026.
Anbang Wang, Yuzhuo Ao, Shangzhe Wu, Chi-Keung Tang
-
LLaMA-Adapter: Efficient Fine-tuning of Language Models with Zero-init Attention. CVPR 2023.
Renrui Zhang, Jiaming Han, Chris Liu, Peng Gao, Aojun Zhou, Xiangfei Hu, Shilin Yan, Pan Lu, Hongsheng Li, Yu Qiao
-
LLaMA-Adapter V2: Parameter-Efficient Visual Instruction Model. ICLR 2024.
Peng Gao, Jiaming Han, Renrui Zhang, Ziyi Lin, Shijie Geng, Aojun Zhou, Wei Zhang, Pan Lu, Conghui He, Xiangyu Yue, Hongsheng Li, Yu Qiao
-
CLIP-Adapter: Better Vision-Language Models with Feature Adapters. IJCV 2024.
Peng Gao, Shijie Geng, Renrui Zhang, Teli Ma, Rongyao Fang, Yongfeng Zhang, Hongsheng Li, Yu Qiao
-
Tip-Adapter: Training-free CLIP-Adapter for Better Vision-Language Modeling. ECCV 2022.
Renrui Zhang, Rongyao Fang, Peng Gao, Wei Zhang, Kunchang Li, Jifeng Dai, Yu Qiao, Hongsheng Li
-
PAVE: Patching and Adapting Video Large Language Models. CVPR 2025.
Zhuoming Liu, Yiquan Li, Khoi Duc Nguyen, Yiwu Zhong, Yin Li
-
MV-Adapter: Multimodal Video Transfer Learning for Video Text Retrieval. CVPR 2024.
Xiaojie Jin, Bowen Zhang, Weibo Gong, Kai Xu, Xueqing Deng, Peng Wang, Zhao Zhang, Xiaohui Shen, Jiashi Feng
Prompt PEFT
Hard Prompt
-
Exploiting Cloze Questions for Few-Shot Text Classification and Natural Language Inference. EACL 2020.
Timo Schick, Hinrich Schutze
-
Cutting Down on Prompts and Parameters: Simple Few-Shot Learning with Language Models. ACL 2022.
Robert L. Logan, Ivana Balazevic, Eric Wallace, Fabio Petroni, Sameer Singh, Sebastian Riedel
AutoPrompt
-
AutoPrompt: Eliciting Knowledge from Language Models with Automatically Generated Prompts. EMNLP 2020.
Taylor Shin, Yasaman Razeghi, Robert L. Logan, Eric Wallace, Sameer Singh
Soft Prompt
-
Prefix-Tuning: Optimizing Continuous Prompts for Generation. ACL 2021.
Xiang Lisa Li, Percy Liang.
-
The Power of Scale for Parameter-Efficient Prompt Tuning. EMNLP 2021.
Brian Lester, Rami Al-Rfou’, Noah Constant.
-
GPT Understands, Too. CoRR 2024.
Xiao Liu, Yanan Zheng, Zhengxiao Du, Ming Ding, Yujie Qian, Zhilin Yang, Jie Tang
-
Differentiable Prompt Makes Pre-trained Language Models Better Few-shot Learners. CoRR 2021.
Ningyu Zhang, Luoqiu Li, Xiang Chen, Shumin Deng, Zhen Bi, Chuanqi Tan, Fei Huang, Huajun Chen
-
Y-Tuning: an Efficient Tuning Paradigm for Large-Scale Pre-Trained Models Via Label Representation Learning. Frontiers of Computer Science 2024.
Yitao Liu, Chenxin An, Xipeng Qiu
[paper] [[code]]
-
PPT: Pre-trained Prompt Tuning for Few-shot Learning. ACL 2021.
Yuxian Gu, Xu Han, Zhiyuan Liu, Minlie Huang
-
SPoT: Better Frozen Model Adaptation Through Soft Prompt Transfer. ACL 2020.
Yuxian Gu, Xu Han, Zhiyuan Liu, Minlie Huang
-
On Transferability of Prompt Tuning for Natural Language Processing. NAACL 2022.
Yusheng Su, Xiaozhi Wang, Yujia Qin, Chi-Min Chan, Yankai Lin, Huadong Wang, Kaiyue Wen, Zhiyuan Liu, Peng Li, Juanzi Li, Lei Hou, Maosong Sun, Jie Zhou
-
Exploring Visual Prompts for Communicating Directional Awareness to Kindergarten Children. International journal of human-computer studies 2019.
Vicente Nacher, Sandra Jurdi, Javier Jaen, Fernando Garcia-Sanjuan
[paper] [[code]]
-
Visual Prompt Tuning. ECCV 2022.
Menglin Jia, Luming Tang, Bor-Chun Chen, Claire Cardie, Serge Belongie, Bharath Hariharan, Ser-Nam Lim
-
Diversity-Aware Meta Visual Prompting. CVPR 2023.
Qidong Huang, Xiaoyi Dong, Dongdong Chen, Weiming Zhang, Feifei Wang, Gang Hua, Nenghai Yu
-
Understanding and Improving Visual Prompting: A Label-Mapping Perspective. CVPR 2023.
Aochuan Chen, Yuguang Yao, Pin-Yu Chen, Yihua Zhang, Sijia Liu
[paper] [[code]]
-
Unleashing the Power of Visual Prompting at the Pixel Level. CoRR 2022.
Junyang Wu, Xianhang Li, Chen Wei, Huiyu Wang, Alan Yuille, Yuyin Zhou, Cihang Xie
-
LION: Implicit Vision Prompt Tuning. AAAI 2024.
Haixin Wang, Jianlong Chang, Yihang Zhai, Xiao Luo, Jinan Sun, Zhouchen Lin, Qi Tian
[paper] [[code]]
-
An Image is Worth One Word: Personalizing Text-to-Image Generation Using Textual Inversion. arXiv 2022.
Rinon Gal, Yuval Alaluf, Yuval Atzmon, Or Patashnik, Amit H. Bermano, Gal Chechik, Daniel Cohen-Or
-
Learning to Prompt for Vision-Language Models. IJCV 2022.
Zhou, Kaiyang, Yang, Jingkang, Loy, Chen Change, Liu, Ziwei
-
Open-Vocabulary Semantic Segmentation with Mask-adapted CLIP. CVPR 2023.
Feng Liang, Bichen Wu, Xiaoliang Dai, Kunpeng Li, Yinan Zhao, Hang Zhang, Peizhao Zhang, Peter Vajda, Diana Marculescu
-
BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models. ICML 2023.
Junnan Li, DONGXU LI, Silvio Savarese, Steven Hoi
Reparameterization PEFT
-
LoRA: Low-Rank Adaptation of Large Language Models. CoRR 2022.
Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Weizhu Chen
-
QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023.
Tim Dettmers, Artidoro Pagnoni, Ari Holtzman, Luke Zettlemoyer
-
LoRA-FA: Memory-efficient Low-rank Adaptation for Large Language Models Fine-tuning. CoRR 2023.
Longteng Zhang, Lin Zhang, Shaohuai Shi, Xiaowen Chu, Bo Li
[paper] [[code]]
-
Delta-LoRA: Fine-Tuning High-Rank Parameters with the Delta of Low-Rank Matrices. CoRR 2023.
Bojia Zi, Xianbiao Qi, Lingzhi Wang, Jianan Wang, Kam-Fai Wong, Lei Zhang
[paper] [[code]]
-
A Stronger Mixture of Low-Rank Experts for Fine-Tuning Foundation Models. CoRR 2025.
Mengyang Sun, Yihao Wang, Tao Feng, Dan Zhang, Yifan Zhu, Jie Tang
-
TT-LoRA MoE: Unifying Parameter-Efficient Fine-Tuning and Sparse Mixture-of-Experts. arXiv 2025.
Pradip Kunwar, Minh N. Vu, Maanak Gupta, Mahmoud Abdelsalam, Manish Bhattarai
-
Enabling Lightweight Fine-tuning for Pre-trained Language Model Compression Based on Matrix Product Operators. CoRR 2021.
Peiyu Liu, Ze-Feng Gao, Wayne Xin Zhao, Z. Y. Xie, Zhong-Yi Lu, Ji-Rong Wen
-
1% VS 100%: Parameter-Efficient Low Rank Adapter for Dense Predictions. CVPR 2023.
Dongshuo Yin, Yiran Yang, Zhechao Wang, Hongfeng Yu, Kaiwen Wei, Xian Sun
[paper] [[code]]
-
Navigating Text-To-Image Customization: from LyCORIS Fine-Tuning to Model Evaluation. ICLR 2024.
SHIH-YING YEH, Yu-Guan Hsieh, Zhidong Gao, Bernard B W Yang, Giyeong Oh, Yanmin Gong
-
DiffuseKronA: A Parameter Efficient Fine-tuning Method for Personalized Diffusion Models. CoRR 2024.
Shyam Marjit, Harshit Singh, Nityanand Mathur, Sayak Paul, Chia-Mu Yu, Pin-Yu Chen
-
Mix-of-Show: Decentralized Low-Rank Adaptation for Multi-Concept Customization of Diffusion Models. CoRR 2023.
Yuchao Gu, Xintao Wang, Jay Zhangjie Wu, Yujun Shi, Yunpeng Chen, Zihan Fan, WUYOU XIAO, Rui Zhao, Shuning Chang, Weijia Wu, Yixiao Ge, Ying Shan, Mike Zheng Shou
-
Navigating Text-to-Image Generative Bias Across Indic Languages. ECCV 2024.
Surbhi Mittal, Arnav Sudan, MAYANK VATSA, RICHA SINGH, Tamar Glaser, Tal Hassner
-
Low-Rank Approximation for Sparse Attention in Multi-Modal LLMs. CVPR 2024.
Lin Song, Yukang Chen, Shuai Yang, Xiaohan Ding, Yixiao Ge, Ying-Cong Chen, Ying Shan
[paper] [[code]]
Hybrid PEFT
-
UniPELT: A Unified Framework for Parameter-Efficient Language Model Tuning. ACL 2022.
Yuning Mao, Lambert Mathias, Rui Hou, Amjad Almahairi, Hao Ma, Jiawei Han, Wen-tau Yih, Madian Khabsa
-
Compacter: Efficient Low-Rank Hypercomplex Adapter Layers. CoRR 2021.
Rabeeh Karimi Mahabadi, James Henderson, Sebastian Ruder
-
Towards a Unified View of Parameter-Efficient Transfer Learning. CoRR 2022.
Junxian He, Chunting Zhou, Xuezhe Ma, Taylor Berg-Kirkpatrick, Graham Neubig
-
Parameter-Efficient Fine-Tuning Design Spaces. CoRR 2023.
Jiaao Chen, Aston Zhang, Xingjian Shi, Mu Li, Alex Smola, Diyi Yang
-
DiffFit: Unlocking Transferability of Large Diffusion Models Via Simple Parameter-Efficient Fine-Tuning. ICCV 2023.
Enze Xie, Lewei Yao, Han Shi, Zhili Liu, Daquan Zhou, Zhaoqiang Liu, Jiawei Li, Zhenguo Li
-
Towards a Unified View on Visual Parameter-Efficient Transfer Learning. CoRR 2022.
Bruce X. B. Yu, Jianlong Chang, Lingbo Liu, Qi Tian, Chang Wen Chen
-
LoRA-Composer: Leveraging Low-Rank Adaptation for Multi-Concept Customization in Training-Free Diffusion Models. arXiv 2024.
Yang Yang, Wen Wang, Liang Peng, Chaotian Song, Yao Chen, Hengjia Li, Xiaolong Yang, Qinglin Lu, Deng Cai, Boxi Wu, Wei Liu
-
ForgeDreamer: Industrial Text-to-3D Generation with Multi-Expert LoRA and Cross-View Hypergraph. CVPR 2026 Findings.
Junhao Cai, Deyu Zeng, Junhao Pang, Lini Li, Zongze Wu, Xiaopin Zhong
Citation
If you find our survey and repository helpful, please kindly cite our paper:
@article{zhang2025parameter,
  title={Parameter-Efficient Fine-Tuning for Foundation Models},
  author={Zhang, Dan and Feng, Tao and Xue, Lilong and Wang, Yuandong and Dong, Yuxiao and Tang, Jie},
  journal={International Journal of Computer Vision},
  year={2026}
}
Similar repos
Contributors
5 commits