
[ACL2026 Main] Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding
21
7 commits
updated Jun 6, 2026
README
Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding
ACL 2026 Main Conference


Sensen Gao1*,
Shanshan Zhao2†,
Xu Jiang3,
Lunhao Duan4*,
Yong Xien Chng3*,
Qing-Guo Chen2,
Weihua Luo2,
Kaifu Zhang2,
Jia-Wang Bian1,
Mingming Gong1,5†
1MBZUAI 2Alibaba International Digital Commerce Group 3Tsinghua University 4Wuhan University 5University of Melbourne
* Work done during an internship at Alibaba International Digital Commerce Group. † Corresponding authors.
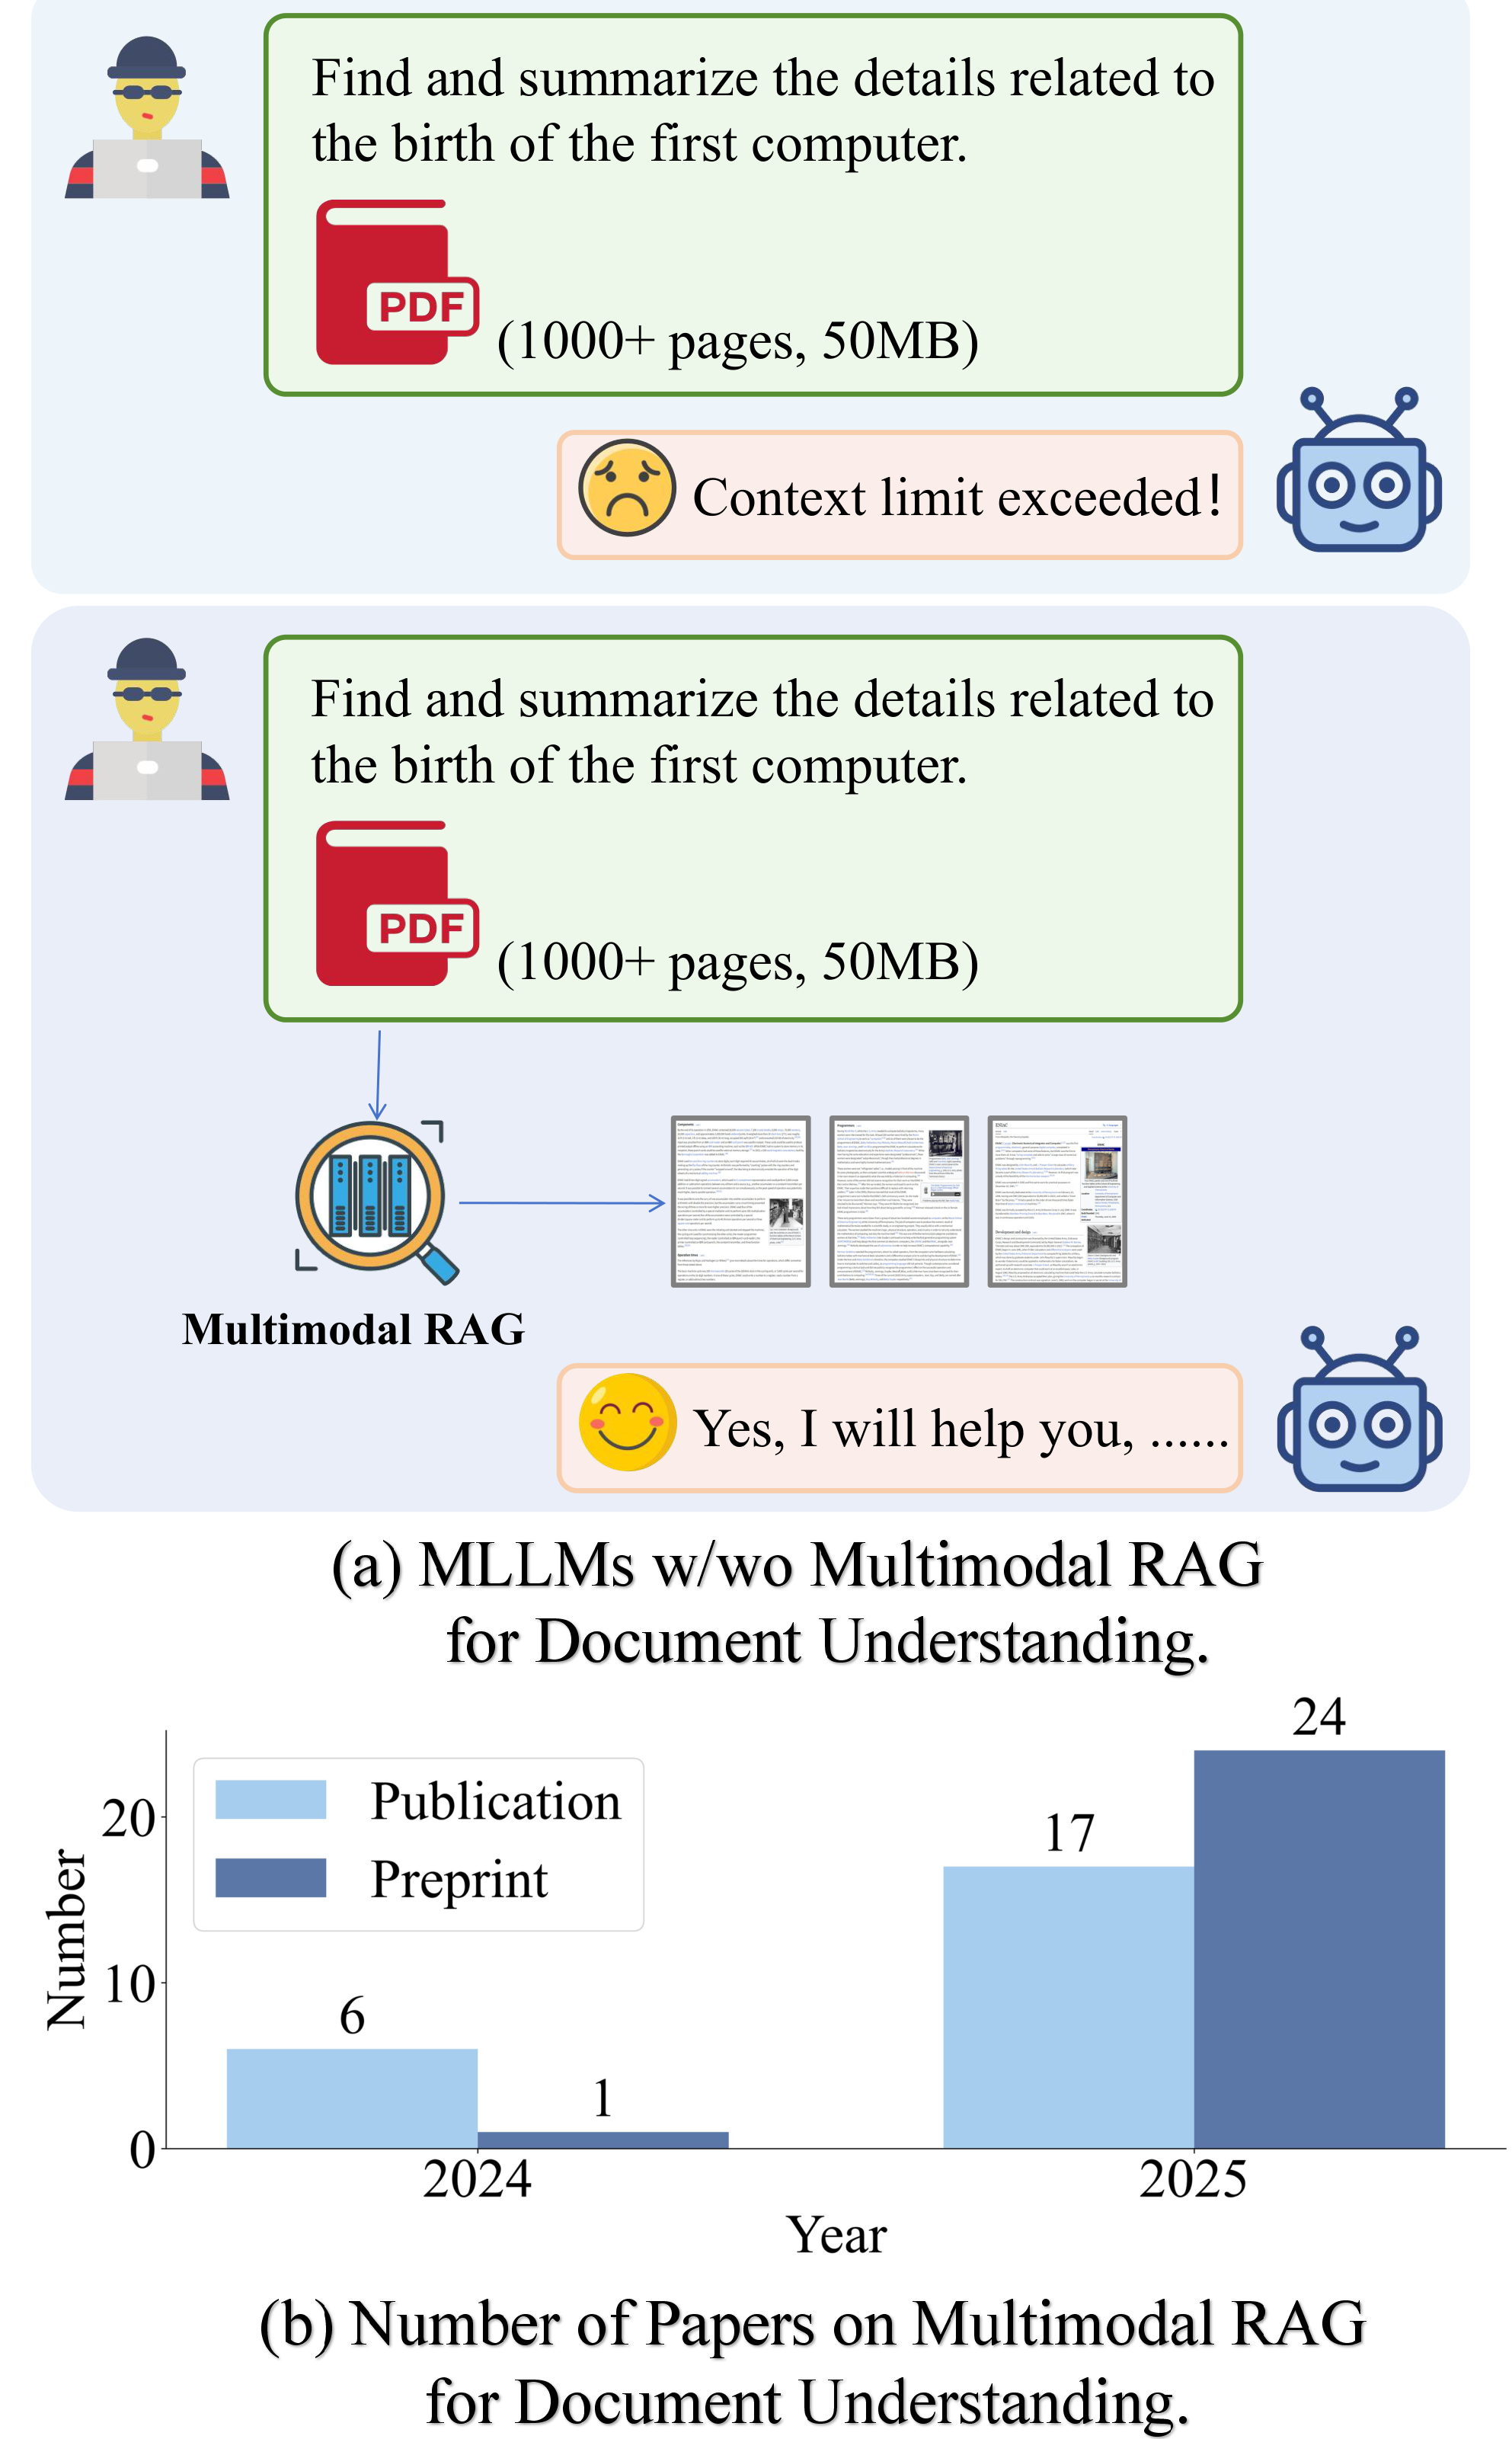
This repository maintains a curated list of methods, datasets, and benchmarks for Multimodal Retrieval-Augmented Generation (RAG) in Document Understanding, based on our ACL 2026 survey. We will keep updating this list. Feel free to open an issue or PR if we missed any relevant work!
Updates
- Ongoing - We keep this list actively maintained! If you have a recent paper, or notice any relevant work we missed, feel free to contact us or open an issue/PR — we'll include it in a future update.
- 2026.04 - Paper accepted at ACL 2026 Main Conference!
- 2025.10 - Paper available on arXiv.
Table of Contents
Overview
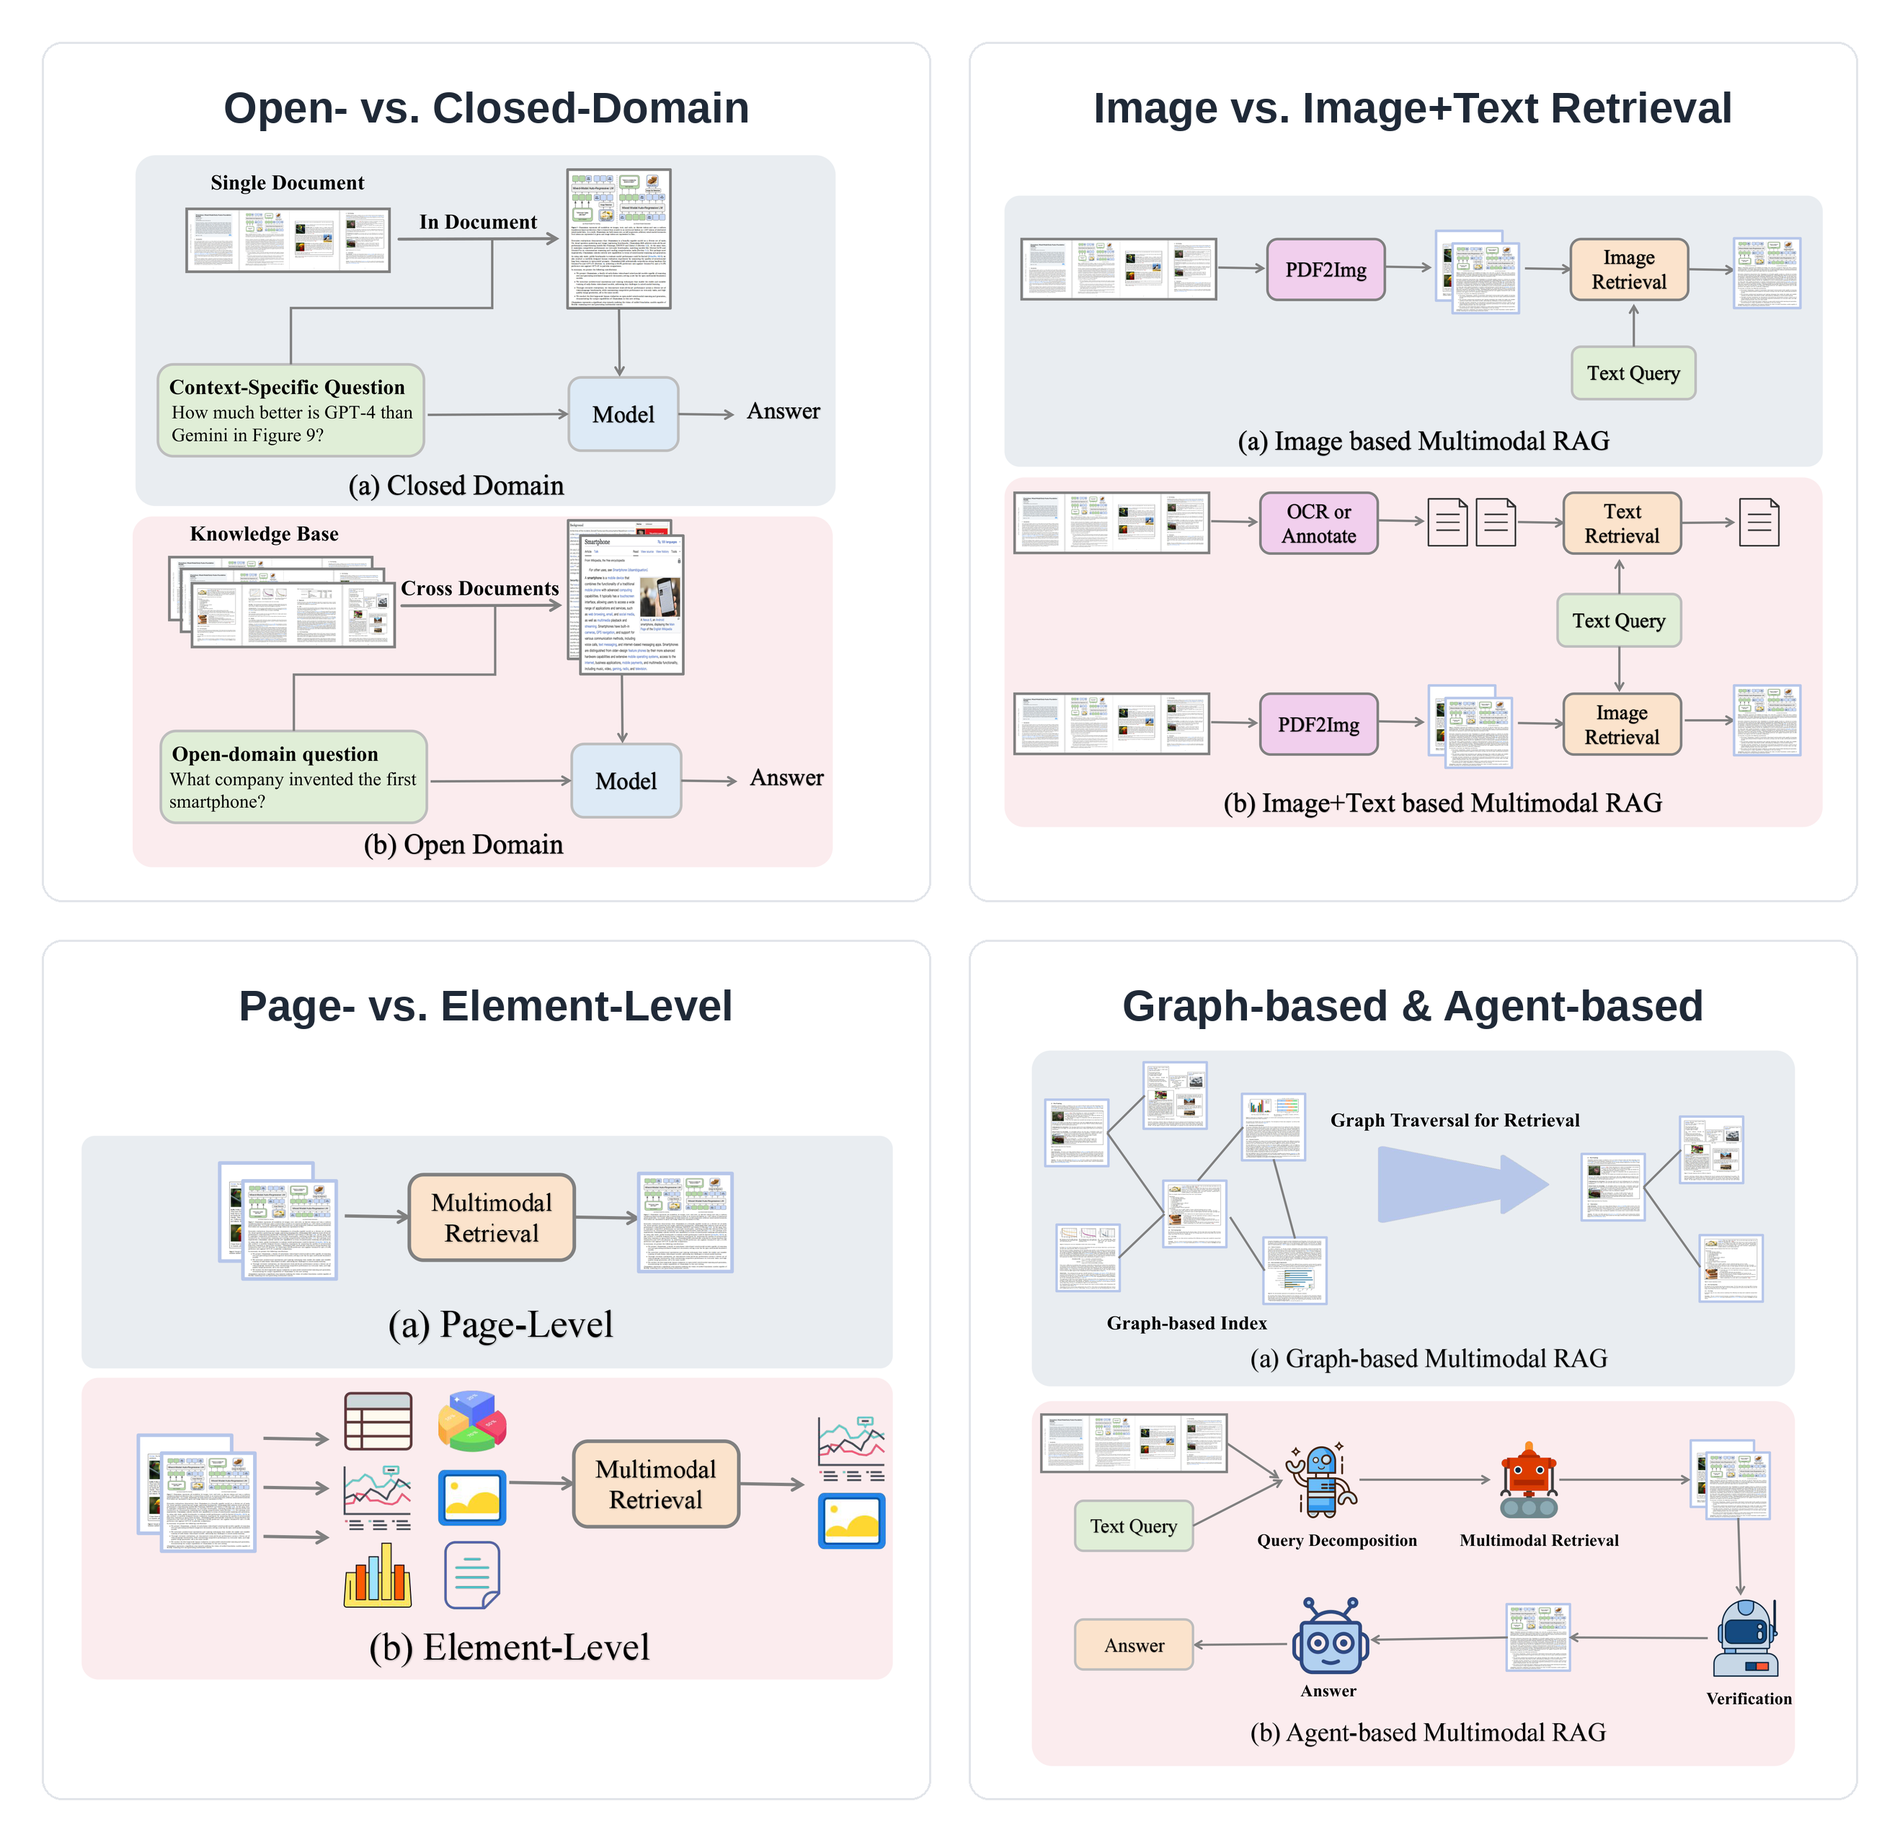
A taxonomy of multimodal RAG for document understanding: retrieval domain (open vs. closed), retrieval modality (image vs. image+text), retrieval granularity (page- vs. element-level), and hybrid graph-/agent-based enhancements.
Methods
Open-Domain Methods
| Method | Venue | Modality | Granularity | Training | Paper |
|---|---|---|---|---|---|
| DSE | EMNLP 2024 | Image | Page | Yes | Link |
| ColPali | ICLR 2025 | Image | Page | Yes | Link |
| ColQwen2 | ICLR 2025 | Image | Page | Yes | Link |
| VisRAG | ICLR 2025 | Image | Page | Yes | Link |
| M3DocRAG | Preprint | Image | Page | No | Link |
| VisDoMRAG | NAACL 2025 | Image+Text | Page | No | Link |
| GME | CVPR 2025 | Image+Text | Page | Yes | Link |
| ViDoRAG | EMNLP 2025 | Image+Text | Page | No | Link |
| HM-RAG | ACM MM 2025 | Image+Text | Page | No | Link |
| VDocRAG | CVPR 2025 | Image | Page | Yes | Link |
| VRAG-RL | Preprint | Image | Element | Yes | Link |
| CoRe-MMRAG | ACL 2025 | Image+Text | Page | Yes | Link |
| Light-ColPali | ACL 2025 | Image | Page | Yes | Link |
| MM-R5 | Preprint | Image | Page | Yes | Link |
| SimpleDoc | Preprint | Image+Text | Page | No | Link |
| DocVQA-RAP | ICIC 2025 | Image | Element | No | Link |
| RL-QR | Preprint | Image | Page | Yes | Link |
| Patho-AgenticRAG | Preprint | Image | Page | Yes | Link |
| M2IO-R1 | Preprint | Image+Text | Page | Yes | Link |
| mKG-RAG | Preprint | Image+Text | Element | Yes | Link |
| DB3Team-RAG | Preprint | Image+Text | Page | Yes | Link |
| PREMIR | EMNLP 2025 | Image+Text | Element | No | Link |
| CMRAG | Preprint | Image+Text | Page | No | Link |
| MoLoRAG | EMNLP 2025 | Image | Page | Yes | Link |
| SERVAL | Preprint | Image | Page | No | Link |
| MetaEmbed | Preprint | Image | Page | Yes | Link |
| DocPruner | Preprint | Image | Page | Yes | Link |
| RECON | Preprint | Image+Text | Element | No | Link |
| LAD-RAG | Preprint | Image+Text | Element | No | Link |
| HEAVEN | Preprint | Image | Page | No | Link |
| MARA | ACM MM 2025 | Image | Element | Yes | Link |
| HPC-ColPali | Preprint | Image | Page | Yes | Link |
| RegionRAG | Preprint | Image | Element | Yes | Link |
| IndustryRAG | EMNLP Industry 2025 | Image | Page | No | Link |
| COLMATE | EMNLP Industry 2025 | Image | Page | Yes | Link |
| LILaC | EMNLP 2025 | Image | Element | No | Link |
| HKRAG | Preprint | Image | Element | Yes | Link |
| SLEUTH | Preprint | Image | Page | No | Link |
| Snappy | Preprint | Image | Element | No | Link |
Closed-Domain Methods
| Method | Venue | Modality | Granularity | Training | Paper |
|---|---|---|---|---|---|
| CREAM | ACM MM 2024 | Image+Text | Page | Yes | Link |
| SV-RAG | ICLR 2025 | Image | Page | Yes | Link |
| FRAG | Preprint | Image | Page | No | Link |
| MG-RAG | Preprint | Image+Text | Element | No | Link |
| VisChunk | Preprint | Image+Text | Page | No | Link |
| MMRAG-DocQA | Preprint | Image+Text | Element | No | Link |
| ReDocRAG | ICDAR WML 2025 | Image | Page | Yes | Link |
| DREAM | ACM MM 2025 | Image | Page | Yes | Link |
| HEAR | ACM MMW 2025 | Image+Text | Page | No | Link |
Graph-based Methods
| Method | Venue | Key Idea | Paper |
|---|---|---|---|
| HM-RAG | ACM MM 2025 | Hierarchical multi-agent framework with graph databases for structured relation capture | Link |
| mKG-RAG | Preprint | Multimodal knowledge graphs aligning entities across vision and text | Link |
| DB3Team-RAG | Preprint | Image-indexed knowledge graphs for domain-specific retrieval | Link |
| MoLoRAG | EMNLP 2025 | Page graphs encoding logical connections via graph traversal | Link |
| RECON | Preprint | Global multimodal document graph linking intra-page and inter-page relations | Link |
| LAD-RAG | Preprint | Layout-aware component graphs with dynamic traversal | Link |
| LILaC | EMNLP 2025 | Layered component graph with late interaction subgraph retrieval | Link |
Agent-based Methods
| Method | Venue | Key Idea | Paper |
|---|---|---|---|
| ViDoRAG | EMNLP 2025 | Iterative agent workflow with exploration, summarization, and reflection | Link |
| HM-RAG | ACM MM 2025 | Hierarchical multi-agent with query decomposition and consistency voting | Link |
| Patho-AgenticRAG | Preprint | Task decomposition and multi-turn search for pathology textbooks | Link |
| HEAR | ACM MMW 2025 | Closed-loop multi-agent reasoning with VLM-based document parsing | Link |
| SLEUTH | Preprint | Coarse-to-fine agent filtering and distilling salient evidence | Link |
Datasets & Benchmarks
Document Understanding Datasets
| Dataset | #Queries | #Docs/Images | Content | Paper |
|---|---|---|---|---|
| TabFQuAD | 210 | 210 (I) | Table | Link |
| PlotQA | 28.9M | 224K (I) | Chart | Link |
| DocVQA | 50K | 12,767 (I) | Text, Table, Chart | Link |
| VisualMRC | 30,562 | 10,197 (I) | Text, Table, Chart | Link |
| TAT-DQA | 16,558 | 2,758 (D) | Text, Table, Chart | Link |
| InfoVQA | 30K | 5.4K (I) | Text, Table, Chart | Link |
| ChartQA | 23.1K | 17.1K (I) | Chart | Link |
| ScienceQA | 21K | 7,803 (I) | Text, Table, Chart | Link |
| DUDE | 41,491 | 4,974 (D) | Text, Table, Chart | Link |
| SlideVQA | 52K | 14.5K (I) | Slide | Link |
| ArXivQA | 100K | 16.6K (D) | Text, Table, Chart | Link |
| MMLongBench-Doc | 1,062 | 130 (D) | Text, Table, Chart, Slide | Link |
| PaperTab | 393 | 307 (D) | Text, Table | Link |
| FetaTab | 1,023 | 878 (D) | Table | Link |
| SPIQA | 27K | 25.5K (D) | Table, Chart | Link |
| LongDocURL | 2,325 | 396 (D) | Text, Table, Chart | Link |
Multimodal RAG Benchmarks
| Benchmark | #Queries | #Docs/Images | Content | Introduced By | Paper |
|---|---|---|---|---|---|
| ViDoRe | 3.8K | 8.3K (D) | Text, Table, Chart | ColPali | Link |
| VisR-Bench | 471 | 226 (D) | Text, Table, Chart, Slide | VisR-Bench | Link |
| M3DocVQA | 2,441 | 3,368 (D) | Text, Table, Chart | M3DocRAG | Link |
| VisDoMBench | 2,271 | 1,277 (D) | Text, Table, Chart, Slide | VisDoMRAG | Link |
| ViDoSeek | 1,142 | 300 (D) | Text, Table, Chart | ViDoRAG | Link |
| OpenDocVQA | 206K | 43K (I) | Text, Table, Chart | VDocRAG | Link |
| UniDoc-Bench | 1.6K | 70K (I) | Text, Table, Chart | UniDoc | Link |
| BBox-DocVQA | 32K | 4.4K (D) | Text, Table, Chart | BBox-DocVQA | Link |
Citation
If you find this survey useful, please cite our paper:
@article{gao2025scaling,
      title={Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding},
      author={Sensen Gao and Shanshan Zhao and Xu Jiang and Lunhao Duan and Yong Xien Chng and Qing-Guo Chen and Weihua Luo and Kaifu Zhang and Jia-Wang Bian and Mingming Gong},
      year={2025},
      eprint={2510.15253},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2510.15253},
}
Contact
For questions or suggestions, feel free to open an issue or contact Sensen Gao.
Contributors

7 commits
Similar repos


[ACL2026 Main] Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding
21
7 commits
updated Jun 6, 2026
README
Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding
ACL 2026 Main Conference
Sensen Gao1*,
Shanshan Zhao2†,
Xu Jiang3,
Lunhao Duan4*,
Yong Xien Chng3*,
Qing-Guo Chen2,
Weihua Luo2,
Kaifu Zhang2,
Jia-Wang Bian1,
Mingming Gong1,5†
1MBZUAI 2Alibaba International Digital Commerce Group 3Tsinghua University 4Wuhan University 5University of Melbourne
* Work done during an internship at Alibaba International Digital Commerce Group. † Corresponding authors.
This repository maintains a curated list of methods, datasets, and benchmarks for Multimodal Retrieval-Augmented Generation (RAG) in Document Understanding, based on our ACL 2026 survey. We will keep updating this list. Feel free to open an issue or PR if we missed any relevant work!
Updates
- Ongoing - We keep this list actively maintained! If you have a recent paper, or notice any relevant work we missed, feel free to contact us or open an issue/PR — we'll include it in a future update.
- 2026.04 - Paper accepted at ACL 2026 Main Conference!
- 2025.10 - Paper available on arXiv.
Table of Contents
Overview
A taxonomy of multimodal RAG for document understanding: retrieval domain (open vs. closed), retrieval modality (image vs. image+text), retrieval granularity (page- vs. element-level), and hybrid graph-/agent-based enhancements.
Methods
Open-Domain Methods
| Method | Venue | Modality | Granularity | Training | Paper |
|---|---|---|---|---|---|
| DSE | EMNLP 2024 | Image | Page | Yes | Link |
| ColPali | ICLR 2025 | Image | Page | Yes | Link |
| ColQwen2 | ICLR 2025 | Image | Page | Yes | Link |
| VisRAG | ICLR 2025 | Image | Page | Yes | Link |
| M3DocRAG | Preprint | Image | Page | No | Link |
| VisDoMRAG | NAACL 2025 | Image+Text | Page | No | Link |
| GME | CVPR 2025 | Image+Text | Page | Yes | Link |
| ViDoRAG | EMNLP 2025 | Image+Text | Page | No | Link |
| HM-RAG | ACM MM 2025 | Image+Text | Page | No | Link |
| VDocRAG | CVPR 2025 | Image | Page | Yes | Link |
| VRAG-RL | Preprint | Image | Element | Yes | Link |
| CoRe-MMRAG | ACL 2025 | Image+Text | Page | Yes | Link |
| Light-ColPali | ACL 2025 | Image | Page | Yes | Link |
| MM-R5 | Preprint | Image | Page | Yes | Link |
| SimpleDoc | Preprint | Image+Text | Page | No | Link |
| DocVQA-RAP | ICIC 2025 | Image | Element | No | Link |
| RL-QR | Preprint | Image | Page | Yes | Link |
| Patho-AgenticRAG | Preprint | Image | Page | Yes | Link |
| M2IO-R1 | Preprint | Image+Text | Page | Yes | Link |
| mKG-RAG | Preprint | Image+Text | Element | Yes | Link |
| DB3Team-RAG | Preprint | Image+Text | Page | Yes | Link |
| PREMIR | EMNLP 2025 | Image+Text | Element | No | Link |
| CMRAG | Preprint | Image+Text | Page | No | Link |
| MoLoRAG | EMNLP 2025 | Image | Page | Yes | Link |
| SERVAL | Preprint | Image | Page | No | Link |
| MetaEmbed | Preprint | Image | Page | Yes | Link |
| DocPruner | Preprint | Image | Page | Yes | Link |
| RECON | Preprint | Image+Text | Element | No | Link |
| LAD-RAG | Preprint | Image+Text | Element | No | Link |
| HEAVEN | Preprint | Image | Page | No | Link |
| MARA | ACM MM 2025 | Image | Element | Yes | Link |
| HPC-ColPali | Preprint | Image | Page | Yes | Link |
| RegionRAG | Preprint | Image | Element | Yes | Link |
| IndustryRAG | EMNLP Industry 2025 | Image | Page | No | Link |
| COLMATE | EMNLP Industry 2025 | Image | Page | Yes | Link |
| LILaC | EMNLP 2025 | Image | Element | No | Link |
| HKRAG | Preprint | Image | Element | Yes | Link |
| SLEUTH | Preprint | Image | Page | No | Link |
| Snappy | Preprint | Image | Element | No | Link |
Closed-Domain Methods
| Method | Venue | Modality | Granularity | Training | Paper |
|---|---|---|---|---|---|
| CREAM | ACM MM 2024 | Image+Text | Page | Yes | Link |
| SV-RAG | ICLR 2025 | Image | Page | Yes | Link |
| FRAG | Preprint | Image | Page | No | Link |
| MG-RAG | Preprint | Image+Text | Element | No | Link |
| VisChunk | Preprint | Image+Text | Page | No | Link |
| MMRAG-DocQA | Preprint | Image+Text | Element | No | Link |
| ReDocRAG | ICDAR WML 2025 | Image | Page | Yes | Link |
| DREAM | ACM MM 2025 | Image | Page | Yes | Link |
| HEAR | ACM MMW 2025 | Image+Text | Page | No | Link |
Graph-based Methods
| Method | Venue | Key Idea | Paper |
|---|---|---|---|
| HM-RAG | ACM MM 2025 | Hierarchical multi-agent framework with graph databases for structured relation capture | Link |
| mKG-RAG | Preprint | Multimodal knowledge graphs aligning entities across vision and text | Link |
| DB3Team-RAG | Preprint | Image-indexed knowledge graphs for domain-specific retrieval | Link |
| MoLoRAG | EMNLP 2025 | Page graphs encoding logical connections via graph traversal | Link |
| RECON | Preprint | Global multimodal document graph linking intra-page and inter-page relations | Link |
| LAD-RAG | Preprint | Layout-aware component graphs with dynamic traversal | Link |
| LILaC | EMNLP 2025 | Layered component graph with late interaction subgraph retrieval | Link |
Agent-based Methods
| Method | Venue | Key Idea | Paper |
|---|---|---|---|
| ViDoRAG | EMNLP 2025 | Iterative agent workflow with exploration, summarization, and reflection | Link |
| HM-RAG | ACM MM 2025 | Hierarchical multi-agent with query decomposition and consistency voting | Link |
| Patho-AgenticRAG | Preprint | Task decomposition and multi-turn search for pathology textbooks | Link |
| HEAR | ACM MMW 2025 | Closed-loop multi-agent reasoning with VLM-based document parsing | Link |
| SLEUTH | Preprint | Coarse-to-fine agent filtering and distilling salient evidence | Link |
Datasets & Benchmarks
Document Understanding Datasets
| Dataset | #Queries | #Docs/Images | Content | Paper |
|---|---|---|---|---|
| TabFQuAD | 210 | 210 (I) | Table | Link |
| PlotQA | 28.9M | 224K (I) | Chart | Link |
| DocVQA | 50K | 12,767 (I) | Text, Table, Chart | Link |
| VisualMRC | 30,562 | 10,197 (I) | Text, Table, Chart | Link |
| TAT-DQA | 16,558 | 2,758 (D) | Text, Table, Chart | Link |
| InfoVQA | 30K | 5.4K (I) | Text, Table, Chart | Link |
| ChartQA | 23.1K | 17.1K (I) | Chart | Link |
| ScienceQA | 21K | 7,803 (I) | Text, Table, Chart | Link |
| DUDE | 41,491 | 4,974 (D) | Text, Table, Chart | Link |
| SlideVQA | 52K | 14.5K (I) | Slide | Link |
| ArXivQA | 100K | 16.6K (D) | Text, Table, Chart | Link |
| MMLongBench-Doc | 1,062 | 130 (D) | Text, Table, Chart, Slide | Link |
| PaperTab | 393 | 307 (D) | Text, Table | Link |
| FetaTab | 1,023 | 878 (D) | Table | Link |
| SPIQA | 27K | 25.5K (D) | Table, Chart | Link |
| LongDocURL | 2,325 | 396 (D) | Text, Table, Chart | Link |
Multimodal RAG Benchmarks
| Benchmark | #Queries | #Docs/Images | Content | Introduced By | Paper |
|---|---|---|---|---|---|
| ViDoRe | 3.8K | 8.3K (D) | Text, Table, Chart | ColPali | Link |
| VisR-Bench | 471 | 226 (D) | Text, Table, Chart, Slide | VisR-Bench | Link |
| M3DocVQA | 2,441 | 3,368 (D) | Text, Table, Chart | M3DocRAG | Link |
| VisDoMBench | 2,271 | 1,277 (D) | Text, Table, Chart, Slide | VisDoMRAG | Link |
| ViDoSeek | 1,142 | 300 (D) | Text, Table, Chart | ViDoRAG | Link |
| OpenDocVQA | 206K | 43K (I) | Text, Table, Chart | VDocRAG | Link |
| UniDoc-Bench | 1.6K | 70K (I) | Text, Table, Chart | UniDoc | Link |
| BBox-DocVQA | 32K | 4.4K (D) | Text, Table, Chart | BBox-DocVQA | Link |
Citation
If you find this survey useful, please cite our paper:
@article{gao2025scaling,
      title={Scaling Beyond Context: A Survey of Multimodal Retrieval-Augmented Generation for Document Understanding},
      author={Sensen Gao and Shanshan Zhao and Xu Jiang and Lunhao Duan and Yong Xien Chng and Qing-Guo Chen and Weihua Luo and Kaifu Zhang and Jia-Wang Bian and Mingming Gong},
      year={2025},
      eprint={2510.15253},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2510.15253},
}
Contact
For questions or suggestions, feel free to open an issue or contact Sensen Gao.
Similar repos
Contributors
7 commits