BrainTrace: GraphRAG-based on-device knowledge management system for secure and efficient document analysis
See the code지식 그래프를 활용한 지식 관리 시스템
Brain Trace System (BrainT)는 사용자가 업로드한 PDF, TXT, DOCX, Markdown 문서에서 핵심 개념과 개념 간의 관계를 자동으로 추출하고, 이를 지식 그래프 형태로 저장하여 활용하는 시스템입니다. 문서 내용을 단순히 저장하는 것을 넘어, 개념 단위로 구조화하여 탐색하고 활용할 수 있도록 돕습니다.
사용자가 질문을 입력하면, 시스템은 지식 그래프에서 관련된 개념들을 중심으로 의미 있는 노드들을 탐색하고, 필요 시 문서 내 해당 개념이 포함된 부분(청크)을 함께 가져와, 문서 기반의 답변을 제공합니다. 이때, 답변은 단순한 키워드 검색이 아닌, 그래프 구조를 따라 의미를 이해하고 연결하는 방식으로 생성됩니다. 또한, 기능을 로컬 또는 클라우드의 구동 환경을 선택하여 실행할 수 있으며, 외부 서버와의 연결 없이도 작동하므로 보안에 민감한 환경에서도 사용할 수 있습니다.
문서를 계속 추가할수록 그래프는 더욱 정교해지고, 검색과 탐색의 깊이와 정확성도 함께 향상됩니다. 흩어져 있던 정보들이 유기적으로 연결되며, 지식은 단순히 쌓이는 것을 넘어 구조화되고 유의미하게 진화하는 형태로 재탄생합니다.
BrainTrace는 다양한 유형의 학습 자료를 다음의 다섯 단계로 지식 그래프로 변환합니다.
텍스트 추출: PDF, 텍스트 파일, 메모, Markdown, DOCX 등의 소스에서 텍스트를 추출합니다.
토큰화: 추출된 텍스트를 의미 있는 단위(문장, 명사구 등)로 분할합니다.
로직:
청킹: 주제별로 유사한 문장들을 묶어 전체 텍스트를 1000~2000자 사이의 청크로 분할합니다. 지식 그래프의 골격을 생성합니다.
노드 및 엣지 생성: 각 청크에서 개념(노드)과 관계(엣지)를 추출하고 청킹 과정에서 생성한 지식그래프와 연결합니다.
그래프 병합: 모든 청크에서 노드/엣지를 통합된 지식 그래프로 병합합니다.
청킹 함수는 재귀적으로 호출되며 다음 동작을 반복합니다.
명사구 추출: (depth 0에서만 수행) 텍스트를 문장 단위로 분할하고 명사구를 추출합니다.
LDA 모듈을 통한 주제 벡터 변환 & 유사도 계산: (depth 0에서만 수행) 각 문장을 주제 벡터로 변환하고 벡터간의 내적값을 계산하여 행렬로 저장합니다.
Grouping: 유사도를 기준으로 각 문장을 묶어 청크를 구성합니다.
각 청크에서 노드 및 엣지 생성: 각 청크에서 tf-idf 키워드를 추출하고 노드와 엣지를 생성합니다.
지식 그래프에 대한 더 자세한 설명은 KNOWLEDGE_GRAPH.md에서 확인할 수 있습니다.
BrainTrace의 Q&A는 질문 → 임베딩 검색 → 그래프 DB 조회 → LLM 답변 생성 → 참조 노드/출처/정확도 계산 → 출처보기 순으로 처리됩니다.
질문 입력
질문 임베딩 & 유사 노드 검색(Qdrant, Q 계산)
Q는 질문과 검색된 노드들의 평균 유사도로, 정확도 계산에 사용됩니다.그래프 DB 조회 (빠른 탐색 / 딥서치)
use_deep_search에 따라 Neo4j 쿼리 경로가 달라집니다.스키마 텍스트 구성 (LLM 입력용 컨텍스트)
original_sentences 기반으로 정리됩니다.LLM 답변 생성
참조 노드 선정 (답변 임베딩 기반) + 답변에 붙이기
0.7입니다.정확도 계산 (Q/S/C 가중합)
S는 답변과 Neo4j 노드 description/original_sentences의 코사인 유사도입니다.C는 **커버리지(Coverage)**로, 답변이 실제로 LLM에 제공된 스키마 컨텍스트 안의 노드를 얼마나 반영했는지 보는 지표입니다.원본 소스/문장(근거) 구성
referenced_nodes에 대해 source_id 목록 + 원문을 구성합니다.original_sentences**를 기반으로 합니다.답변 저장 & 응답 구조
BrainTrace는 지식 그래프를 생성할 때 두 가지 로직을 고려했습니다.
알고리즘 기반(수동 청킹)
위의 “지식 그래프 생성 파이프라인”에서 설명한 방식입니다. LLM 없이 manual_chunking_sentences로 문장을 청킹하고, 알고리즘적으로 노드/엣지를 생성합니다.
LLM 기반(OpenAI/Ollama)
OpenAI/Ollama가 원문에서 노드/엣지를 추출하고, description을 추가로 생성합니다. (description은 노드를 한 문장으로 요약한 설명입니다.)
이후 description과 원문 문장 임베딩 유사도를 비교해 original_sentences를 산출합니다.
|
새 프로젝트 생성
프로젝트 이름과 환경을 선택하여 새 프로젝트를 시작할 수 있습니다.
|
업로드 시 그래프 생성
파일을 업로드하면 자동으로 노드와 엣지가 생성되어 그래프에 반영됩니다.
|
|
소스 하이라이팅
원하는 소스를 클릭하여 내용을 확인하고 하이라이팅할 수 있습니다.
|
Q&A 후 참조된 노드
답변에 사용된 노드를 그래프 뷰에서 확인할 수 있습니다.
|
|
출처 보기
답변에 사용된 노드가 어떤 소스를 참고했는지 확인합니다.
|
소스 노드 보기
특정 소스가 생성한 노드를 그래프 뷰에서 확인합니다.
|
|
메모 작성 및 소스로 추가
메모를 작성하고 소스로 변환하여 그래프에 반영할 수 있습니다.
|
LLM 모델 및 탐색 종류 선택
원하는 LLM 모델을 선택하고, 깊은 탐색 또는 빠른 탐색 중 하나를 진행할 수 있습니다.
|
|
소스 삭제
특정 소스를 삭제하면 해당 소스로 생성된 노드도 함께 삭제됩니다.
|
탐색 기능
파일 내용이나 키워드로 유사한 소스를 찾습니다.
|
|
그래프 뷰 라이트 모드 노드 검색 및 노드 속성 확인
노드 검색으로 원하는 노드로 카메라를 이동하고, 노드 호버 시 출처 및 원문을 확인할 수 있습니다.
|
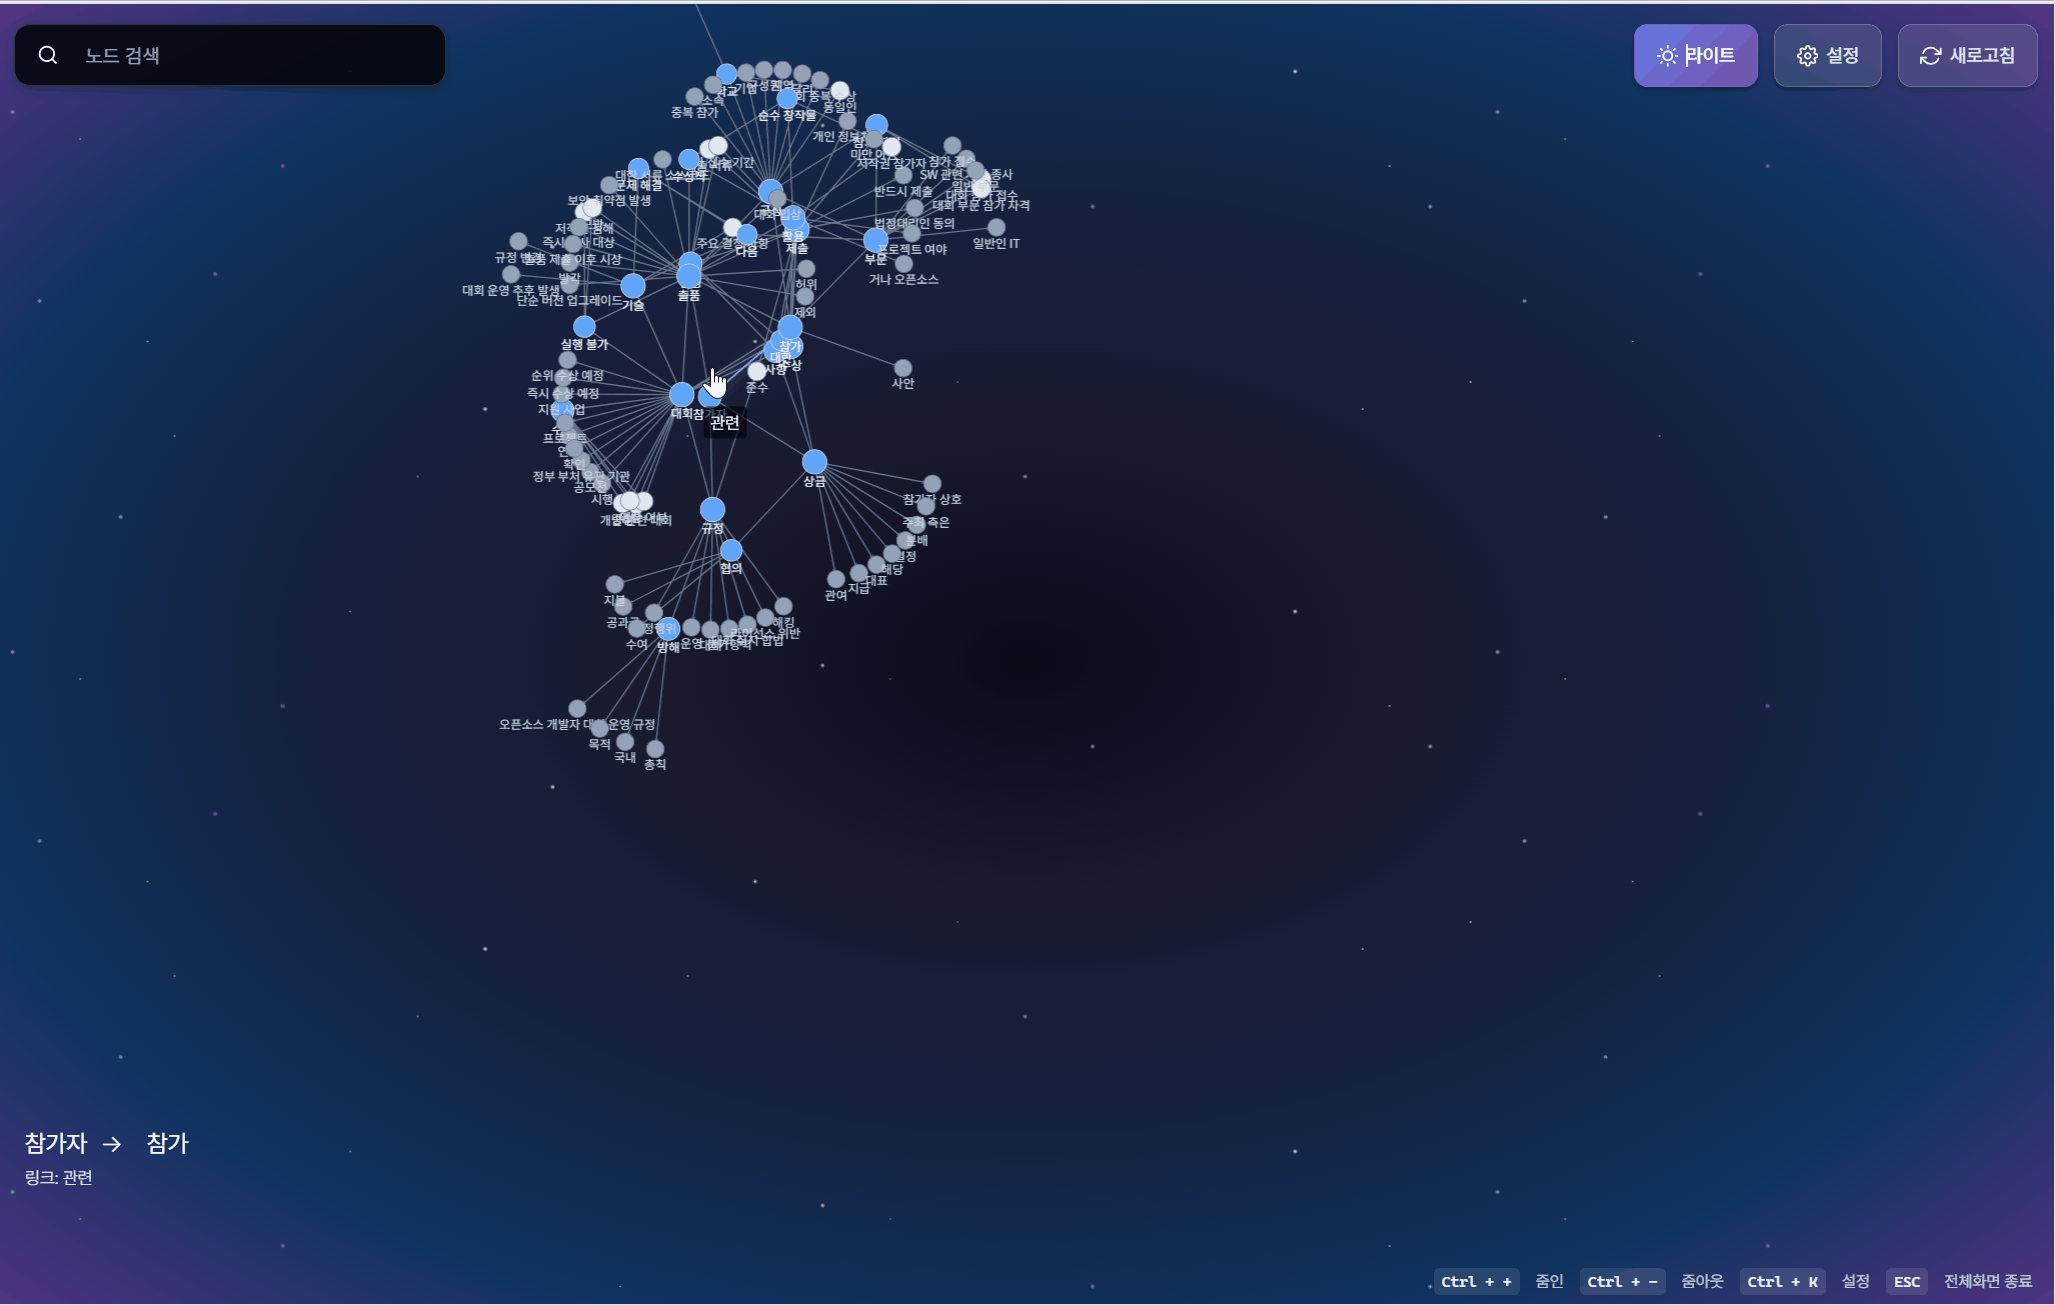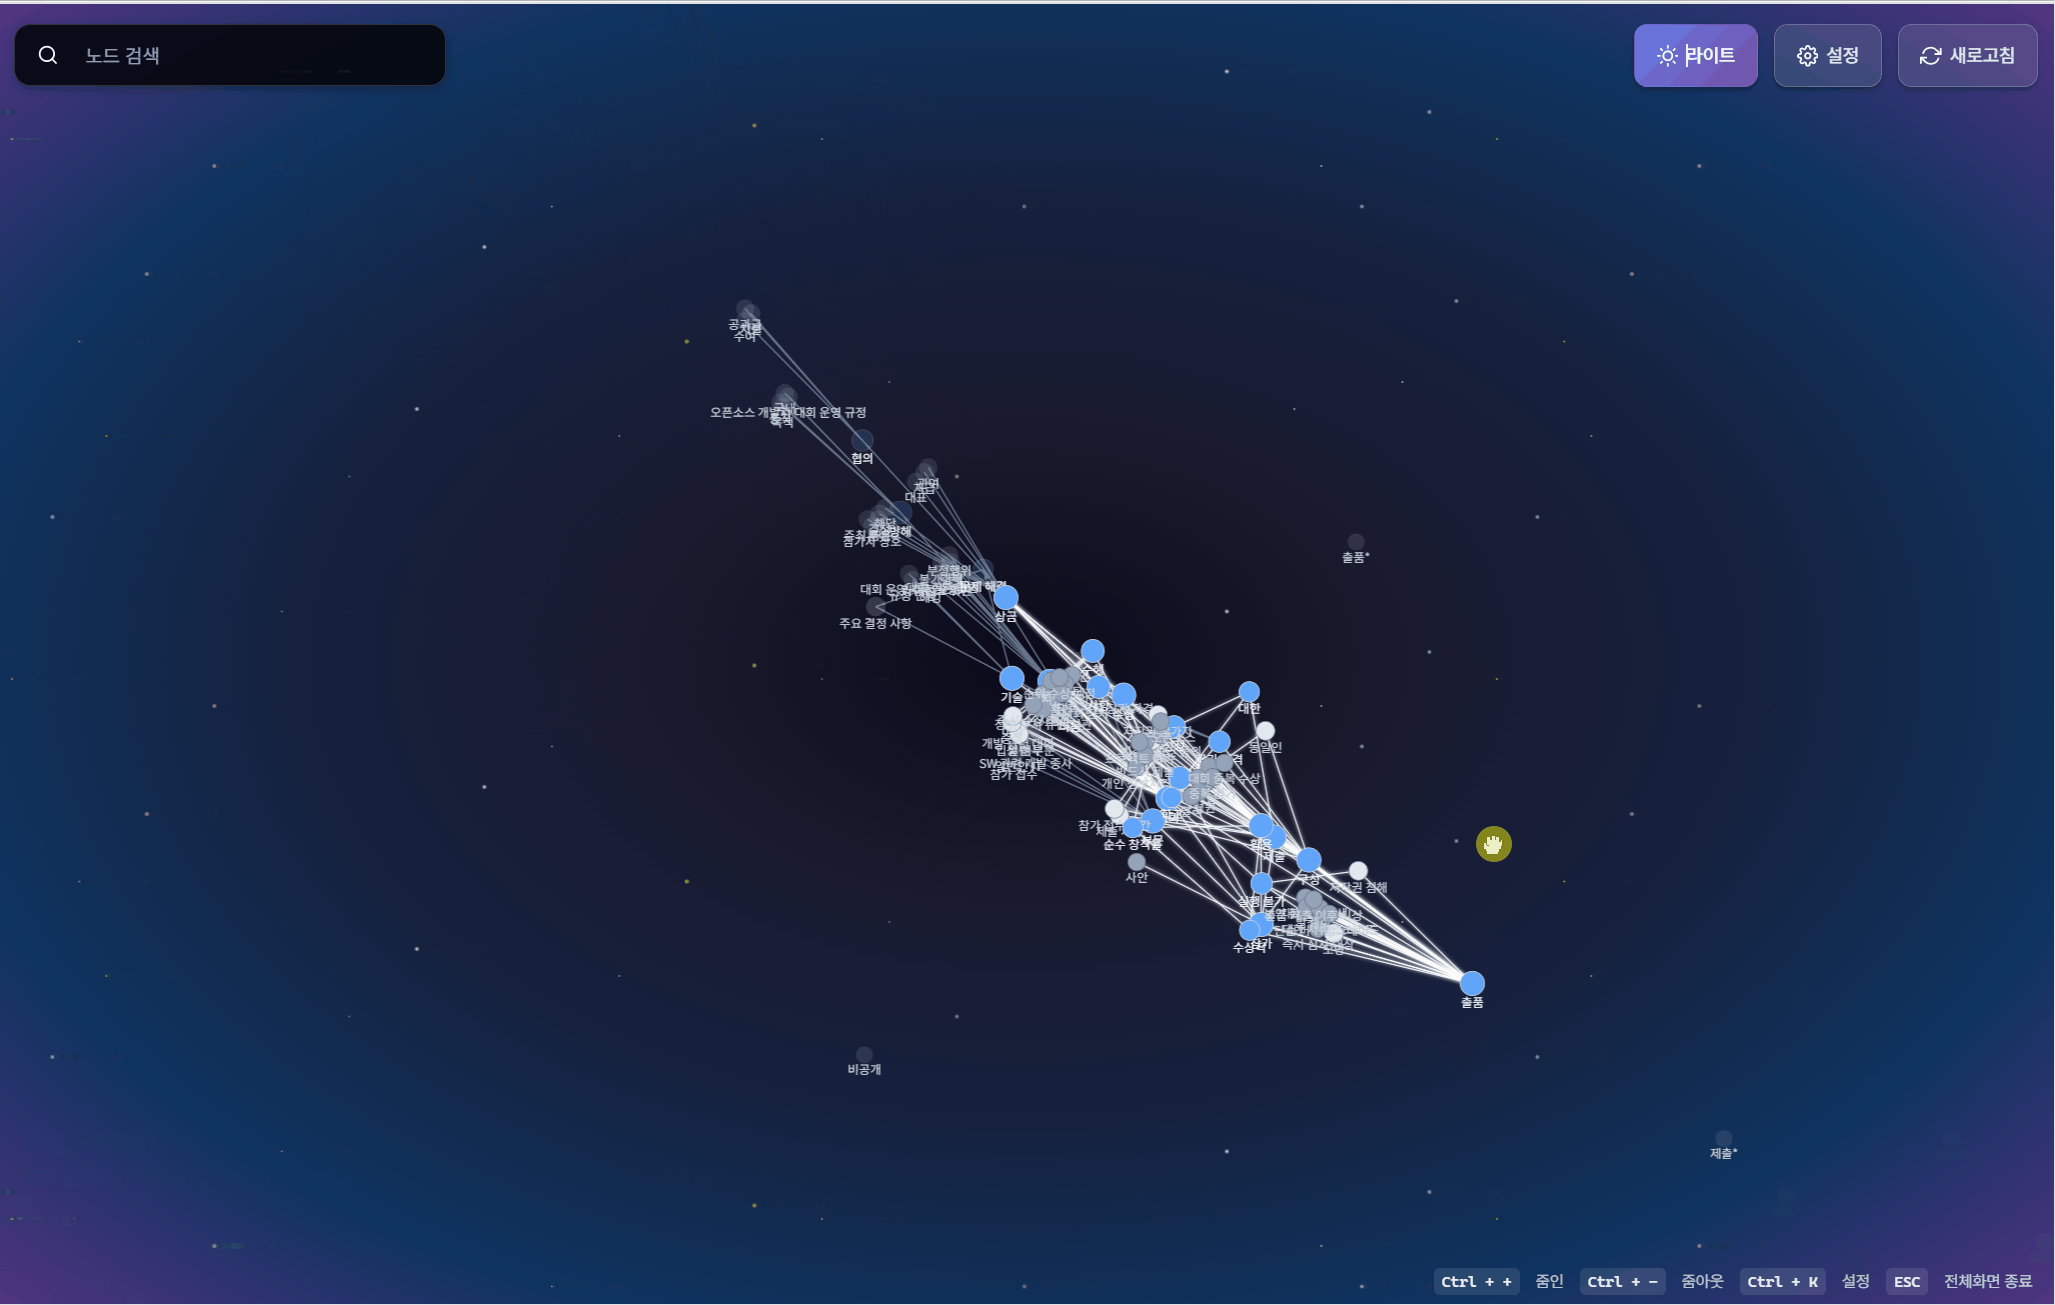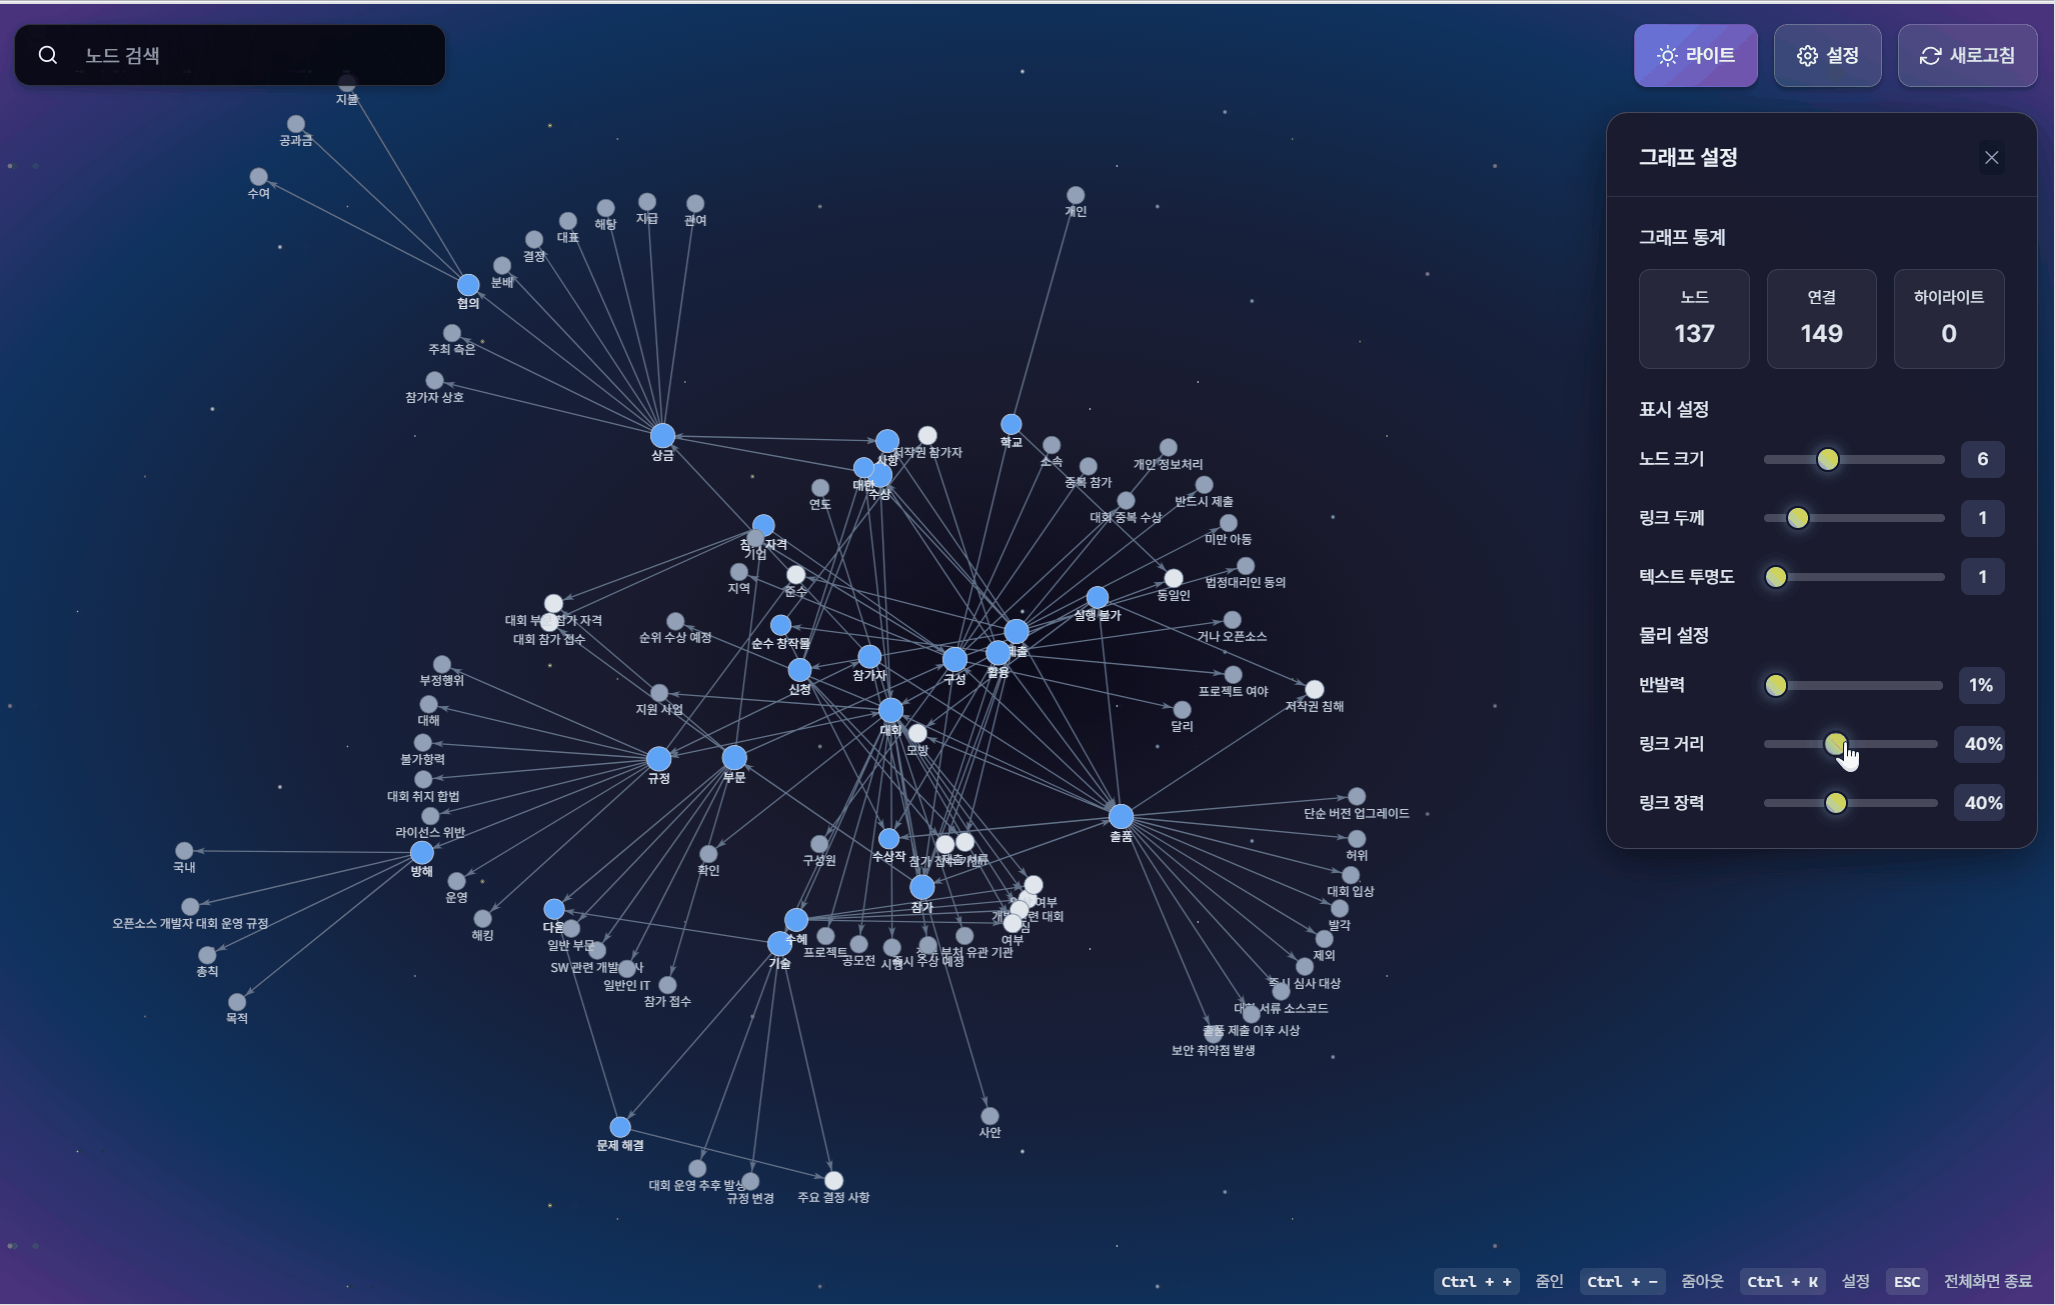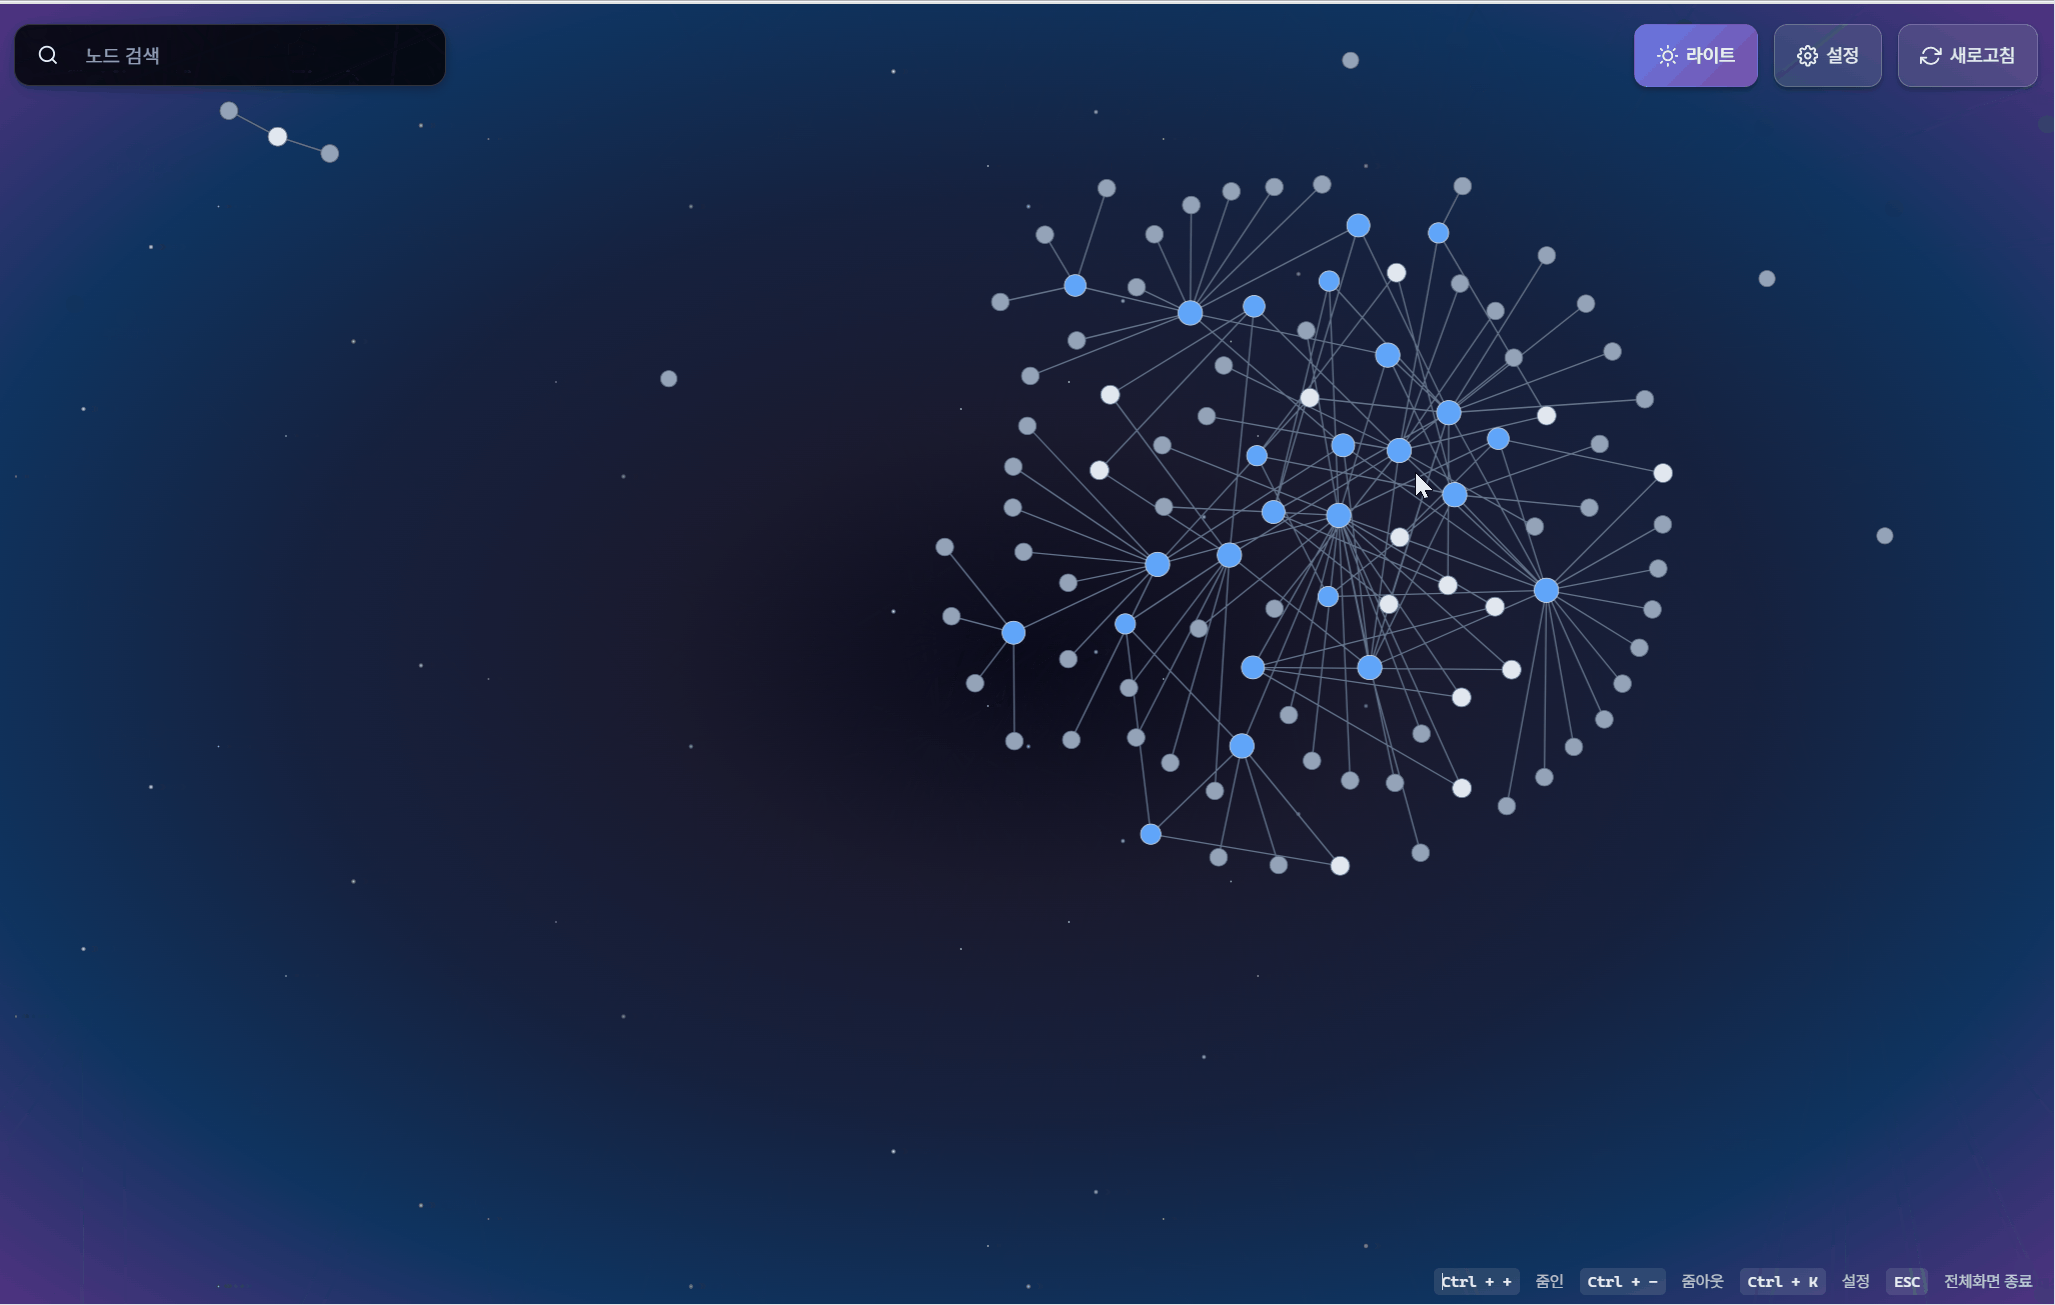
그래프 뷰 다크 모드
어두운 테마에서 그래프를 탐색하며 속성을 자유롭게 조절합니다.
|
라이선스는 저장소의 LICENSE 파일을 참고하세요.
자세한 제3자 오픈소스 사용 및 라이선스 표기는 THIRD_PARTY_LICENSES.md 파일을 참고하세요.
BrainTrace: GraphRAG-based on-device knowledge management system for secure and efficient document analysis
See the code지식 그래프를 활용한 지식 관리 시스템
Brain Trace System (BrainT)는 사용자가 업로드한 PDF, TXT, DOCX, Markdown 문서에서 핵심 개념과 개념 간의 관계를 자동으로 추출하고, 이를 지식 그래프 형태로 저장하여 활용하는 시스템입니다. 문서 내용을 단순히 저장하는 것을 넘어, 개념 단위로 구조화하여 탐색하고 활용할 수 있도록 돕습니다.
사용자가 질문을 입력하면, 시스템은 지식 그래프에서 관련된 개념들을 중심으로 의미 있는 노드들을 탐색하고, 필요 시 문서 내 해당 개념이 포함된 부분(청크)을 함께 가져와, 문서 기반의 답변을 제공합니다. 이때, 답변은 단순한 키워드 검색이 아닌, 그래프 구조를 따라 의미를 이해하고 연결하는 방식으로 생성됩니다. 또한, 기능을 로컬 또는 클라우드의 구동 환경을 선택하여 실행할 수 있으며, 외부 서버와의 연결 없이도 작동하므로 보안에 민감한 환경에서도 사용할 수 있습니다.
문서를 계속 추가할수록 그래프는 더욱 정교해지고, 검색과 탐색의 깊이와 정확성도 함께 향상됩니다. 흩어져 있던 정보들이 유기적으로 연결되며, 지식은 단순히 쌓이는 것을 넘어 구조화되고 유의미하게 진화하는 형태로 재탄생합니다.
BrainTrace는 다양한 유형의 학습 자료를 다음의 다섯 단계로 지식 그래프로 변환합니다.
텍스트 추출: PDF, 텍스트 파일, 메모, Markdown, DOCX 등의 소스에서 텍스트를 추출합니다.
토큰화: 추출된 텍스트를 의미 있는 단위(문장, 명사구 등)로 분할합니다.
로직:
청킹: 주제별로 유사한 문장들을 묶어 전체 텍스트를 1000~2000자 사이의 청크로 분할합니다. 지식 그래프의 골격을 생성합니다.
노드 및 엣지 생성: 각 청크에서 개념(노드)과 관계(엣지)를 추출하고 청킹 과정에서 생성한 지식그래프와 연결합니다.
그래프 병합: 모든 청크에서 노드/엣지를 통합된 지식 그래프로 병합합니다.
청킹 함수는 재귀적으로 호출되며 다음 동작을 반복합니다.
명사구 추출: (depth 0에서만 수행) 텍스트를 문장 단위로 분할하고 명사구를 추출합니다.
LDA 모듈을 통한 주제 벡터 변환 & 유사도 계산: (depth 0에서만 수행) 각 문장을 주제 벡터로 변환하고 벡터간의 내적값을 계산하여 행렬로 저장합니다.
Grouping: 유사도를 기준으로 각 문장을 묶어 청크를 구성합니다.
각 청크에서 노드 및 엣지 생성: 각 청크에서 tf-idf 키워드를 추출하고 노드와 엣지를 생성합니다.
지식 그래프에 대한 더 자세한 설명은 KNOWLEDGE_GRAPH.md에서 확인할 수 있습니다.
BrainTrace의 Q&A는 질문 → 임베딩 검색 → 그래프 DB 조회 → LLM 답변 생성 → 참조 노드/출처/정확도 계산 → 출처보기 순으로 처리됩니다.
질문 입력
질문 임베딩 & 유사 노드 검색(Qdrant, Q 계산)
Q는 질문과 검색된 노드들의 평균 유사도로, 정확도 계산에 사용됩니다.그래프 DB 조회 (빠른 탐색 / 딥서치)
use_deep_search에 따라 Neo4j 쿼리 경로가 달라집니다.스키마 텍스트 구성 (LLM 입력용 컨텍스트)
original_sentences 기반으로 정리됩니다.LLM 답변 생성
참조 노드 선정 (답변 임베딩 기반) + 답변에 붙이기
0.7입니다.정확도 계산 (Q/S/C 가중합)
S는 답변과 Neo4j 노드 description/original_sentences의 코사인 유사도입니다.C는 **커버리지(Coverage)**로, 답변이 실제로 LLM에 제공된 스키마 컨텍스트 안의 노드를 얼마나 반영했는지 보는 지표입니다.원본 소스/문장(근거) 구성
referenced_nodes에 대해 source_id 목록 + 원문을 구성합니다.original_sentences**를 기반으로 합니다.답변 저장 & 응답 구조
BrainTrace는 지식 그래프를 생성할 때 두 가지 로직을 고려했습니다.
알고리즘 기반(수동 청킹)
위의 “지식 그래프 생성 파이프라인”에서 설명한 방식입니다. LLM 없이 manual_chunking_sentences로 문장을 청킹하고, 알고리즘적으로 노드/엣지를 생성합니다.
LLM 기반(OpenAI/Ollama)
OpenAI/Ollama가 원문에서 노드/엣지를 추출하고, description을 추가로 생성합니다. (description은 노드를 한 문장으로 요약한 설명입니다.)
이후 description과 원문 문장 임베딩 유사도를 비교해 original_sentences를 산출합니다.
|
새 프로젝트 생성
프로젝트 이름과 환경을 선택하여 새 프로젝트를 시작할 수 있습니다.
|
업로드 시 그래프 생성
파일을 업로드하면 자동으로 노드와 엣지가 생성되어 그래프에 반영됩니다.
|
|
소스 하이라이팅
원하는 소스를 클릭하여 내용을 확인하고 하이라이팅할 수 있습니다.
|
Q&A 후 참조된 노드
답변에 사용된 노드를 그래프 뷰에서 확인할 수 있습니다.
|
|
출처 보기
답변에 사용된 노드가 어떤 소스를 참고했는지 확인합니다.
|
소스 노드 보기
특정 소스가 생성한 노드를 그래프 뷰에서 확인합니다.
|
|
메모 작성 및 소스로 추가
메모를 작성하고 소스로 변환하여 그래프에 반영할 수 있습니다.
|
LLM 모델 및 탐색 종류 선택
원하는 LLM 모델을 선택하고, 깊은 탐색 또는 빠른 탐색 중 하나를 진행할 수 있습니다.
|
|
소스 삭제
특정 소스를 삭제하면 해당 소스로 생성된 노드도 함께 삭제됩니다.
|
탐색 기능
파일 내용이나 키워드로 유사한 소스를 찾습니다.
|
|
그래프 뷰 라이트 모드 노드 검색 및 노드 속성 확인
노드 검색으로 원하는 노드로 카메라를 이동하고, 노드 호버 시 출처 및 원문을 확인할 수 있습니다.
|
그래프 뷰 다크 모드
어두운 테마에서 그래프를 탐색하며 속성을 자유롭게 조절합니다.
|
라이선스는 저장소의 LICENSE 파일을 참고하세요.
자세한 제3자 오픈소스 사용 및 라이선스 표기는 THIRD_PARTY_LICENSES.md 파일을 참고하세요.



