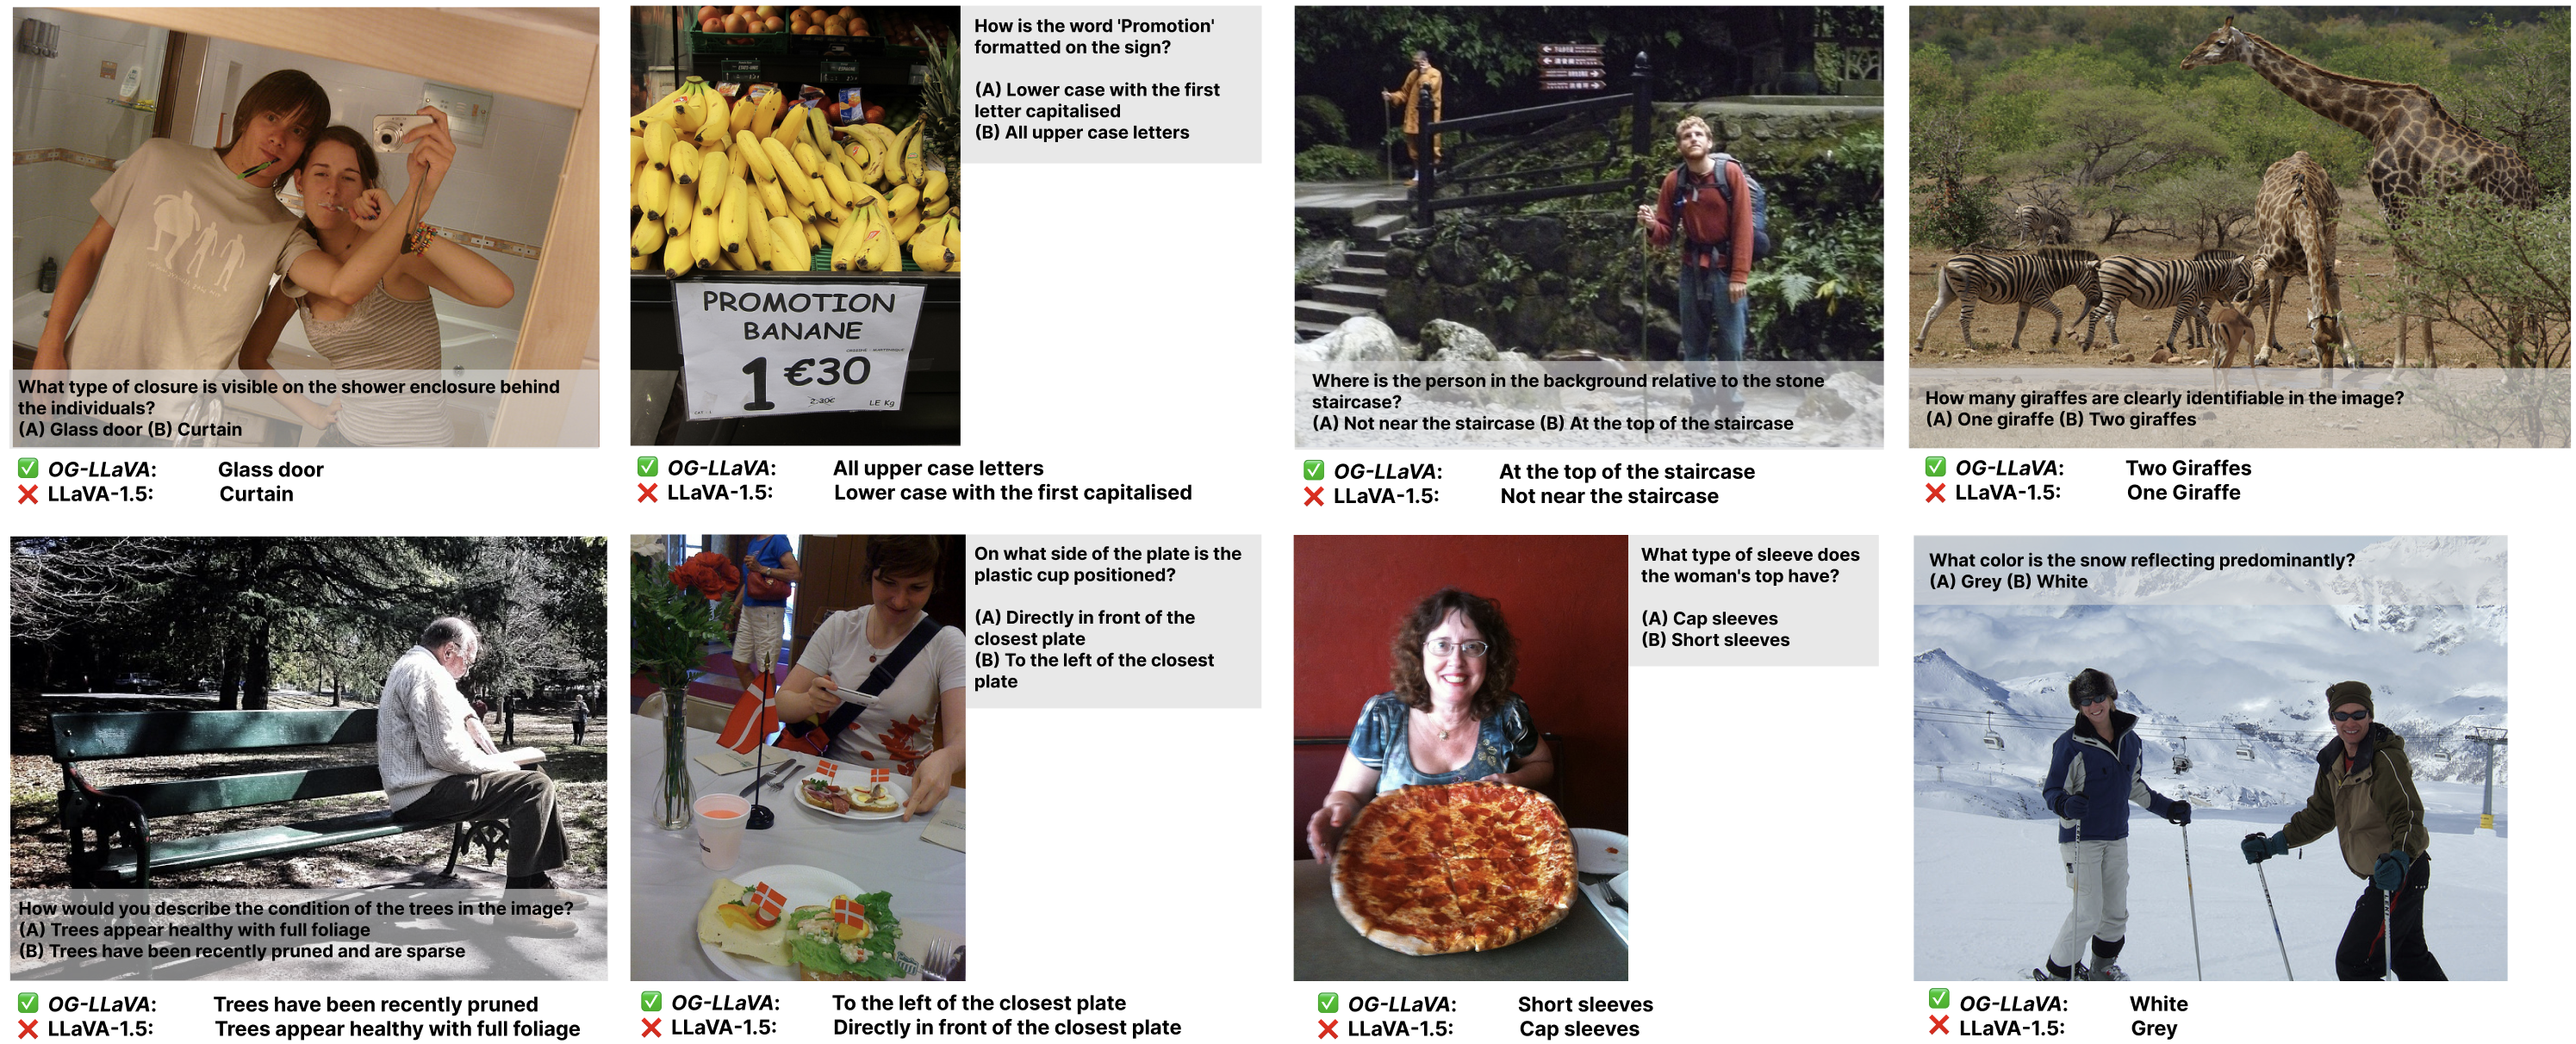
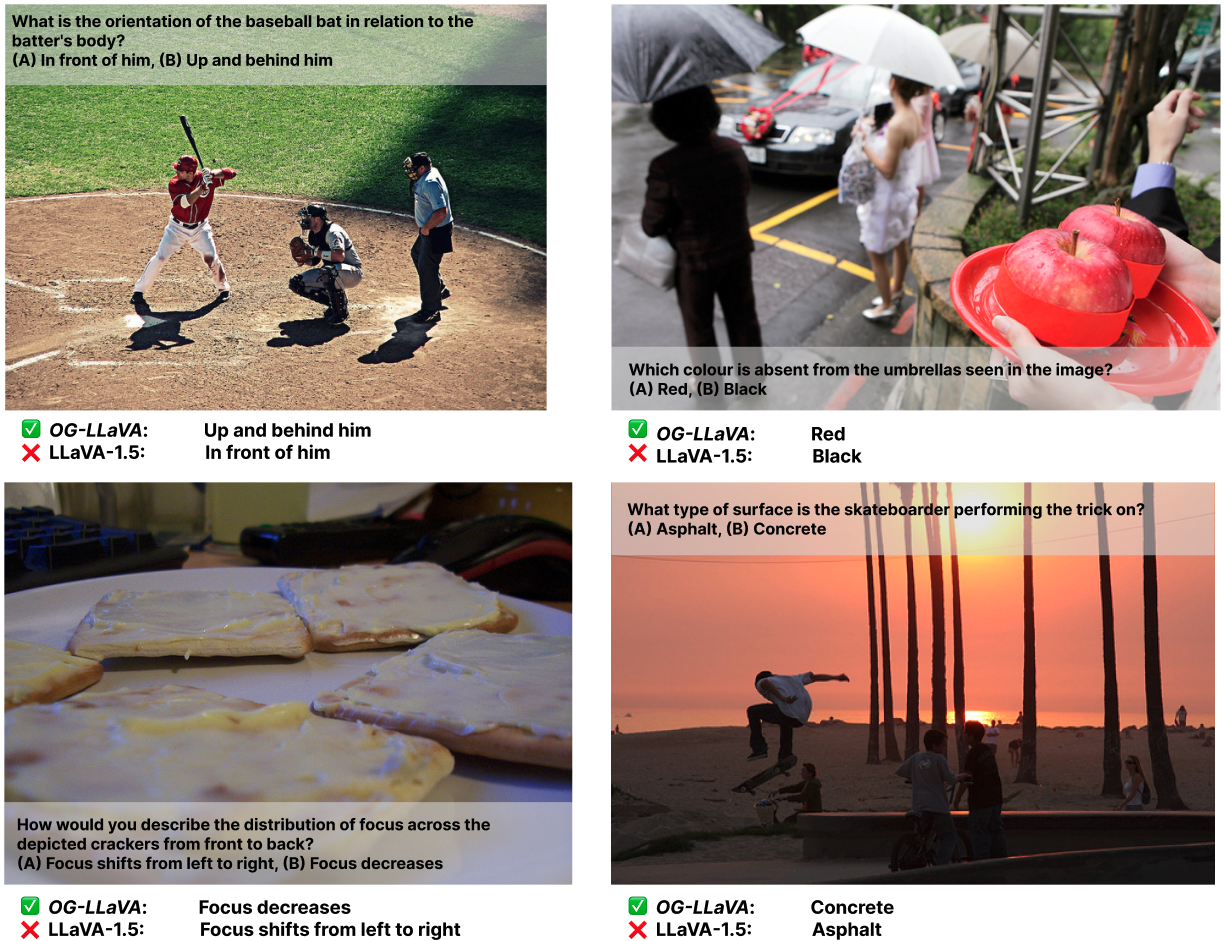
Object-Guided Visual Tokens: Eliciting Compositional Reasoning in Multimodal Language Models
Jupyter Notebook
2
27 commits
updated Dec 1, 2025
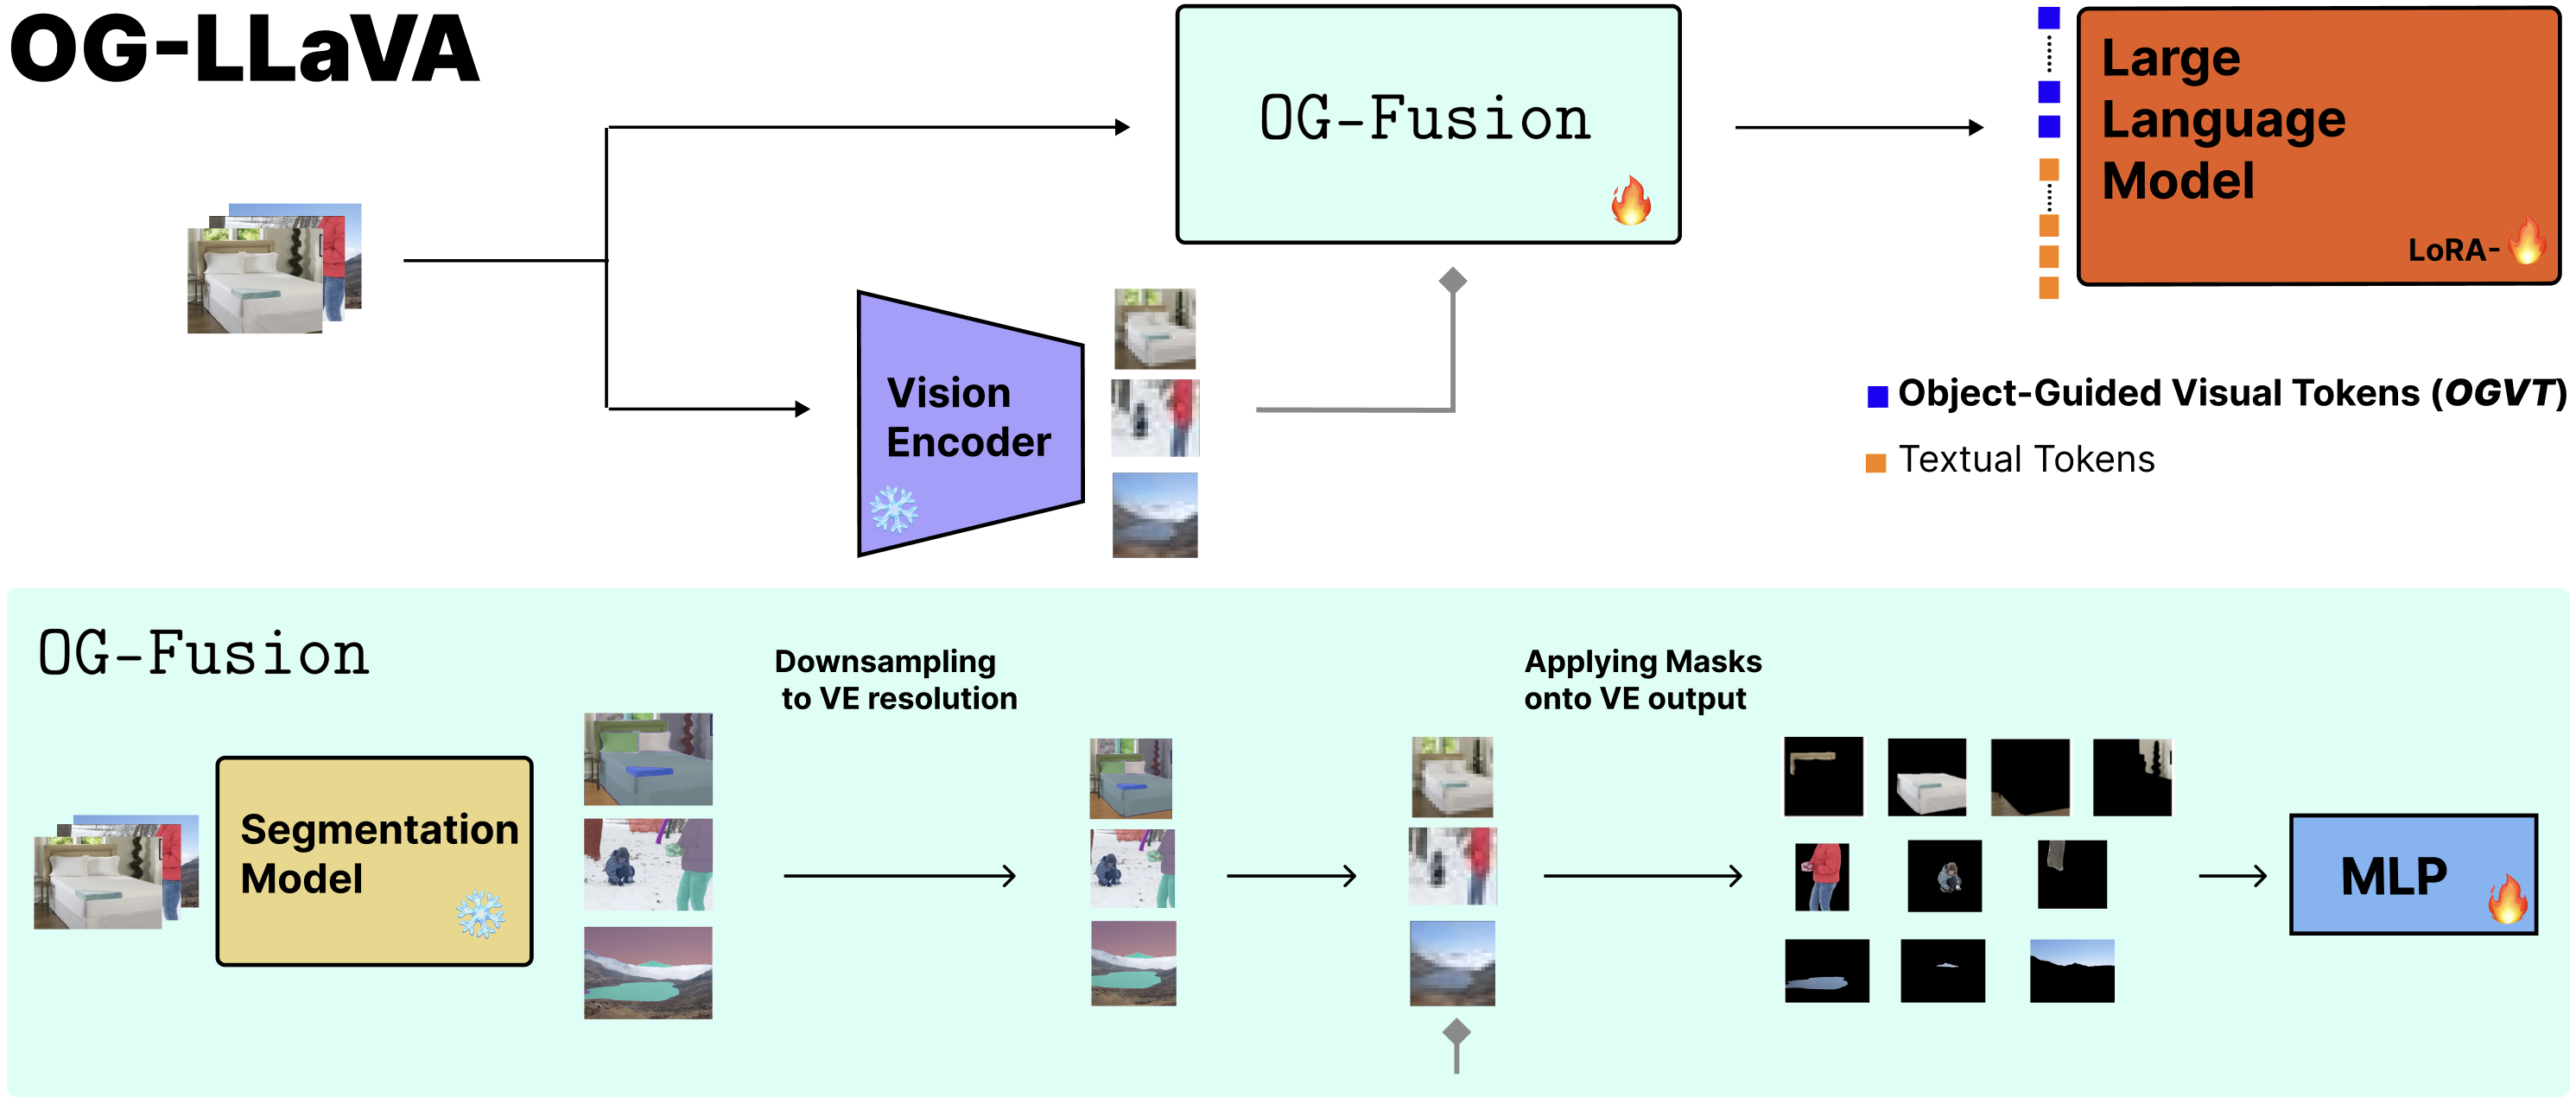
We extract visual features from the input image through a Vision Encoder.
Concurrently, we pass the input image through OG-Fusion. Here we:
The OGVT are then given as input to a Large Language Model together with Textual Tokens to produce an output.
The ❄️ (snowflake) and 🔥 (fire) represent modules whose parameters are kept frozen or turned on.
LoRA emphasizes that not all parameters of the LLM are unfrozen, only the LoRA layers.
conda create -n ogllava python=3.10 -y
conda activate ogllava
pip install -e .
We employ a local fork of lmms_eval to ensure a correct evaluation of our models. You can run all our benchmarks following those guidelines. Read more at lmms_eval/README.md or on the original lmms_eval repository.
Traing scripts are in scripts/train. Down below is an example of a captioning (pretraining) and a visual instruction tuning (finetune) script.
# First job
echo "Starting pretraining job..."
CAP_EPOCHS=1
SAM2_MASKING_TOKEN=True
CUSTOM_ROTARY_EMBEDDING=False

echo "Pretraining initialized with SAM2_MASKING_TOKEN=$SAM2_MASKING_TOKEN and CUSTOM_ROTARY_EMBEDDING=$CUSTOM_ROTARY_EMBEDDING"

## Choose Model Name
MODEL_NAME="Meta-Llama-3_1-8B-Instruct"
MODEL_DIR="<path_to_directory>/${MODEL_NAME}"
# MODEL_NAME="meta-llama--Llama-3.2-1B-Instruct"
# MODEL_DIR="<path_to_directory>${MODEL_NAME}"
# MODEL_NAME="meta-llama--Llama-3.2-3B-Instruct"
# MODEL_DIR="<path_to_directory>${MODEL_NAME}"

#standard llava pretraining data
DATA_PATH="<path_to_directory>/blip_laion_cc_sbu_558k.json"

IMG_DIR='None'
FILE_NAME_CAP=$(echo "${DATA_PATH##*/}" | cut -d'_' -f1,2)

echo DATAFILE_NAME=$FILE_NAME_CAP

VIS_TOWER="<path_to_directory>/openai/clip-vit-large-patch14-336"
VIS_TOWER_NAME=$(echo "$VIS_TOWER" | awk -F'/' '{print $(NF-1)"-"$NF}')

echo VIS_TOWER_NAME=$VIS_TOWER_NAME


BASE_RUN_NAME="$MODEL_NAME-$VIS_TOWER_NAME-$FILE_NAME_CAP-$CAP_EPOCHS-EPOCHS"
BASE_SAVE_DIR="<path_to_save_directory>/${BASE_RUN_NAME}"


mkdir -p $BASE_SAVE_DIR

CUDA_LAUNCH_BLOCKING=1
ACCELERATE_CPU_AFFINITY=1 torchrun --nproc_per_node="${NUM_GPUS}" --nnodes="${NNODES}" --node_rank="${RANK}" --master_addr="${ADDR}" --master_port="${PORT}" \
    llava/train/train_mem.py \
    --deepspeed scripts/zero3.json \
    --model_name_or_path $MODEL_DIR \
    --version llama3 \
    --data_path $DATA_PATH \
    --image_folder $IMG_DIR \
    --vision_tower $VIS_TOWER \
    --mm_projector_type mlp2x_gelu \
    --tune_mm_mlp_adapter True \
    --mm_vision_select_layer -2 \
    --mm_use_im_start_end False \
    --mm_use_im_patch_token False \
    --bf16 True \
    --output_dir $BASE_SAVE_DIR \
    --num_train_epochs $CAP_EPOCHS \
    --per_device_train_batch_size 8 \
    --per_device_eval_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --evaluation_strategy "no" \
    --save_strategy "steps" \
    --save_steps 24000 \
    --save_total_limit 1 \
    --learning_rate 1e-3 \
    --weight_decay 0. \
    --warmup_ratio 0.03 \
    --lr_scheduler_type "cosine" \
    --logging_steps 1 \
    --tf32 True \
    --model_max_length 2048 \
    --gradient_checkpointing True \
    --dataloader_num_workers 1 \
    --lazy_preprocess True \
    --report_to none \
    --sam2_masking_token $SAM2_MASKING_TOKEN \
    --custom_rotary_embedding $CUSTOM_ROTARY_EMBEDDING \
    --overwrite_output_dir 2>&1 | tee $BASE_SAVE_DIR/out
# Second job
echo "Starting finetuning job..."
SFT_EPOCHS=1
SAM2_MASKING_TOKEN=True
CUSTOM_ROTARY_EMBEDDING=False

echo "SFT initialized with SAM2_MASKING_TOKEN=$SAM2_MASKING_TOKEN and CUSTOM_ROTARY_EMBEDDING=$CUSTOM_ROTARY_EMBEDDING"

MODEL_NAME="Meta-Llama-3_1-8B-Instruct"
MODEL_DIR="<path_to_directory>/${MODEL_NAME}"
# MODEL_NAME="meta-llama--Llama-3.2-1B-Instruct"
# MODEL_DIR="<path_to_directory>${MODEL_NAME}"
# MODEL_NAME="meta-llama--Llama-3.2-3B-Instruct"
# MODEL_DIR="<path_to_directory>${MODEL_NAME}"

DATA_PATH_SFT="<path_to_directory>/llava_mix665k_format_adjusted.json"
IMG_DIR='None'

FILE_NAME_SFT=$(echo "${DATA_PATH_SFT##*/}" | cut -d'_' -f1,2)

echo DATAFILE_NAME=$FILE_NAME_SFT

VIS_TOWER="<path_to_directory>/openai/clip-vit-large-patch14-336"
VIS_TOWER_NAME=$(echo "$VIS_TOWER" | awk -F'/' '{print $(NF-1)"-"$NF}')

echo VIS_TOWER_NAME=$VIS_TOWER_NAME

SFT_RUN_NAME="$MODEL_NAME-$VIS_TOWER_NAME-$FILE_NAME_CAP-$FILE_NAME_SFT-lora-$SFT_EPOCHS-EPOCHS"

echo SFT_RUN_NAME=$SFT_RUN_NAME

PROJECTOR=${BASE_SAVE_DIR}/mm_projector.bin
MASK_TOKEN=${BASE_SAVE_DIR}/mm_bom_mask_token.bin
POS_ENCODING=${BASE_SAVE_DIR}/mm_masks_pos_encoding.bin

SAVE_DIR="<path_to_save_directory>/${SFT_RUN_NAME}"


mkdir -p $SAVE_DIR

CUDA_LAUNCH_BLOCKING=1
ACCELERATE_CPU_AFFINITY=1 torchrun --nproc_per_node="${NUM_GPUS}" --nnodes="${NNODES}" --node_rank="${RANK}" --master_addr="${ADDR}" --master_port="${PORT}" \
    llava/train/train_mem.py \
    --deepspeed scripts/zero3.json \
    --lora_enable True --lora_r 128 --lora_alpha 256 --mm_projector_lr 1e-4 \
    --model_name_or_path $MODEL_DIR \
    --version llama3 \
    --data_path $DATA_PATH_SFT \
    --image_folder $IMG_DIR \
    --vision_tower $VIS_TOWER \
    --pretrain_mm_mlp_adapter $PROJECTOR \
    --pretrain_mm_bom_mask_token $MASK_TOKEN \
    --pretrain_mm_masks_pos_encoding $POS_ENCODING \
    --mm_projector_type mlp2x_gelu \
    --mm_vision_select_layer -2 \
    --mm_use_im_start_end False \
    --mm_use_im_patch_token False \
    --image_aspect_ratio pad \
    --group_by_modality_length True \
    --bf16 True \
    --output_dir $SAVE_DIR \
    --num_train_epochs $SFT_EPOCHS \
    --per_device_train_batch_size 4 \
    --per_device_eval_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --evaluation_strategy "no" \
    --save_strategy "steps" \
    --save_steps 50000 \
    --save_total_limit 1 \
    --learning_rate 1e-4 \
    --weight_decay 0. \
    --warmup_ratio 0.06 \
    --max_grad_norm 0.3 \
    --lr_scheduler_type "cosine" \
    --logging_steps 1 \
    --tf32 True \
    --model_max_length 2048 \
    --gradient_checkpointing True \
    --dataloader_num_workers 1 \
    --lazy_preprocess True \
    --report_to none \
    --overwrite_output_dir \
    --sam2_masking_token $SAM2_MASKING_TOKEN \
    --custom_rotary_embedding $CUSTOM_ROTARY_EMBEDDING \
    2>&1 | tee $SAVE_DIR/out
We would like to thank the following works that inspired/enabled this project:
If you find our work useful for your research and applications, please consider citing us.
@inproceedings{nulli2025objectguided,
title={Object-Guided Visual Tokens: Eliciting Compositional Reasoning in Multimodal Language Models},
author={Matteo Nulli and Ivona Najdenkoska and Mohammad Mahdi Derakhshani and Yuki M Asano},
booktitle={EurIPS 2025 Workshop on Principles of Generative Modeling (PriGM)},
year={2025},
url={https://openreview.net/forum?id=yvY1T3hHEQ}
}