
A Comprehensive Survey on Long Context Language Modeling
See the codeREADME
A Comprehensive Survey on Long Context Language Modeling 💡


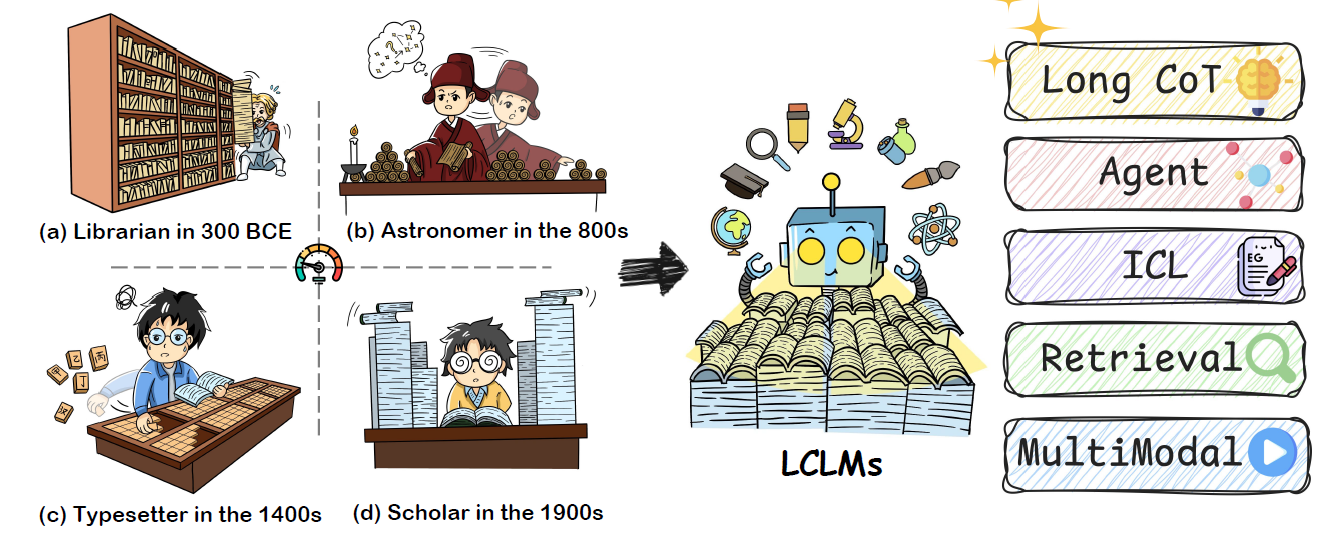
This repository provides a collection of papers and resources focused on Long Context Language Modeling. For a clear taxonomy and more insights about the methodology, you can refer to our survey: A Comprehensive Survey on Long Context Language Modeling with an overview shown below.
We appreciate any useful suggestions for improvement of this paper list or survey from peers and commit to regularly updating the repository.
If you would like to include your paper or any modifications in this survey and repository, please feel free to raise issues or send an email to dwzhu@pku.edu.cn, liujiaheng@nju.edu.cn, or liaohuanxuan2023@ia.ac.cn. We sincerely appreciate your collaboration!
We would like to extend our sincere gratitude to Awesome-LLM-Long-Context-Modeling for providing valuable reference to support the expansion of this project and the development of the comprehensive scholarly survey.
We would also like to mention Thus Spake Long-Context Large Language Model (GitHub), a concurrent survey that details the development history of long-context LLMs. They've created a video with Thus Spake Zarathustra symphony to introduce LCLM-related work.
If you find our survey useful for your research, please consider citing the following paper:
@article{liu2025comprehensive,
  title={A Comprehensive Survey on Long Context Language Modeling},
  author={Liu, Jiaheng and Zhu, Dawei and Bai, Zhiqi and He, Yancheng and Liao, Huanxuan and Que, Haoran and Wang, Zekun and Zhang, Chenchen and Zhang, Ge and Zhang, Jiebin and others},
  journal={arXiv preprint arXiv:2503.17407},
  year={2025}
}
Updates
- [2026.08.17] Sync recent long-context papers from Awesome-LLM-Long-Context-Modeling (sparse/hybrid attention, KV cache, memory, long-horizon agents, adaptive thinking, long video, and serving) while preserving the existing taxonomy.
- [2026.05.19] Expand the paper list with remaining 2026 works and selected 2025 Q4 papers from Awesome-LLM-Long-Context-Modeling while preserving the existing taxonomy.
- [2026.05.19] Standardize README formatting and incorporate recent long-context modeling papers from Awesome-LLM-Long-Context-Modeling into the existing taxonomy.
- [2025.03.25] Our paper is finally out on arXiv.
- [2025.03.13] We have a good communication with the authors of concurrent work, and will promote work of both parties in the future.
- [2025.03.11] We release the first version of the survey on Long Context Language Modeling [lclm-survey.pdf] and open-source our repo.
Table of Contents
- A Comprehensive Survey on Long Context Language Modeling 💡
Paper List
Data
Pretraining
-
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, Peter J. Liu. J. Mach. Learn. Res. 2020
-
Scaling Language Models: Methods, Analysis {&} Insights from Training Gopher. Jack W. Rae, Sebastian Borgeaud, Trevor Cai, Katie Millican, Jordan Hoffmann, H. Francis Song, John Aslanides, Sarah Henderson, Roman Ring, Susannah Young, Eliza Rutherford, Tom Hennigan, Jacob Menick, Albin Cassirer, Richard Powell, George van den Driessche, Lisa Anne Hendricks, Maribeth Rauh, Po{-}Sen Huang, Amelia Glaese, Johannes Welbl, Sumanth Dathathri, Saffron Huang, Jonathan Uesato, John Mellor, Irina Higgins, Antonia Creswell, Nat McAleese, Amy Wu, Erich Elsen, Siddhant M. Jayakumar, Elena Buchatskaya, David Budden, Esme Sutherland, Karen Simonyan, Michela Paganini, Laurent Sifre, Lena Martens, Xiang Lorraine Li, Adhiguna Kuncoro, Aida Nematzadeh, Elena Gribovskaya, Domenic Donato, Angeliki Lazaridou, Arthur Mensch, Jean{-}Baptiste Lespiau, Maria Tsimpoukelli, Nikolai Grigorev, Doug Fritz, Thibault Sottiaux, Mantas Pajarskas, Toby Pohlen, Zhitao Gong, Daniel Toyama, Cyprien de Masson d'Autume, Yujia Li, Tayfun Terzi, Vladimir Mikulik, Igor Babuschkin, Aidan Clark, Diego de Las Casas, Aurelia Guy, Chris Jones, James Bradbury, Matthew J. Johnson, Blake A. Hechtman, Laura Weidinger, Iason Gabriel, William Isaac, Edward Lockhart, Simon Osindero, Laura Rimell, Chris Dyer, Oriol Vinyals, Kareem Ayoub, Jeff Stanway, Lorrayne Bennett, Demis Hassabis, Koray Kavukcuoglu, Geoffrey Irving. Arxiv 2021
-
Structured Packing in LLM Training Improves Long Context Utilization. Konrad Staniszewski, Szymon Tworkowski, Sebastian Jaszczur, Henryk Michalewski, Łukasz Kuciński, Piotr Miłoś. Arxiv 2024.
-
SemDeDup: Data-efficient learning at web-scale through semantic deduplication. Amro Abbas, Kushal Tirumala, Daniel Simig, Surya Ganguli, Ari S. Morcos. Arxiv 2023
-
{SlimPajama: A 627B token cleaned and deduplicated version of RedPajama}. Daria Soboleva, Faisal Al-Khateeb, Robert Myers, Jacob R Steeves, Joel Hestness, Nolan Dey. Arxiv 2023
-
In-Context Pretraining: Language Modeling Beyond Document Boundaries. Weijia Shi, Sewon Min, Maria Lomeli, Chunting Zhou, Margaret Li, Xi Victoria Lin, Noah A. Smith, Luke Zettlemoyer, Wen-tau Yih, Mike Lewis. ICLR 2024 Spotlight.
-
Data Mixing Laws: Optimizing Data Mixtures by Predicting Language Modeling Performance. Jiasheng Ye, Peiju Liu, Tianxiang Sun, Yunhua Zhou, Jun Zhan, Xipeng Qiu. Arxiv 2024
-
Long Context is Not Long at All: A Prospector of Long-Dependency Data for Large Language Models. Longze Chen, Ziqiang Liu, Wanwei He, Yunshui Li, Run Luo, Min Yang. Arxiv 2024.
-
{L}ong{W}anjuan: Towards Systematic Measurement for Long Text Quality. Xiaoran Liu, Kai Lv, Qipeng Guo, Hang Yan, Conghui He, Xipeng Qiu, Dahua Lin. ACL 2024
-
Map-neo: Highly capable and transparent bilingual large language model series. Ge Zhang, Scott Qu, Jiaheng Liu, Chenchen Zhang, Chenghua Lin, Chou Leuang Yu, Danny Pan, Esther Cheng, Jie Liu, Qunshu Lin, others. Arxiv 2024
-
Quest: Query-centric Data Synthesis Approach for Long-context Scaling of Large Language Model. Chaochen Gao, Xing Wu, Qi Fu, Songlin Hu. Arxiv 2024.
-
Data Engineering for Scaling Language Models to 128K Context. Yao Fu, Rameswar Panda, Xinyao Niu, Xiang Yue, Hannaneh Hajishirzi, Yoon Kim, Hao Peng. Arxiv 2024.
-
RegMix: Data Mixture as Regression for Language Model Pre-training. Qian Liu, Xiaosen Zheng, Niklas Muennighoff, Guangtao Zeng, Longxu Dou, Tianyu Pang, Jing Jiang, Min Lin. Arxiv 2024
-
How to Train Long-Context Language Models (Effectively). Tianyu Gao, Alexander Wettig, Howard Yen, Danqi Chen. Arxiv 2024.
-
LongAttn: Selecting Long-context Training Data via Token-level Attention. Longyun Wu, Dawei Zhu, Guangxiang Zhao, Zhuocheng Yu, Junfeng Ran, Xiangyu Wong, Lin Sun, Sujian Li. Arxiv 2025.
-
Untie the Knots: An Efficient Data Augmentation Strategy for Long-Context Pre-Training in Language Models. Junfeng Tian, Da Zheng, Yang Cheng, Rui Wang, Colin Zhang, Debing Zhang. Arxiv 2024.


Posttraining
-
The {N}arrative{QA} Reading Comprehension Challenge. Tom{'a}{\v{s}} Ko{\v{c}}isk{'y}, Jonathan Schwarz, Phil Blunsom, Chris Dyer, Karl Moritz Hermann, G{'a}bor Melis, Edward Grefenstette. ACL 2018
-
Training language models to follow instructions with human feedback. Long Ouyang, Jeff Wu, Xu Jiang, Diogo Almeida, Carroll L. Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke E. Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul Francis Christiano, Jan Leike, Ryan J. Lowe. Arxiv 2022
-
{SlimPajama: A 627B token cleaned and deduplicated version of RedPajama}. Daria Soboleva, Faisal Al-Khateeb, Robert Myers, Jacob R Steeves, Joel Hestness, Nolan Dey. Arxiv 2023
-
Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Rafael Rafailov, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D. Manning, Chelsea Finn. Arxiv 2023
-
WanJuan: A Comprehensive Multimodal Dataset for Advancing English and Chinese Large Models. Conghui He, Zhenjiang Jin, Chaoxi Xu, Jiantao Qiu, Bin Wang, Wei Li, Hang Yan, Jiaqi Wang, Da Lin. Arxiv 2023
-
{L}ong{W}anjuan: Towards Systematic Measurement for Long Text Quality. Xiaoran Liu, Kai Lv, Qipeng Guo, Hang Yan, Conghui He, Xipeng Qiu, Dahua Lin. ACL 2024
-
LOGO--Long cOntext aliGnment via efficient preference Optimization. Zecheng Tang, Zechen Sun, Juntao Li, Qiaoming Zhu, Min Zhang. Arxiv 2024
-
{L}ong{A}lign: A Recipe for Long Context Alignment of Large Language Models. Yushi Bai, Xin Lv, Jiajie Zhang, Yuze He, Ji Qi, Lei Hou, Jie Tang, Yuxiao Dong, Juanzi Li. ACL 2024
-
What are the Essential Factors in Crafting Effective Long Context Multi-Hop Instruction Datasets? Insights and Best Practices. Zhi Chen, Qiguang Chen, Libo Qin, Qipeng Guo, Haijun Lv, Yicheng Zou, Wanxiang Che, Hang Yan, Kai Chen, Dahua Lin. Arxiv 2024.
-
Weaver: Foundation Models for Creative Writing. Tiannan Wang, Jiamin Chen, Qingrui Jia, Shuai Wang, Ruoyu Fang, Huilin Wang, Zhaowei Gao, Chunzhao Xie, Chuou Xu, Jihong Dai, Yibin Liu, Jialong Wu, Shengwei Ding, Long Li, Zhiwei Huang, Xinle Deng, Teng Yu, Gangan Ma, Han Xiao, Zixin Chen, Danjun Xiang, Yunxia Wang, Yuanyuan Zhu, Yi Xiao, Jing Wang, Yiru Wang, Siran Ding, Jiayang Huang, Jiayi Xu, Yilihamu Tayier, Zhenyu Hu, Yuan Gao, Chengfeng Zheng, Yueshu Ye, Yihang Li, Lei Wan, Xinyue Jiang, Yujie Wang, Siyu Cheng, Zhule Song, Xiangru Tang, Xiaohua Xu, Ningyu Zhang, Huajun Chen, Yuchen Eleanor Jiang, Wangchunshu Zhou. Arxiv 2024
-
LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs. Yushi Bai, Jiajie Zhang, Xin Lv, Linzhi Zheng, Siqi Zhu, Lei Hou, Yuxiao Dong, Jie Tang, Juanzi Li. Arxiv 2024.
-
LongReward: Improving Long-context Large Language Models with AI Feedback. Jiajie Zhang, Zhongni Hou, Xin Lv, Shulin Cao, Zhenyu Hou, Yilin Niu, Lei Hou, Yuxiao Dong, Ling Feng, Juanzi Li. Arxiv 2024
-
ChatQA 2: Bridging the Gap to Proprietary LLMs in Long Context and RAG Capabilities. Peng Xu, Wei Ping, Xianchao Wu, Zihan Liu, Mohammad Shoeybi, Bryan Catanzaro. Arxiv 2024.
-
LongLoRA: Efficient Fine-tuning of Long-Context Large Language Models. Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han, Jiaya Jia. ICLR 2024 Oral.
-
{ORPO}: Monolithic Preference Optimization without Reference Model. Jiwoo Hong, Noah Lee, James Thorne. EMNLP 2024
-
Never Lost in the Middle: Mastering Long-Context Question Answering with Position-Agnostic Decompositional Training. Junqing He, Kunhao Pan, Xiaoqun Dong, Zhuoyang Song, LiuYiBo LiuYiBo, Qianguosun Qianguosun, Yuxin Liang, Hao Wang, Enming Zhang, Jiaxing Zhang. ACL 2024
-
Make Your {LLM} Fully Utilize the Context. Shengnan An, Zexiong Ma, Zeqi Lin, Nanning Zheng, Jian-Guang Lou, Weizhu Chen. NeurIPS 2024
-
LongDPO: Unlock Better Long-form Generation Abilities for LLMs via Critique-augmented Stepwise Information. Bowen Ping, Jiali Zeng, Fandong Meng, Shuo Wang, Jie Zhou, Shanghang Zhang. Arxiv 2025.
-
LongAttn: Selecting Long-context Training Data via Token-level Attention. Longyun Wu, Dawei Zhu, Guangxiang Zhao, Zhuocheng Yu, Junfeng Ran, Xiangyu Wong, Lin Sun, Sujian Li. Arxiv 2025.
-
LongFaith: Enhancing Long-Context Reasoning in LLMs with Faithful Synthetic Data. Cehao Yang, Xueyuan Lin, Chengjin Xu, Xuhui Jiang, Shengjie Ma, Aofan Liu, Hui Xiong, Jian Guo. Arxiv 2025.
-
In-Place Test-Time Training. Guhao Feng, Shengjie Luo, Kai Hua, Ge Zhang, Di He, Wenhao Huang, Tianle Cai. ICLR 2026 Oral.
-
Let's (not) just put things in Context: Test-Time Training for Long-Context LLMs. Rachit Bansal, Aston Zhang, Rishabh Tiwari, Lovish Madaan, Sai Surya Duvvuri, Devvrit Khatri, David Brandfonbrener, David Alvarez-Melis, Prajjwal Bhargava, Mihir Sanjay Kale, Samy Jelassi. Arxiv 2025.
-
End-to-End Test-Time Training for Long Context. Arnuv Tandon, Karan Dalal, Xinhao Li, Daniel Koceja, Marcel Rød, Sam Buchanan, Xiaolong Wang, Jure Leskovec, Sanmi Koyejo, Tatsunori Hashimoto, Carlos Guestrin, Jed McCaleb, Yejin Choi, Yu Sun. Arxiv 2025.
-
QwenLong-L1.5: Post-Training Recipe for Long-Context Reasoning and Memory Management. Weizhou Shen, Ziyi Yang, Chenliang Li, Zhiyuan Lu, Miao Peng, Huashan Sun, Yingcheng Shi, Shengyi Liao, Shaopeng Lai, Bo Zhang, Dayiheng Liu, Fei Huang, Jingren Zhou, Ming Yan. Arxiv 2025.
-
ACC: Compiling Agent Trajectories for Long-Context Training. Qisheng Su, Zhen Fang, Shiting Huang, Yu Zeng, Yiming Zhao, Kou Shi, Ziao Zhang, Lin Chen, Zehui Chen, Lijun Wu, Feng Zhao. Arxiv 2026.
-
OctoLong: Mid-Training On Cross-Repository Code Contexts Enhances Long-Context Modeling. Indraneil Paul, Falko Helm, Goran Glavaš, Iryna Gurevych. Arxiv 2026.
-
Learning What to Remember: Test-Time Training via Context Distillation. Zixuan Wang, Xingyu Dang, Rui-Jie Zhu, Zixin Wen, Hengyu Fu, Wenhao Chai, Jason D. Lee. Arxiv 2026.


Model
Position Embeddings
-
An Efficient Recipe for Long Context Extension via Middle-Focused Positional Encoding. Tong Wu, Yanpeng Zhao, Zilong Zheng. NeurIPS 2024.
-
PoSE: Efficient Context Window Extension of LLMs via Positional Skip-wise Training. Dawei Zhu,Nan Yang,Liang Wang,Yifan Song,Wenhao Wu,Furu Wei,Sujian Li. Arxiv 2023.
-
Contextual Position Encoding: Learning to Count What's Important. Olga Golovneva, Tianlu Wang, Jason Weston, Sainbayar Sukhbaatar. Arxiv 2024.
-
Why Does the Effective Context Length of LLMs Fall Short?. Chenxin An, Jun Zhang, Ming Zhong, Lei Li, Shansan Gong, Yao Luo, Jingjing Xu, Lingpeng Kong. Arxiv 2024.
-
HoPE: A Novel Positional Encoding Without Long-Term Decay for Enhanced Context Awareness and Extrapolation. Yuhan Chen, Ang Lv, Jian Luan, Bin Wang, Wei Liu. Arxiv 2024.
-
DAPE: Data-Adaptive Positional Encoding for Length Extrapolation. Chuanyang Zheng, Yihang Gao, Han Shi, Minbin Huang, Jingyao Li, Jing Xiong, Xiaozhe Ren, Michael Ng, Xin Jiang, Zhenguo Li, Yu Li. NeurIPS 2024.
-
Convolutional sequence to sequence learning. Jonas Gehring and Michael Auli and David Grangier and Denis Yarats and Yann N. Dauphin. Arxiv 2017
-
Self-attention with relative position representations. Peter Shaw and Jakob Uszkoreit and Ashish Vaswani. Arxiv 2018
-
Encoding word order in complex embeddings. Benyou Wang and Donghao Zhao and Christina Lioma and Qiuchi Li and Peng Zhang and Jakob Grue Simonsen. Arxiv 2020
-
Train short, test long: Attention with linear biases enables input length extrapolation. Ofir Press and Noah A. Smith and Mike Lewis. Arxiv 2022
-
Kerple: Kernelized relative positional embedding for length extrapolation. Ta-Chung Chi and Ting-Han Fan and Peter J. Ramadge and Alexander I. Rudnicky. Arxiv 2022
-
Dissecting transformer length extrapolation via the lens of receptive field analysis. Ta-Chung Chi and Ting-Han Fan and Alexander I. Rudnicky and Peter J. Ramadge. Arxiv 2023
-
A length-extrapolatable transformer. Yutao Sun and Li Dong and Barun Patra and Shuming Ma and Shaohan Huang and Alon Benhaim and Vishrav Chaudhary and Xia Song and Furu Wei. Arxiv 2022
-
Functional interpolation for relative positions improves long context transformers. Shanda Li and Chong You and Guru Guruganesh and Joshua Ainslie and Santiago Ontanon and Manzil Zaheer and Sumit Sanghai and Yiming Yang and Sanjiv Kumar and Srinadh Bhojanapalli. Arxiv 2024
-
Latent positional information is in the self-attention variance of transformer language models without positional embeddings. Latent Positional Information is in the Self-Attention Variance of Transformer Language Models Without Positional Embeddings. Arxiv 2023
-
Extending context window of large language models via positional interpolation. Shouyuan Chen and Sherman Wong and Liangjian Chen and Yuandong Tian. Arxiv 2023
-
Randomized positional encodings boost length generalization of transformers. Anian Ruoss and Grégoire Delétang and Tim Genewein and Jordi Grau-Moya and Róbert Csordás and Mehdi Bennani and Shane Legg and Joel Veness. Arxiv 2023
-
Yarn: Efficient context window extension of large language models. Bowen Peng and Jeffrey Quesnelle and Honglu Fan and Enrico Shippole. Arxiv 2023
-
Clex: Continuous length extrapolation for large language models. Guanzheng Chen and Xin Li and Zaiqiao Meng and Shangsong Liang and Lidong Bing. Arxiv 2024
-
Effective long-context scaling of foundation models. Wenhan Xiong and Jingyu Liu and Igor Molybog and Hejia Zhang and Prajjwal Bhargava and Rui Hou and Louis Martin and Rashi Rungta and Karthik Abinav Sankararaman and Barlas Oguz and Madian Khabsa and Han Fang and Yashar Mehdad and Sharan Narang and Kshitiz Malik and Angela Fan and Shruti Bhosale and Sergey Edunov and Mike Lewis and Sinong Wang and Hao Ma. Arxiv 2023
-
Giraffe: Adventures in expanding context lengths in llms. Arka Pal and Deep Karkhanis and Manley Roberts and Samuel Dooley and Arvind Sundararajan and Siddartha Naidu. Arxiv 2023
-
Resonance rope: Improving context length generalization of large language models. Suyuchen Wang and Ivan Kobyzev and Peng Lu and Mehdi Rezagholizadeh and Bang Liu. Arxiv 2024
-
Long context alignment with short instructions and synthesized positions. Wenhao Wu and Yizhong Wang and Yao Fu and Xiang Yue and Dawei Zhu and Sujian Li. Arxiv 2024
-
Two stones hit one bird: Bilevel positional encoding for better length extrapolation. Zhenyu He and Guhao Feng and Shengjie Luo and Kai Yang and Liwei Wang and Jingjing Xu and Zhi Zhang and Hongxia Yang and Di He. Arxiv 2024
-
Found in the middle: How language models use long contexts better via plug-and-play positional encoding. Zhenyu Zhang and Runjin Chen and Shiwei Liu and Zhewei Yao and Olatunji Ruwase and Beidi Chen and Xiaoxia Wu and Zhangyang Wang. Arxiv 2024
-
Llm maybe longlm: Self-extend llm context window without tuning. Hongye Jin and Xiaotian Han and Jingfeng Yang and Zhimeng Jiang and Zirui Liu and Chia-Yuan Chang and Huiyuan Chen and Xia Hu. Arxiv 2024
-
Longrope: Extending llm context window beyond 2 million tokens. Yiran Ding and Li Lyna Zhang and Chengruidong Zhang and Yuanyuan Xu and Ning Shang and Jiahang Xu and Fan Yang and Mao Yang. Arxiv 2024
-
The impact of positional encoding on length generalization in transformers. Amirhossein Kazemnejad and Inkit Padhi and Karthikeyan Natesan Ramamurthy and Payel Das and Siva Reddy. Arxiv 2024
-
Roformer: Enhanced transformer with rotary position embedding. Jianlin Su and Yu Lu and Shengfeng Pan and Ahmed Murtadha and Bo Wen and Yunfeng Liu. Arxiv 2023
-
Training-free long-context scaling of large language models. Chenxin An and Fei Huang and Jun Zhang and Shansan Gong and Xipeng Qiu and Chang Zhou and Lingpeng Kong. Arxiv 2024
-
PSC: Extending Context Window of Large Language Models via Phase Shift Calibration. Wenqiao Zhu and Chao Xu and Lulu Wang and Jun Wu. EMNLP 2024.
-
Attention Entropy is a Key Factor: An Analysis of Parallel Context Encoding with Full-attention-based Pre-trained Language Models. Zhisong Zhang, Yan Wang, Xinting Huang, Tianqing Fang, Hongming Zhang, Chenlong Deng, Shuaiyi Li, Dong Yu. Arxiv 2024.
-
DCIS: Efficient Length Extrapolation of LLMs via Divide-and-Conquer Scaling Factor Search. Lei Yang, Shaoyang Xu, Deyi Xiong. Arxiv 2024.
-
Adjoint sharding for very long context training of state space models. Xingzi Xu, Amir Tavanaei, Kavosh Asadi, Karim Bouyarmane. Arxiv 2025.
-
Information Entropy Invariance: Enhancing Length Extrapolation in Attention Mechanisms. Kewei Li, Yanwen Kong, Yiping Xu, Lan Huang, Ruochi Zhang, Fengfeng Zhou. Arxiv 2025.
-
LeMo: Enabling LEss Token Involvement for MOre Context Fine-tuning. Tuowei Wang, Xingyu Chen, Kun Li, Ting Cao, Ju Ren, Yaoxue Zhang. Arxiv 2025.
-
NExtLong: Toward Effective Long-Context Training without Long Documents. Chaochen Gao, Xing Wu, Zijia Lin, Debing Zhang, Songlin Hu. Arxiv 2025.
-
SEAL: Scaling to Emphasize Attention for Long-Context Retrieval. Changhun Lee, Jun-gyu Jin, Younghyun Cho, Eunhyeok Park. Arxiv 2025.
-
DINT Transformer. Yueyang Cang, Yuhang Liu, Xiaoteng Zhang, Erlu Zhao, Li Shi. Arxiv 2025.
-
Scalable-Softmax Is Superior for Attention. Ken M. Nakanishi. Arxiv 2025.
-
Rope to Nope and Back Again: A New Hybrid Attention Strategy. Bowen Yang, Bharat Venkitesh, Dwarak Talupuru, Hangyu Lin, David Cairuz, Phil Blunsom, Acyr Locatelli. Arxiv 2025.
-
A Training-Free Length Extrapolation Approach for LLMs: Greedy Attention Logit Interpolation (GALI). Yan Li, Tianyi Zhang, Zechuan Li, Soyeon Caren Han. Arxiv 2025.
-
LongReD: Mitigating Short-Text Degradation of Long-Context Large Language Models via Restoration Distillation. Zican Dong, Junyi Li, Jinhao Jiang, Mingyu Xu, Wayne Xin Zhao, Bingning Wang, Weipeng Chen. Arxiv 2025.
-
Unveiling Simplicities of Attention: Adaptive Long-Context Head Identification. Konstantin Donhauser, Charles Arnal, Mohammad Pezeshki, Vivien Cabannes, David Lopez-Paz, Kartik Ahuja. Arxiv 2025.
-
The Rotary Position Embedding May Cause Dimension Inefficiency in Attention Heads for Long-Distance Retrieval. Ting-Rui Chiang, Dani Yogatama. Arxiv 2025.
-
LongFaith: Enhancing Long-Context Reasoning in LLMs with Faithful Synthetic Data. Cehao Yang, Xueyuan Lin, Chengjin Xu, Xuhui Jiang, Shengjie Ma, Aofan Liu, Hui Xiong, Jian Guo. Arxiv 2025.
-
LongPO: Long Context Self-Evolution of Large Language Models through Short-to-Long Preference Optimization. Guanzheng Chen, Xin Li, Michael Qizhe Shieh, Lidong Bing. Arxiv 2025.
-
ParallelComp: Parallel Long-Context Compressor for Length Extrapolation. Jing Xiong, Jianghan Shen, Chuanyang Zheng, Zhongwei Wan, Chenyang Zhao, Chiwun Yang, Fanghua Ye, Hongxia Yang, Lingpeng Kong, Ngai Wong. Arxiv 2025.
-
Generalizing From Short to Long: Effective Data Synthesis for Long-Context Instruction Tuning. Wenhao Zhu, Pinzhen Chen, Hanxu Hu, Shujian Huang, Fei Yuan, Jiajun Chen, Alexandra Birch. Arxiv 2025.
-
LongAttn: Selecting Long-context Training Data via Token-level Attention. Longyun Wu, Dawei Zhu, Guangxiang Zhao, Zhuocheng Yu, Junfeng Ran, Xiangyu Wong, Lin Sun, Sujian Li. Arxiv 2025.
-
WildLong: Synthesizing Realistic Long-Context Instruction Data at Scale. Jiaxi Li, Xingxing Zhang, Xun Wang, Xiaolong Huang, Li Dong, Liang Wang, Si-Qing Chen, Wei Lu, Furu Wei. Arxiv 2025.
-
Sliding Window Attention Training for Efficient Large Language Models. Zichuan Fu, Wentao Song, Yejing Wang, Xian Wu, Yefeng Zheng, Yingying Zhang, Derong Xu, Xuetao Wei, Tong Xu, Xiangyu Zhao. Arxiv 2025.
-
LongRoPE2: Near-Lossless LLM Context Window Scaling. Ning Shang, Li Lyna Zhang, Siyuan Wang, Gaokai Zhang, Gilsinia Lopez, Fan Yang, Weizhu Chen, Mao Yang. Arxiv 2025.
-
ByteScale: Efficient Scaling of LLM Training with a 2048K Context Length on More Than 12,000 GPUs. Hao Ge, Junda Feng, Qi Huang, Fangcheng Fu, Xiaonan Nie, Lei Zuo, Haibin Lin, Bin Cui, Xin Liu. Arxiv 2025.
-
Pause-Tuning for Long-Context Comprehension: A Lightweight Approach to LLM Attention Recalibration. James Begin, Namit Agrawal, Eshan Singh, Yicheng Fu, Sean O'Brien, Vasu Sharma, Kevin Zhu. Arxiv 2025.
-
LADM: Long-context Training Data Selection with Attention-based Dependency Measurement for LLMs. Jianghao Chen, Junhong Wu, Yangyifan Xu, Jiajun Zhang. Arxiv 2025.
-
Forgetting Transformer: Softmax Attention with a Forget Gate. Zhixuan Lin, Evgenii Nikishin, Xu Owen He, Aaron Courville. ICLR 2025.
-
Layer-Specific Scaling of Positional Encodings for Superior Long-Context Modeling. Zhenghua Wang, Yiran Ding, Changze Lv, Zhibo Xu, Tianlong Li, Tianyuan Shi, Xiaoqing Zheng, Xuanjing Huang. Arxiv 2025.
-
Token Weighting for Long-Range Language Modeling. Falko Helm, Nico Daheim, Iryna Gurevych. NAACL 2025.
-
From 128K to 4M: Efficient Training of Ultra-Long Context Large Language Models. Chejian Xu, Wei Ping, Peng Xu, Zihan Liu, Boxin Wang, Mohammad Shoeybi, Bo Li, Bryan Catanzaro. Arxiv 2025.
-
SWAN-GPT: An Efficient and Scalable Approach for Long-Context Language Modeling. Krishna C. Puvvada, Faisal Ladhak, Santiago Akle Serrano, Cheng-Ping Hsieh, Shantanu Acharya, Somshubra Majumdar, Fei Jia, Samuel Kriman, Simeng Sun, Dima Rekesh, Boris Ginsburg. Arxiv 2025.
-
Scaling Instruction-Tuned LLMs to Million-Token Contexts via Hierarchical Synthetic Data Generation. Linda He, Jue Wang, Maurice Weber, Shang Zhu, Ben Athiwaratkun, Ce Zhang. Arxiv 2025.
-
Effective Length Extrapolation via Dimension-Wise Positional Embeddings Manipulation. Yi Lu, Wanxu Zhao, Xin Zhou, Chenxin An, Chenglong Wang, Shuo Li, Yuming Yang, Jun Zhao, Tao Ji, Tao Gui, Qi Zhang, Xuanjing Huang. Arxiv 2025.
-
Bayesian Attention Mechanism: A Probabilistic Framework for Positional Encoding and Context Length Extrapolation. Arthur S. Bianchessi, Rodrigo C. Barros, Lucas S. Kupssinskü. Arxiv 2025.
-
Extending the Context of Pretrained LLMs by Dropping Their Positional Embeddings. Yoav Gelberg, Koshi Eguchi, Takuya Akiba, Edoardo Cetin. Arxiv 2025.
-
Explain Before You Answer: A Survey on Compositional Visual Reasoning Fucai Ke, Joy Hsu, Zhixi Cai, Zixian Ma, Xin Zheng, Xindi Wu, Sukai Huang, Weiqing Wang, Pari Delir Haghighi, Gholamreza Haffari, Ranjay Krishna, Jiajun Wu, Hamid Rezatofighi. Arxiv 2025.
-
HoPE: Hyperbolic Rotary Positional Encoding for Stable Long-Range Dependency Modeling in Large Language Models Chang Dai, Hongyu Shan, Mingyang Song, Di Liang. Arxiv 2025.
-
Positional Encoding via Token-Aware Phase Attention Yu, Wang, Sheng Shen, Rémi Munos, Hongyuan Zhan, Yuandong Tian. Arxiv 2025.
-
RePo: Language Models with Context Re-Positioning Huayang Li, Tianyu Zhao, Richard Sproat. Arxiv 2025.
-
Variation-aware Vision Token Dropping for Faster Large Vision-Language Models Junjie Chen, Xuyang Liu, Zichen Wen, Yiyu Wang, Siteng Huang, Honggang Chen. Arxiv 2025.
-
D-CoDe: Scaling Image-Pretrained VLMs to Video via Dynamic Compression and Question Decomposition Yiyang Huang, Yizhou Wang, Yun Fu. Arxiv 2025.
-
Periodic RoPE for Infinite Context LLMs. Simin Huo. Arxiv 2026.
-
Disentangling the Expressivity of RoPE. Selim Jerad, Anej Svete, Jiaoda Li, Ryan Cotterell. Arxiv 2026.
-
Position Encoding in Transformers: From Absolute and Relative Methods to Rotary Position Embeddings and Long-Context Scaling. Jiguo Li. Arxiv 2026.
-
Anti-Periodic Positional Encoding: Möbius Boundary Conditions Make In-Context Retrieval Reliable. Ji Ho Bae. Arxiv 2026.




Architecture
-
Compressive Transformers for Long-Range Sequence Modelling. Jack W. Rae, Anna Potapenko, Siddhant M. Jayakumar, Timothy P. Lillicrap. Arxiv 2019.
-
Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, François Fleuret. ICML 2020.
-
Block-Recurrent Transformers. DeLesley Hutchins, Imanol Schlag, Yuhuai Wu, Ethan Dyer, Behnam Neyshabur. Arxiv 2023.
-
Memorizing Transformers. Yuhuai Wu, Markus N. Rabe, DeLesley Hutchins, Christian Szegedy. Arxiv 2022.
-
GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, Sumit Sanghai. Arxiv 2023.
-
Zebra: Extending Context Window with Layerwise Grouped Local-Global Attention. Kaiqiang Song, Xiaoyang Wang, Sangwoo Cho, Xiaoman Pan, Dong Yu. Arxiv 2023.
-
Leave No Context Behind: Efficient Infinite Context Transformers with Infini-attention. Tsendsuren Munkhdalai, Manaal Faruqui, Siddharth Gopal. Arxiv 2024.
-
Weighted Grouped Query Attention in Transformers. Sai Sena Chinnakonduru, Astarag Mohapatra. Arxiv 2024.
-
Associative Recurrent Memory Transformer. Ivan Rodkin, Yuri Kuratov, Aydar Bulatov, Mikhail Burtsev. ICML 2024 Workshop.
-
Simple linear attention language models balance the recall-throughput tradeoff. Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, Christopher Ré. Arxiv 2024.
-
DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads. Guangxuan Xiao, Jiaming Tang, Jingwei Zuo, Junxian Guo, Shang Yang, Haotian Tang, Yao Fu, Song Han. Arxiv 2024.
-
TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention. Lijie Yang, Zhihao Zhang, Zhuofu Chen, Zikun Li, Zhihao Jia. Arxiv 2024.
-
Selective Attention Improves Transformer. Yaniv Leviathan, Matan Kalman, Yossi Matias. Arxiv 2024.
-
SnapKV: LLM Knows What You are Looking for Before Generation. Yuhong Li, Yingbing Huang, Bowen Yang, Bharat Venkitesh, Acyr Locatelli, Hanchen Ye, Tianle Cai, Patrick Lewis, Deming Chen. Arxiv 2024.
-
Extra Global Attention Designation Using Keyword Detection in Sparse Transformer Architectures. Evan Lucas, Dylan Kangas, Timothy C Havens. Arxiv 2024.
-
An Empirical Study of Mamba-based Language Models. Roger Waleffe, Wonmin Byeon, Duncan Riach, Brandon Norick, Vijay Korthikanti, Tri Dao, Albert Gu, Ali Hatamizadeh, Sudhakar Singh, Deepak Narayanan, Garvit Kulshreshtha, Vartika Singh, Jared Casper, Jan Kautz, Mohammad Shoeybi, Bryan Catanzaro. Arxiv 2024.
-
Lightning Attention-2: A Free Lunch for Handling Unlimited Sequence Lengths in Large Language Models. Zhen Qin, Weigao Sun, Dong Li, Xuyang Shen, Weixuan Sun, Yiran Zhong. Arxiv 2024.
-
Various Lengths, Constant Speed: Efficient Language Modeling with Lightning Attention. Zhen Qin, Weigao Sun, Dong Li, Xuyang Shen, Weixuan Sun, Yiran Zhong. Arxiv 2024.
-
SeerAttention: Learning Intrinsic Sparse Attention in Your LLMs. Yizhao Gao, Zhichen Zeng, Dayou Du, Shijie Cao, Hayden Kwok-Hay So, Ting Cao, Fan Yang, Mao Yang. Arxiv 2024.
-
Stuffed Mamba: State Collapse and State Capacity of RNN-Based Long-Context Modeling. Yingfa Chen, Xinrong Zhang, Shengding Hu, Xu Han, Zhiyuan Liu, Maosong Sun. Arxiv 2024.
-
Taipan: Efficient and Expressive State Space Language Models with Selective Attention. Chien Van Nguyen, Huy Huu Nguyen, Thang M. Pham, Ruiyi Zhang, Hanieh Deilamsalehy, Puneet Mathur, Ryan A. Rossi, Trung Bui, Viet Dac Lai, Franck Dernoncourt, Thien Huu Nguyen. Arxiv 2024.
-
Megalodon: Efficient LLM Pretraining and Inference with Unlimited Context Length. Xuezhe Ma, Xiaomeng Yang, Wenhan Xiong, Beidi Chen, Lili Yu, Hao Zhang, Jonathan May, Luke Zettlemoyer, Omer Levy, Chunting Zhou. Arxiv 2024. . Djork-Arné Clevert, Thomas Unterthiner, Sepp Hochreiter. Arxiv 2016
-
Neural Discrete Representation Learning. Aaron van den Oord, Oriol Vinyals, Koray Kavukcuoglu. Arxiv 2018
-
Improving spiking dynamical networks: Accurate delays, higher-order synapses, and time cells. Voelker, Aaron R and Eliasmith, Chris. IEEE 2018
-
Improving language understanding by generative pre-training. Radford, Alec and Narasimhan, Karthik and Salimans, Tim and Sutskever, Ilya and others. mikecaptain 2018
-
Memformer: The Memory-Augmented Transformer. Qingyang Wu, Zhenzhong Lan, Jing Gu, Zhou Yu. Arxiv 2020
-
Linformer: Self-Attention with Linear Complexity. Sinong Wang, Belinda Z. Li, Madian Khabsa, Han Fang, Hao Ma. Arxiv 2020
-
Combining Recurrent, Convolutional, and Continuous-time Models with Linear State Space Layers. Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra, Christopher R{'{e}}. Arxiv 2021
-
Nystr"omformer: A Nystr"om-Based Algorithm for Approximating Self-Attention. Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, Vikas Singh. Arxiv 2021
-
Efficient attention: Attention with linear complexities. Zhuoran Shen and Mingyuan Zhang and Haiyu Zhao and Shuai Yi and Hongsheng Li. Arxiv 2024
-
ERNIE-SPARSE: Learning Hierarchical Efficient Transformer Through Regularized Self-Attention. Yang Liu, Jiaxiang Liu, Li Chen, Yuxiang Lu, Shikun Feng, Zhida Feng, Yu Sun, Hao Tian, Hua Wu, Haifeng Wang. Arxiv 2022
-
cosFormer: Rethinking Softmax in Attention. Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, Yiran Zhong. Arxiv 2022
-
Rethinking Attention with Performers. Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, David Belanger, Lucy Colwell, Adrian Weller. Arxiv 2022
-
Multi-head state space model for speech recognition. Yassir Fathullah and Chunyang Wu and Yuan Shangguan and Junteng Jia and Wenhan Xiong and Jay Mahadeokar and Chunxi Liu and Yangyang Shi and Ozlem Kalinli and Mike Seltzer and Mark J. F. Gales. Arxiv 2023
-
Attention Is All You Need. Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin. Arxiv 2023
-
Retentive Network: A Successor to Transformer for Large Language Models. Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, Furu Wei. Arxiv 2023
-
Scaling Transformer to 1M tokens and beyond with {RMT}. Aydar Bulatov and Yuri Kuratov and Yermek Kapushev and Mikhail S. Burtsev. Arxiv 2024
-
FLatten Transformer: Vision Transformer using Focused Linear Attention. Dongchen Han, Xuran Pan, Yizeng Han, Shiji Song, Gao Huang. Arxiv 2023
-
TRAMS: Training-free Memory Selection for Long-range Language Modeling. Haofei Yu and Cunxiang Wang and Yue Zhang and Wei Bi. Arxiv 2023
-
Segmented Recurrent Transformer: An Efficient Sequence-to-Sequence Model. Yinghan Long and Sayeed Shafayet Chowdhury and Kaushik Roy. Arxiv 2023
-
Transformer-VQ: Linear-Time Transformers via Vector Quantization. Lucas D. Lingle. Arxiv 2024
-
Transformers are SSMs: Generalized models and efficient algorithms through structured state space duality. Tri Dao and Albert Gu. Arxiv 2024
-
Block-state transformers. Mahan Fathi and Jonathan Pilault and Orhan Firat and Christopher Pal and Pierre-Luc Bacon and Ross Goroshin. Arxiv 2023
-
Extensible Embedding: {A} Flexible Multipler For LLM's Context Length. Ninglu Shao and Shitao Xiao and Zheng Liu and Peitian Zhang. Arxiv 2024
-
DeciMamba: Exploring the Length Extrapolation Potential of Mamba. Assaf Ben-Kish, Itamar Zimerman, Shady Abu-Hussein, Nadav Cohen, Amir Globerson, Lior Wolf, Raja Giryes. Arxiv 2024
-
CORM: Cache Optimization with Recent Message for Large Language Model Inference. Jincheng Dai, Zhuowei Huang, Haiyun Jiang, Chen Chen, Deng Cai, Wei Bi, Shuming Shi. Arxiv 2024
-
Longformer: The Long-Document Transformer. Iz Beltagy, Matthew E. Peters, Arman Cohan. Arxiv 2020.
-
Model Tells You What to Discard: Adaptive KV Cache Compression for LLMs. Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, Jianfeng Gao. ICLR 2024 Oral.
-
PyramidKV: Dynamic KV Cache Compression based on Pyramidal Information Funneling. Zefan Cai., Yichi Zhang, Bofei Gao, Tianyu Liu, Keming Lu, Wayne Xiong, Yue Dong, Baobao Chang, Junjie Hu, Wen Xiao. Arxiv 2024.
-
RazorAttention: Efficient KV Cache Compression Through Retrieval Heads. Hanlin Tang, Yang Lin, Jing Lin, Qingsen Han, Shikuan Hong, Yiwu Yao, Gongyi Wang. Arxiv 2024.
-
Not All Heads Matter: A Head-Level KV Cache Compression Method with Integrated Retrieval and Reasoning. Yu Fu, Zefan Cai, Abedelkadir Asi, Wayne Xiong, Yue Dong, Wen Xiao. Arxiv 2024.
-
Quest: Query-Aware Sparsity for Efficient Long-Context LLM Inference. Jiaming Tang, Yilong Zhao, Kan Zhu, Guangxuan Xiao, Baris Kasikci, Song Han. ICML 2024.
-
Efficient Streaming Language Models with Attention Sinks. Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis. Arxiv 2023.
-
PyramidInfer: Pyramid KV Cache Compression for High-throughput LLM Inference. William Brandon, Mayank Mishra, Aniruddha Nrusimha, Rameswar Panda, Jonathan Ragan Kelly. Arxiv 2024.
-
MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention. Huiqiang Jiang, Yucheng Li, Chengruidong Zhang, Qianhui Wu, Xufang Luo, Surin Ahn, Zhenhua Han, Amir H. Abdi, Dongsheng Li, Chin-Yew Lin, Yuqing Yang, Lili Qiu. Arxiv 2024.
-
LazyLLM: Dynamic Token Pruning for Efficient Long Context LLM Inference. Qichen Fu, Minsik Cho, Thomas Merth, Sachin Mehta, Mohammad Rastegari, Mahyar Najibi. Arxiv 2024.
-
DynamicKV: Task-Aware Adaptive KV Cache Compression for Long Context LLMs. Xiabin Zhou, Wenbin Wang, Minyan Zeng, Jiaxian Guo, Xuebo Liu, Li Shen, Min Zhang, Liang Ding. Arxiv 2024.
-
H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models. Zhenyu Zhang, Ying Sheng, Tianyi Zhou, Tianlong Chen, Lianmin Zheng, Ruisi Cai, Zhao Song, Yuandong Tian, Christopher R'{e}, Clark Barrett, Zhangyang "Atlas" Wang, Beidi Chen. Arxiv 2023
-
Scissorhands: Exploiting the Persistence of Importance Hypothesis for LLM KV Cache Compression at Test Time. Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, Anshumali Shrivastava. Arxiv 2023
-
Loki: Low-rank Keys for Efficient Sparse Attention. Prajwal Singhania, Siddharth Singh, Shwai He, Soheil Feizi, Abhinav Bhatele. Arxiv 2024
-
LM-Infinite: Zero-Shot Extreme Length Generalization for Large Language Models. Chi Han, Qifan Wang, Hao Peng, Wenhan Xiong, Yu Chen, Heng Ji, Sinong Wang. Arxiv 2024
-
Ada-KV: Optimizing KV Cache Eviction by Adaptive Budget Allocation for Efficient LLM Inference. Yuan Feng, Junlin Lv, Yukun Cao, Xike Xie, S. Kevin Zhou. Arxiv 2025
-
LightTransfer: Your Long-Context LLM is Secretly a Hybrid Model with Effortless Adaptation. Xuan Zhang, Fengzhuo Zhang, Cunxiao Du, Chao Du, Tianyu Pang, Wei Gao, Min Lin. Arxiv 2025
-
Hierarchical Attention Networks for Document Classification. Zichao Yang, Diyi Yang, Chris Dyer, Xiaodong He, Alexander J. Smola, Eduard H. Hovy. Arxiv 2016
-
Neural Tangent Kernel: Convergence and Generalization in Neural Networks. Arthur Jacot, Cl{'{e}}ment Hongler, Franck Gabriel. Arxiv 2018
-
Transformer-XL: Attentive Language Models beyond a Fixed-Length Context. Zihang Dai, Zhilin Yang, Yiming Yang, Jaime G. Carbonell, Quoc Viet Le, Ruslan Salakhutdinov. Arxiv 2019
-
{BERT}: Pre-training of Deep Bidirectional Transformers for Language Understanding. Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova. Arxiv 2019
-
HiPPO: Recurrent Memory with Optimal Polynomial Projections. Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra, Christopher R{'{e}}. Arxiv 2020
-
Language Models are Few-Shot Learners. Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert{-}Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, Dario Amodei. Arxiv 2020
-
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, Peter J. Liu. Arxiv 2020
-
Hi-Transformer: Hierarchical Interactive Transformer for Efficient and Effective Long Document Modeling. Chuhan Wu, Fangzhao Wu, Tao Qi, Yongfeng Huang. Arxiv 2021
-
Nystr{"{o}}mformer: {A} Nystr{"{o}}m-based Algorithm for Approximating Self-Attention. Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, Vikas Singh. Arxiv 2021
-
{GLM}: General Language Model Pretraining with Autoregressive Blank Infilling. Zhengxiao Du, Yujie Qian, Xiao Liu, Ming Ding, Jiezhong Qiu, Zhilin Yang, Jie Tang. Arxiv 2022
-
{OPT:} Open Pre-trained Transformer Language Models. Susan Zhang, Stephen Roller, Naman Goyal, Mikel Artetxe, Moya Chen, Shuohui Chen, Christopher Dewan, Mona T. Diab, Xian Li, Xi Victoria Lin, Todor Mihaylov, Myle Ott, Sam Shleifer, Kurt Shuster, Daniel Simig, Punit Singh Koura, Anjali Sridhar, Tianlu Wang, Luke Zettlemoyer. Arxiv 2022
-
{BLOOM:} {A} 176B-Parameter Open-Access Multilingual Language Model. Teven Le Scao, Angela Fan, Christopher Akiki, Ellie Pavlick, Suzana Ilic, Daniel Hesslow, Roman Castagn{'{e}}, Alexandra Sasha Luccioni, Fran{\c{c}}ois Yvon, Matthias Gall{'{e}}, Jonathan Tow, Alexander M. Rush, Stella Biderman, Albert Webson, Pawan Sasanka Ammanamanchi, Thomas Wang, Beno{^{\i}}t Sagot, Niklas Muennighoff, Albert Villanova del Moral, Olatunji Ruwase, Rachel Bawden, Stas Bekman, Angelina McMillan{-}Major, Iz Beltagy, Huu Nguyen, Lucile Saulnier, Samson Tan, Pedro Ortiz Suarez, Victor Sanh, Hugo Lauren{\c{c}}on, Yacine Jernite, Julien Launay, Margaret Mitchell, Colin Raffel, Aaron Gokaslan, Adi Simhi, Aitor Soroa, Alham Fikri Aji, Amit Alfassy, Anna Rogers, Ariel Kreisberg Nitzav, Canwen Xu, Chenghao Mou, Chris Emezue, Christopher Klamm, Colin Leong, Daniel van Strien, David Ifeoluwa Adelani, et al.. Arxiv 2022
-
Efficiently Modeling Long Sequences with Structured State Spaces. Albert Gu, Karan Goel, Christopher R{'{e}}. Arxiv 2022
-
NTK-ALiBi: Long Text Extrapolation of ALiBi Position Encoding through Interpolation. Arxiv 2023
-
LLaMA: Open and Efficient Foundation Language Models. Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie{-}Anne Lachaux, Timoth{'{e}}e Lacroix, Baptiste Rozi{`{e}}re, Naman Goyal, Eric Hambro, Faisal Azhar, Aur{'{e}}lien Rodriguez, Armand Joulin, Edouard Grave, Guillaume Lample. Arxiv 2023
-
Position Interpolation Improves ALiBi Extrapolation. Faisal Al{-}Khateeb, Nolan Dey, Daria Soboleva, Joel Hestness. Arxiv 2023
-
Efficient Prompting via Dynamic In-Context Learning. Wangchunshu Zhou, Yuchen Eleanor Jiang, Ryan Cotterell, Mrinmaya Sachan. Arxiv 2023
-
{RWKV:} Reinventing RNNs for the Transformer Era. Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Stella Biderman, Huanqi Cao, Xin Cheng, Michael Chung, Leon Derczynski, Xingjian Du, Matteo Grella, Kranthi Kiran GV, Xuzheng He, Haowen Hou, Przemyslaw Kazienko, Jan Kocon, Jiaming Kong, Bartlomiej Koptyra, Hayden Lau, Jiaju Lin, Krishna Sri Ipsit Mantri, Ferdinand Mom, Atsushi Saito, Guangyu Song, Xiangru Tang, Johan S. Wind, Stanislaw Wozniak, Zhenyuan Zhang, Qinghua Zhou, Jian Zhu, Rui{-}Jie Zhu. Arxiv 2023
-
{GQA:} Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. Joshua Ainslie, James Lee{-}Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebr{'{o}}n, Sumit Sanghai. Arxiv 2023
-
Baichuan 2: Open Large-scale Language Models. Aiyuan Yang, Bin Xiao, Bingning Wang, Borong Zhang, Ce Bian, Chao Yin, Chenxu Lv, Da Pan, Dian Wang, Dong Yan, Fan Yang, Fei Deng, Feng Wang, Feng Liu, Guangwei Ai, Guosheng Dong, Haizhou Zhao, Hang Xu, Haoze Sun, Hongda Zhang, Hui Liu, Jiaming Ji, Jian Xie, Juntao Dai, Kun Fang, Lei Su, Liang Song, Lifeng Liu, Liyun Ru, Luyao Ma, Mang Wang, Mickel Liu, MingAn Lin, Nuolan Nie, Peidong Guo, Ruiyang Sun, Tao Zhang, Tianpeng Li, Tianyu Li, Wei Cheng, Weipeng Chen, Xiangrong Zeng, Xiaochuan Wang, Xiaoxi Chen, Xin Men, Xin Yu, Xuehai Pan, Yanjun Shen, Yiding Wang, Yiyu Li, Youxin Jiang, Yuchen Gao, Yupeng Zhang, Zenan Zhou, Zhiying Wu. Arxiv 2023
-
Eagle and Finch: RWKV with Matrix-Valued States and Dynamic Recurrence. Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Xingjian Du, Teddy Ferdinan, Haowen Hou, Przemysław Kazienko, Kranthi Kiran GV, Jan Kocoń, Bartłomiej Koptyra, Satyapriya Krishna, Ronald McClelland Jr., Jiaju Lin, Niklas Muennighoff, Fares Obeid, Atsushi Saito, Guangyu Song, Haoqin Tu, Cahya Wirawan, Stanisław Woźniak, Ruichong Zhang, Bingchen Zhao, Qihang Zhao, Peng Zhou, Jian Zhu, Rui-Jie Zhu. Arxiv 2024
-
Fortify the Shortest Stave in Attention: Enhancing Context Awareness of Large Language Models for Effective Tool Use. Yuhan Chen, Ang Lv, Ting{-}En Lin, Changyu Chen, Yuchuan Wu, Fei Huang, Yongbin Li, Rui Yan. Arxiv 2024
-
QUEST: Query-Aware Sparsity for Efficient Long-Context {LLM} Inference. Jiaming Tang, Yilong Zhao, Kan Zhu, Guangxuan Xiao, Baris Kasikci, Song Han. Arxiv 2024
-
RecurrentGemma: Moving Past Transformers for Efficient Open Language Models. Aleksandar Botev, Soham De, Samuel L. Smith, Anushan Fernando, George{-}Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, L{'{e}}onard Hussenot, Johan Ferret, Sertan Girgin, Olivier Bachem, Alek Andreev, Kathleen Kenealy, Thomas Mesnard, Cassidy Hardin, Surya Bhupatiraju, Shreya Pathak, Laurent Sifre, Morgane Rivi{`{e}}re, Mihir Sanjay Kale, Juliette Love, Pouya Tafti, Armand Joulin, Noah Fiedel, Evan Senter, Yutian Chen, Srivatsan Srinivasan, Guillaume Desjardins, David Budden, Arnaud Doucet, Sharad Vikram, Adam Paszke, Trevor Gale, Sebastian Borgeaud, Charlie Chen, Andy Brock, Antonia Paterson, Jenny Brennan, Meg Risdal, Raj Gundluru, Nesh Devanathan, Paul Mooney, Nilay Chauhan, Phil Culliton, Luiz GUStavo Martins, Elisa Bandy, David Huntsperger, Glenn Cameron, Arthur Zucker, Tris Warkentin, Ludovic Peran, Minh Giang, Zoubin Ghahramani, Cl{'{e}}ment Farabet, Koray Kavukcuoglu, Demis Hassabis, Raia Hadsell, Yee Whye Teh, Nando de Frietas. Arxiv 2024
-
SnapKV: LLM Knows What You are Looking for Before Generation. Yuhong Li, Yingbing Huang, Bowen Yang, Bharat Venkitesh, Acyr Locatelli, Hanchen Ye, Tianle Cai, Patrick Lewis, Deming Chen. Arxiv 2024
-
PyramidInfer: Pyramid {KV} Cache Compression for High-throughput {LLM} Inference. Dongjie Yang, Xiaodong Han, Yan Gao, Yao Hu, Shilin Zhang, Hai Zhao. Arxiv 2024
-
HiRoPE: Length Extrapolation for Code Models Using Hierarchical Position. Kechi Zhang, Ge Li, Huangzhao Zhang, Zhi Jin. Arxiv 2024
-
DAPE V2: Process Attention Score as Feature Map for Length Extrapolation. Chuanyang Zheng, Yihang Gao, Han Shi, Jing Xiong, Jiankai Sun, Jingyao Li, Minbin Huang, Xiaozhe Ren, Michael K. Ng, Xin Jiang, Zhenguo Li, Yu Li. Arxiv 2024
-
LM-Infinite: Zero-Shot Extreme Length Generalization for Large Language Models. Chi Han, Qifan Wang, Hao Peng, Wenhan Xiong, Yu Chen, Heng Ji, Sinong Wang. Arxiv 2024
-
Model Tells You What to Discard: Adaptive {KV} Cache Compression for {LLM}s. Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, Jianfeng Gao. Arxiv 2024
-
LongRecipe: Recipe for Efficient Long Context Generalization in Large Language Models. Zhiyuan Hu, Yuliang Liu, Jinman Zhao, Suyuchen Wang, Yan Wang, Wei Shen, Qing Gu, Anh Tuan Luu, See{-}Kiong Ng, Zhiwei Jiang, Bryan Hooi. Arxiv 2024
-
LongHeads: Multi-Head Attention is Secretly a Long Context Processor. Yi Lu, Xin Zhou, Wei He, Jun Zhao, Tao Ji, Tao Gui, Qi Zhang, Xuanjing Huang. Arxiv 2024
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. Albert Gu, Tri Dao. Arxiv 2024
-
DeepSeek-V2: {A} Strong, Economical, and Efficient Mixture-of-Experts Language Model. DeepSeek{-}AI, Aixin Liu, Bei Feng, Bin Wang, Bingxuan Wang, Bo Liu, Chenggang Zhao, Chengqi Deng, Chong Ruan, Damai Dai, Daya Guo, Dejian Yang, Deli Chen, Dongjie Ji, Erhang Li, Fangyun Lin, Fuli Luo, Guangbo Hao, Guanting Chen, Guowei Li, Hao Zhang, Hanwei Xu, Hao Yang, Haowei Zhang, Honghui Ding, Huajian Xin, Huazuo Gao, Hui Li, Hui Qu, J. L. Cai, Jian Liang, Jianzhong Guo, Jiaqi Ni, Jiashi Li, Jin Chen, Jingyang Yuan, Junjie Qiu, Junxiao Song, Kai Dong, Kaige Gao, Kang Guan, Lean Wang, Lecong Zhang, Lei Xu, Leyi Xia, Liang Zhao, Liyue Zhang, Meng Li, Miaojun Wang, Mingchuan Zhang, Minghua Zhang, Minghui Tang, Mingming Li, Ning Tian, Panpan Huang, Peiyi Wang, Peng Zhang, Qihao Zhu, Qinyu Chen, Qiushi Du, R. J. Chen, R. L. Jin, Ruiqi Ge, Ruizhe Pan, Runxin Xu, Ruyi Chen, S. S. Li, Shanghao Lu, Shangyan Zhou, Shanhuang Chen, Shaoqing Wu, Shengfeng Ye, Shirong Ma, Shiyu Wang, Shuang Zhou, Shuiping Yu, Shunfeng Zhou, Size Zheng, Tao Wang, Tian Pei, Tian Yuan, Tianyu Sun, W. L. Xiao, Wangding Zeng, Wei An, Wen Liu, Wenfeng Liang, Wenjun Gao, Wentao Zhang, X. Q. Li, Xiangyue Jin, Xianzu Wang, Xiao Bi, Xiaodong Liu, Xiaohan Wang, Xiaojin Shen, Xiaokang Chen, Xiaosha Chen, Xiaotao Nie, Xiaowen Sun. Arxiv 2024
-
Can Mamba Learn How To Learn? {A} Comparative Study on In-Context Learning Tasks. Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee, Dimitris Papailiopoulos. Arxiv 2024
-
You Only Cache Once: Decoder-Decoder Architectures for Language Models. Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang, Furu Wei. Arxiv 2024
-
Zamba: A Compact 7B SSM Hybrid Model. Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim, Beren Millidge. Arxiv 2024
-
Qwen2.5-1M Technical Report. An Yang, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoyan Huang, Jiandong Jiang, Jianhong Tu, Jianwei Zhang, Jingren Zhou, Junyang Lin, Kai Dang, Kexin Yang, Le Yu, Mei Li, Minmin Sun, Qin Zhu, Rui Men, Tao He, Weijia Xu, Wenbiao Yin, Wenyuan Yu, Xiafei Qiu, Xingzhang Ren, Xinlong Yang, Yong Li, Zhiying Xu, Zipeng Zhang. Arxiv 2025
-
RazorAttention: Efficient {KV} Cache Compression Through Retrieval Heads. Hanlin Tang, Yang Lin, Jing Lin, Qingsen Han, Danning Ke, Shikuan Hong, Yiwu Yao, Gongyi Wang. Arxiv 2025
-
LightTransfer: Your Long-Context {LLM} is Secretly a Hybrid Model with Effortless Adaptation. Xuan Zhang, Fengzhuo Zhang, Cunxiao Du, Chao Du, Tianyu Pang, Wei Gao, Min Lin. Arxiv 2025
-
Unshackling Context Length: An Efficient Selective Attention Approach through Query-Key Compression. Haoyu Wang, Tong Teng, Tianyu Guo, An Xiao, Duyu Tang, Hanting Chen, Yunhe Wang. Arxiv 2025.
-
Towards Economical Inference: Enabling DeepSeek's Multi-Head Latent Attention in Any Transformer-based LLMs. Tao Ji, Bin Guo, Yuanbin Wu, Qipeng Guo, Lixing Shen, Zhan Chen, Xipeng Qiu, Qi Zhang, Tao Gui. Arxiv 2025.
-
SVDq: 1.25-bit and 410x Key Cache Compression for LLM Attention. Hong Yankun, Li Xing, Zhen Hui-Ling, Yu Xianzhi, Liu Wulong, Yuan Mingxuan. Arxiv 2025.
-
Round Attention: A Novel Round-Level Attention Mechanism to Accelerate LLM Inference. Yaohua Tang, Zhicheng Hu, Kun Cheng, Fan Mo, Qiheng Lv, Hua Wang, Zhi Chen. Arxiv 2025.
-
DBudgetKV: Dynamic Budget in KV Cache Compression for Ensuring Optimal Performance. Xuanfan Ni, Liyan Xu, Chenyang Lyu, Longyue Wang, Mo Yu, Lemao Liu, Fandong Meng, Jie Zhou, Piji Li. Arxiv 2025.
-
KVLink: Accelerating Large Language Models via Efficient KV Cache Reuse. Jingbo Yang, Bairu Hou, Wei Wei, Yujia Bao, Shiyu Changi. Arxiv 2025.
-
FairKV: Balancing Per-Head KV Cache for Fast Multi-GPU Inference. Bingzhe Zhao, Ke Cheng, Aomufei Yuan, Yuxuan Tian, Ruiguang Zhong, Chengchen Hu, Tong Yang, Lian Yu. Arxiv 2025.
-
CoKV: Optimizing KV Cache Allocation via Cooperative Game. Qiheng Sun, Hongwei Zhang, Haocheng Xia, Jiayao Zhang, Jinfei Liu, Kui Ren. Arxiv 2025.
-
MEDA: Dynamic KV Cache Allocation for Efficient Multimodal Long-Context Inference. Zhongwei Wan, Hui Shen, Xin Wang, Che Liu, Zheda Mai, Mi Zhang. NAACL 2025.
-
FlexPrefill: A Context-Aware Sparse Attention Mechanism for Efficient Long-Sequence Inference. Xunhao Lai, Jianqiao Lu, Yao Luo, Yiyuan Ma, Xun Zhou. ICLR 2025 Oral.
-
WeightedKV: Attention Scores Weighted Key-Value Cache Merging for Large Language Models. Jian Yuan, Ziwei He, Haoli Bai, Jingwen Leng, Bo Jiang. ICASSP 2025.
-
Dialogue Without Limits: Constant-Sized KV Caches for Extended Responses in LLMs. Ravi Ghadia, Avinash Kumar, Gaurav Jain, Prashant Nair, Poulami Das. Arxiv 2025.
-
KVCrush: Key value cache size-reduction using similarity in head-behaviour. Gopi Krishna Jha, Sameh Gobriel, Liubov Talamanova, Alexander Kozlov, Nilesh Jain. Arxiv 2025.
-
EliteKV: Scalable KV Cache Compression via RoPE Frequency Selection and Joint Low-Rank Projection. Yuhao Zhou, Sirui Song, Boyang Liu, Zhiheng Xi, Senjie Jin, Xiaoran Fan, Zhihao Zhang, Wei Li, Xuanjing Huang. Arxiv 2025.
-
Progressive Sparse Attention: Algorithm and System Co-design for Efficient Attention in LLM Serving. Qihui Zhou, Peiqi Yin, Pengfei Zuo, James Cheng. Arxiv 2025.
-
Q-Filters: Leveraging QK Geometry for Efficient KV Cache Compression. Nathan Godey, Alessio Devoto, Yu Zhao, Simone Scardapane, Pasquale Minervini, Éric de la Clergerie, Benoît Sagot. Arxiv 2025.
-
TokenButler: Token Importance is Predictable. Yash Akhauri, Ahmed F AbouElhamayed, Yifei Gao, Chi-Chih Chang, Nilesh Jain, Mohamed S. Abdelfattah. Arxiv 2025.
-
Slim attention: cut your context memory in half without loss of accuracy -- K-cache is all you need for MHA. Nils Graef, Andrew Wasielewski. Arxiv 2025.
-
LLMs Know What to Drop: Self-Attention Guided KV Cache Eviction for Efficient Long-Context Inference. Guangtao Wang, Shubhangi Upasani, Chen Wu, Darshan Gandhi, Jonathan Li, Changran Hu, Bo Li, Urmish Thakker. ICLR 2025.
-
KV-Distill: Nearly Lossless Learnable Context Compression for LLMs. Vivek Chari, Guanghui Qin, Benjamin Van Durme. Arxiv 2025.
-
Radar: Fast Long-Context Decoding for Any Transformer. Yongchang Hao, Mengyao Zhai, Hossein Hajimirsadeghi, Sepidehsadat Hosseini, Frederick Tung. ICLR 2025.
-
PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention. Lida Chen, Dong Xu, Chenxin An, Xintao Wang, Yikai Zhang, Jiangjie Chen, Zujie Liang, Feng Wei, Jiaqing Liang, Yanghua Xiao, Wei Wang. Arxiv 2025.
-
Cost-Optimal Grouped-Query Attention for Long-Context LLMs. Yingfa Chen, Yutong Wu, Xu Han, Zhiyuan Liu, Maosong Sun. Arxiv 2025.
-
ZeroMerge: Parameter-Free KV Cache Compression for Memory-Efficient Long-Context LLMs. Xin Liu, Pei Liu, Guoming Tang. Arxiv 2025.
-
Exploring the Limits of KV Cache Compression in Visual Autoregressive Transformers. Bo Chen, Xiaoyu Li, Yekun Ke, Yingyu Liang, Zhenmei Shi, Zhao Song. Arxiv 2025.
-
SpeCache: Speculative Key-Value Caching for Efficient Generation of LLMs. Shibo Jie, Yehui Tang, Kai Han, Zhi-Hong Deng, Jing Han. Arxiv 2025.
-
KVShare: Semantic-Aware Key-Value Cache Sharing for Efficient Large Language Model Inference. Huan Yang, Renji Zhang, Deyu Zhang. Arxiv 2025.
-
xKV: Cross-Layer SVD for KV-Cache Compression. Chi-Chih Chang, Chien-Yu Lin, Yash Akhauri, Wei-Cheng Lin, Kai-Chiang Wu, Luis Ceze, Mohamed S. Abdelfattah. Arxiv 2025.
-
WindowKV: Task-Adaptive Group-Wise KV Cache Window Selection for Efficient LLM Inference. Youhui Zuo, Sibo Wei, Chen Zhang, Zhuorui Liu, Wenpeng Lu, Dawei Song. Arxiv 2025.
-
BitDecoding: Unlocking Tensor Cores for Long-Context LLMs Decoding with Low-Bit KV Cache. Dayou Du, Shijie Cao, Jianyi Cheng, Ting Cao, Mao Yang. Arxiv 2025.
-
Oaken: Fast and Efficient LLM Serving with Online-Offline Hybrid KV Cache Quantization. Minsu Kim, Seongmin Hong, RyeoWook Ko, Soongyu Choi, Hunjong Lee, Junsoo Kim, Joo-Young Kim, Jongse Park. Arxiv 2025.
-
LogQuant: Log-Distributed 2-Bit Quantization of KV Cache with Superior Accuracy Preservation. Han Chen, Zicong Jiang, Zining Zhang, Bingsheng He, Pingyi Luo, Mian Lu, Yuqiang Chen. ICLR 2025.
-
Cocktail: Chunk-Adaptive Mixed-Precision Quantization for Long-Context LLM Inference. Wei Tao, Bin Zhang, Xiaoyang Qu, Jiguang Wan, Jianzong Wang. DATE 2025.
-
PromptDistill: Query-based Selective Token Retention in Intermediate Layers for Efficient Large Language Model Inference. Weisheng Jin, Maojia Song, Tej Deep Pala, Yew Ken Chia, Amir Zadeh, Chuan Li, Soujanya Poria. Arxiv 2025.
-
SQuat: Subspace-orthogonal KV Cache Quantization. Hao Wang, Ligong Han, Kai Xu, Akash Srivastava. Arxiv 2025.
-
Rethinking Key-Value Cache Compression Techniques for Large Language Model Serving. Wei Gao, Xinyu Zhou, Peng Sun, Tianwei Zhang, Yonggang Wen. MLSys 2025.
-
SentenceKV: Efficient LLM Inference via Sentence-Level Semantic KV Caching. Yuxuan Zhu, Ali Falahati, David H. Yang, Mohammad Mohammadi Amiri. Arxiv 2025.
-
LagKV: Lag-Relative Information of the KV Cache Tells Which Tokens Are Important. Manlai Liang, JiaMing Zhang, Xiong Li, Jinlong Li. Arxiv 2025.
-
FlowKV: A Disaggregated Inference Framework with Low-Latency KV Cache Transfer and Load-Aware Scheduling. Weiqing Li, Guochao Jiang, Xiangyong Ding, Zhangcheng Tao, Chuzhan Hao, Chenfeng Xu, Yuewei Zhang, Hao Wang. Arxiv 2025.
-
Apt-Serve: Adaptive Request Scheduling on Hybrid Cache for Scalable LLM Inference Serving. Shihong Gao, Xin Zhang, Yanyan Shen, Lei Chen. Arxiv 2025.
-
KeepKV: Eliminating Output Perturbation in KV Cache Compression for Efficient LLMs Inference. Yuxuan Tian, Zihan Wang, Yebo Peng, Aomufei Yuan, Zhiming Wang, Bairen Yi, Xin Liu, Yong Cui, Tong Yang. Arxiv 2025.
-
MOM: Memory-Efficient Offloaded Mini-Sequence Inference for Long Context Language Models. Junyang Zhang, Tianyi Zhu, Cheng Luo, Anima Anandkumar. Arxiv 2025.
-
CAOTE: KV Caching through Attention Output Error based Token Eviction. Raghavv Goel, Junyoung Park, Mukul Gagrani, Dalton Jones, Matthew Morse, Harper Langston, Mingu Lee, Chris Lott. Arxiv 2025.
-
SlimPipe: Memory-Thrifty and Efficient Pipeline Parallelism for Long-Context LLM Training. Zhouyang Li, Yuliang Liu, Wei Zhang, Tailing Yuan, Bin Chen, Chengru Song, Di Zhang. Arxiv 2025.
-
FreqKV: Frequency Domain Key-Value Compression for Efficient Context Window Extension. Jushi Kai, Boyi Zeng, Yixuan Wang, Haoli Bai, Bo Jiang, Zhouhan Lin. Arxiv 2025.
-
dKV-Cache: The Cache for Diffusion Language Models. Xinyin Ma, Runpeng Yu, Gongfan Fang, Xinchao Wang. Arxiv 2025.
-
PM-KVQ: Progressive Mixed-precision KV Cache Quantization for Long-CoT LLMs. Tengxuan Liu, Shiyao Li, Jiayi Yang, Tianchen Zhao, Feng Zhou, Xiaohui Song, Guohao Dai, Shengen Yan, Huazhong Yang, Yu Wang. Arxiv 2025.
-
TailorKV: A Hybrid Framework for Long-Context Inference via Tailored KV Cache Optimization. Dingyu Yao, Bowen Shen, Zheng Lin, Wei Liu, Jian Luan, Bin Wang, Weiping Wang. Arxiv 2025.
-
R-KV: Redundancy-aware KV Cache Compression for Training-Free Reasoning Models Acceleration. Zefan Cai, Wen Xiao, Hanshi Sun, Cheng Luo, Yikai Zhang, Ke Wan, Yucheng Li, Yeyang Zhou, Li-Wen Chang, Jiuxiang Gu, Zhen Dong, Anima Anandkumar, Abedelkadir Asi, Junjie Hu. Arxiv 2025.
-
ReCalKV: Low-Rank KV Cache Compression via Head Reordering and Offline Calibration. Xianglong Yan, Zhiteng Li, Tianao Zhang, Linghe Kong, Yulun Zhang, Xiaokang Yang. Arxiv 2025.
-
VScan: Rethinking Visual Token Reduction for Efficient Large Vision-Language Models. Ce Zhang, Kaixin Ma, Tianqing Fang, Wenhao Yu, Hongming Zhang, Zhisong Zhang, Yaqi Xie, Katia Sycara, Haitao Mi, Dong Yu. Arxiv 2025.
-
KVzip: Query-Agnostic KV Cache Compression with Context Reconstruction. Jang-Hyun Kim, Jinuk Kim, Sangwoo Kwon, Jae W. Lee, Sangdoo Yun, Hyun Oh Song. Arxiv 2025.
-
Mustafar: Promoting Unstructured Sparsity for KV Cache Pruning in LLM Inference. Donghyeon Joo, Helya Hosseini, Ramyad Hadidi, Bahar Asgari. Arxiv 2025.
-
Lookahead Q-Cache: Achieving More Consistent KV Cache Eviction via Pseudo Query. Yixuan Wang, Shiyu Ji, Yijun Liu, Yuzhuang Xu, Yang Xu, Qingfu Zhu, Wanxiang Che. Arxiv 2025.
-
Hardware-Efficient Attention for Fast Decoding. Ted Zadouri, Hubert Strauss, Tri Dao. Arxiv 2025.
-
Accelerating Diffusion Language Model Inference via Efficient KV Caching and Guided Diffusion. Zhanqiu Hu, Jian Meng, Yash Akhauri, Mohamed S. Abdelfattah, Jae-sun Seo, Zhiru Zhang, Udit Gupta. Arxiv 2025.
-
AhaKV: Adaptive Holistic Attention-Driven KV Cache Eviction for Efficient Inference of Large Language Models. Yifeng Gu, Zicong Jiang, Jianxiu Jin, Kailing Guo, Ziyang Zhang, Xiangmin Xu. Arxiv 2025.
-
Inference-Time Hyper-Scaling with KV Cache Compression. Adrian Łańcucki, Konrad Staniszewski, Piotr Nawrot, Edoardo M. Ponti. Arxiv 2025.
-
TaDA: Training-free recipe for Decoding with Adaptive KV Cache Compression and Mean-centering. Vinay Joshi, Pratik Prabhanjan Brahma, Zicheng Liu, Emad Barsoum. Arxiv 2025.
-
Homogeneous Keys, Heterogeneous Values: Exploiting Local KV Cache Asymmetry for Long-Context LLMs. Wanyun Cui, Mingwei Xu. Arxiv 2025.
-
Paged Attention Meets FlexAttention: Unlocking Long-Context Efficiency in Deployed Inference. Thomas Joshi, Herman Saini, Neil Dhillon, Antoni Viros i Martin, Kaoutar El Maghraoui. Arxiv 2025.
-
KVmix: Gradient-Based Layer Importance-Aware Mixed-Precision Quantization for KV Cache. Fei Li, Song Liu, Weiguo Wu, Shiqiang Nie, Jinyu Wang. Arxiv 2025.
-
Efficient Long-Context LLM Inference via KV Cache Clustering. Jie Hu, Shengnan Wang, Yutong He, Ping Gong, Jiawei Yi, Juncheng Zhang, Youhui Bai, Renhai Chen, Gong Zhang, Cheng Li, Kun Yuan. Arxiv 2025.
-
Beyond Homogeneous Attention: Memory-Efficient LLMs via Fourier-Approximated KV Cache. Xiaoran Liu, Siyang He, Qiqi Wang, Ruixiao Li, Yuerong Song, Zhigeng Liu, Linlin Li, Qun Liu, Zengfeng Huang, Qipeng Guo, Ziwei He, Xipeng Qiu. Arxiv 2025.
-
Latent Multi-Head Attention for Small Language Models. Sushant Mehta, Raj Dandekar, Rajat Dandekar, Sreedath Panat. Arxiv 2025.
-
Multipole Attention for Efficient Long Context Reasoning. Coleman Hooper, Sebastian Zhao, Luca Manolache, Sehoon Kim, Michael W. Mahoney, Yakun Sophia Shao, Kurt Keutzer, Amir Gholami. Arxiv 2025.
-
Mixture of Weight-shared Heterogeneous Group Attention Experts for Dynamic Token-wise KV Optimization. Guanghui Song, Dongping Liao, Yiren Zhao, Kejiang Ye, Cheng-zhong Xu, Xitong Gao. Arxiv 2025.
-
Cache Me If You Can: How Many KVs Do You Need for Effective Long-Context LMs?. Adithya Bhaskar, Alexander Wettig, Tianyu Gao, Yihe Dong, Danqi Chen. Arxiv 2025.
-
LazyEviction: Lagged KV Eviction with Attention Pattern Observation for Efficient Long Reasoning. Haoyue Zhang, Hualei Zhang, Xiaosong Ma, Jie Zhang, Song Guo. Arxiv 2025.
-
CommVQ: Commutative Vector Quantization for KV Cache Compression. Junyan Li, Yang Zhang, Muhammad Yusuf Hassan, Talha Chafekar, Tianle Cai, Zhile Ren, Pengsheng Guo, Foroozan Karimzadeh, Colorado Reed, Chong Wang, Chuang Gan. Arxiv 2025.
-
X-EcoMLA: Upcycling Pre-Trained Attention into MLA for Efficient and Extreme KV Compression. Guihong Li, Mehdi Rezagholizadeh, Mingyu Yang, Vikram Appia, Emad Barsoum. Arxiv 2025.
-
OmniKV: Dynamic Context Selection for Efficient Long-Context LLMs Jitai Hao, Yuke Zhu, Tian Wang, Jun Yu, Xin Xin, Bo Zheng, Zhaochun Ren, Sheng Guo. ICLR 2025.
-
XAttention: Block Sparse Attention with Antidiagonal Scoring. Ruyi Xu, Guangxuan Xiao, Haofeng Huang, Junxian Guo, Song Han. Arxiv 2025.
-
The Sparse Frontier: Sparse Attention Trade-offs in Transformer LLMs. Piotr Nawrot, Robert Li, Renjie Huang, Sebastian Ruder, Kelly Marchisio, Edoardo M. Ponti. Arxiv 2025.
-
Mixture of Sparse Attention: Content-Based Learnable Sparse Attention via Expert-Choice Routing. Piotr Piękos, Róbert Csordás, Jürgen Schmidhuber. Arxiv 2025.
-
Hierarchical Context Merging: Better Long Context Understanding for Pre-trained LLMs. Woomin Song, Seunghyuk Oh, Sangwoo Mo, Jaehyung Kim, Sukmin Yun, Jung-Woo Ha, Jinwoo Shin. ICLR 2024.
-
Sparsified State-Space Models are Efficient Highway Networks. Woomin Song, Jihoon Tack, Sangwoo Mo, Seunghyuk Oh, Jinwoo Shin. TMLR 2025.
-
Compress, Gather, and Recompute: REFORMing Long-Context Processing in Transformers. Woomin Song, Sai Muralidhar Jayanthi, Srikanth Ronanki, Kanthashree Mysore Sathyendra, Jinwoo Shin, Aram Galstyan, Shubham Katiyar, Sravan Babu Bodapati. Arxiv 2025.
-
Multi-head Temporal Latent Attention. Keqi Deng, Philip C. Woodland. Arxiv 2025.
-
Scale-invariant Attention. Ben Anson, Xi Wang, Laurence Aitchison. Arxiv 2025.
-
SageAttention2++: A More Efficient Implementation of SageAttention2. Jintao Zhang, Xiaoming Xu, Jia Wei, Haofeng Huang, Pengle Zhang, Chendong Xiang, Jun Zhu, Jianfei Chen. Arxiv 2025.
-
HATA: Trainable and Hardware-Efficient Hash-Aware Top-k Attention for Scalable Large Model Inference. Ping Gong, Jiawei Yi, Shengnan Wang, Juncheng Zhang, Zewen Jin, Ouxiang Zhou, Ruibo Liu, Guanbin Xu, Youhui Bai, Bowen Ye, Kun Yuan, Tong Yang, Gong Zhang, Renhai Chen, Feng Wu, Cheng Li. Arxiv 2025.
-
Rectified Sparse Attention. Yutao Sun, Tianzhu Ye, Li Dong, Yuqing Xia, Jian Chen, Yizhao Gao, Shijie Cao, Jianyong Wang, Furu Wei. Arxiv 2025.
-
SeerAttention-R: Sparse Attention Adaptation for Long Reasoning. Yizhao Gao, Shuming Guo, Shijie Cao, Yuqing Xia, Yu Cheng, Lei Wang, Lingxiao Ma, Yutao Sun, Tianzhu Ye, Li Dong, Hayden Kwok-Hay So, Yu Hua, Ting Cao, Fan Yang, Mao Yang. Arxiv 2025.
-
Lag-Relative Sparse Attention In Long Context Training. Manlai Liang, Wanyi Huang, Mandi Liu, Huaijun Li, Jinlong Li. Arxiv 2025.
-
DAM: Dynamic Attention Mask for Long-Context Large Language Model Inference Acceleration. Hanzhi Zhang, Heng Fan, Kewei Sha, Yan Huang, Yunhe Feng. Arxiv 2025.
-
GTA: Grouped-head latenT Attention. Luoyang Sun, Jiwen Jiang, Cheng Deng, Xinjian Wu, Haifeng Zhang, Lei Chen, Lionel Ni, Jun Wang. Arxiv 2025.
-
Fast and Simplex: 2-Simplicial Attention in Triton. Aurko Roy, Timothy Chou, Sai Surya Duvvuri, Sijia Chen, Jiecao Yu, Xiaodong Wang, Manzil Zaheer, Rohan Anil. Arxiv 2025.
-
Mitigating Posterior Salience Attenuation in Long-Context LLMs with Positional Contrastive Decoding. Zikai Xiao, Ziyang Wang, Wen Ma, Yan Zhang, Wei Shen, Yan Wang, Luqi Gong, Zuozhu Liu. Arxiv 2025.
-
Long-Short Alignment for Effective Long-Context Modeling in LLMs. Tianqi Du, Haotian Huang, Yifei Wang, Yisen Wang. Arxiv 2025.
-
Arctic Long Sequence Training: Scalable And Efficient Training For Multi-Million Token Sequences. Stas Bekman, Samyam Rajbhandari, Michael Wyatt, Jeff Rasley, Tunji Ruwase, Zhewei Yao, Aurick Qiao, Yuxiong He. Arxiv 2025.
-
Long-Context Generalization with Sparse Attention. Pavlo Vasylenko, Marcos Treviso, André F. T. Martins. Arxiv 2025.
-
Elastic Attention: Test-time Adaptive Sparsity Ratios for Efficient Transformers. Zecheng Tang, Quantong Qiu, Yi Yang, Zhiyi Hong, Haiya Xiang, Kebin Liu, Qingqing Dang, Juntao Li, Min Zhang. Arxiv 2025.
-
TimeViper: A Hybrid Mamba-Transformer Vision-Language Model for Efficient Long Video Understanding. Boshen Xu, Zihan Xiao, Jiaze Li, Jianzhong Ju, Zhenbo Luo, Jian Luan, Qin Jin. Arxiv 2025.
-
Speed Always Wins: A Survey on Efficient Architectures for Large Language Models Weigao Sun, Jiaxi Hu, Yucheng Zhou, Jusen Du, Disen Lan, Kexin Wang, Tong Zhu, Xiaoye Qu, Yu Zhang, Xiaoyu Mo, Daizong Liu, Yuxuan Liang, Wenliang Chen, Guoqi Li, Yu Cheng. Arxiv 2025.
-
Speed Always Wins: A Survey on Efficient Architectures for Large Language Models Xinda Jia, Jinpeng Li, Zezhong Wang, Jingjing Li, Xingshan Zeng, Yasheng Wang, Weinan Zhang, Yong Yu, Weiwen Liu. Arxiv 2025.
-
Trainable Dynamic Mask Sparse Attention Jingze Shi, Yifan Wu, Bingheng Wu, Yiran Peng, Liangdong Wang, Guang Liu, Yuyu Luo. Arxiv 2025.
-
Less Is More: Training-Free Sparse Attention with Global Locality for Efficient Reasoning Lijie Yang, Zhihao Zhang, Arti Jain, Shijie Cao, Baihong Yuan, Yiwei Chen, Zhihao Jia, Ravi Netravali. Arxiv 2025.
-
Every Attention Matters: An Efficient Hybrid Architecture for Long-Context Reasoning Ling Team, Bin Han, Caizhi Tang, Chen Liang, Donghao Zhang, Fan Yuan, Feng Zhu, Jie Gao, Jingyu Hu, Longfei Li, Meng Li, Mingyang Zhang, Peijie Jiang, Peng Jiao, Qian Zhao, Qingyuan Yang, Wenbo Shen, Xinxing Yang, Yalin Zhang, Yankun Ren, Yao Zhao, Yibo Cao, Yixuan Sun, Yue Zhang, Yuchen Fang, Zibin Lin, Zixuan Cheng, Jun Zhou. Arxiv 2025.
-
Alleviating Forgetfulness of Linear Attention by Hybrid Sparse Attention and Contextualized Learnable Token Eviction Mutian He, Philip N. Garner. Arxiv 2025.
-
Retrospective Sparse Attention for Efficient Long-Context Generation Seonghwan Choi, Beomseok Kang, Dongwon Jo, Jae-Joon Kim. Arxiv 2025.
-
ProxyAttn: Guided Sparse Attention via Representative Heads Yixuan Wang, Huang He, Siqi Bao, Hua Wu, Haifeng Wang, Qingfu Zhu, Wanxiang Che. Arxiv 2025.
-
Frequency-Aware Token Reduction for Efficient Vision Transformer Dong-Jae Lee, Jiwan Hur, Jaehyun Choi, Jaemyung Yu, Junmo Kim. Arxiv 2025.
-
Gated Associative Memory: A Parallel O(N) Architecture for Efficient Sequence Modeling Rishiraj Acharya. Arxiv 2025.
-
Mamba Modulation: On the Length Generalization of Mamba Peng Lu, Jerry Huang, Qiuhao Zeng, Xinyu Wang, Boxing Wang, Philippe Langlais, Yufei Cui. Arxiv 2025.
-
Causal Attention with Lookahead Keys Zhuoqing Song, Peng Sun, Huizhuo Yuan, Quanquan Gu. Arxiv 2025.
-
DTRNet: Dynamic Token Routing Network to Reduce Quadratic Costs in Transformers Aman Sharma, Saeed Najafi, Parsa Farinneya, Benyamin Jamialahmadi, Marzieh S. Tahaei, Yuhe Fan, Mehdi Rezagholizadeh, Boxing Chen, Aref Jafari. Arxiv 2025.
-
HiPrune: Training-Free Visual Token Pruning via Hierarchical Attention in Vision-Language Models Jizhihui Liu, Feiyi Du, Guangdao Zhu, Niu Lian, Jun Li, Bin Chen. Arxiv 2025.
-
VideoNSA: Native Sparse Attention Scales Video Understanding Enxin Song, Wenhao Chai, Shusheng Yang, Ethan Armand, Xiaojun Shan, Haiyang Xu, Jianwen Xie, Zhuowen Tu. Arxiv 2025.
-
SparseVILA: Decoupling Visual Sparsity for Efficient VLM Inference Samir Khaki, Junxian Guo, Jiaming Tang, Shang Yang, Yukang Chen, Konstantinos N. Plataniotis, Yao Lu, Song Han, Zhijian Liu. Arxiv 2025.
-
Accelerating Vision Transformers with Adaptive Patch Sizes Rohan Choudhury, JungEun Kim, Jinhyung Park, Eunho Yang, László A. Jeni, Kris M. Kitani. Arxiv 2025.
-
NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model NVIDIA: Aarti Basant, Abhijit Khairnar, Abhijit Paithankar, Abhinav Khattar, Adi Renduchintala, Adithya Renduchintala, Aditya Malte, Akhiad Bercovich, Akshay Hazare, Alejandra Rico, Aleksander Ficek, Alex Kondratenko, Alex Shaposhnikov, Ali Taghibakhshi, Amelia Barton, Ameya Sunil Mahabaleshwarkar, Amy Shen, Andrew Tao, Ann Guan, Anna Shors, Anubhav Mandarwal, Arham Mehta, Arun Venkatesan, Ashton Sharabiani, Ashwath Aithal, Ashwin Poojary, Ayush Dattagupta, Balaram Buddharaju, Banghua Zhu, Barnaby Simkin, Bilal Kartal, Bita Darvish Rouhani, Bobby Chen, Boris Ginsburg, Brandon Norick, Brian Yu, Bryan Catanzaro, Charles Wang, Charlie Truong, Chetan Mungekar, Chintan Patel, Chris Alexiuk, Christian Munley, Christopher Parisien, Dan Su, Daniel Afrimi, Daniel Korzekwa, Daniel Rohrer, Daria Gitman, David Mosallanezhad, Deepak Narayanan, Dima Rekesh, Dina Yared, Dmytro Pykhtar, Dong Ahn, Duncan Riach, Eileen Long, Elliott Ning, Eric Chung, Erick Galinkin, Evelina Bakhturina, Gargi Prasad, Gerald Shen, Haim Elisha, Harsh Sharma, Hayley Ross, Helen Ngo, Herman Sahota, Hexin Wang, Hoo Chang Shin, Hua Huang, Iain Cunningham, Igor Gitman, Ivan Moshkov, Jaehun Jung, Jan Kautz, Jane Polak Scowcroft, Jared Casper, Jimmy Zhang, Jinze Xue, Jocelyn Huang, Joey Conway, John Kamalu, Jonathan Cohen, Joseph Jennings, Julien Veron Vialard, Junkeun Yi, Jupinder Parmar, Kari Briski, Katherine Cheung, Katherine Luna, Keith Wyss, Keshav Santhanam, Kezhi Kong, Krzysztof Pawelec, Kumar Anik, Kunlun Li, Kushan Ahmadian, Lawrence McAfee et al. Arxiv 2025.
-
HISA: Efficient Hierarchical Indexing for Fine-Grained Sparse Attention. Yufei Xu, Fanxu Meng, Fan Jiang, Yuxuan Wang, Ruijie Zhou, Jiexi Wu, Zhixin Pan, Zhaohui Wang, Xiaojuan Tang, Wenjie Pei, Tongxuan Liu, Di yin, Xing Sun, Muhan Zhang. Arxiv 2026.
-
Why Attend to Everything? Focus is the Key. Hengshuai Yao, Xing Chen, Ahmed Murtadha, Jin Li, Shuai Shao, Yasin Abbasi Yadkori, Guan Wang, Mingli Yuan, William Chen, Sen Song. Arxiv 2026.
-
MHLA: Restoring Expressivity of Linear Attention via Token-Level Multi-Head. Kewei Zhang, Ye Huang, Yufan Deng, Jincheng Yu, Junsong Chen, Huan Ling, Enze Xie, Daquan Zhou. Arxiv 2026.
-
Olmo 3. Team Olmo, Allyson Ettinger, Amanda Bertsch, Bailey Kuehl, David Graham, David Heineman, Dirk Groeneveld, Faeze Brahman, Finbarr Timbers, Hamish Ivison, Jacob Morrison, Jake Poznanski, Kyle Lo, Luca Soldaini, Matt Jordan, Mayee Chen, Michael Noukhovitch, Nathan Lambert, Pete Walsh, Pradeep Dasigi, Robert Berry, Saumya Malik, Saurabh Shah, Scott Geng, Shane Arora, Shashank Gupta, Taira Anderson, Teng Xiao, Tyler Murray, Tyler Romero, Victoria Graf, Akari Asai, Akshita Bhagia, Alexander Wettig, Alisa Liu, Aman Rangapur, Chloe Anastasiades, Costa Huang, Dustin Schwenk, Harsh Trivedi, Ian Magnusson, Jaron Lochner, Jiacheng Liu, Lester James V. Miranda, Maarten Sap, Malia Morgan, Michael Schmitz, Michal Guerquin, Michael Wilson, Regan Huff, Ronan Le Bras, Rui Xin, Rulin Shao, Sam Skjonsberg, Shannon Zejiang Shen, Shuyue Stella Li, Tucker Wilde, Valentina Pyatkin, Will Merrill, Yapei Chang, Yuling Gu, Zhiyuan Zeng, Ashish Sabharwal, Luke Zettlemoyer, Pang Wei Koh, Ali Farhadi, Noah A. Smith, Hannaneh Hajishirzi. Arxiv 2025.
-
UNIQUE: Universal Top-k Sparse Attention for Training-free Inference and Sparsity-aware Training. Keqi Deng, Shaoshi Ling, Ruchao Fan, Jinyu Li. Arxiv 2026.
-
Tensor Memory: Fixed-Size Recurrent State for Long-Horizon Transformers. Kabir Swain, Sijie Han, Daniel Karl I. Weidele, Mauro Martino, Antonio Torralba. Arxiv 2026.
-
Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention. Ali Hatamizadeh, Yejin Choi, Jan Kautz. Arxiv 2026.
-
LongCat Sparse Attention: Taming the Lightning via Streaming-aware Hierarchical Cross-Layer Indexing. Wen Zan, Jiaqi Zhang, Jianchao Tan, Hong Liu, Cunguang Wang, Xiang Li, Duyue Ma, Guanyu Wu, Yifan Lu, Fengcun Li, Yerui Sun, Peng Pei, Yuchen Xie, Xunliang Cai. Arxiv 2026.
-
HiSparse: Scaling Sparse-Attention Decoding with Hierarchical KV Cache Management. Zhiqiang Xie, Zhangheng Huang, Tingwei Huang, Ziyi Xu, Ruiyang Ma, Christos Kozyrakis. Arxiv 2026.
-
Autonomy-of-Heads: Data-Free Sparse Attention from Frozen Query-Key Geometry. Yehan Yang, Junyuan Shang, Yang Li, Guanqun Zhao, Shuohuan Wang, Dianhai Yu. Arxiv 2026.
-
CoSA: Accelerating Long-Context Inference via Proxy-Kernel Co-Designed Sparse Attention. Yufei Xue, Lin Niu, Hong Liu, Siran Liu, Hanyong Shao, Wei Liu, Guanghua Yu, Jianchen Zhu, Jun Zhang. Arxiv 2026.
-
PIVOT: Efficient Query-Group Indexing for Token-Level Sparse Attention. Hong Liu, Yuan Cheng, Lin Niu, Yi Su, Yufei Xue, Anmin Liu, Guanghua Yu, Jianchen Zhu. Arxiv 2026.
-
LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration. Enhuai Liu, Yunke Wang, Yutong Wang, Changming Sun, Chang Xu. Arxiv 2026.
-
SPADE: An Input-Adaptive Sparse Attention Engine for Fast Video Diffusion Models Inference. Shanghao Liu, Renze Chen, Size Zheng, Yuanqiang Liu, Yun Liang, Hailong Yang. Arxiv 2026.
-
ATFlash: Per-RoPE-Wavelength Attention Windows for Compute/Memory-Efficient LLM Inference. Shun-ichiro Hayashi, Daichi Mukunoki, Tetsuya Hoshino, Takahiro Katagiri. Arxiv 2026.
-
Understanding Sparse Attention Selectivity in Long-Context Foundation Models via Counterfactual Evaluation. Xingyu Ren, Youran Sun, Chugang Yi, Haizhao Yang. Arxiv 2026.
-
Recall Before You Rank: Similarity-Guided Top-$K$ Reuse for Efficient Long-Context Attention. Wenshuai Yao, Wenyong Zhou, Hanyong Shao, Yizhe Chen, Zhiyuan Ning, Yuannuo Feng, Ru Huang, Kechao Tang. Arxiv 2026.
-
The Query Knows What to Forget: A Second Erase Direction for Linear Attention. Dhruman Gupta, Aritra Das, Debayan Gupta. Arxiv 2026.
-
MixFormer: Linear Transformer with Mixture of Memory Experts. Yu Guo, Lei Duan. Arxiv 2026.
-
Hybrid Gated Attention. Zekun Zhou, Ruobing Xie, Lanrui Wang, Weixuan Sun. Arxiv 2026.
-
SpotAttention: Plug-In Block-Sparse Routing for Pretrained Long-Context Transformers. Huzama Ahmad, Se-Young Yun. Arxiv 2026.
-
MATCH: Modulating Attention via In-Context Retrieval for Long-Context Transformers. Linrui Ma, Chun Hei Lo, Xinyu Wang, Peng Lu, Xihao Yuan, Hanting Chen, Kai Han, Xinghao Chen, Chengjun Zhan, Hanlin Xu, Yichun Yin, Lifeng Shang, Feng Wen, Boxing Chen, Yufei Cui. ACL 2026.
-
ConSA: Controllable Sparsity in Hybrid Attention via Learnable Allocation. Yao Chen, Yinqi Yang, Junyuan Shang, Xiangzhao Hao, Simeng Zhang, Yilong Chen, Tingwen Liu, Shuohuan Wang, Dianhai Yu. Arxiv 2026.
-
Training-free sparse attention based on cumulative energy filtering. Chunlu Li, Yixuan Pan, Bai Du, Zhenyuan Chen, Yanzhao Li, Hui Dong, Hui Wang, Zhiqiang Zou. Arxiv 2026.
-
SCOPE: Subspace Clustering with Online Per-Head Top-K Estimation for Sparse Video Attention. Qi Zhao, Qirui Li, Hanlin Tang, Yiduo Li, Zhen Guo, Cuifeng Shen, Chao Xu, Zhaosheng Chi, Xiaojin Lu, Kan Liu, Tao Lan, Lin Qu, Xi Li. Arxiv 2026.
-
SparSTAR: Sparse Attention for SpaceTime AutoRegressive Video Synthesis. Jongbeom Lee, Hyunwoo Yu, Jincheol Yang, Jaemin Choi, Suk-Ju Kang. Arxiv 2026.
-
Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification. Haopeng Li, Yitong Li, Junsong Chen, Tian Ye, Haozhe Liu, Jincheng Yu, Duomin Wang, Ruihua Zhang, Zeke Xie, Enze Xie, Song Han. Arxiv 2026.




Hybrid Architecture
-
C4AI Command R7B: A 7 Billion Parameter Multilingual Model. Cohere, Cohere For AI. Arxiv 2024
-
Jamba: A hybrid transformer-mamba language model. Opher Lieber and Barak Lenz and Hofit Bata and Gal Cohen and Jhonathan Osin and Itay Dalmedigos and Erez Safahi and Shaked Meirom and Yonatan Belinkov and Shai Shalev-Shwartz and Omri Abend and Raz Alon and Tomer Asida and Amir Bergman and Roman Glozman and Michael Gokhman and Avashalom Manevich and Nir Ratner and Noam Rozen and Erez Shwartz and Mor Zusman and Yoav Shoham. Arxiv 2024
-
Hymba: A hybrid-head architecture for small language models. Xin Dong and Yonggan Fu and Shizhe Diao and Wonmin Byeon and Zijia Chen and Ameya Sunil Mahabaleshwarkar and Shih-Yang Liu and Matthijs Van Keirsbilck and Min-Hung Chen and Yoshi Suhara and Yingyan Lin and Jan Kautz and Pavlo Molchanov. Arxiv 2024
-
Zamba: A compact 7b ssm hybrid model. Paolo Glorioso and Quentin Anthony and Yury Tokpanov and James Whittington and Jonathan Pilault and Adam Ibrahim and Beren Millidge. Arxiv 2024
-
Goldfinch: High performance rwkv/transformer hybrid with linear pre-fill and extreme kv-cache compression. Daniel Goldstein and Fares Obeid and Eric Alcaide and Guangyu Song and Eugene Cheah. Arxiv 2024
-
Gemma 2: Improving open language models at a practical size. Gemma Team and Morgane Riviere and Shreya Pathak and Pier Giuseppe Sessa and Cassidy Hardin and Surya Bhupatiraju and Léonard Hussenot and Thomas Mesnard and Bobak Shahriari and Alexandre Ramé and Johan Ferret and Peter Liu and Pouya Tafti and Abe Friesen and Michelle Casbon and Sabela Ramos and Ravin Kumar and Charline Le Lan and Sammy Jerome and Anton Tsitsulin and Nino Vieillard and Piotr Stanczyk and Sertan Girgin and Nikola Momchev and Matt Hoffman and Shantanu Thakoor and Jean-Bastien Grill and Behnam Neyshabur and Olivier Bachem and Alanna Walton and Aliaksei Severyn and Alicia Parrish and Aliya Ahmad and Allen Hutchison and Alvin Abdagic and Amanda Carl and Amy Shen and Andy Brock and Andy Coenen and Anthony Laforge and Antonia Paterson and Ben Bastian and Bilal Piot and Bo Wu and Brandon Royal and Charlie Chen and Chintu Kumar and Chris Perry and Chris Welty and Christopher A. Choquette-Choo and Danila Sinopalnikov and David Weinberger and Dimple Vijaykumar and Dominika Rogozińska and Dustin Herbison and Elisa Bandy and Emma Wang and Eric Noland and Erica Moreira and Evan Senter and Evgenii Eltyshev and Francesco Visin and Gabriel Rasskin and Gary Wei and Glenn Cameron and Gus Martins and Hadi Hashemi and Hanna Klimczak-Plucińska and Harleen Batra and Harsh Dhand and Ivan Nardini and Jacinda Mein and Jack Zhou and James Svensson and Jeff Stanway and Jetha Chan and Jin Peng Zhou and Joana Carrasqueira and Joana Iljazi and Jocelyn Becker and Joe Fernandez and Joost van Amersfoort and Josh Gordon and Josh Lipschultz and Josh Newlan and Ju-yeong Ji and Kareem Mohamed and Kartikeya Badola and Kat Black and Katie Millican and Keelin McDonell and Kelvin Nguyen and Kiranbir Sodhia and Kish Greene and Lars Lowe Sjoesund and Lauren Usui and Laurent Sifre and Lena Heuermann and Leticia Lago and Lilly McNealus and Livio Baldini Soares and Logan Kilpatrick and Lucas Dixon and Luciano Martins and Machel Reid and Manvinder Singh and Mark Iverson and Martin Görner and Mat Velloso and Mateo Wirth and Matt Davidow and Matt Miller and Matthew Rahtz and Matthew Watson and Meg Risdal and Mehran Kazemi and Michael Moynihan and Ming Zhang and Minsuk Kahng and Minwoo Park and Mofi Rahman and Mohit Khatwani and Natalie Dao and Nenshad Bardoliwalla and Nesh Devanathan and Neta Dumai and Nilay Chauhan and Oscar Wahltinez and Pankil Botarda and Parker Barnes and Paul Barham and Paul Michel and Pengchong Jin and Petko Georgiev and Phil Culliton and Pradeep Kuppala and Ramona Comanescu and Ramona Merhej and Reena Jana and Reza Ardeshir Rokni and Rishabh Agarwal and Ryan Mullins and Samaneh Saadat and Sara Mc Carthy and Sarah Cogan and Sarah Perrin and Sébastien M. R. Arnold and Sebastian Krause and Shengyang Dai and Shruti Garg and Shruti Sheth and Sue Ronstrom and Susan Chan and Timothy Jordan and Ting Yu and Tom Eccles and Tom Hennigan and Tomas Kocisky and Tulsee Doshi and Vihan Jain and Vikas Yadav and Vilobh Meshram and Vishal Dharmadhikari and Warren Barkley and Wei Wei and Wenming Ye and Woohyun Han and Woosuk Kwon and Xiang Xu and Zhe Shen and Zhitao Gong and Zichuan Wei and Victor Cotruta and Phoebe Kirk and Anand Rao and Minh Giang and Ludovic Peran and Tris Warkentin and Eli Collins and Joelle Barral and Zoubin Ghahramani and Raia Hadsell and D. Sculley and Jeanine Banks and Anca Dragan and Slav Petrov and Oriol Vinyals and Jeff Dean and Demis Hassabis and Koray Kavukcuoglu and Clement Farabet and Elena Buchatskaya and Sebastian Borgeaud and Noah Fiedel and Armand Joulin and Kathleen Kenealy and Robert Dadashi and Alek Andreev. Arxiv 2024
-
Jamba-1.5: Hybrid transformer-mamba models at scale. Jamba Team and Barak Lenz and Alan Arazi and Amir Bergman and Avshalom Manevich and Barak Peleg and Ben Aviram and Chen Almagor and Clara Fridman and Dan Padnos and Daniel Gissin and Daniel Jannai and Dor Muhlgay and Dor Zimberg and Edden M Gerber and Elad Dolev and Eran Krakovsky and Erez Safahi and Erez Schwartz and Gal Cohen and Gal Shachaf and Haim Rozenblum and Hofit Bata and Ido Blass and Inbal Magar and Itay Dalmedigos and Jhonathan Osin and Julie Fadlon and Maria Rozman and Matan Danos and Michael Gokhman and Mor Zusman and Naama Gidron and Nir Ratner and Noam Gat and Noam Rozen and Oded Fried and Ohad Leshno and Omer Antverg and Omri Abend and Opher Lieber and Or Dagan and Orit Cohavi and Raz Alon and Ro'i Belson and Roi Cohen and Rom Gilad and Roman Glozman and Shahar Lev and Shaked Meirom and Tal Delbari and Tal Ness and Tomer Asida and Tom Ben Gal and Tom Braude and Uriya Pumerantz and Yehoshua Cohen and Yonatan Belinkov and Yuval Globerson and Yuval Peleg Levy and Yoav Shoham. Arxiv 2024
-
RecurrentGemma: Moving Past Transformers for Efficient Open Language Models. Aleksandar Botev and Soham De and Samuel L Smith and Anushan Fernando and George-Cristian Muraru and Ruba Haroun and Leonard Berrada and Razvan Pascanu and Pier Giuseppe Sessa and Robert Dadashi and Léonard Hussenot and Johan Ferret and Sertan Girgin and Olivier Bachem and Alek Andreev and Kathleen Kenealy and Thomas Mesnard and Cassidy Hardin and Surya Bhupatiraju and Shreya Pathak and Laurent Sifre and Morgane Rivière and Mihir Sanjay Kale and Juliette Love and Pouya Tafti and Armand Joulin and Noah Fiedel and Evan Senter and Yutian Chen and Srivatsan Srinivasan and Guillaume Desjardins and David Budden and Arnaud Doucet and Sharad Vikram and Adam Paszke and Trevor Gale and Sebastian Borgeaud and Charlie Chen and Andy Brock and Antonia Paterson and Jenny Brennan and Meg Risdal and Raj Gundluru and Nesh Devanathan and Paul Mooney and Nilay Chauhan and Phil Culliton and Luiz Gustavo Martins and Elisa Bandy and David Huntsperger and Glenn Cameron and Arthur Zucker and Tris Warkentin and Ludovic Peran and Minh Giang and Zoubin Ghahramani and Clément Farabet and Koray Kavukcuoglu and Demis Hassabis and Raia Hadsell and Yee Whye Teh and Nando de Frietas. Arxiv 2024
-
The Zamba2 Suite: Technical Report. Paolo Glorioso and Quentin Anthony and Yury Tokpanov and Anna Golubeva and Vasudev Shyam and James Whittington and Jonathan Pilault and Beren Millidge. Arxiv 2024
-
You only cache once: Decoder-decoder architectures for language models. Yutao Sun and Li Dong and Yi Zhu and Shaohan Huang and Wenhui Wang and Shuming Ma and Quanlu Zhang and Jianyong Wang and Furu Wei. Arxiv 2024
-
Artificial Hippocampus Networks for Efficient Long-Context Modeling. Yunhao Fang, Weihao Yu, Shu Zhong, Qinghao Ye, Xuehan Xiong, Lai Wei. Arxiv 2025.
-
Massive Activations in Hybrid Linear Attention Large Language Models: Pre-Attention Spikes and Inter-Spike Plateaus. Zunhai Su, Bohan Sun, Xialie Zhuang, Shuibai Zhang, He Xiao, Jing Xiong, Hengyuan Zhang, Zhongzhu Zhou, Tiantian Zhang, Ngai Wong, Chuan-Wei Kuo. Arxiv 2026.
-
Mamba with Hierarchical Memory: Solving Representation Bottleneck in Long Sequence Modeling. Qinwen Wang, Jieping Luo, Aoxiang Qin, Ruoyu Zhao, Jianxiong Tang, Wei Zhang, Zhichao Lu, Luziwei Leng. Arxiv 2026.
-
Retrofitting Linear Attention into Diffusion Language Models. Jinha Kim, Younghun Roh, Jaeyeon Kim. Arxiv 2026.
-
Muon Meets Mamba: Spectral Optimization for State Space Models. Arslan Battalov, Karim Kramin, Alexander Markotenko, Sofia Sinitsina. Arxiv 2026.
-
DART: Decoded Attention over Recurrent States for Efficient Long-Context Sequence Modeling. Yixiao Qian, Song Chen, Pengkai Wang, Jiaxu Liu, Shengze Cai, Chao Xu. Arxiv 2026.
-
MARCH: Scaling Recurrent Memory with Content-Routed State Anchors. Ming Zhang, Kaisen Yang, Shu Yu, Ermo Hua, Ning Ding, Xia Hu, Bowen Zhou, Chaochao Lu, Youbang Sun. Arxiv 2026.
-
StateFlow: Sequence Pipeline Parallelism for Long-Context Modeling with Linear Recurrence. Wenxuan Zhao, Yingfa Chen, Xu Han, Wenjing Han, Tianbo Huang, Zhiyu Li, Ao Sun, Jingheng Xu, Lin Gan, Guangwen Yang. Arxiv 2026.


Workflow Design
Prompt Compression
- Prompt Compression for Large Language Models: A Survey. Zongqian Li, Yinhong Liu, Yixuan Su, Nigel Collier. Arxiv 2024.
Hard Prompt Compression
-
LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models. Huiqiang Jiang, Qianhui Wu, Chin-Yew Lin, Yuqing Yang, Lili Qiu. Arxiv 2023.
-
LongLLMLingua: Accelerating and Enhancing LLMs in Long Context Scenarios via Prompt Compression. Huiqiang Jiang, Qianhui Wu, Xufang Luo, Dongsheng Li, Chin-Yew Lin, Yuqing Yang, Lili Qiu. Arxiv 2023.
-
LLMLingua-2: Data Distillation for Efficient and Faithful Task-Agnostic Prompt Compression. Zhuoshi Pan, Qianhui Wu, Huiqiang Jiang, Menglin Xia, Xufang Luo, Jue Zhang, Qingwei Lin, Victor Rühle, Yuqing Yang, Chin-Yew Lin, H. Vicky Zhao, Lili Qiu, Dongmei Zhang. Arxiv 2024.
-
Compressing Context to Enhance Inference Efficiency of Large Language Models. Yucheng Li, Bo Dong, Chenghua Lin, Frank Guerin. Arxiv 2023.
-
TACO-RL: Task Aware Prompt Compression Optimization with Reinforcement Learning. Shivam Shandilya, Menglin Xia, Supriyo Ghosh, Huiqiang Jiang, Jue Zhang, Qianhui Wu, Victor Rühle. Arxiv 2024.
-
Prompt Compression with Context-Aware Sentence Encoding for Fast and Improved LLM Inference. Barys Liskavets, Maxim Ushakov, Shuvendu Roy, Mark Klibanov, Ali Etemad, Shane Luke. Arxiv 2024.
-
AdaComp: Extractive Context Compression with Adaptive Predictor for Retrieval-Augmented Large Language Models. Qianchi Zhang, Hainan Zhang, Liang Pang, Hongwei Zheng, Zhiming Zheng. Arxiv 2024.
-
Learning to Compress Prompt in Natural Language Formats. Yu-Neng Chuang, Tianwei Xing, Chia-Yuan Chang, Zirui Liu, Xun Chen, Xia Hu. Arxiv 2024.
-
{TCRA}-{LLM}: Token Compression Retrieval Augmented Large Language Model for Inference Cost Reduction. Junyi Liu, Liangzhi Li, Tong Xiang, Bowen Wang, Yiming Qian. Arxiv 2023
-
Familiarity-Aware Evidence Compression for Retrieval-Augmented Generation. Dongwon Jung, Qin Liu, Tenghao Huang, Ben Zhou, Muhao Chen. Arxiv 2024
-
Discrete Prompt Compression With Reinforcement Learning. Hoyoun Jung, Kyung-Joong Kim. Arxiv 2024
-
CompAct: Compressing Retrieved Documents Actively for Question Answering. Chanwoong Yoon, Taewhoo Lee, Hyeon Hwang, Minbyul Jeong, Jaewoo Kang. Arxiv 2024
-
EXIT: Context-Aware Extractive Compression for Enhancing Retrieval-Augmented Generation. Taeho Hwang, Sukmin Cho, Soyeong Jeong, Hoyun Song, SeungYoon Han, Jong C. Park. Arxiv 2024.
-
Selection-p: Self-Supervised Task-Agnostic Prompt Compression for Faithfulness and Transferability. Tsz Ting Chung, Leyang Cui, Lemao Liu, Xinting Huang, Shuming Shi, Dit-Yan Yeung. EMNLP 2024.
-
Visual Text Compression as Measure Transport. Lv Tang, Tianyi Zheng, Yang Liu, Bo Li, Xingyu Li. Arxiv 2026.
-
AgentOCR: Reimagining Agent History via Optical Self-Compression. Lang Feng, Fuchao Yang, Feng Chen, Xin Cheng, Haiyang Xu, Zhenglin Wan, Ming Yan, Bo An. Arxiv 2026.
-
ZipRL: Adaptive Multi-Turn Context Compression with Hindsight Response Replay. Zhexin Hu, Li Wang, Xiaohan Wang, Jiajun Chai, Xiaojun Guo, Wei Lin, Guojun Yin. Arxiv 2026.
-
Relevant but Incomplete: Referential Dangling as a Paradigm-Level Failure Mode in Hard Prompt Compression. Zhengpei Hu, Kai Li, Dapeng Fu, Xuechao Zou, Yuanhao Tang, Yue Li, Tengfei Cao, Jianqiang Huang. Arxiv 2026.
-
SALT: Salience-Aware Lexical Trie for Long-Context Compression. Oteo Mamo, Hyunjin Yi, Joydhriti Choudhury, Shangqian Gao, Weikuan Yu. Arxiv 2026.
-
Every Time I Hire a Linguist, Inference Costs Go Down: On Linguistic Rules as Effective Prompt Compressors. Jianfei Ma, Zhaoxin Feng, Emmanuele Chersoni, Si Chen. Arxiv 2026.
-
PReM: Learning What to Preserve and When to Refresh for Context Compression. Bohan Yu, Lei Shen, Chenxi Zhou, Chen Han, Junlin Liu, Wenbo Su, Yu Cheng, Bo Zheng. Arxiv 2026.
-
Context Compression Is Not One Thing: Readable Symbolic Re-expression vs. Coherent Summary at Matched Budget. Sisong Bei, Mikhail L. Arbuzov, Ziwei Dong, Dmitri Kalaev, Alexey Shvets. Arxiv 2026.


Soft Prompt Compression
-
Adapting Language Models to Compress Contexts. Alexis Chevalier, Alexander Wettig, Anirudh Ajith, Danqi Chen. Arxiv 2023.
-
xRAG: Extreme Context Compression for Retrieval-augmented Generation with One Token. Xin Cheng, Xun Wang, Xingxing Zhang, Tao Ge, Si-Qing Chen, Furu Wei, Huishuai Zhang, Dongyan Zhao. Arxiv 2024.
-
In-context Autoencoder for Context Compression in a Large Language Model. Tao Ge, Hu Jing, Lei Wang, Xun Wang, Si-Qing Chen, Furu Wei. ICLR 2024.
-
The Power of Scale for Parameter-Efficient Prompt Tuning. Brian Lester, Rami Al-Rfou, Noah Constant. Arxiv 2021
-
Prompt Compression and Contrastive Conditioning for Controllability and Toxicity Reduction in Language Models. David Wingate, Mohammad Shoeybi, Taylor Sorensen. Arxiv 2022
-
Learning to Compress Prompts with Gist Tokens. Jesse Mu, Xiang Lisa Li, Noah Goodman. Arxiv 2024
-
Unifying Demonstration Selection and Compression for In-Context Learning. Jun Gao, Ziqiang Cao, Wenjie Li. Arxiv 2024
-
Long Context Compression with Activation Beacon. Peitian Zhang, Zheng Liu, Shitao Xiao, Ninglu Shao, Qiwei Ye, Zhicheng Dou. Arxiv 2024
-
500xCompressor: Generalized Prompt Compression for Large Language Models. Zongqian Li, Yixuan Su, Nigel Collier. Arxiv 2024
-
DivPrune: Diversity-based Visual Token Pruning for Large Multimodal Models. Saeed Ranjbar Alvar, Gursimran Singh, Mohammad Akbari, Yong Zhang. Arxiv 2025.
-
EFPC: Towards Efficient and Flexible Prompt Compression. Yun-Hao Cao, Yangsong Wang, Shuzheng Hao, Zhenxing Li, Chengjun Zhan, Sichao Liu, Yi-Qi Hu. Arxiv 2025.
-
AttentionRAG: Attention-Guided Context Pruning in Retrieval-Augmented Generation. Yixiong Fang, Tianran Sun, Yuling Shi, Xiaodong Gu. Arxiv 2025.
-
Limits of KV Cache Compression for Tensor Attention based Autoregressive Transformers. Yifang Chen, Xiaoyu Li, Yingyu Liang, Zhenmei Shi, Zhao Song, Yu Tian. Arxiv 2025.
-
Hybrid-Level Instruction Injection for Video Token Compression in Multi-modal Large Language Models. Zhihang Liu, Chen-Wei Xie, Pandeng Li, Liming Zhao, Longxiang Tang, Yun Zheng, Chuanbin Liu, Hongtao Xie. CVPR 2025.
-
Token Dynamics: Towards Efficient and Dynamic Video Token Representation for Video Large Language Models. Haichao Zhang, Zhuowei Li, Dimitris Metaxas, Yun Fu. Arxiv 2025.
-
A Silver Bullet or a Compromise for Full Attention? A Comprehensive Study of Gist Token-based Context Compression. Chenlong Deng, Zhisong Zhang, Kelong Mao, Shuaiyi Li, Xinting Huang, Dong Yu, Zhicheng Dou. Arxiv 2024.
-
Layer- and Timestep-Adaptive Differentiable Token Compression Ratios for Efficient Diffusion Transformers. Haoran You, Connelly Barnes, Yuqian Zhou, Yan Kang, Zhenbang Du, Wei Zhou, Lingzhi Zhang, Yotam Nitzan, Xiaoyang Liu, Zhe Lin, Eli Shechtman, Sohrab Amirghodsi, Yingyan Celine Lin. Arxiv 2024.
-
Efficient Prompt Compression with Evaluator Heads for Long-Context Transformer Inference. Weizhi Fei, Xueyan Niu, Guoqing Xie, Yingqing Liu, Bo Bai, Wei Han. Arxiv 2025.
-
Understanding and Improving Information Preservation in Prompt Compression for LLMs. Weronika Łajewska, Momchil Hardalov, Laura Aina, Neha Anna John, Hang Su, Lluís Màrquezu. Arxiv 2025.
-
Fwd2Bot: LVLM Visual Token Compression with Double Forward Bottleneck. Adrian Bulat, Yassine Ouali, Georgios Tzimiropoulos. Arxiv 2025.
-
Efficient Dynamic Clustering-Based Document Compression for Retrieval-Augmented-Generation. Weitao Li, Kaiming Liu, Xiangyu Zhang, Xuanyu Lei, Weizhi Ma, Yang Liu. Arxiv 2025.
-
Saliency-driven Dynamic Token Pruning for Large Language Models. Yao Tao, Yehui Tang, Yun Wang, Mingjian Zhu, Hailin Hu, Yunhe Wang. Arxiv 2025.
-
Dynamic Compressing Prompts for Efficient Inference of Large Language Models. Jinwu Hu, Wei Zhang, Yufeng Wang, Yu Hu, Bin Xiao, Mingkui Tan, Qing Du. Arxiv 2025.
-
ACoRN: Noise-Robust Abstractive Compression in Retrieval-Augmented Language Models. Singon Kim, Gunho Jung, Seong-Whan Lee. Arxiv 2025.
-
MOOSComp: Improving Lightweight Long-Context Compressor via Mitigating Over-Smoothing and Incorporating Outlier Scores. Fengwei Zhou, Jiafei Song, Wenjin Jason Li, Gengjian Xue, Zhikang Zhao, Yichao Lu, Bailin Na. Arxiv 2025.
-
Token Sequence Compression for Efficient Multimodal Computing. Yasmine Omri, Parth Shroff, Thierry Tambe. Arxiv 2025.
-
An Empirical Study on Prompt Compression for Large Language Models. Zheng Zhang, Jinyi Li, Yihuai Lan, Xiang Wang, Hao Wang. Arxiv 2025.
-
Video Compression Commander: Plug-and-Play Inference Acceleration for Video Large Language Models. Xuyang Liu, Yiyu Wang, Junpeng Ma, Linfeng Zhang. Arxiv 2025.
-
Beyond Hard and Soft: Hybrid Context Compression for Balancing Local and Global Information Retention. Huanxuan Liao, Wen Hu, Yao Xu, Shizhu He, Jun Zhao, Kang Liu. Arxiv 2025.
-
QwenLong-CPRS: Towards ∞-LLMs with Dynamic Context Optimization. Weizhou Shen, Chenliang Li, Fanqi Wan, Shengyi Liao, Shaopeng Lai, Bo Zhang, Yingcheng Shi, Yuning Wu, Gang Fu, Zhansheng Li, Bin Yang, Ji Zhang, Fei Huang, Jingren Zhou, Ming Yan. Arxiv 2025.
-
Lossless Token Sequence Compression via Meta-Tokens. John Harvill, Ziwei Fan, Hao Wang, Yizhou Sun, Hao Ding, Luke Huan, Anoop Deoras. Arxiv 2025.
-
Sentinel: Attention Probing of Proxy Models for LLM Context Compression with an Understanding Perspective. Yong Zhang, Yanwen Huang, Ning Cheng, Yang Guo, Yun Zhu, Yanmeng Wang, Shaojun Wang, Jing Xiao. Arxiv 2025.
-
METok: Multi-Stage Event-based Token Compression for Efficient Long Video Understanding. Mengyue Wang, Shuo Chen, Kristian Kersting, Volker Tresp, Yunpu Ma. Arxiv 2025.
-
SecurityLingua: Efficient Defense of LLM Jailbreak Attacks via Security-Aware Prompt Compression. Yucheng Li, Surin Ahn, Huiqiang Jiang, Amir H. Abdi, Yuqing Yang, Lili Qiu. Arxiv 2025.
-
Chain-of-Thought Compression Should Not Be Blind: V-Skip for Efficient Multimodal Reasoning via Dual-Path Anchoring. Dongxu Zhang, Yiding Sun, Cheng Tan, Wenbiao Yan, Ning Yang, Jihua Zhu, Hiajun Zhang. Arxiv 2025.
-
Context Cascade Compression: Exploring the Upper Limits of Text Compression. Fanfan Liu, Haibo Qiu. Arxiv 2025.
-
CompressKV: Semantic Retrieval Heads Know What Tokens are Not Important Before Generation Xiaolin Lin, Jingcun Wang, Olga Kondrateva, Yiyu Shi, Bing Li, Grace Li Zhang. Arxiv 2025.
-
UniGist: Towards General and Hardware-aligned Sequence-level Long Context Compression Chenlong Deng, Zhisong Zhang, Kelong Mao, Shuaiyi Li, Tianqing Fang, Hongming Zhang, Haitao Mi, Dong Yu, Zhicheng Dou. Arxiv 2025.
-
ProCut: LLM Prompt Compression via Attribution Estimation Zhentao Xu, Fengyi Li, Albert Chen, Xiaofeng Wang. Arxiv 2025.
-
DSPC: Dual-Stage Progressive Compression Framework for Efficient Long-Context Reasoning Yaxin Gao, Yao Lu, Zongfei Zhang, Jiaqi Nie, Shanqing Yu, Qi Xuan. Arxiv 2025.
-
AttnComp: Attention-Guided Adaptive Context Compression for Retrieval-Augmented Generation Lvzhou Luo, Yixuan Cao, Ping Luo. Arxiv 2025.
-
LongCodeZip: Compress Long Context for Code Language Models Yuling Shi, Yichun Qian, Hongyu Zhang, Beijun Shen, Xiaodong Gu. Arxiv 2025.
-
ILRe: Intermediate Layer Retrieval for Context Compression in Causal Language Models Manlai Liang, Mandi Liu, Jiangzhou Ji, Huaijun Li, Haobo Yang, Yaohan He, Jinlong Li. Arxiv 2025.
-
DeepSeek-OCR: Contexts Optical Compression Haoran Wei, Yaofeng Sun, Yukun Li. Arxiv 2025.
-
Simple Context Compression: Mean-Pooling and Multi-Ratio Training Yair Feldman, Yoav Artzi. Arxiv 2025.
-
LLM Compression: How Far Can We Go in Balancing Size and Performance? Sahil Sk, Debasish Dhal, Sonal Khosla, Sk Shahid, Sambit Shekhar, Akash Dhaka, Shantipriya Parida, Dilip K. Prasad, Ondřej Bojar. Arxiv 2025.
-
One Shot vs. Iterative: Rethinking Pruning Strategies for Model Compression Mikołaj Janusz, Tomasz Wojnar, Yawei Li, Luca Benini, Kamil Adamczewski. Arxiv 2025.
-
Reasoning Efficiently Through Adaptive Chain-of-Thought Compression: A Self-Optimizing Framework Kerui Huang, Shuhan Liu, Xing Hu, Tongtong Xu, Lingfeng Bao, Xin Xia. Arxiv 2025.
-
From Long to Lean: Performance-aware and Adaptive Chain-of-Thought Compression via Multi-round Refinement Jianzhi Yan, Le Liu, Youcheng Pan, Shiwei Chen, Zike Yuan, Yang Xiang, Buzhou Tang. Arxiv 2025.
-
R-Capsule: Compressing High-Level Plans for Efficient Large Language Model Reasoning Hongyu Shan, Mingyang Song, Chang Dai, Di Liang, Han Chen. Arxiv 2025.
-
Representation Shift: Unifying Token Compression with FlashAttention Joonmyung Choi, Sanghyeok Lee, Byungoh Ko, Eunseo Kim, Jihyung Kil, Hyunwoo J. Kim. Arxiv 2025.
-
A Glimpse to Compress: Dynamic Visual Token Pruning for Large Vision-Language Models Quan-Sheng Zeng, Yunheng Li, Qilong Wang, Peng-Tao Jiang, Zuxuan Wu, Ming-Ming Cheng, Qibin Hou. Arxiv 2025.
-
Fourier-VLM: Compressing Vision Tokens in the Frequency Domain for Large Vision-Language Models Huanyu Wang, Jushi Kai, Haoli Bai, Lu Hou, Bo Jiang, Ziwei He, Zhouhan Lin. Arxiv 2025.
-
Seeing More, Saying More: Lightweight Language Experts are Dynamic Video Token Compressors Arxiv 2025.
-
MARC: Memory-Augmented RL Token Compression for Efficient Video Understanding Peiran Wu, Zhuorui Yu, Yunze Liu, Chi-Hao Wu, Enmin Zhou, Junxiao Shen. Arxiv 2025.
-
VisionSelector: End-to-End Learnable Visual Token Compression for Efficient Multimodal LLMs Jiaying Zhu, Yurui Zhu, Xin Lu, Wenrui Yan, Dong Li, Kunlin Liu, Xueyang Fu, Zheng-Jun Zha. Arxiv 2025.
-
StreamingTOM: Streaming Token Compression for Efficient Video Understanding Xueyi Chen, Keda Tao, Kele Shao, Huan Wang. Arxiv 2025.
-
FLoC: Facility Location-Based Efficient Visual Token Compression for Long Video Understanding Janghoon Cho, Jungsoo Lee, Munawar Hayat, Kyuwoong Hwang, Fatih Porikli, Sungha Choi. Arxiv 2025.
-
Can Visual Input Be Compressed? A Visual Token Compression Benchmark for Large Multimodal Models Tianfan Peng, Yuntao Du, Pengzhou Ji, Shijie Dong, Kailin Jiang, Mingchuan Ma, Yijun Tian, Jinhe Bi, Qian Li, Wei Du, Feng Xiao, Lizhen Cui. Arxiv 2025.
-
VideoCompressa: Data-Efficient Video Understanding via Joint Temporal Compression and Spatial Reconstruction Shaobo Wang, Tianle Niu, Runkang Yang, Deshan Liu, Xu He, Zichen Wen, Conghui He, Xuming Hu, Linfeng Zhang. Arxiv 2025.
-
LLaVA-UHD v3: Progressive Visual Compression for Efficient Native-Resolution Encoding in MLLMs Shichu Sun, Yichen Zhang, Haolin Song, Zonghao Guo, Chi Chen, Yidan Zhang, Yuan Yao, Zhiyuan Liu, Maosong Sun. Arxiv 2025.
-
Compressor-VLA: Instruction-Guided Visual Token Compression for Efficient Robotic Manipulation Juntao Gao, Feiyang Ye, Jing Zhang, Wenjing Qian. Arxiv 2025.
-
UniComp: Rethinking Video Compression Through Informational Uniqueness Chao Yuan, Shimin Chen, Minliang Lin, Limeng Qiao, Guanglu Wan, Lin Ma. Arxiv 2025.
-
SSPO: Self-traced Step-wise Preference Optimization for Process Supervision and Reasoning Compression Yuyang Xu, Yi Cheng, Haochao Ying, Zhuoyun Du, Renjun Hu, Xing Shi, Wei Lin, Jian Wu. Arxiv 2025.
-
LeanK: Learnable K Cache Channel Pruning for Efficient Decoding Yike Zhang, Zhiyuan He, Huiqiang Jiang, Chengruidong Zhang, Yuqing Yang, Jianyong Wang, Lili Qiu. Arxiv 2025.
-
SlimInfer: Accelerating Long-Context LLM Inference via Dynamic Token Pruning Lingkun Long, Rubing Yang, Yushi Huang, Desheng Hui, Ao Zhou, Jianlei Yang. Arxiv 2025.
-
E3-Pruner: Towards Efficient, Economical, and Effective Layer Pruning for Large Language Models Tao Yuan, Haoli Bai, Yinfei Pan, Xuyang Cao, Tianyu Zhang, Lu Hou, Ting Hu, Xianzhi Yu. Arxiv 2025.
-
SCOPE: Saliency-Coverage Oriented Token Pruning for Efficient Multimodel LLMs Jinhong Deng, Wen Li, Joey Tianyi Zhou, Yang He. Arxiv 2025.
-
Pruning the Unsurprising: Efficient Code Reasoning via First-Token Surprisal Wenhao Zeng, Yaoning Wang, Chao Hu, Yuling Shi, Chengcheng Wan, Hongyu Zhang, Xiaodong Gu. Arxiv 2025.
-
Large Language Model as Token Compressor and Decompressor. Wenbing Li, Zikai Song, Jielei Zhang, Tianhao Zhao, Junkai Lin, Yiran Wang, Wei Yang. Arxiv 2026.
-
Density-aware Soft Context Compression with Semi-Dynamic Compression Ratio. Yijiong Yu, Shuai Yuan, Jie Zheng, Huazheng Wang, Ji Pei. Arxiv 2026.
-
Latent Context Compilation: Distilling Long Context into Compact Portable Memory. Zeju Li, Yizhou Zhou, Qiang Xu. Arxiv 2026.
-
The Sleeping Agent: What Gist-Based Context Compression Loses and Why. Nicholas E. Kyrkewood. Arxiv 2026.
-
VLZip: Unified Visual and Textual Compression for Interleaved Long-Context Modeling. Yuqi Zhang, Cheng Chen, Yuyu Guo, Wenjie Yang, Lingchen Meng, Peng Di, Hang Yu, Zuxuan Wu, Yu-Gang Jiang. Arxiv 2026.


Memory-Based
-
Towards Teachable Reasoning Systems: Using a Dynamic Memory of User Feedback for Continual System Improvement. Bhavana Dalvi Mishra, Oyvind Tafjord, Peter Clark. EMNLP 2022
-
Augmenting Language Models with Long-Term Memory. Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao, Furu Wei. NeurIPS 2023
-
{MEMORYLLM:} Towards Self-Updatable Large Language Models. Yu Wang, Yifan Gao, Xiusi Chen, Haoming Jiang, Shiyang Li, Jingfeng Yang, Qingyu Yin, Zheng Li, Xian Li, Bing Yin, Jingbo Shang, Julian J. McAuley. ICML 2024
-
MemoryBank: Enhancing Large Language Models with Long-Term Memory. Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, Yanlin Wang. Arxiv 2023.
-
You Only Read Once (YORO): Learning to Internalize Database Knowledge for Text-to-SQL. Hideo Kobayashi, Wuwei Lan, Peng Shi, Shuaichen Chang, Jiang Guo, Henghui Zhu, Zhiguo Wang, Patrick Ng. NAACL 2025
-
KVSink: Understanding and Enhancing the Preservation of Attention Sinks in KV Cache Quantization for LLMs Zunhai Su, Kehong Yuan. Arxiv 2025.
-
XQuant: Breaking the Memory Wall for LLM Inference with KV Cache Rematerialization Aditya Tomar, Coleman Hooper, Minjae Lee, Haocheng Xi, Rishabh Tiwari, Wonjun Kang, Luca Manolache, Michael W. Mahoney, Kurt Keutzer, Amir Gholami. Arxiv 2025.
-
Sparse Attention across Multiple-context KV Cache Ziyi Cao, Qingyi Si, Jingbin Zhang, Bingquan Liu. Arxiv 2025.
-
SparK: Query-Aware Unstructured Sparsity with Recoverable KV Cache Channel Pruning Huanxuan Liao, Yixing Xu, Shizhu He, Guanchen Li, Xuanwu Yin, Dong Li, Emad Barsoum, Jun Zhao, Kang Liu. Arxiv 2025.
-
Spotlight Attention: Towards Efficient LLM Generation via Non-linear Hashing-based KV Cache Retrieval Wenhao Li, Yuxin Zhang, Gen Luo, Haiyuan Wan, Ziyang Gong, Fei Chao, Rongrong Ji. Arxiv 2025.
-
GraphKV: Breaking the Static Selection Paradigm with Graph-Based KV Cache Eviction Xuelin Li, Xiangqi Jin, Linfeng Zhang. Arxiv 2025.
-
KVCompose: Efficient Structured KV Cache Compression with Composite Tokens Dmitry Akulov, Mohamed Sana, Antonio De Domenico, Tareq Si Salem, Nicola Piovesan, Fadhel Ayed. Arxiv 2025.
-
EvolKV: Evolutionary KV Cache Compression for LLM Inference Bohan Yu, Yekun Chai. Arxiv 2025.
-
LAVa: Layer-wise KV Cache Eviction with Dynamic Budget Allocation Yiqun Shen, Song Yuan, Zhengze Zhang, Xiaoliang Wang, Daxin Jiang, Nguyen Cam-Tu. Arxiv 2025.
-
EpiCache: Episodic KV Cache Management for Long Conversational Question Answering Arxiv 2025.
-
OjaKV: Context-Aware Online Low-Rank KV Cache Compression with Oja's Rule Yuxuan Zhu, David H. Yang, Mohammad Mohammadi Amiri, Keerthiram Murugesan, Tejaswini Pedapati, Pin-Yu Chen. Arxiv 2025.
-
StreamKV: Streaming Video Question-Answering with Segment-based KV Cache Retrieval and Compression Yilong Chen, Xiang Bai, Zhibin Wang, Chengyu Bai, Yuhan Dai, Ming Lu, Shanghang Zhang. Arxiv 2025.
-
Revisiting Multimodal KV Cache Compression: A Frequency-Domain-Guided Outlier-KV-Aware Approach Yaoxin Yang, Peng Ye, Xudong Tan, Chongjun Tu, Maosen Zhao, Jia Hao, Tao Chen. Arxiv 2025.
-
LightVLM: Acceleraing Large Multimodal Models with Pyramid Token Merging and KV Cache Compression Arxiv 2025.
-
δ-mem: Efficient Online Memory for Large Language Models. Jingdi Lei, Di Zhang, Junxian Li, Weida Wang, Kaixuan Fan, Xiang Liu, Qihan Liu, Xiaoteng Ma, Baian Chen, Soujanya Poria. Arxiv 2026.
-
Omni-SimpleMem: Autoresearch-Guided Discovery of Lifelong Multimodal Agent Memory. Jiaqi Liu, Zipeng Ling, Shi Qiu, Yanqing Liu, Siwei Han, Peng Xia, Haoqin Tu, Zeyu Zheng, Cihang Xie, Charles Fleming, Mingyu Ding, Huaxiu Yao. Arxiv 2026.
-
Thinking Ahead: Prospection-Guided Retrieval of Memory with Language Models. Harshita Chopra et al. Arxiv 2026.
-
Cognifold: Always-On Proactive Memory via Cognitive Folding. Suli Wang, Yiqun Duan, Yu Deng, Rundong Zhao, Dai Shi, Xinliang Zhou. Arxiv 2026.
-
A Heterogeneous Temporal Memory Governance Framework for Long-Term LLM Persona Consistency. Zhao Yang, Wang Huan, Li Yingshuo, Tu Haomiao, Lin Hujite. Arxiv 2026.
-
Improving Multi-turn Dialogue Consistency with Self-Recall Thinking. Renning Pang, Tian Lan, Leyuan Liu, Xiaoming Huang, Piao Tong, Xiaosong Zhang. Arxiv 2026.
-
Fast-weight Product Key Memory. Tianyu Zhao, Llion Jones. Arxiv 2026.
-
Human-Like Lifelong Memory: A Neuroscience-Grounded Architecture for Infinite Interaction. Diego C. Lerma-Torres. Arxiv 2026.
-
Explore with Long-term Memory: A Benchmark and Multimodal LLM-based Reinforcement Learning Framework for Embodied Exploration. Sen Wang, Bangwei Liu, Zhenkun Gao, Lizhuang Ma, Xuhong Wang, Yuan Xie, Xin Tan. Arxiv 2026.
-
Can Coding Agents Externalize Long-Context Processing? Weili Cao, Xunjian Yin, Bhuwan Dhingra, Shuyan Zhou. Arxiv 2026.
-
Metis: Memory Foundation Model. Zeyu Zhang, Ziliang Guo, Yihang Sun, Xichong Zhang, Xixuan Hao, Zehao Lin, Yang Zhang, Xiaoyan Zhao, Tong Shen, Bo Tang, Zhi-Qin John Xu, Junchi Yan, Haofen Wang, Xu Chen, Feiyu Xiong, Zhiyu Li, Tat-Seng Chua. Arxiv 2026.
-
PI-Mem: Pushing Long-Context Reasoning to 3.6M Tokens with Parallel-Iterative Memory. Dawei Liu, Haixu Song, Shuang Cheng, Shijie Wang, Haozheng Hou, Kaifeng Liu, Ermo Hua, Zhonghang Yuan, Zhijie Zhong, Yuchen Fan, Biqing Qi, Bowen Zhou. Arxiv 2026.
-
RippleMem: From Isolated Retrieval to Associative Recollection for Long-Term Agent Memory. Jingbo Ji, Lingyi Li, Xilong Cheng, Yuhao Zhou, Wenji Zhang, Yuting Tan, Yunxiao Qin. Arxiv 2026.
-
MemoryLake on MemoryArena: A Matched Study of Agent Memory Backends. Chaoqun Zhan, Qiang Zhou, Guannan Li, Zhenqiang Huang, Qianjin Wang. Arxiv 2026.
-
LycheeMemory V2: Efficient Long-Term Memory for LLM Agents via Semantic Segment-Level Consolidation. Dongfang Li, Zixuan Liu, Junmai Wang, Jiahe Huang, Fuhao Li, Bonian Jia, Baotian Hu, Min Zhang. Arxiv 2026.
-
MESA:Task-Adaptive Multi-Structure Evidence Selection for Long-Horizon Agent Memory. Beidi Zhao, Yaoqi Chen, Yuru Feng, Menghao Li, Qianxi Zhang, Baotong Lu, Jianan Lu, Zhirui Wang, Xinjiang Wang, Shusen Xu, Zengzhong Li, Xiaoxiao Li, Qi Chen. Arxiv 2026.
-
MemoryCPT: An End-to-End Agent Memory Framework for Cost-Performance Trade-off. Songxin Lei, Kun Ouyang, Weilin Ruan, Yuqian Wu, Zhijiang Guo, Yushi Sun, Fugee Tsung. Arxiv 2026.
-
Caching for the Future: Scrub Jay Episodic Memory Principles for Agent Memory Systems. Kartikey Singh Bhandari, Aarya Wadhwani, Dhruv Kumar, Pratik Narang. Arxiv 2026.
-
Towards a Formal Definition of Agent Memory: Basis, Span, Optimality, and the Sequential Memory Problem. Hongyao Tang. Arxiv 2026.
-
SeDeM: Selective Decompression of Hidden-State Memories for Long-Context Question Answering. Maryam Haghifam, Jason Cong, Yizhou Sun. Arxiv 2026.


RAG-Based
-
{BERT}: Pre-training of Deep Bidirectional Transformers for Language Understanding. Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova. ACL 2019
-
Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering. Gautier Izacard, Edouard Grave. ACL 2021
-
RepoCoder: Repository-Level Code Completion Through Iterative Retrieval and Generation. Fengji Zhang, Bei Chen, Yue Zhang, Jacky Keung, Jin Liu, Daoguang Zan, Yi Mao, Jian{-}Guang Lou, Weizhu Chen. EMNLP 2023
-
Query Rewriting in Retrieval-Augmented Large Language Models. Xinbei Ma, Yeyun Gong, Pengcheng He, hai zhao, Nan Duan. EMNLP 2023
-
{REPLUG}: Retrieval-Augmented Black-Box Language Models. Weijia Shi, Sewon Min, Michihiro Yasunaga, Minjoon Seo, Richard James, Mike Lewis, Luke Zettlemoyer, Wen-tau Yih. ACL 2024
-
{BGE} M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation. Jianlv Chen, Shitao Xiao, Peitian Zhang, Kun Luo, Defu Lian, Zheng Liu. Arxiv 2024
-
Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. Benjamin Warner, Antoine Chaffin, Benjamin Clavié, Orion Weller, Oskar Hallström, Said Taghadouini, Alexis Gallagher, Raja Biswas, Faisal Ladhak, Tom Aarsen, Nathan Cooper, Griffin Adams, Jeremy Howard, Iacopo Poli. Arxiv 2024
-
Beyond RAG: Task-Aware KV Cache Compression for Comprehensive Knowledge Reasoning. Giulio Corallo, Orion Weller, Fabio Petroni, Paolo Papotti. Arxiv 2025.
-
Efficient Many-Shot In-Context Learning with Dynamic Block-Sparse Attention. Emily Xiao, Chin-Jou Li, Yilin Zhang, Graham Neubig, Amanda Bertsch. Arxiv 2025.
-
Conflict-Aware Soft Prompting for Retrieval-Augmented Generation Arxiv 2025.
-
Why Neighborhoods Matter: Traversal Context and Provenance in Agentic GraphRAG. Riccardo Terrenzi, Maximilian von Zastrow, Serkan Ayvaz. Arxiv 2026.
-
Why Retrieval-Augmented Generation Fails: A Graph Perspective. Kai Guo, Xinnan Dai, Zhibo Zhang, Nuohan Lin, Shenglai Zeng, Jie Ren, Haoyu Han, Jiliang Tang. Arxiv 2026.
-
Is Grep All You Need? How Agent Harnesses Reshape Agentic Search. Sahil Sen, Akhil Kasturi, Elias Lumer, Anmol Gulati, Vamse Kumar Subbiah. Arxiv 2026.
-
Stop Overthinking: Unlocking Efficient Listwise Reranking with Minimal Reasoning. Danyang Liu, Kan Li. Arxiv 2026.

Agent-Based
-
Re3: Generating Longer Stories With Recursive Reprompting and Revision. Kevin Yang, Yuandong Tian, Nanyun Peng, Dan Klein. EMNLP 2022
-
Walking Down the Memory Maze: Beyond Context Limit through Interactive Reading. Howard Chen, Ramakanth Pasunuru, Jason Weston, Asli Celikyilmaz. Arxiv 2023.
-
PEARL: Prompting Large Language Models to Plan and Execute Actions Over Long Documents. Simeng Sun, Yang Liu, Shuohang Wang, Dan Iter, Chenguang Zhu, Mohit Iyyer. EACL 2024.
-
Learning to Reason and Memorize with Self-Notes. Jack Lanchantin, Shubham Toshniwal, Jason Weston, arthur szlam, Sainbayar Sukhbaatar. NeurIPS 2023
-
GraphReader: Building Graph-based Agent to Enhance Long-Context Abilities of Large Language Models. Shilong Li, Yancheng He, Hangyu Guo, Xingyuan Bu, Ge Bai, Jie Liu, Jiaheng Liu, Xingwei Qu, Yangguang Li, Wanli Ouyang, Wenbo Su, Bo Zheng. Arxiv 2024.
-
A Human-Inspired Reading Agent with Gist Memory of Very Long Contexts. Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, Ian Fischer. Arxiv 2024.
-
RoleAgent: Building, Interacting, and Benchmarking High-quality Role-Playing Agents from Scripts. Jiaheng Liu, Zehao Ni, Haoran Que, Tao Sun, Noah Wang, Jian Yang, JiakaiWang, Hongcheng Guo, Z.Y. Peng, Ge Zhang, Jiayi Tian, Xingyuan Bu, Ke Xu, Wenge Rong, Junran Peng, Zhaoxiang Zhang. NeurIPS 2024
-
Chain of Agents: Large Language Models Collaborating on Long-Context Tasks. Yusen Zhang, Ruoxi Sun, Yanfei Chen, Tomas Pfister, Rui Zhang, Sercan Ö. Arik. Arxiv 2024.
-
LongAgent: Scaling Language Models to 128k Context through Multi-Agent Collaboration. Jun Zhao, Can Zu, Hao Xu, Yi Lu, Wei He, Yiwen Ding, Tao Gui, Qi Zhang, Xuanjing Huang. Arxiv 2024.
-
MEMENTO: Teaching LLMs to Manage Their Own Context. Vasilis Kontonis, Yuchen Zeng, Shivam Garg, Lingjiao Chen, Hao Tang, Ziyan Wang, Ahmed Awadallah, Eric Horvitz, John Langford, Dimitris Papailiopoulos. Arxiv 2026.
-
Escaping the Context Bottleneck: Active Context Curation for LLM Agents via Reinforcement Learning. Xiaozhe Li, Tianyi Lyu, Yizhao Yang, Liang Shan, Siyi Yang, Ligao Zhang, Zhuoyi Huang, Qingwen Liu, Yang Li. Arxiv 2026.
-
GenericAgent: A Token-Efficient Self-Evolving LLM Agent via Contextual Information Density Maximization. Jiaqing Liang et al. Arxiv 2026.
-
Brief Is Better: Non-Monotonic Chain-of-Thought Budget Effects in Function-Calling Language Agents. Xuan Qi. Arxiv 2026.
-
LongHorizon-Harness: Advancing Long-Horizon Agents for Real-World Tasks. Ziyu Ma, Hailang Huang, Shun Zou, Yong Wang, Shidong Yang, Yiming Hu, Fei Wei, XiangXiang Chu. Arxiv 2026.
-
AgentRewind: Recoverable Execution for Long-Horizon LLM Agents. Yu Zhuang, Kefei Chen, Yitong Duan, Shuxin Zheng, Jian Li, Xu-Yao Zhang. Arxiv 2026.
-
The Horizon Gap: Planning, Memory, Execution, Training, and Evaluation for Long-Horizon LLM Agents. Mingguang Chen, Licheng Wang, Bo Qu. Arxiv 2026.
-
ACM: Agentic Context Management for Long Horizon Tasks. Xiaochuan Li, Ryan Ming, Meng Chu, Shuai Shao, Rong Jin, Chenyan Xiong. Arxiv 2026.
-
Recursive Synthesis for Long-Horizon Terminal Tasks. Zhongzhi Li, Yucheng Shi, Zongxia Li, Ruhan Wang, Anhao Li, Zixun Huang, Junyao Yang, Lei Ke, Ninghao Liu, Haitao Mi, Leowei Liang. Arxiv 2026.
-
AutoDesign: Meta-Harness Optimization for Long-Horizon Agentic Design. Yaxin Luo, Haobin Jiang, Jialv Zou, Xu Huang, Wenhao Yan, Haodong Li, Zhengrong Yue, Jing Li, Xiaofu Chen, Xiaohan Zhao, Jiacheng Liu, Jiacheng Cui, Zhiqiang Shen, Xiaotong Li. Arxiv 2026.
-
OneDayAgent: Towards a Long-Horizon Harness for Autonomous Agents. Jingsheng Zheng, Xinyuan Fang, Jintian Zhang, Zhengke Gui, Huajun Chen, Ningyu Zhang. Arxiv 2026.
-
Toward Reliable Context Compression for Long-Horizon Agents: An Empirical Study of Execution Instability. Guanghui Min, Liang Wu, Mayank Darbari, Chen Chen, Liangjie Hong. Arxiv 2026.
-
CHILL-Harness: Counterfactual Harness Learning for Efficient Reasoning in Long-Horizon Agents. Jiarun Fu, Lizhong Ding, Sida Chen, Honglei Xin, Chunhui Zhang, Pengqi Li, Qiuning Wei, Ye Yuan, Guoren Wang. Arxiv 2026.
-
Efficient Reinforcement Learning for Long-Horizon Tool-Use Agentic Tasks. Zelei Cheng, Amritansh Mishra, Sambit Sahu, William Campbell. COLM 2026.


Evaluation
Long-Context Comprehension
-
Ada-LEval: Evaluating long-context LLMs with length-adaptable benchmarks. Chonghua Wang, Haodong Duan, Songyang Zhang, Dahua Lin, Kai Chen. Arxiv 2024.
-
BABILong: Testing the Limits of LLMs with Long Context Reasoning-in-a-Haystack. Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin, Mikhail Burtsev. Arxiv 2024.
-
DENIAHL: In-Context Features Influence LLM Needle-In-A-Haystack Abilities. Hui Dai, Dan Pechi, Xinyi Yang, Garvit Banga, Raghav Mantri. Arxiv 2024.
-
Holistic Reasoning with Long-Context LMs: A Benchmark for Database Operations on Massive Textual Data. Seiji Maekawa, Hayate Iso, Nikita Bhutani. Arxiv 2024.
-
LongIns: A Challenging Long-context Instruction-based Exam for LLMs. Shawn Gavin, Tuney Zheng, Jiaheng Liu, Quehry Que, Noah Wang, Jian Yang, Chenchen Zhang, Wenhao Huang, Wenhu Chen, Ge Zhang. Arxiv 2024.
-
Distance between Relevant Information Pieces Causes Bias in Long-Context LLMs. Runchu Tian, Yanghao Li, Yuepeng Fu, Siyang Deng, Qinyu Luo, Cheng Qian, Shuo Wang, Xin Cong, Zhong Zhang, Yesai Wu, Yankai Lin, Huadong Wang, Xiaojiang Liu. Arxiv 2024.
-
LIFBench: Evaluating the Instruction Following Performance and Stability of Large Language Models in Long-Context Scenarios. Xiaodong Wu, Minhao Wang, Yichen Liu, Xiaoming Shi, He Yan, Xiangju Lu, Junmin Zhu, Wei Zhang. Arxiv 2024.
-
Long Range Arena: A Benchmark for Efficient Transformers. Yi Tay, Mostafa Dehghani, Samira Abnar, Yikang Shen, Dara Bahri, Philip Pham, Jinfeng Rao, Liu Yang, Sebastian Ruder, Donald Metzler. Arxiv 2020
-
LongReason: A Synthetic Long-Context Reasoning Benchmark via Context Expansion. Zhan Ling, Kang Liu, Kai Yan, Yifan Yang, Weijian Lin, Ting-Han Fan, Lingfeng Shen, Zhengyin Du, Jiecao Chen. Arxiv 2025.
-
Evaluating Multilingual Long-Context Models for Retrieval and Reasoning. Agrawal, Ameeta and Dang, Andy and Nezhad, Sina Bagheri and Pokharel, Rhitabrat and Scheinberg, Russell. ACL 2024.
-
M4le: A multi-ability multi-range multi-task multi-domain long-context evaluation benchmark for large language models. Kwan, Wai-Chung and Zeng, Xingshan and Wang, Yufei and Sun, Yusen and Li, Liangyou and Shang, Lifeng and Liu, Qun and Wong, Kam-Fai. ACL 2024.
-
Michelangelo: Long context evaluations beyond haystacks via latent structure queries. Vodrahalli, Kiran and Ontanon, Santiago and Tripuraneni, Nilesh and Xu, Kelvin and Jain, Sanil and Shivanna, Rakesh and Hui, Jeffrey and Dikkala, Nishanth and Kazemi, Mehran and Fatemi, Bahare and others. Arxiv 2024.
-
Multilingual Needle in a Haystack: Investigating Long-Context Behavior of Multilingual Large Language Models. Amey Hengle, Prasoon Bajpai, Soham Dan, Tanmoy Chakraborty. Arxiv 2024.
-
Needle Threading: Can LLMs Follow Threads through Near-Million-Scale Haystacks?. Jonathan Roberts, Kai Han, Samuel Albanie. Arxiv 2024.
-
NoLiMa: Long-Context Evaluation Beyond Literal Matching. Ali Modarressi, Hanieh Deilamsalehy, Franck Dernoncourt, Trung Bui, Ryan A. Rossi, Seunghyun Yoon, Hinrich Schütze. Arxiv 2025.
-
RULER: What’s the Real Context Size of Your Long-Context Language Models?. Hsieh, Cheng-Ping and Sun, Simeng and Kriman, Samuel and Acharya, Shantanu and Rekesh, Dima and Jia, Fei and Ginsburg, Boris. COLM 2024.
-
S3Eval: A Synthetic, Scalable, Systematic Evaluation Suite for Large Language Model. Lei, Fangyu and Liu, Qian and Huang, Yiming and He, Shizhu and Zhao, Jun and Liu, Kang. NAACL 2024.
-
Summary of a Haystack: A Challenge to Long-Context LLMs and RAG Systems. Philippe Laban, Alexander R. Fabbri, Caiming Xiong, Chien-Sheng Wu. Arxiv 2024.
-
LongHealth: A Question Answering Benchmark with Long Clinical Documents. Lisa Adams, Felix Busch, Tianyu Han, Jean-Baptiste Excoffier, Matthieu Ortala, Alexander Löser, Hugo JWL. Aerts, Jakob Nikolas Kather, Daniel Truhn, Keno Bressem. Arxiv 2024.
-
Mathhay: An automated benchmark for long-context mathematical reasoning in llms. Wang, Lei and Dong, Shan and Xu, Yuhui and Dong, Hanze and Wang, Yalu and Saha, Amrita and Lim, Ee-Peng and Xiong, Caiming and Sahoo, Doyen. Arxiv 2024.
-
RepoQA: Evaluating Long Context Code Understanding. Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang, Lingming Zhang. Arxiv 2024.
-
Bamboo: A comprehensive benchmark for evaluating long text modeling capacities of large language models. Dong, Zican and Tang, Tianyi and Li, Junyi and Zhao, Wayne Xin and Wen, Ji-Rong. ACL 2024.
-
Clongeval: A chinese benchmark for evaluating long-context large language models. Qiu, Zexuan and Li, Jingjing and Huang, Shijue and Jiao, Xiaoqi and Zhong, Wanjun and King, Irwin. EMNLP 2024.
-
Detectiveqa: Evaluating long-context reasoning on detective novels. Xu, Zhe and Ye, Jiasheng and Liu, Xiangyang and Sun, Tianxiang and Liu, Xiaoran and Guo, Qipeng and Li, Linlin and Liu, Qun and Huang, Xuanjing and Qiu, Xipeng. Arxiv 2024.
-
ETHIC: Evaluating Large Language Models on Long-Context Tasks with High Information Coverage. Taewhoo Lee, Chanwoong Yoon, Kyochul Jang, Donghyeon Lee, Minju Song, Hyunjae Kim, Jaewoo Kang. Arxiv 2024.
-
Extending long context evaluation beyond 100k tokens. Zhang, Xinrong and Chen, Yingfa and Hu, Shengding and Xu, Zihang and Chen, Junhao and Hao, Moo and Han, Xu and Thai, Zhen and Wang, Shuo and Liu, Zhiyuan and others. ACL 2024.
-
Helmet: How to evaluate long-context language models effectively and thoroughly. Yen, Howard and Gao, Tianyu and Hou, Minmin and Ding, Ke and Fleischer, Daniel and Izsak, Peter and Wasserblat, Moshe and Chen, Danqi. ICLR 2025.
-
L-CiteEval: Do Long-Context Models Truly Leverage Context for Responding?. Zecheng Tang and Keyan Zhou and Juntao Li and Baibei Ji and Jianye Hou and Min Zhang. Arxiv 2024.
-
L-eval: Instituting standardized evaluation for long context language models. An, Chenxin and Gong, Shansan and Zhong, Ming and Zhao, Xingjian and Li, Mukai and Zhang, Jun and Kong, Lingpeng and Qiu, Xipeng. ACL 2024.
-
Long Input Benchmark for Russian Analysis. Igor Churin, Murat Apishev, Maria Tikhonova, Denis Shevelev, Aydar Bulatov, Yuri Kuratov, Sergej Averkiev, Alena Fenogenova. Arxiv 2024.
-
Can Long-Context Language Models Subsume Retrieval, RAG, SQL, and More?. Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien M. R. Arnold, Vincent Perot, Siddharth Dalmia, Hexiang Hu, Xudong Lin, Panupong Pasupat, Aida Amini, Jeremy R. Cole, Sebastian Riedel, Iftekhar Naim, Ming-Wei Chang, Kelvin Guu. Arxiv 2024.
-
LONG2RAG: Evaluating Long-Context & Long-Form Retrieval-Augmented Generation with Key Point Recall. Qi, Zehan and Xu, Rongwu and Guo, Zhijiang and Wang, Cunxiang and Zhang, Hao and Xu, Wei. ACL 2024.
-
Longbench: A bilingual, multitask benchmark for long context understanding. Bai, Yushi and Lv, Xin and Zhang, Jiajie and Lyu, Hongchang and Tang, Jiankai and Huang, Zhidian and Du, Zhengxiao and Liu, Xiao and Zeng, Aohan and Hou, Lei and others. ACL 2024.
-
LongBench v2: Towards Deeper Understanding and Reasoning on Realistic Long-context Multitasks. Yushi Bai, Shangqing Tu, Jiajie Zhang, Hao Peng, Xiaozhi Wang, Xin Lv, Shulin Cao, Jiazheng Xu, Lei Hou, Yuxiao Dong, Jie Tang, Juanzi Li. Arxiv 2024.
-
Longcite: Enabling llms to generate fine-grained citations in long-context qa. Zhang, Jiajie and Bai, Yushi and Lv, Xin and Gu, Wanjun and Liu, Danqing and Zou, Minhao and Cao, Shulin and Hou, Lei and Dong, Yuxiao and Feng, Ling and others. Arxiv 2024.
-
Long-context llms struggle with long in-context learning. Li, Tianle and Zhang, Ge and Do, Quy Duc and Yue, Xiang and Chen, Wenhu. TMLR.
-
LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. Di Wu, Hongwei Wang, Wenhao Yu, Yuwei Zhang, Kai-Wei Chang, Dong Yu. Arxiv 2024.
-
Leave no document behind: Benchmarking long-context llms with extended multi-doc qa. Wang, Minzheng and Chen, Longze and Cheng, Fu and Liao, Shengyi and Zhang, Xinghua and Wu, Bingli and Yu, Haiyang and Xu, Nan and Zhang, Lei and Luo, Run and others. EMNLP 2024.
-
LooGLE: Can Long-Context Language Models Understand Long Contexts?. Li, Jiaqi and Wang, Mengmeng and Zheng, Zilong and Zhang, Muhan. ACL 2024.
-
LV-Eval: A Balanced Long-Context Benchmark with 5 Length Levels Up to 256K. Tao Yuan, Xuefei Ning, Dong Zhou, Zhijie Yang, Shiyao Li, Minghui Zhuang, Zheyue Tan, Zhuyu Yao, Dahua Lin, Boxun Li, Guohao Dai, Shengen Yan, Yu Wang. Arxiv 2024.
-
Retrieval or Global Context Understanding? On Many-Shot In-Context Learning for Long-Context Evaluation. Kaijian Zou, Muhammad Khalifa, Lu Wang. Arxiv 2024.
-
Marathon: A race through the realm of long context with large language models. Zhang, Lei and Li, Yunshui and Liu, Ziqiang and Liu, Junhao and Chen, Longze and Luo, Run and Yang, Min and others. ACL 2024.
-
One Thousand and One Pairs: A "novel" challenge for long-context language models. Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal, Mohit Iyyer. Arxiv 2024.
-
Analyzing Temporal Complex Events with Large Language Models? A Benchmark towards Temporal, Long Context Understanding. Zhihan Zhang, Yixin Cao, Chenchen Ye, Yunshan Ma, Lizi Liao, Tat-Seng Chua. Arxiv 2024.
-
Zeroscrolls: A zero-shot benchmark for long text understanding. Shaham, Uri and Ivgi, Maor and Efrat, Avia and Berant, Jonathan and Levy, Omer. EMNLP 2023.
-
DocFinQA: {A} Long-Context Financial Reasoning Dataset. Varshini Reddy, Rik Koncel{-}Kedziorski, Viet Dac Lai, Michael Krumdick, Charles Lovering, Chris Tanner. ACL 2024
-
FinTextQA: A Dataset for Long-form Financial Question Answering. Jian Chen, Peilin Zhou, Yining Hua, Yingxin Loh, Kehui Chen, Ziyuan Li, Bing Zhu, Junwei Liang. Arxiv 2024.
-
Long Code Arena: a Set of Benchmarks for Long-Context Code Models. Bogomolov, Egor and Eliseeva, Aleksandra and Galimzyanov, Timur and Glukhov, Evgeniy and Shapkin, Anton and Tigina, Maria and Golubev, Yaroslav and Kovrigin, Alexander and van Deursen, Arie and Izadi, Maliheh and others. Arxiv 2024.
-
MedOdyssey: A Medical Domain Benchmark for Long Context Evaluation Up to 200K Tokens. Yongqi Fan, Hongli Sun, Kui Xue, Xiaofan Zhang, Shaoting Zhang, Tong Ruan. Arxiv 2024.
-
Examining Long-Context Large Language Models for Environmental Review Document Comprehension. Phan, Hung and Acharya, Anurag and Meyur, Rounak and Chaturvedi, Sarthak and Sharma, Shivam and Parker, Mike and Nally, Dan and Jannesari, Ali and Pazdernik, Karl and Halappanavar, Mahantesh and others. Arxiv 2024.
-
Train short, test long: Attention with linear biases enables input length extrapolation. Ofir Press and Noah A. Smith and Mike Lewis. Arxiv 2022
-
PoSE: Efficient Context Window Extension of LLMs via Positional Skip-wise Training. Dawei Zhu,Nan Yang,Liang Wang,Yifan Song,Wenhao Wu,Furu Wei,Sujian Li. Arxiv 2023.
-
Landmark Attention: Random-Access Infinite Context Length for Transformers. Amirkeivan Mohtashami, Martin Jaggi Arxiv 2023.
-
NeedleBench: Can LLMs Do Retrieval and Reasoning in 1 Million Context Window?. Mo Li, Songyang Zhang, Yunxin Liu, Kai Chen. Arxiv 2024.
-
Multi-News: A Large-Scale Multi-Document Summarization Dataset and Abstractive Hierarchical Model. Fabbri, Alexander Richard and Li, Irene and She, Tianwei and Li, Suyi and Radev, Dragomir. ACL 2019.
-
Ms marco: A human-generated machine reading comprehension dataset. Nguyen, Tri and Rosenberg, Mir and Song, Xia and Gao, Jianfeng and Tiwary, Saurabh and Majumder, Rangan and Deng, Li. Arxiv 2016.
-
U-NIAH: Unified RAG and LLM Evaluation for Long Context Needle-In-A-Haystack. Yunfan Gao, Yun Xiong, Wenlong Wu, Zijing Huang, Bohan Li, Haofen WangYunfan Gao, Yun Xiong, Wenlong Wu, Zijing Huang, Bohan Li, Haofen Wang. Arxiv 2025.
-
L2M: Mutual Information Scaling Law for Long-Context Language Modeling. Zhuo Chen, Oriol Mayné i Comas, Zhuotao Jin, Di Luo, Marin Soljačić. Arxiv 2025.
-
MMLongBench: Benchmarking Long-Context Vision-Language Models Effectively and Thoroughly. Zhaowei Wang, Wenhao Yu, Xiyu Ren, Jipeng Zhang, Yu Zhao, Rohit Saxena, Liang Cheng, Ginny Wong, Simon See, Pasquale Minervini, Yangqiu Song, Mark Steedman. Arxiv 2025.
-
VideoZeroBench: Probing the Limits of Video MLLMs with Spatio-Temporal Evidence Verification. Jiahao Meng, Tan Yue, Qi Xu, Haochen Wang, Zhongwei Ren, Weisong Liu, Yuhao Wang, Renrui Zhang, Yunhai Tong, Haodong Duan. Arxiv 2026.
-
MemLens: Benchmarking Multimodal Long-Term Memory in Large Vision-Language Models. Xiyu Ren, Zhaowei Wang, Yiming Du, Zhongwei Xie, Chi Liu, Xinlin Yang, Haoyue Feng, Wenjun Pan, Tianshi Zheng, Baixuan Xu, Zhengnan Li, Yangqiu Song, Ginny Wong, Simon See. Arxiv 2026.
-
GroupMemBench: Benchmarking LLM Agent Memory in Multi-Party Conversations. Jingbo Yang, Kwei-Herng Lai, Xiaowen Wang, Shiyu Chang, Yaar Harari, Evgeniy Gabrilovich. Arxiv 2026.
-
MemEye: A Visual-Centric Evaluation Framework for Multimodal Agent Memory. Minghao Guo, Qingyue Jiao, Zeru Shi, Yihao Quan, Boxuan Zhang, Danrui Li, Liwei Che, Wujiang Xu, Shilong Liu, Zirui Liu, Mubbasir Kapadia, Vladimir Pavlovic, Jiang Liu, Mengdi Wang, Yiyu Shi, Dimitris N. Metaxas, Ruixiang Tang. Arxiv 2026.
-
Beyond Accuracy: Evaluating Grounded Visual Evidence in Thinking with Images (ViEBench). Xuchen Li, Xuzhao Li, Renjie Pi, Shiyu Hu, Jian Zhao, Jiahui Gao. Arxiv 2026.
-
StreamingEval: A Unified Evaluation Framework for Streaming Video Understanding. Guowei Tang, Tianwen Qian, Huanran Zheng, Yifei Wang, Xiaoling Wang. Arxiv 2026.
-
KVDiagnosis: A Diagnostic Benchmark for KV-Cache Compression in Long-Context Language Models. Chen Qiu, Ziwu Liu, Chao Fei, Guozhong Li, Panos Kalnis. Arxiv 2026.
-
Distractor-Aware Truncation: Disentangling Context-Length Effects from Signal Loss in Long-Context LLM Benchmarks. Mohsen Arjmandi. Arxiv 2026.
-
Cracks in the Foundation: Seemingly Minor Architectural Choices Impact Long Context Extension. Amanda Bertsch, Luca Soldaini, Matthew R. Gormley, Graham Neubig, Hannaneh Hajishirzi, Kyle Lo, Dirk Groeneveld. COLM 2026.
-
Information Abundance Paradox: Long-Context Training Undermines Parametric Knowledge. Arda Uzunoglu, Benjamin Van Durme, Daniel Khashabi. Arxiv 2026.




Long-Form Generation
-
ELI5: Long form question answering. Fan, Angela and Jernite, Yacine and Perez, Ethan and Grangier, David and Weston, Jason and Auli, Michael. Arxiv 2019.
-
Ms marco: A human-generated machine reading comprehension dataset. Nguyen, Tri and Rosenberg, Mir and Song, Xia and Gao, Jianfeng and Tiwary, Saurabh and Majumder, Rangan and Deng, Li. Arxiv 2016.
-
Expertqa: Expert-curated questions and attributed answers. Malaviya, Chaitanya and Lee, Subin and Chen, Sihao and Sieber, Elizabeth and Yatskar, Mark and Roth, Dan. NAACL 2024.
-
Proxyqa: An alternative framework for evaluating long-form text generation with large language models. Tan, Haochen and Guo, Zhijiang and Shi, Zhan and Xu, Lu and Liu, Zhili and Feng, Yunlong and Li, Xiaoguang and Wang, Yasheng and Shang, Lifeng and Liu, Qun and others. ACL 2024
-
LongGenBench: Long-context Generation Benchmark. Xiang Liu, Peijie Dong, Xuming Hu, Xiaowen Chu. EMNLP 2024.
-
ASQA: Factoid questions meet long-form answers. Stelmakh, Ivan and Luan, Yi and Dhingra, Bhuwan and Chang, Ming-Wei. EMNLP 2022.
-
Qasa: advanced question answering on scientific articles. Lee, Yoonjoo and Lee, Kyungjae and Park, Sunghyun and Hwang, Dasol and Kim, Jaehyeon and Lee, Hong-in and Lee, Moontae. PMLR 2023.
-
CLAPNQ: Cohesive Long-form Answers from Passages in Natural Questions for RAG systems. Sara Rosenthal, Avirup Sil, Radu Florian, Salim Roukos. Arxiv 2024.
-
LONG2RAG: Evaluating Long-Context & Long-Form Retrieval-Augmented Generation with Key Point Recall. Qi, Zehan and Xu, Rongwu and Guo, Zhijiang and Wang, Cunxiang and Zhang, Hao and Xu, Wei. ACL 2024.
-
A Benchmark for Long-Form Medical Question Answering. Pedram Hosseini, Jessica M. Sin, Bing Ren, Bryceton G. Thomas, Elnaz Nouri, Ali Farahanchi, Saeed Hassanpour. NeurIPS 2024.
-
OLAPH: Improving Factuality in Biomedical Long-form Question Answering. Minbyul Jeong, Hyeon Hwang, Chanwoong Yoon, Taewhoo Lee, Jaewoo Kang. Arxiv 2024.
-
Factscore: Fine-grained atomic evaluation of factual precision in long form text generation. Min, Sewon and Krishna, Kalpesh and Lyu, Xinxi and Lewis, Mike and Yih, Wen-tau and Koh, Pang Wei and Iyyer, Mohit and Zettlemoyer, Luke and Hajishirzi, Hannaneh. EMNLP 2023.
-
Long-form factuality in large language models. Jerry Wei, Chengrun Yang, Xinying Song, Yifeng Lu, Nathan Hu, Dustin Tran, Daiyi Peng, Ruibo Liu, Da Huang, Cosmo Du, Quoc V. Le. Arxiv 2024.
-
Large Language Models Still Exhibit Bias in Long Text. Wonje Jeung, Dongjae Jeon, Ashkan Yousefpour, Jonghyun Choi. Arxiv 2024.
-
Aquamuse: Automatically generating datasets for query-based multi-document summarization. Kulkarni, Sayali and Chammas, Sheide and Zhu, Wan and Sha, Fei and Ie, Eugene. Arxiv 2020.
-
Multi-News: A Large-Scale Multi-Document Summarization Dataset and Abstractive Hierarchical Model. Fabbri, Alexander Richard and Li, Irene and She, Tianwei and Li, Suyi and Radev, Dragomir. ACL 2019.
-
LCFO: Long Context and Long Form Output Dataset and Benchmarking. Marta R. Costa-jussà, Pierre Andrews, Mariano Coria Meglioli, Joy Chen, Joe Chuang, David Dale, Christophe Ropers, Alexandre Mourachko, Eduardo Sánchez, Holger Schwenk, Tuan Tran, Arina Turkatenko, Carleigh Wood. Arxiv 2024.
-
LongForm: Effective Instruction Tuning with Reverse Instructions. Koksal, Abdullatif and Schick, Timo and Korhonen, Anna and Schutze, Hinrich. EMNLP 2024.
-
Suri: Multi-constraint Instruction Following for Long-form Text Generation. Chau Minh Pham, Simeng Sun, Mohit Iyyer. EMNLP 2024.
-
LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs. Yushi Bai, Jiajie Zhang, Xin Lv, Linzhi Zheng, Siqi Zhu, Lei Hou, Yuxiao Dong, Jie Tang, Juanzi Li. Arxiv 2024.
-
Language Models can Self-Lengthen to Generate Long Texts. Shanghaoran Quan, Tianyi Tang, Bowen Yu, An Yang, Dayiheng Liu, Bofei Gao, Jianhong Tu, Yichang Zhang, Jingren Zhou, Junyang Lin. Arxiv 2024.
-
LOT: A story-centric benchmark for evaluating Chinese long text understanding and generation. Guan, Jian and Feng, Zhuoer and Chen, Yamei and He, Ruilin and Mao, Xiaoxi and Fan, Changjie and Huang, Minlie. TACL 2022.
-
Longlamp: A benchmark for personalized long-form text generation. Kumar, Ishita and Viswanathan, Snigdha and Yerra, Sushrita and Salemi, Alireza and Rossi, Ryan A and Dernoncourt, Franck and Deilamsalehy, Hanieh and Chen, Xiang and Zhang, Ruiyi and Agarwal, Shubham and others. Arxiv 2o24.
-
DOLOMITES: Domain-Specific Long-Form Methodical Tasks. Chaitanya Malaviya, Priyanka Agrawal, Kuzman Ganchev, Pranesh Srinivasan, Fantine Huot, Jonathan Berant, Mark Yatskar, Dipanjan Das, Mirella Lapata, Chris Alberti. Arxiv 2024.
-
LongGenBench: Benchmarking Long-Form Generation in Long Context LLMs. Yuhao Wu, Ming Shan Hee, Zhiqing Hu, Roy Ka-Wei Lee. Arxiv 2024.
-
LongProc: Benchmarking Long-Context Language Models on Long Procedural Generation. Xi Ye, Fangcong Yin, Yinghui He, Joie Zhang, Howard Yen, Tianyu Gao, Greg Durrett, Danqi Chen. Arxiv 2025.
-
Hellobench: Evaluating long text generation capabilities of large language models. Que, Haoran and Duan, Feiyu and He, Liqun and Mou, Yutao and Zhou, Wangchunshu and Liu, Jiaheng and Rong, Wenge and Wang, Zekun Moore and Yang, Jian and Zhang, Ge and others. Arxiv 2024.
-
The FACTS Grounding Leaderboard: Benchmarking LLMs' Ability to Ground Responses to Long-Form Input. Alon Jacovi, Andrew Wang, Chris Alberti, Connie Tao, Jon Lipovetz, Kate Olszewska, Lukas Haas, Michelle Liu, Nate Keating, Adam Bloniarz, Carl Saroufim, Corey Fry, Dror Marcus, Doron Kukliansky, Gaurav Singh Tomar, James Swirhun, Jinwei Xing, Lily Wang, Madhu Gurumurthy, Michael Aaron, Moran Ambar, Rachana Fellinger, Rui Wang, Zizhao Zhang, Sasha Goldshtein, Dipanjan Das. Arxiv 2025.
-
RAPID: Efficient Retrieval-Augmented Long Text Generation with Writing Planning and Information Discovery. Hongchao Gu, Dexun Li, Kuicai Dong, Hao Zhang, Hang Lv, Hao Wang, Defu Lian, Yong Liu, Enhong Chen. Arxiv 2025.
-
[DeFine: A Decomposed and Fine-Grained Annotated Dataset for Long-form Article Generation.](https://arxiv.org/abs


Truncated — view the full README on GitHub.
Contributors


Similar repos


A Comprehensive Survey on Long Context Language Modeling
See the codeREADME
A Comprehensive Survey on Long Context Language Modeling 💡
This repository provides a collection of papers and resources focused on Long Context Language Modeling. For a clear taxonomy and more insights about the methodology, you can refer to our survey: A Comprehensive Survey on Long Context Language Modeling with an overview shown below.
We appreciate any useful suggestions for improvement of this paper list or survey from peers and commit to regularly updating the repository.
If you would like to include your paper or any modifications in this survey and repository, please feel free to raise issues or send an email to dwzhu@pku.edu.cn, liujiaheng@nju.edu.cn, or liaohuanxuan2023@ia.ac.cn. We sincerely appreciate your collaboration!
We would like to extend our sincere gratitude to Awesome-LLM-Long-Context-Modeling for providing valuable reference to support the expansion of this project and the development of the comprehensive scholarly survey.
We would also like to mention Thus Spake Long-Context Large Language Model (GitHub), a concurrent survey that details the development history of long-context LLMs. They've created a video with Thus Spake Zarathustra symphony to introduce LCLM-related work.
If you find our survey useful for your research, please consider citing the following paper:
@article{liu2025comprehensive,
  title={A Comprehensive Survey on Long Context Language Modeling},
  author={Liu, Jiaheng and Zhu, Dawei and Bai, Zhiqi and He, Yancheng and Liao, Huanxuan and Que, Haoran and Wang, Zekun and Zhang, Chenchen and Zhang, Ge and Zhang, Jiebin and others},
  journal={arXiv preprint arXiv:2503.17407},
  year={2025}
}
Updates
- [2026.08.17] Sync recent long-context papers from Awesome-LLM-Long-Context-Modeling (sparse/hybrid attention, KV cache, memory, long-horizon agents, adaptive thinking, long video, and serving) while preserving the existing taxonomy.
- [2026.05.19] Expand the paper list with remaining 2026 works and selected 2025 Q4 papers from Awesome-LLM-Long-Context-Modeling while preserving the existing taxonomy.
- [2026.05.19] Standardize README formatting and incorporate recent long-context modeling papers from Awesome-LLM-Long-Context-Modeling into the existing taxonomy.
- [2025.03.25] Our paper is finally out on arXiv.
- [2025.03.13] We have a good communication with the authors of concurrent work, and will promote work of both parties in the future.
- [2025.03.11] We release the first version of the survey on Long Context Language Modeling [lclm-survey.pdf] and open-source our repo.
Table of Contents
- A Comprehensive Survey on Long Context Language Modeling 💡
Paper List
Data
Pretraining
-
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, Peter J. Liu. J. Mach. Learn. Res. 2020
-
Scaling Language Models: Methods, Analysis {&} Insights from Training Gopher. Jack W. Rae, Sebastian Borgeaud, Trevor Cai, Katie Millican, Jordan Hoffmann, H. Francis Song, John Aslanides, Sarah Henderson, Roman Ring, Susannah Young, Eliza Rutherford, Tom Hennigan, Jacob Menick, Albin Cassirer, Richard Powell, George van den Driessche, Lisa Anne Hendricks, Maribeth Rauh, Po{-}Sen Huang, Amelia Glaese, Johannes Welbl, Sumanth Dathathri, Saffron Huang, Jonathan Uesato, John Mellor, Irina Higgins, Antonia Creswell, Nat McAleese, Amy Wu, Erich Elsen, Siddhant M. Jayakumar, Elena Buchatskaya, David Budden, Esme Sutherland, Karen Simonyan, Michela Paganini, Laurent Sifre, Lena Martens, Xiang Lorraine Li, Adhiguna Kuncoro, Aida Nematzadeh, Elena Gribovskaya, Domenic Donato, Angeliki Lazaridou, Arthur Mensch, Jean{-}Baptiste Lespiau, Maria Tsimpoukelli, Nikolai Grigorev, Doug Fritz, Thibault Sottiaux, Mantas Pajarskas, Toby Pohlen, Zhitao Gong, Daniel Toyama, Cyprien de Masson d'Autume, Yujia Li, Tayfun Terzi, Vladimir Mikulik, Igor Babuschkin, Aidan Clark, Diego de Las Casas, Aurelia Guy, Chris Jones, James Bradbury, Matthew J. Johnson, Blake A. Hechtman, Laura Weidinger, Iason Gabriel, William Isaac, Edward Lockhart, Simon Osindero, Laura Rimell, Chris Dyer, Oriol Vinyals, Kareem Ayoub, Jeff Stanway, Lorrayne Bennett, Demis Hassabis, Koray Kavukcuoglu, Geoffrey Irving. Arxiv 2021
-
Structured Packing in LLM Training Improves Long Context Utilization. Konrad Staniszewski, Szymon Tworkowski, Sebastian Jaszczur, Henryk Michalewski, Łukasz Kuciński, Piotr Miłoś. Arxiv 2024.
-
SemDeDup: Data-efficient learning at web-scale through semantic deduplication. Amro Abbas, Kushal Tirumala, Daniel Simig, Surya Ganguli, Ari S. Morcos. Arxiv 2023
-
{SlimPajama: A 627B token cleaned and deduplicated version of RedPajama}. Daria Soboleva, Faisal Al-Khateeb, Robert Myers, Jacob R Steeves, Joel Hestness, Nolan Dey. Arxiv 2023
-
In-Context Pretraining: Language Modeling Beyond Document Boundaries. Weijia Shi, Sewon Min, Maria Lomeli, Chunting Zhou, Margaret Li, Xi Victoria Lin, Noah A. Smith, Luke Zettlemoyer, Wen-tau Yih, Mike Lewis. ICLR 2024 Spotlight.
-
Data Mixing Laws: Optimizing Data Mixtures by Predicting Language Modeling Performance. Jiasheng Ye, Peiju Liu, Tianxiang Sun, Yunhua Zhou, Jun Zhan, Xipeng Qiu. Arxiv 2024
-
Long Context is Not Long at All: A Prospector of Long-Dependency Data for Large Language Models. Longze Chen, Ziqiang Liu, Wanwei He, Yunshui Li, Run Luo, Min Yang. Arxiv 2024.
-
{L}ong{W}anjuan: Towards Systematic Measurement for Long Text Quality. Xiaoran Liu, Kai Lv, Qipeng Guo, Hang Yan, Conghui He, Xipeng Qiu, Dahua Lin. ACL 2024
-
Map-neo: Highly capable and transparent bilingual large language model series. Ge Zhang, Scott Qu, Jiaheng Liu, Chenchen Zhang, Chenghua Lin, Chou Leuang Yu, Danny Pan, Esther Cheng, Jie Liu, Qunshu Lin, others. Arxiv 2024
-
Quest: Query-centric Data Synthesis Approach for Long-context Scaling of Large Language Model. Chaochen Gao, Xing Wu, Qi Fu, Songlin Hu. Arxiv 2024.
-
Data Engineering for Scaling Language Models to 128K Context. Yao Fu, Rameswar Panda, Xinyao Niu, Xiang Yue, Hannaneh Hajishirzi, Yoon Kim, Hao Peng. Arxiv 2024.
-
RegMix: Data Mixture as Regression for Language Model Pre-training. Qian Liu, Xiaosen Zheng, Niklas Muennighoff, Guangtao Zeng, Longxu Dou, Tianyu Pang, Jing Jiang, Min Lin. Arxiv 2024
-
How to Train Long-Context Language Models (Effectively). Tianyu Gao, Alexander Wettig, Howard Yen, Danqi Chen. Arxiv 2024.
-
LongAttn: Selecting Long-context Training Data via Token-level Attention. Longyun Wu, Dawei Zhu, Guangxiang Zhao, Zhuocheng Yu, Junfeng Ran, Xiangyu Wong, Lin Sun, Sujian Li. Arxiv 2025.
-
Untie the Knots: An Efficient Data Augmentation Strategy for Long-Context Pre-Training in Language Models. Junfeng Tian, Da Zheng, Yang Cheng, Rui Wang, Colin Zhang, Debing Zhang. Arxiv 2024.
Posttraining
-
The {N}arrative{QA} Reading Comprehension Challenge. Tom{'a}{\v{s}} Ko{\v{c}}isk{'y}, Jonathan Schwarz, Phil Blunsom, Chris Dyer, Karl Moritz Hermann, G{'a}bor Melis, Edward Grefenstette. ACL 2018
-
Training language models to follow instructions with human feedback. Long Ouyang, Jeff Wu, Xu Jiang, Diogo Almeida, Carroll L. Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke E. Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul Francis Christiano, Jan Leike, Ryan J. Lowe. Arxiv 2022
-
{SlimPajama: A 627B token cleaned and deduplicated version of RedPajama}. Daria Soboleva, Faisal Al-Khateeb, Robert Myers, Jacob R Steeves, Joel Hestness, Nolan Dey. Arxiv 2023
-
Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Rafael Rafailov, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D. Manning, Chelsea Finn. Arxiv 2023
-
WanJuan: A Comprehensive Multimodal Dataset for Advancing English and Chinese Large Models. Conghui He, Zhenjiang Jin, Chaoxi Xu, Jiantao Qiu, Bin Wang, Wei Li, Hang Yan, Jiaqi Wang, Da Lin. Arxiv 2023
-
{L}ong{W}anjuan: Towards Systematic Measurement for Long Text Quality. Xiaoran Liu, Kai Lv, Qipeng Guo, Hang Yan, Conghui He, Xipeng Qiu, Dahua Lin. ACL 2024
-
LOGO--Long cOntext aliGnment via efficient preference Optimization. Zecheng Tang, Zechen Sun, Juntao Li, Qiaoming Zhu, Min Zhang. Arxiv 2024
-
{L}ong{A}lign: A Recipe for Long Context Alignment of Large Language Models. Yushi Bai, Xin Lv, Jiajie Zhang, Yuze He, Ji Qi, Lei Hou, Jie Tang, Yuxiao Dong, Juanzi Li. ACL 2024
-
What are the Essential Factors in Crafting Effective Long Context Multi-Hop Instruction Datasets? Insights and Best Practices. Zhi Chen, Qiguang Chen, Libo Qin, Qipeng Guo, Haijun Lv, Yicheng Zou, Wanxiang Che, Hang Yan, Kai Chen, Dahua Lin. Arxiv 2024.
-
Weaver: Foundation Models for Creative Writing. Tiannan Wang, Jiamin Chen, Qingrui Jia, Shuai Wang, Ruoyu Fang, Huilin Wang, Zhaowei Gao, Chunzhao Xie, Chuou Xu, Jihong Dai, Yibin Liu, Jialong Wu, Shengwei Ding, Long Li, Zhiwei Huang, Xinle Deng, Teng Yu, Gangan Ma, Han Xiao, Zixin Chen, Danjun Xiang, Yunxia Wang, Yuanyuan Zhu, Yi Xiao, Jing Wang, Yiru Wang, Siran Ding, Jiayang Huang, Jiayi Xu, Yilihamu Tayier, Zhenyu Hu, Yuan Gao, Chengfeng Zheng, Yueshu Ye, Yihang Li, Lei Wan, Xinyue Jiang, Yujie Wang, Siyu Cheng, Zhule Song, Xiangru Tang, Xiaohua Xu, Ningyu Zhang, Huajun Chen, Yuchen Eleanor Jiang, Wangchunshu Zhou. Arxiv 2024
-
LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs. Yushi Bai, Jiajie Zhang, Xin Lv, Linzhi Zheng, Siqi Zhu, Lei Hou, Yuxiao Dong, Jie Tang, Juanzi Li. Arxiv 2024.
-
LongReward: Improving Long-context Large Language Models with AI Feedback. Jiajie Zhang, Zhongni Hou, Xin Lv, Shulin Cao, Zhenyu Hou, Yilin Niu, Lei Hou, Yuxiao Dong, Ling Feng, Juanzi Li. Arxiv 2024
-
ChatQA 2: Bridging the Gap to Proprietary LLMs in Long Context and RAG Capabilities. Peng Xu, Wei Ping, Xianchao Wu, Zihan Liu, Mohammad Shoeybi, Bryan Catanzaro. Arxiv 2024.
-
LongLoRA: Efficient Fine-tuning of Long-Context Large Language Models. Yukang Chen, Shengju Qian, Haotian Tang, Xin Lai, Zhijian Liu, Song Han, Jiaya Jia. ICLR 2024 Oral.
-
{ORPO}: Monolithic Preference Optimization without Reference Model. Jiwoo Hong, Noah Lee, James Thorne. EMNLP 2024
-
Never Lost in the Middle: Mastering Long-Context Question Answering with Position-Agnostic Decompositional Training. Junqing He, Kunhao Pan, Xiaoqun Dong, Zhuoyang Song, LiuYiBo LiuYiBo, Qianguosun Qianguosun, Yuxin Liang, Hao Wang, Enming Zhang, Jiaxing Zhang. ACL 2024
-
Make Your {LLM} Fully Utilize the Context. Shengnan An, Zexiong Ma, Zeqi Lin, Nanning Zheng, Jian-Guang Lou, Weizhu Chen. NeurIPS 2024
-
LongDPO: Unlock Better Long-form Generation Abilities for LLMs via Critique-augmented Stepwise Information. Bowen Ping, Jiali Zeng, Fandong Meng, Shuo Wang, Jie Zhou, Shanghang Zhang. Arxiv 2025.
-
LongAttn: Selecting Long-context Training Data via Token-level Attention. Longyun Wu, Dawei Zhu, Guangxiang Zhao, Zhuocheng Yu, Junfeng Ran, Xiangyu Wong, Lin Sun, Sujian Li. Arxiv 2025.
-
LongFaith: Enhancing Long-Context Reasoning in LLMs with Faithful Synthetic Data. Cehao Yang, Xueyuan Lin, Chengjin Xu, Xuhui Jiang, Shengjie Ma, Aofan Liu, Hui Xiong, Jian Guo. Arxiv 2025.
-
In-Place Test-Time Training. Guhao Feng, Shengjie Luo, Kai Hua, Ge Zhang, Di He, Wenhao Huang, Tianle Cai. ICLR 2026 Oral.
-
Let's (not) just put things in Context: Test-Time Training for Long-Context LLMs. Rachit Bansal, Aston Zhang, Rishabh Tiwari, Lovish Madaan, Sai Surya Duvvuri, Devvrit Khatri, David Brandfonbrener, David Alvarez-Melis, Prajjwal Bhargava, Mihir Sanjay Kale, Samy Jelassi. Arxiv 2025.
-
End-to-End Test-Time Training for Long Context. Arnuv Tandon, Karan Dalal, Xinhao Li, Daniel Koceja, Marcel Rød, Sam Buchanan, Xiaolong Wang, Jure Leskovec, Sanmi Koyejo, Tatsunori Hashimoto, Carlos Guestrin, Jed McCaleb, Yejin Choi, Yu Sun. Arxiv 2025.
-
QwenLong-L1.5: Post-Training Recipe for Long-Context Reasoning and Memory Management. Weizhou Shen, Ziyi Yang, Chenliang Li, Zhiyuan Lu, Miao Peng, Huashan Sun, Yingcheng Shi, Shengyi Liao, Shaopeng Lai, Bo Zhang, Dayiheng Liu, Fei Huang, Jingren Zhou, Ming Yan. Arxiv 2025.
-
ACC: Compiling Agent Trajectories for Long-Context Training. Qisheng Su, Zhen Fang, Shiting Huang, Yu Zeng, Yiming Zhao, Kou Shi, Ziao Zhang, Lin Chen, Zehui Chen, Lijun Wu, Feng Zhao. Arxiv 2026.
-
OctoLong: Mid-Training On Cross-Repository Code Contexts Enhances Long-Context Modeling. Indraneil Paul, Falko Helm, Goran Glavaš, Iryna Gurevych. Arxiv 2026.
-
Learning What to Remember: Test-Time Training via Context Distillation. Zixuan Wang, Xingyu Dang, Rui-Jie Zhu, Zixin Wen, Hengyu Fu, Wenhao Chai, Jason D. Lee. Arxiv 2026.
Model
Position Embeddings
-
An Efficient Recipe for Long Context Extension via Middle-Focused Positional Encoding. Tong Wu, Yanpeng Zhao, Zilong Zheng. NeurIPS 2024.
-
PoSE: Efficient Context Window Extension of LLMs via Positional Skip-wise Training. Dawei Zhu,Nan Yang,Liang Wang,Yifan Song,Wenhao Wu,Furu Wei,Sujian Li. Arxiv 2023.
-
Contextual Position Encoding: Learning to Count What's Important. Olga Golovneva, Tianlu Wang, Jason Weston, Sainbayar Sukhbaatar. Arxiv 2024.
-
Why Does the Effective Context Length of LLMs Fall Short?. Chenxin An, Jun Zhang, Ming Zhong, Lei Li, Shansan Gong, Yao Luo, Jingjing Xu, Lingpeng Kong. Arxiv 2024.
-
HoPE: A Novel Positional Encoding Without Long-Term Decay for Enhanced Context Awareness and Extrapolation. Yuhan Chen, Ang Lv, Jian Luan, Bin Wang, Wei Liu. Arxiv 2024.
-
DAPE: Data-Adaptive Positional Encoding for Length Extrapolation. Chuanyang Zheng, Yihang Gao, Han Shi, Minbin Huang, Jingyao Li, Jing Xiong, Xiaozhe Ren, Michael Ng, Xin Jiang, Zhenguo Li, Yu Li. NeurIPS 2024.
-
Convolutional sequence to sequence learning. Jonas Gehring and Michael Auli and David Grangier and Denis Yarats and Yann N. Dauphin. Arxiv 2017
-
Self-attention with relative position representations. Peter Shaw and Jakob Uszkoreit and Ashish Vaswani. Arxiv 2018
-
Encoding word order in complex embeddings. Benyou Wang and Donghao Zhao and Christina Lioma and Qiuchi Li and Peng Zhang and Jakob Grue Simonsen. Arxiv 2020
-
Train short, test long: Attention with linear biases enables input length extrapolation. Ofir Press and Noah A. Smith and Mike Lewis. Arxiv 2022
-
Kerple: Kernelized relative positional embedding for length extrapolation. Ta-Chung Chi and Ting-Han Fan and Peter J. Ramadge and Alexander I. Rudnicky. Arxiv 2022
-
Dissecting transformer length extrapolation via the lens of receptive field analysis. Ta-Chung Chi and Ting-Han Fan and Alexander I. Rudnicky and Peter J. Ramadge. Arxiv 2023
-
A length-extrapolatable transformer. Yutao Sun and Li Dong and Barun Patra and Shuming Ma and Shaohan Huang and Alon Benhaim and Vishrav Chaudhary and Xia Song and Furu Wei. Arxiv 2022
-
Functional interpolation for relative positions improves long context transformers. Shanda Li and Chong You and Guru Guruganesh and Joshua Ainslie and Santiago Ontanon and Manzil Zaheer and Sumit Sanghai and Yiming Yang and Sanjiv Kumar and Srinadh Bhojanapalli. Arxiv 2024
-
Latent positional information is in the self-attention variance of transformer language models without positional embeddings. Latent Positional Information is in the Self-Attention Variance of Transformer Language Models Without Positional Embeddings. Arxiv 2023
-
Extending context window of large language models via positional interpolation. Shouyuan Chen and Sherman Wong and Liangjian Chen and Yuandong Tian. Arxiv 2023
-
Randomized positional encodings boost length generalization of transformers. Anian Ruoss and Grégoire Delétang and Tim Genewein and Jordi Grau-Moya and Róbert Csordás and Mehdi Bennani and Shane Legg and Joel Veness. Arxiv 2023
-
Yarn: Efficient context window extension of large language models. Bowen Peng and Jeffrey Quesnelle and Honglu Fan and Enrico Shippole. Arxiv 2023
-
Clex: Continuous length extrapolation for large language models. Guanzheng Chen and Xin Li and Zaiqiao Meng and Shangsong Liang and Lidong Bing. Arxiv 2024
-
Effective long-context scaling of foundation models. Wenhan Xiong and Jingyu Liu and Igor Molybog and Hejia Zhang and Prajjwal Bhargava and Rui Hou and Louis Martin and Rashi Rungta and Karthik Abinav Sankararaman and Barlas Oguz and Madian Khabsa and Han Fang and Yashar Mehdad and Sharan Narang and Kshitiz Malik and Angela Fan and Shruti Bhosale and Sergey Edunov and Mike Lewis and Sinong Wang and Hao Ma. Arxiv 2023
-
Giraffe: Adventures in expanding context lengths in llms. Arka Pal and Deep Karkhanis and Manley Roberts and Samuel Dooley and Arvind Sundararajan and Siddartha Naidu. Arxiv 2023
-
Resonance rope: Improving context length generalization of large language models. Suyuchen Wang and Ivan Kobyzev and Peng Lu and Mehdi Rezagholizadeh and Bang Liu. Arxiv 2024
-
Long context alignment with short instructions and synthesized positions. Wenhao Wu and Yizhong Wang and Yao Fu and Xiang Yue and Dawei Zhu and Sujian Li. Arxiv 2024
-
Two stones hit one bird: Bilevel positional encoding for better length extrapolation. Zhenyu He and Guhao Feng and Shengjie Luo and Kai Yang and Liwei Wang and Jingjing Xu and Zhi Zhang and Hongxia Yang and Di He. Arxiv 2024
-
Found in the middle: How language models use long contexts better via plug-and-play positional encoding. Zhenyu Zhang and Runjin Chen and Shiwei Liu and Zhewei Yao and Olatunji Ruwase and Beidi Chen and Xiaoxia Wu and Zhangyang Wang. Arxiv 2024
-
Llm maybe longlm: Self-extend llm context window without tuning. Hongye Jin and Xiaotian Han and Jingfeng Yang and Zhimeng Jiang and Zirui Liu and Chia-Yuan Chang and Huiyuan Chen and Xia Hu. Arxiv 2024
-
Longrope: Extending llm context window beyond 2 million tokens. Yiran Ding and Li Lyna Zhang and Chengruidong Zhang and Yuanyuan Xu and Ning Shang and Jiahang Xu and Fan Yang and Mao Yang. Arxiv 2024
-
The impact of positional encoding on length generalization in transformers. Amirhossein Kazemnejad and Inkit Padhi and Karthikeyan Natesan Ramamurthy and Payel Das and Siva Reddy. Arxiv 2024
-
Roformer: Enhanced transformer with rotary position embedding. Jianlin Su and Yu Lu and Shengfeng Pan and Ahmed Murtadha and Bo Wen and Yunfeng Liu. Arxiv 2023
-
Training-free long-context scaling of large language models. Chenxin An and Fei Huang and Jun Zhang and Shansan Gong and Xipeng Qiu and Chang Zhou and Lingpeng Kong. Arxiv 2024
-
PSC: Extending Context Window of Large Language Models via Phase Shift Calibration. Wenqiao Zhu and Chao Xu and Lulu Wang and Jun Wu. EMNLP 2024.
-
Attention Entropy is a Key Factor: An Analysis of Parallel Context Encoding with Full-attention-based Pre-trained Language Models. Zhisong Zhang, Yan Wang, Xinting Huang, Tianqing Fang, Hongming Zhang, Chenlong Deng, Shuaiyi Li, Dong Yu. Arxiv 2024.
-
DCIS: Efficient Length Extrapolation of LLMs via Divide-and-Conquer Scaling Factor Search. Lei Yang, Shaoyang Xu, Deyi Xiong. Arxiv 2024.
-
Adjoint sharding for very long context training of state space models. Xingzi Xu, Amir Tavanaei, Kavosh Asadi, Karim Bouyarmane. Arxiv 2025.
-
Information Entropy Invariance: Enhancing Length Extrapolation in Attention Mechanisms. Kewei Li, Yanwen Kong, Yiping Xu, Lan Huang, Ruochi Zhang, Fengfeng Zhou. Arxiv 2025.
-
LeMo: Enabling LEss Token Involvement for MOre Context Fine-tuning. Tuowei Wang, Xingyu Chen, Kun Li, Ting Cao, Ju Ren, Yaoxue Zhang. Arxiv 2025.
-
NExtLong: Toward Effective Long-Context Training without Long Documents. Chaochen Gao, Xing Wu, Zijia Lin, Debing Zhang, Songlin Hu. Arxiv 2025.
-
SEAL: Scaling to Emphasize Attention for Long-Context Retrieval. Changhun Lee, Jun-gyu Jin, Younghyun Cho, Eunhyeok Park. Arxiv 2025.
-
DINT Transformer. Yueyang Cang, Yuhang Liu, Xiaoteng Zhang, Erlu Zhao, Li Shi. Arxiv 2025.
-
Scalable-Softmax Is Superior for Attention. Ken M. Nakanishi. Arxiv 2025.
-
Rope to Nope and Back Again: A New Hybrid Attention Strategy. Bowen Yang, Bharat Venkitesh, Dwarak Talupuru, Hangyu Lin, David Cairuz, Phil Blunsom, Acyr Locatelli. Arxiv 2025.
-
A Training-Free Length Extrapolation Approach for LLMs: Greedy Attention Logit Interpolation (GALI). Yan Li, Tianyi Zhang, Zechuan Li, Soyeon Caren Han. Arxiv 2025.
-
LongReD: Mitigating Short-Text Degradation of Long-Context Large Language Models via Restoration Distillation. Zican Dong, Junyi Li, Jinhao Jiang, Mingyu Xu, Wayne Xin Zhao, Bingning Wang, Weipeng Chen. Arxiv 2025.
-
Unveiling Simplicities of Attention: Adaptive Long-Context Head Identification. Konstantin Donhauser, Charles Arnal, Mohammad Pezeshki, Vivien Cabannes, David Lopez-Paz, Kartik Ahuja. Arxiv 2025.
-
The Rotary Position Embedding May Cause Dimension Inefficiency in Attention Heads for Long-Distance Retrieval. Ting-Rui Chiang, Dani Yogatama. Arxiv 2025.
-
LongFaith: Enhancing Long-Context Reasoning in LLMs with Faithful Synthetic Data. Cehao Yang, Xueyuan Lin, Chengjin Xu, Xuhui Jiang, Shengjie Ma, Aofan Liu, Hui Xiong, Jian Guo. Arxiv 2025.
-
LongPO: Long Context Self-Evolution of Large Language Models through Short-to-Long Preference Optimization. Guanzheng Chen, Xin Li, Michael Qizhe Shieh, Lidong Bing. Arxiv 2025.
-
ParallelComp: Parallel Long-Context Compressor for Length Extrapolation. Jing Xiong, Jianghan Shen, Chuanyang Zheng, Zhongwei Wan, Chenyang Zhao, Chiwun Yang, Fanghua Ye, Hongxia Yang, Lingpeng Kong, Ngai Wong. Arxiv 2025.
-
Generalizing From Short to Long: Effective Data Synthesis for Long-Context Instruction Tuning. Wenhao Zhu, Pinzhen Chen, Hanxu Hu, Shujian Huang, Fei Yuan, Jiajun Chen, Alexandra Birch. Arxiv 2025.
-
LongAttn: Selecting Long-context Training Data via Token-level Attention. Longyun Wu, Dawei Zhu, Guangxiang Zhao, Zhuocheng Yu, Junfeng Ran, Xiangyu Wong, Lin Sun, Sujian Li. Arxiv 2025.
-
WildLong: Synthesizing Realistic Long-Context Instruction Data at Scale. Jiaxi Li, Xingxing Zhang, Xun Wang, Xiaolong Huang, Li Dong, Liang Wang, Si-Qing Chen, Wei Lu, Furu Wei. Arxiv 2025.
-
Sliding Window Attention Training for Efficient Large Language Models. Zichuan Fu, Wentao Song, Yejing Wang, Xian Wu, Yefeng Zheng, Yingying Zhang, Derong Xu, Xuetao Wei, Tong Xu, Xiangyu Zhao. Arxiv 2025.
-
LongRoPE2: Near-Lossless LLM Context Window Scaling. Ning Shang, Li Lyna Zhang, Siyuan Wang, Gaokai Zhang, Gilsinia Lopez, Fan Yang, Weizhu Chen, Mao Yang. Arxiv 2025.
-
ByteScale: Efficient Scaling of LLM Training with a 2048K Context Length on More Than 12,000 GPUs. Hao Ge, Junda Feng, Qi Huang, Fangcheng Fu, Xiaonan Nie, Lei Zuo, Haibin Lin, Bin Cui, Xin Liu. Arxiv 2025.
-
Pause-Tuning for Long-Context Comprehension: A Lightweight Approach to LLM Attention Recalibration. James Begin, Namit Agrawal, Eshan Singh, Yicheng Fu, Sean O'Brien, Vasu Sharma, Kevin Zhu. Arxiv 2025.
-
LADM: Long-context Training Data Selection with Attention-based Dependency Measurement for LLMs. Jianghao Chen, Junhong Wu, Yangyifan Xu, Jiajun Zhang. Arxiv 2025.
-
Forgetting Transformer: Softmax Attention with a Forget Gate. Zhixuan Lin, Evgenii Nikishin, Xu Owen He, Aaron Courville. ICLR 2025.
-
Layer-Specific Scaling of Positional Encodings for Superior Long-Context Modeling. Zhenghua Wang, Yiran Ding, Changze Lv, Zhibo Xu, Tianlong Li, Tianyuan Shi, Xiaoqing Zheng, Xuanjing Huang. Arxiv 2025.
-
Token Weighting for Long-Range Language Modeling. Falko Helm, Nico Daheim, Iryna Gurevych. NAACL 2025.
-
From 128K to 4M: Efficient Training of Ultra-Long Context Large Language Models. Chejian Xu, Wei Ping, Peng Xu, Zihan Liu, Boxin Wang, Mohammad Shoeybi, Bo Li, Bryan Catanzaro. Arxiv 2025.
-
SWAN-GPT: An Efficient and Scalable Approach for Long-Context Language Modeling. Krishna C. Puvvada, Faisal Ladhak, Santiago Akle Serrano, Cheng-Ping Hsieh, Shantanu Acharya, Somshubra Majumdar, Fei Jia, Samuel Kriman, Simeng Sun, Dima Rekesh, Boris Ginsburg. Arxiv 2025.
-
Scaling Instruction-Tuned LLMs to Million-Token Contexts via Hierarchical Synthetic Data Generation. Linda He, Jue Wang, Maurice Weber, Shang Zhu, Ben Athiwaratkun, Ce Zhang. Arxiv 2025.
-
Effective Length Extrapolation via Dimension-Wise Positional Embeddings Manipulation. Yi Lu, Wanxu Zhao, Xin Zhou, Chenxin An, Chenglong Wang, Shuo Li, Yuming Yang, Jun Zhao, Tao Ji, Tao Gui, Qi Zhang, Xuanjing Huang. Arxiv 2025.
-
Bayesian Attention Mechanism: A Probabilistic Framework for Positional Encoding and Context Length Extrapolation. Arthur S. Bianchessi, Rodrigo C. Barros, Lucas S. Kupssinskü. Arxiv 2025.
-
Extending the Context of Pretrained LLMs by Dropping Their Positional Embeddings. Yoav Gelberg, Koshi Eguchi, Takuya Akiba, Edoardo Cetin. Arxiv 2025.
-
Explain Before You Answer: A Survey on Compositional Visual Reasoning Fucai Ke, Joy Hsu, Zhixi Cai, Zixian Ma, Xin Zheng, Xindi Wu, Sukai Huang, Weiqing Wang, Pari Delir Haghighi, Gholamreza Haffari, Ranjay Krishna, Jiajun Wu, Hamid Rezatofighi. Arxiv 2025.
-
HoPE: Hyperbolic Rotary Positional Encoding for Stable Long-Range Dependency Modeling in Large Language Models Chang Dai, Hongyu Shan, Mingyang Song, Di Liang. Arxiv 2025.
-
Positional Encoding via Token-Aware Phase Attention Yu, Wang, Sheng Shen, Rémi Munos, Hongyuan Zhan, Yuandong Tian. Arxiv 2025.
-
RePo: Language Models with Context Re-Positioning Huayang Li, Tianyu Zhao, Richard Sproat. Arxiv 2025.
-
Variation-aware Vision Token Dropping for Faster Large Vision-Language Models Junjie Chen, Xuyang Liu, Zichen Wen, Yiyu Wang, Siteng Huang, Honggang Chen. Arxiv 2025.
-
D-CoDe: Scaling Image-Pretrained VLMs to Video via Dynamic Compression and Question Decomposition Yiyang Huang, Yizhou Wang, Yun Fu. Arxiv 2025.
-
Periodic RoPE for Infinite Context LLMs. Simin Huo. Arxiv 2026.
-
Disentangling the Expressivity of RoPE. Selim Jerad, Anej Svete, Jiaoda Li, Ryan Cotterell. Arxiv 2026.
-
Position Encoding in Transformers: From Absolute and Relative Methods to Rotary Position Embeddings and Long-Context Scaling. Jiguo Li. Arxiv 2026.
-
Anti-Periodic Positional Encoding: Möbius Boundary Conditions Make In-Context Retrieval Reliable. Ji Ho Bae. Arxiv 2026.
Architecture
-
Compressive Transformers for Long-Range Sequence Modelling. Jack W. Rae, Anna Potapenko, Siddhant M. Jayakumar, Timothy P. Lillicrap. Arxiv 2019.
-
Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, François Fleuret. ICML 2020.
-
Block-Recurrent Transformers. DeLesley Hutchins, Imanol Schlag, Yuhuai Wu, Ethan Dyer, Behnam Neyshabur. Arxiv 2023.
-
Memorizing Transformers. Yuhuai Wu, Markus N. Rabe, DeLesley Hutchins, Christian Szegedy. Arxiv 2022.
-
GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, Sumit Sanghai. Arxiv 2023.
-
Zebra: Extending Context Window with Layerwise Grouped Local-Global Attention. Kaiqiang Song, Xiaoyang Wang, Sangwoo Cho, Xiaoman Pan, Dong Yu. Arxiv 2023.
-
Leave No Context Behind: Efficient Infinite Context Transformers with Infini-attention. Tsendsuren Munkhdalai, Manaal Faruqui, Siddharth Gopal. Arxiv 2024.
-
Weighted Grouped Query Attention in Transformers. Sai Sena Chinnakonduru, Astarag Mohapatra. Arxiv 2024.
-
Associative Recurrent Memory Transformer. Ivan Rodkin, Yuri Kuratov, Aydar Bulatov, Mikhail Burtsev. ICML 2024 Workshop.
-
Simple linear attention language models balance the recall-throughput tradeoff. Simran Arora, Sabri Eyuboglu, Michael Zhang, Aman Timalsina, Silas Alberti, Dylan Zinsley, James Zou, Atri Rudra, Christopher Ré. Arxiv 2024.
-
DuoAttention: Efficient Long-Context LLM Inference with Retrieval and Streaming Heads. Guangxuan Xiao, Jiaming Tang, Jingwei Zuo, Junxian Guo, Shang Yang, Haotian Tang, Yao Fu, Song Han. Arxiv 2024.
-
TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention. Lijie Yang, Zhihao Zhang, Zhuofu Chen, Zikun Li, Zhihao Jia. Arxiv 2024.
-
Selective Attention Improves Transformer. Yaniv Leviathan, Matan Kalman, Yossi Matias. Arxiv 2024.
-
SnapKV: LLM Knows What You are Looking for Before Generation. Yuhong Li, Yingbing Huang, Bowen Yang, Bharat Venkitesh, Acyr Locatelli, Hanchen Ye, Tianle Cai, Patrick Lewis, Deming Chen. Arxiv 2024.
-
Extra Global Attention Designation Using Keyword Detection in Sparse Transformer Architectures. Evan Lucas, Dylan Kangas, Timothy C Havens. Arxiv 2024.
-
An Empirical Study of Mamba-based Language Models. Roger Waleffe, Wonmin Byeon, Duncan Riach, Brandon Norick, Vijay Korthikanti, Tri Dao, Albert Gu, Ali Hatamizadeh, Sudhakar Singh, Deepak Narayanan, Garvit Kulshreshtha, Vartika Singh, Jared Casper, Jan Kautz, Mohammad Shoeybi, Bryan Catanzaro. Arxiv 2024.
-
Lightning Attention-2: A Free Lunch for Handling Unlimited Sequence Lengths in Large Language Models. Zhen Qin, Weigao Sun, Dong Li, Xuyang Shen, Weixuan Sun, Yiran Zhong. Arxiv 2024.
-
Various Lengths, Constant Speed: Efficient Language Modeling with Lightning Attention. Zhen Qin, Weigao Sun, Dong Li, Xuyang Shen, Weixuan Sun, Yiran Zhong. Arxiv 2024.
-
SeerAttention: Learning Intrinsic Sparse Attention in Your LLMs. Yizhao Gao, Zhichen Zeng, Dayou Du, Shijie Cao, Hayden Kwok-Hay So, Ting Cao, Fan Yang, Mao Yang. Arxiv 2024.
-
Stuffed Mamba: State Collapse and State Capacity of RNN-Based Long-Context Modeling. Yingfa Chen, Xinrong Zhang, Shengding Hu, Xu Han, Zhiyuan Liu, Maosong Sun. Arxiv 2024.
-
Taipan: Efficient and Expressive State Space Language Models with Selective Attention. Chien Van Nguyen, Huy Huu Nguyen, Thang M. Pham, Ruiyi Zhang, Hanieh Deilamsalehy, Puneet Mathur, Ryan A. Rossi, Trung Bui, Viet Dac Lai, Franck Dernoncourt, Thien Huu Nguyen. Arxiv 2024.
-
Megalodon: Efficient LLM Pretraining and Inference with Unlimited Context Length. Xuezhe Ma, Xiaomeng Yang, Wenhan Xiong, Beidi Chen, Lili Yu, Hao Zhang, Jonathan May, Luke Zettlemoyer, Omer Levy, Chunting Zhou. Arxiv 2024. . Djork-Arné Clevert, Thomas Unterthiner, Sepp Hochreiter. Arxiv 2016
-
Neural Discrete Representation Learning. Aaron van den Oord, Oriol Vinyals, Koray Kavukcuoglu. Arxiv 2018
-
Improving spiking dynamical networks: Accurate delays, higher-order synapses, and time cells. Voelker, Aaron R and Eliasmith, Chris. IEEE 2018
-
Improving language understanding by generative pre-training. Radford, Alec and Narasimhan, Karthik and Salimans, Tim and Sutskever, Ilya and others. mikecaptain 2018
-
Memformer: The Memory-Augmented Transformer. Qingyang Wu, Zhenzhong Lan, Jing Gu, Zhou Yu. Arxiv 2020
-
Linformer: Self-Attention with Linear Complexity. Sinong Wang, Belinda Z. Li, Madian Khabsa, Han Fang, Hao Ma. Arxiv 2020
-
Combining Recurrent, Convolutional, and Continuous-time Models with Linear State Space Layers. Albert Gu, Isys Johnson, Karan Goel, Khaled Saab, Tri Dao, Atri Rudra, Christopher R{'{e}}. Arxiv 2021
-
Nystr"omformer: A Nystr"om-Based Algorithm for Approximating Self-Attention. Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, Vikas Singh. Arxiv 2021
-
Efficient attention: Attention with linear complexities. Zhuoran Shen and Mingyuan Zhang and Haiyu Zhao and Shuai Yi and Hongsheng Li. Arxiv 2024
-
ERNIE-SPARSE: Learning Hierarchical Efficient Transformer Through Regularized Self-Attention. Yang Liu, Jiaxiang Liu, Li Chen, Yuxiang Lu, Shikun Feng, Zhida Feng, Yu Sun, Hao Tian, Hua Wu, Haifeng Wang. Arxiv 2022
-
cosFormer: Rethinking Softmax in Attention. Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, Yiran Zhong. Arxiv 2022
-
Rethinking Attention with Performers. Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, David Belanger, Lucy Colwell, Adrian Weller. Arxiv 2022
-
Multi-head state space model for speech recognition. Yassir Fathullah and Chunyang Wu and Yuan Shangguan and Junteng Jia and Wenhan Xiong and Jay Mahadeokar and Chunxi Liu and Yangyang Shi and Ozlem Kalinli and Mike Seltzer and Mark J. F. Gales. Arxiv 2023
-
Attention Is All You Need. Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin. Arxiv 2023
-
Retentive Network: A Successor to Transformer for Large Language Models. Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, Furu Wei. Arxiv 2023
-
Scaling Transformer to 1M tokens and beyond with {RMT}. Aydar Bulatov and Yuri Kuratov and Yermek Kapushev and Mikhail S. Burtsev. Arxiv 2024
-
FLatten Transformer: Vision Transformer using Focused Linear Attention. Dongchen Han, Xuran Pan, Yizeng Han, Shiji Song, Gao Huang. Arxiv 2023
-
TRAMS: Training-free Memory Selection for Long-range Language Modeling. Haofei Yu and Cunxiang Wang and Yue Zhang and Wei Bi. Arxiv 2023
-
Segmented Recurrent Transformer: An Efficient Sequence-to-Sequence Model. Yinghan Long and Sayeed Shafayet Chowdhury and Kaushik Roy. Arxiv 2023
-
Transformer-VQ: Linear-Time Transformers via Vector Quantization. Lucas D. Lingle. Arxiv 2024
-
Transformers are SSMs: Generalized models and efficient algorithms through structured state space duality. Tri Dao and Albert Gu. Arxiv 2024
-
Block-state transformers. Mahan Fathi and Jonathan Pilault and Orhan Firat and Christopher Pal and Pierre-Luc Bacon and Ross Goroshin. Arxiv 2023
-
Extensible Embedding: {A} Flexible Multipler For LLM's Context Length. Ninglu Shao and Shitao Xiao and Zheng Liu and Peitian Zhang. Arxiv 2024
-
DeciMamba: Exploring the Length Extrapolation Potential of Mamba. Assaf Ben-Kish, Itamar Zimerman, Shady Abu-Hussein, Nadav Cohen, Amir Globerson, Lior Wolf, Raja Giryes. Arxiv 2024
-
CORM: Cache Optimization with Recent Message for Large Language Model Inference. Jincheng Dai, Zhuowei Huang, Haiyun Jiang, Chen Chen, Deng Cai, Wei Bi, Shuming Shi. Arxiv 2024
-
Longformer: The Long-Document Transformer. Iz Beltagy, Matthew E. Peters, Arman Cohan. Arxiv 2020.
-
Model Tells You What to Discard: Adaptive KV Cache Compression for LLMs. Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, Jianfeng Gao. ICLR 2024 Oral.
-
PyramidKV: Dynamic KV Cache Compression based on Pyramidal Information Funneling. Zefan Cai., Yichi Zhang, Bofei Gao, Tianyu Liu, Keming Lu, Wayne Xiong, Yue Dong, Baobao Chang, Junjie Hu, Wen Xiao. Arxiv 2024.
-
RazorAttention: Efficient KV Cache Compression Through Retrieval Heads. Hanlin Tang, Yang Lin, Jing Lin, Qingsen Han, Shikuan Hong, Yiwu Yao, Gongyi Wang. Arxiv 2024.
-
Not All Heads Matter: A Head-Level KV Cache Compression Method with Integrated Retrieval and Reasoning. Yu Fu, Zefan Cai, Abedelkadir Asi, Wayne Xiong, Yue Dong, Wen Xiao. Arxiv 2024.
-
Quest: Query-Aware Sparsity for Efficient Long-Context LLM Inference. Jiaming Tang, Yilong Zhao, Kan Zhu, Guangxuan Xiao, Baris Kasikci, Song Han. ICML 2024.
-
Efficient Streaming Language Models with Attention Sinks. Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis. Arxiv 2023.
-
PyramidInfer: Pyramid KV Cache Compression for High-throughput LLM Inference. William Brandon, Mayank Mishra, Aniruddha Nrusimha, Rameswar Panda, Jonathan Ragan Kelly. Arxiv 2024.
-
MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention. Huiqiang Jiang, Yucheng Li, Chengruidong Zhang, Qianhui Wu, Xufang Luo, Surin Ahn, Zhenhua Han, Amir H. Abdi, Dongsheng Li, Chin-Yew Lin, Yuqing Yang, Lili Qiu. Arxiv 2024.
-
LazyLLM: Dynamic Token Pruning for Efficient Long Context LLM Inference. Qichen Fu, Minsik Cho, Thomas Merth, Sachin Mehta, Mohammad Rastegari, Mahyar Najibi. Arxiv 2024.
-
DynamicKV: Task-Aware Adaptive KV Cache Compression for Long Context LLMs. Xiabin Zhou, Wenbin Wang, Minyan Zeng, Jiaxian Guo, Xuebo Liu, Li Shen, Min Zhang, Liang Ding. Arxiv 2024.
-
H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models. Zhenyu Zhang, Ying Sheng, Tianyi Zhou, Tianlong Chen, Lianmin Zheng, Ruisi Cai, Zhao Song, Yuandong Tian, Christopher R'{e}, Clark Barrett, Zhangyang "Atlas" Wang, Beidi Chen. Arxiv 2023
-
Scissorhands: Exploiting the Persistence of Importance Hypothesis for LLM KV Cache Compression at Test Time. Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, Anshumali Shrivastava. Arxiv 2023
-
Loki: Low-rank Keys for Efficient Sparse Attention. Prajwal Singhania, Siddharth Singh, Shwai He, Soheil Feizi, Abhinav Bhatele. Arxiv 2024
-
LM-Infinite: Zero-Shot Extreme Length Generalization for Large Language Models. Chi Han, Qifan Wang, Hao Peng, Wenhan Xiong, Yu Chen, Heng Ji, Sinong Wang. Arxiv 2024
-
Ada-KV: Optimizing KV Cache Eviction by Adaptive Budget Allocation for Efficient LLM Inference. Yuan Feng, Junlin Lv, Yukun Cao, Xike Xie, S. Kevin Zhou. Arxiv 2025
-
LightTransfer: Your Long-Context LLM is Secretly a Hybrid Model with Effortless Adaptation. Xuan Zhang, Fengzhuo Zhang, Cunxiao Du, Chao Du, Tianyu Pang, Wei Gao, Min Lin. Arxiv 2025
-
Hierarchical Attention Networks for Document Classification. Zichao Yang, Diyi Yang, Chris Dyer, Xiaodong He, Alexander J. Smola, Eduard H. Hovy. Arxiv 2016
-
Neural Tangent Kernel: Convergence and Generalization in Neural Networks. Arthur Jacot, Cl{'{e}}ment Hongler, Franck Gabriel. Arxiv 2018
-
Transformer-XL: Attentive Language Models beyond a Fixed-Length Context. Zihang Dai, Zhilin Yang, Yiming Yang, Jaime G. Carbonell, Quoc Viet Le, Ruslan Salakhutdinov. Arxiv 2019
-
{BERT}: Pre-training of Deep Bidirectional Transformers for Language Understanding. Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova. Arxiv 2019
-
HiPPO: Recurrent Memory with Optimal Polynomial Projections. Albert Gu, Tri Dao, Stefano Ermon, Atri Rudra, Christopher R{'{e}}. Arxiv 2020
-
Language Models are Few-Shot Learners. Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert{-}Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, Dario Amodei. Arxiv 2020
-
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, Peter J. Liu. Arxiv 2020
-
Hi-Transformer: Hierarchical Interactive Transformer for Efficient and Effective Long Document Modeling. Chuhan Wu, Fangzhao Wu, Tao Qi, Yongfeng Huang. Arxiv 2021
-
Nystr{"{o}}mformer: {A} Nystr{"{o}}m-based Algorithm for Approximating Self-Attention. Yunyang Xiong, Zhanpeng Zeng, Rudrasis Chakraborty, Mingxing Tan, Glenn Fung, Yin Li, Vikas Singh. Arxiv 2021
-
{GLM}: General Language Model Pretraining with Autoregressive Blank Infilling. Zhengxiao Du, Yujie Qian, Xiao Liu, Ming Ding, Jiezhong Qiu, Zhilin Yang, Jie Tang. Arxiv 2022
-
{OPT:} Open Pre-trained Transformer Language Models. Susan Zhang, Stephen Roller, Naman Goyal, Mikel Artetxe, Moya Chen, Shuohui Chen, Christopher Dewan, Mona T. Diab, Xian Li, Xi Victoria Lin, Todor Mihaylov, Myle Ott, Sam Shleifer, Kurt Shuster, Daniel Simig, Punit Singh Koura, Anjali Sridhar, Tianlu Wang, Luke Zettlemoyer. Arxiv 2022
-
{BLOOM:} {A} 176B-Parameter Open-Access Multilingual Language Model. Teven Le Scao, Angela Fan, Christopher Akiki, Ellie Pavlick, Suzana Ilic, Daniel Hesslow, Roman Castagn{'{e}}, Alexandra Sasha Luccioni, Fran{\c{c}}ois Yvon, Matthias Gall{'{e}}, Jonathan Tow, Alexander M. Rush, Stella Biderman, Albert Webson, Pawan Sasanka Ammanamanchi, Thomas Wang, Beno{^{\i}}t Sagot, Niklas Muennighoff, Albert Villanova del Moral, Olatunji Ruwase, Rachel Bawden, Stas Bekman, Angelina McMillan{-}Major, Iz Beltagy, Huu Nguyen, Lucile Saulnier, Samson Tan, Pedro Ortiz Suarez, Victor Sanh, Hugo Lauren{\c{c}}on, Yacine Jernite, Julien Launay, Margaret Mitchell, Colin Raffel, Aaron Gokaslan, Adi Simhi, Aitor Soroa, Alham Fikri Aji, Amit Alfassy, Anna Rogers, Ariel Kreisberg Nitzav, Canwen Xu, Chenghao Mou, Chris Emezue, Christopher Klamm, Colin Leong, Daniel van Strien, David Ifeoluwa Adelani, et al.. Arxiv 2022
-
Efficiently Modeling Long Sequences with Structured State Spaces. Albert Gu, Karan Goel, Christopher R{'{e}}. Arxiv 2022
-
NTK-ALiBi: Long Text Extrapolation of ALiBi Position Encoding through Interpolation. Arxiv 2023
-
LLaMA: Open and Efficient Foundation Language Models. Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie{-}Anne Lachaux, Timoth{'{e}}e Lacroix, Baptiste Rozi{`{e}}re, Naman Goyal, Eric Hambro, Faisal Azhar, Aur{'{e}}lien Rodriguez, Armand Joulin, Edouard Grave, Guillaume Lample. Arxiv 2023
-
Position Interpolation Improves ALiBi Extrapolation. Faisal Al{-}Khateeb, Nolan Dey, Daria Soboleva, Joel Hestness. Arxiv 2023
-
Efficient Prompting via Dynamic In-Context Learning. Wangchunshu Zhou, Yuchen Eleanor Jiang, Ryan Cotterell, Mrinmaya Sachan. Arxiv 2023
-
{RWKV:} Reinventing RNNs for the Transformer Era. Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Stella Biderman, Huanqi Cao, Xin Cheng, Michael Chung, Leon Derczynski, Xingjian Du, Matteo Grella, Kranthi Kiran GV, Xuzheng He, Haowen Hou, Przemyslaw Kazienko, Jan Kocon, Jiaming Kong, Bartlomiej Koptyra, Hayden Lau, Jiaju Lin, Krishna Sri Ipsit Mantri, Ferdinand Mom, Atsushi Saito, Guangyu Song, Xiangru Tang, Johan S. Wind, Stanislaw Wozniak, Zhenyuan Zhang, Qinghua Zhou, Jian Zhu, Rui{-}Jie Zhu. Arxiv 2023
-
{GQA:} Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. Joshua Ainslie, James Lee{-}Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebr{'{o}}n, Sumit Sanghai. Arxiv 2023
-
Baichuan 2: Open Large-scale Language Models. Aiyuan Yang, Bin Xiao, Bingning Wang, Borong Zhang, Ce Bian, Chao Yin, Chenxu Lv, Da Pan, Dian Wang, Dong Yan, Fan Yang, Fei Deng, Feng Wang, Feng Liu, Guangwei Ai, Guosheng Dong, Haizhou Zhao, Hang Xu, Haoze Sun, Hongda Zhang, Hui Liu, Jiaming Ji, Jian Xie, Juntao Dai, Kun Fang, Lei Su, Liang Song, Lifeng Liu, Liyun Ru, Luyao Ma, Mang Wang, Mickel Liu, MingAn Lin, Nuolan Nie, Peidong Guo, Ruiyang Sun, Tao Zhang, Tianpeng Li, Tianyu Li, Wei Cheng, Weipeng Chen, Xiangrong Zeng, Xiaochuan Wang, Xiaoxi Chen, Xin Men, Xin Yu, Xuehai Pan, Yanjun Shen, Yiding Wang, Yiyu Li, Youxin Jiang, Yuchen Gao, Yupeng Zhang, Zenan Zhou, Zhiying Wu. Arxiv 2023
-
Eagle and Finch: RWKV with Matrix-Valued States and Dynamic Recurrence. Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Xingjian Du, Teddy Ferdinan, Haowen Hou, Przemysław Kazienko, Kranthi Kiran GV, Jan Kocoń, Bartłomiej Koptyra, Satyapriya Krishna, Ronald McClelland Jr., Jiaju Lin, Niklas Muennighoff, Fares Obeid, Atsushi Saito, Guangyu Song, Haoqin Tu, Cahya Wirawan, Stanisław Woźniak, Ruichong Zhang, Bingchen Zhao, Qihang Zhao, Peng Zhou, Jian Zhu, Rui-Jie Zhu. Arxiv 2024
-
Fortify the Shortest Stave in Attention: Enhancing Context Awareness of Large Language Models for Effective Tool Use. Yuhan Chen, Ang Lv, Ting{-}En Lin, Changyu Chen, Yuchuan Wu, Fei Huang, Yongbin Li, Rui Yan. Arxiv 2024
-
QUEST: Query-Aware Sparsity for Efficient Long-Context {LLM} Inference. Jiaming Tang, Yilong Zhao, Kan Zhu, Guangxuan Xiao, Baris Kasikci, Song Han. Arxiv 2024
-
RecurrentGemma: Moving Past Transformers for Efficient Open Language Models. Aleksandar Botev, Soham De, Samuel L. Smith, Anushan Fernando, George{-}Cristian Muraru, Ruba Haroun, Leonard Berrada, Razvan Pascanu, Pier Giuseppe Sessa, Robert Dadashi, L{'{e}}onard Hussenot, Johan Ferret, Sertan Girgin, Olivier Bachem, Alek Andreev, Kathleen Kenealy, Thomas Mesnard, Cassidy Hardin, Surya Bhupatiraju, Shreya Pathak, Laurent Sifre, Morgane Rivi{`{e}}re, Mihir Sanjay Kale, Juliette Love, Pouya Tafti, Armand Joulin, Noah Fiedel, Evan Senter, Yutian Chen, Srivatsan Srinivasan, Guillaume Desjardins, David Budden, Arnaud Doucet, Sharad Vikram, Adam Paszke, Trevor Gale, Sebastian Borgeaud, Charlie Chen, Andy Brock, Antonia Paterson, Jenny Brennan, Meg Risdal, Raj Gundluru, Nesh Devanathan, Paul Mooney, Nilay Chauhan, Phil Culliton, Luiz GUStavo Martins, Elisa Bandy, David Huntsperger, Glenn Cameron, Arthur Zucker, Tris Warkentin, Ludovic Peran, Minh Giang, Zoubin Ghahramani, Cl{'{e}}ment Farabet, Koray Kavukcuoglu, Demis Hassabis, Raia Hadsell, Yee Whye Teh, Nando de Frietas. Arxiv 2024
-
SnapKV: LLM Knows What You are Looking for Before Generation. Yuhong Li, Yingbing Huang, Bowen Yang, Bharat Venkitesh, Acyr Locatelli, Hanchen Ye, Tianle Cai, Patrick Lewis, Deming Chen. Arxiv 2024
-
PyramidInfer: Pyramid {KV} Cache Compression for High-throughput {LLM} Inference. Dongjie Yang, Xiaodong Han, Yan Gao, Yao Hu, Shilin Zhang, Hai Zhao. Arxiv 2024
-
HiRoPE: Length Extrapolation for Code Models Using Hierarchical Position. Kechi Zhang, Ge Li, Huangzhao Zhang, Zhi Jin. Arxiv 2024
-
DAPE V2: Process Attention Score as Feature Map for Length Extrapolation. Chuanyang Zheng, Yihang Gao, Han Shi, Jing Xiong, Jiankai Sun, Jingyao Li, Minbin Huang, Xiaozhe Ren, Michael K. Ng, Xin Jiang, Zhenguo Li, Yu Li. Arxiv 2024
-
LM-Infinite: Zero-Shot Extreme Length Generalization for Large Language Models. Chi Han, Qifan Wang, Hao Peng, Wenhan Xiong, Yu Chen, Heng Ji, Sinong Wang. Arxiv 2024
-
Model Tells You What to Discard: Adaptive {KV} Cache Compression for {LLM}s. Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, Jianfeng Gao. Arxiv 2024
-
LongRecipe: Recipe for Efficient Long Context Generalization in Large Language Models. Zhiyuan Hu, Yuliang Liu, Jinman Zhao, Suyuchen Wang, Yan Wang, Wei Shen, Qing Gu, Anh Tuan Luu, See{-}Kiong Ng, Zhiwei Jiang, Bryan Hooi. Arxiv 2024
-
LongHeads: Multi-Head Attention is Secretly a Long Context Processor. Yi Lu, Xin Zhou, Wei He, Jun Zhao, Tao Ji, Tao Gui, Qi Zhang, Xuanjing Huang. Arxiv 2024
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces. Albert Gu, Tri Dao. Arxiv 2024
-
DeepSeek-V2: {A} Strong, Economical, and Efficient Mixture-of-Experts Language Model. DeepSeek{-}AI, Aixin Liu, Bei Feng, Bin Wang, Bingxuan Wang, Bo Liu, Chenggang Zhao, Chengqi Deng, Chong Ruan, Damai Dai, Daya Guo, Dejian Yang, Deli Chen, Dongjie Ji, Erhang Li, Fangyun Lin, Fuli Luo, Guangbo Hao, Guanting Chen, Guowei Li, Hao Zhang, Hanwei Xu, Hao Yang, Haowei Zhang, Honghui Ding, Huajian Xin, Huazuo Gao, Hui Li, Hui Qu, J. L. Cai, Jian Liang, Jianzhong Guo, Jiaqi Ni, Jiashi Li, Jin Chen, Jingyang Yuan, Junjie Qiu, Junxiao Song, Kai Dong, Kaige Gao, Kang Guan, Lean Wang, Lecong Zhang, Lei Xu, Leyi Xia, Liang Zhao, Liyue Zhang, Meng Li, Miaojun Wang, Mingchuan Zhang, Minghua Zhang, Minghui Tang, Mingming Li, Ning Tian, Panpan Huang, Peiyi Wang, Peng Zhang, Qihao Zhu, Qinyu Chen, Qiushi Du, R. J. Chen, R. L. Jin, Ruiqi Ge, Ruizhe Pan, Runxin Xu, Ruyi Chen, S. S. Li, Shanghao Lu, Shangyan Zhou, Shanhuang Chen, Shaoqing Wu, Shengfeng Ye, Shirong Ma, Shiyu Wang, Shuang Zhou, Shuiping Yu, Shunfeng Zhou, Size Zheng, Tao Wang, Tian Pei, Tian Yuan, Tianyu Sun, W. L. Xiao, Wangding Zeng, Wei An, Wen Liu, Wenfeng Liang, Wenjun Gao, Wentao Zhang, X. Q. Li, Xiangyue Jin, Xianzu Wang, Xiao Bi, Xiaodong Liu, Xiaohan Wang, Xiaojin Shen, Xiaokang Chen, Xiaosha Chen, Xiaotao Nie, Xiaowen Sun. Arxiv 2024
-
Can Mamba Learn How To Learn? {A} Comparative Study on In-Context Learning Tasks. Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee, Dimitris Papailiopoulos. Arxiv 2024
-
You Only Cache Once: Decoder-Decoder Architectures for Language Models. Yutao Sun, Li Dong, Yi Zhu, Shaohan Huang, Wenhui Wang, Shuming Ma, Quanlu Zhang, Jianyong Wang, Furu Wei. Arxiv 2024
-
Zamba: A Compact 7B SSM Hybrid Model. Paolo Glorioso, Quentin Anthony, Yury Tokpanov, James Whittington, Jonathan Pilault, Adam Ibrahim, Beren Millidge. Arxiv 2024
-
Qwen2.5-1M Technical Report. An Yang, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoyan Huang, Jiandong Jiang, Jianhong Tu, Jianwei Zhang, Jingren Zhou, Junyang Lin, Kai Dang, Kexin Yang, Le Yu, Mei Li, Minmin Sun, Qin Zhu, Rui Men, Tao He, Weijia Xu, Wenbiao Yin, Wenyuan Yu, Xiafei Qiu, Xingzhang Ren, Xinlong Yang, Yong Li, Zhiying Xu, Zipeng Zhang. Arxiv 2025
-
RazorAttention: Efficient {KV} Cache Compression Through Retrieval Heads. Hanlin Tang, Yang Lin, Jing Lin, Qingsen Han, Danning Ke, Shikuan Hong, Yiwu Yao, Gongyi Wang. Arxiv 2025
-
LightTransfer: Your Long-Context {LLM} is Secretly a Hybrid Model with Effortless Adaptation. Xuan Zhang, Fengzhuo Zhang, Cunxiao Du, Chao Du, Tianyu Pang, Wei Gao, Min Lin. Arxiv 2025
-
Unshackling Context Length: An Efficient Selective Attention Approach through Query-Key Compression. Haoyu Wang, Tong Teng, Tianyu Guo, An Xiao, Duyu Tang, Hanting Chen, Yunhe Wang. Arxiv 2025.
-
Towards Economical Inference: Enabling DeepSeek's Multi-Head Latent Attention in Any Transformer-based LLMs. Tao Ji, Bin Guo, Yuanbin Wu, Qipeng Guo, Lixing Shen, Zhan Chen, Xipeng Qiu, Qi Zhang, Tao Gui. Arxiv 2025.
-
SVDq: 1.25-bit and 410x Key Cache Compression for LLM Attention. Hong Yankun, Li Xing, Zhen Hui-Ling, Yu Xianzhi, Liu Wulong, Yuan Mingxuan. Arxiv 2025.
-
Round Attention: A Novel Round-Level Attention Mechanism to Accelerate LLM Inference. Yaohua Tang, Zhicheng Hu, Kun Cheng, Fan Mo, Qiheng Lv, Hua Wang, Zhi Chen. Arxiv 2025.
-
DBudgetKV: Dynamic Budget in KV Cache Compression for Ensuring Optimal Performance. Xuanfan Ni, Liyan Xu, Chenyang Lyu, Longyue Wang, Mo Yu, Lemao Liu, Fandong Meng, Jie Zhou, Piji Li. Arxiv 2025.
-
KVLink: Accelerating Large Language Models via Efficient KV Cache Reuse. Jingbo Yang, Bairu Hou, Wei Wei, Yujia Bao, Shiyu Changi. Arxiv 2025.
-
FairKV: Balancing Per-Head KV Cache for Fast Multi-GPU Inference. Bingzhe Zhao, Ke Cheng, Aomufei Yuan, Yuxuan Tian, Ruiguang Zhong, Chengchen Hu, Tong Yang, Lian Yu. Arxiv 2025.
-
CoKV: Optimizing KV Cache Allocation via Cooperative Game. Qiheng Sun, Hongwei Zhang, Haocheng Xia, Jiayao Zhang, Jinfei Liu, Kui Ren. Arxiv 2025.
-
MEDA: Dynamic KV Cache Allocation for Efficient Multimodal Long-Context Inference. Zhongwei Wan, Hui Shen, Xin Wang, Che Liu, Zheda Mai, Mi Zhang. NAACL 2025.
-
FlexPrefill: A Context-Aware Sparse Attention Mechanism for Efficient Long-Sequence Inference. Xunhao Lai, Jianqiao Lu, Yao Luo, Yiyuan Ma, Xun Zhou. ICLR 2025 Oral.
-
WeightedKV: Attention Scores Weighted Key-Value Cache Merging for Large Language Models. Jian Yuan, Ziwei He, Haoli Bai, Jingwen Leng, Bo Jiang. ICASSP 2025.
-
Dialogue Without Limits: Constant-Sized KV Caches for Extended Responses in LLMs. Ravi Ghadia, Avinash Kumar, Gaurav Jain, Prashant Nair, Poulami Das. Arxiv 2025.
-
KVCrush: Key value cache size-reduction using similarity in head-behaviour. Gopi Krishna Jha, Sameh Gobriel, Liubov Talamanova, Alexander Kozlov, Nilesh Jain. Arxiv 2025.
-
EliteKV: Scalable KV Cache Compression via RoPE Frequency Selection and Joint Low-Rank Projection. Yuhao Zhou, Sirui Song, Boyang Liu, Zhiheng Xi, Senjie Jin, Xiaoran Fan, Zhihao Zhang, Wei Li, Xuanjing Huang. Arxiv 2025.
-
Progressive Sparse Attention: Algorithm and System Co-design for Efficient Attention in LLM Serving. Qihui Zhou, Peiqi Yin, Pengfei Zuo, James Cheng. Arxiv 2025.
-
Q-Filters: Leveraging QK Geometry for Efficient KV Cache Compression. Nathan Godey, Alessio Devoto, Yu Zhao, Simone Scardapane, Pasquale Minervini, Éric de la Clergerie, Benoît Sagot. Arxiv 2025.
-
TokenButler: Token Importance is Predictable. Yash Akhauri, Ahmed F AbouElhamayed, Yifei Gao, Chi-Chih Chang, Nilesh Jain, Mohamed S. Abdelfattah. Arxiv 2025.
-
Slim attention: cut your context memory in half without loss of accuracy -- K-cache is all you need for MHA. Nils Graef, Andrew Wasielewski. Arxiv 2025.
-
LLMs Know What to Drop: Self-Attention Guided KV Cache Eviction for Efficient Long-Context Inference. Guangtao Wang, Shubhangi Upasani, Chen Wu, Darshan Gandhi, Jonathan Li, Changran Hu, Bo Li, Urmish Thakker. ICLR 2025.
-
KV-Distill: Nearly Lossless Learnable Context Compression for LLMs. Vivek Chari, Guanghui Qin, Benjamin Van Durme. Arxiv 2025.
-
Radar: Fast Long-Context Decoding for Any Transformer. Yongchang Hao, Mengyao Zhai, Hossein Hajimirsadeghi, Sepidehsadat Hosseini, Frederick Tung. ICLR 2025.
-
PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention. Lida Chen, Dong Xu, Chenxin An, Xintao Wang, Yikai Zhang, Jiangjie Chen, Zujie Liang, Feng Wei, Jiaqing Liang, Yanghua Xiao, Wei Wang. Arxiv 2025.
-
Cost-Optimal Grouped-Query Attention for Long-Context LLMs. Yingfa Chen, Yutong Wu, Xu Han, Zhiyuan Liu, Maosong Sun. Arxiv 2025.
-
ZeroMerge: Parameter-Free KV Cache Compression for Memory-Efficient Long-Context LLMs. Xin Liu, Pei Liu, Guoming Tang. Arxiv 2025.
-
Exploring the Limits of KV Cache Compression in Visual Autoregressive Transformers. Bo Chen, Xiaoyu Li, Yekun Ke, Yingyu Liang, Zhenmei Shi, Zhao Song. Arxiv 2025.
-
SpeCache: Speculative Key-Value Caching for Efficient Generation of LLMs. Shibo Jie, Yehui Tang, Kai Han, Zhi-Hong Deng, Jing Han. Arxiv 2025.
-
KVShare: Semantic-Aware Key-Value Cache Sharing for Efficient Large Language Model Inference. Huan Yang, Renji Zhang, Deyu Zhang. Arxiv 2025.
-
xKV: Cross-Layer SVD for KV-Cache Compression. Chi-Chih Chang, Chien-Yu Lin, Yash Akhauri, Wei-Cheng Lin, Kai-Chiang Wu, Luis Ceze, Mohamed S. Abdelfattah. Arxiv 2025.
-
WindowKV: Task-Adaptive Group-Wise KV Cache Window Selection for Efficient LLM Inference. Youhui Zuo, Sibo Wei, Chen Zhang, Zhuorui Liu, Wenpeng Lu, Dawei Song. Arxiv 2025.
-
BitDecoding: Unlocking Tensor Cores for Long-Context LLMs Decoding with Low-Bit KV Cache. Dayou Du, Shijie Cao, Jianyi Cheng, Ting Cao, Mao Yang. Arxiv 2025.
-
Oaken: Fast and Efficient LLM Serving with Online-Offline Hybrid KV Cache Quantization. Minsu Kim, Seongmin Hong, RyeoWook Ko, Soongyu Choi, Hunjong Lee, Junsoo Kim, Joo-Young Kim, Jongse Park. Arxiv 2025.
-
LogQuant: Log-Distributed 2-Bit Quantization of KV Cache with Superior Accuracy Preservation. Han Chen, Zicong Jiang, Zining Zhang, Bingsheng He, Pingyi Luo, Mian Lu, Yuqiang Chen. ICLR 2025.
-
Cocktail: Chunk-Adaptive Mixed-Precision Quantization for Long-Context LLM Inference. Wei Tao, Bin Zhang, Xiaoyang Qu, Jiguang Wan, Jianzong Wang. DATE 2025.
-
PromptDistill: Query-based Selective Token Retention in Intermediate Layers for Efficient Large Language Model Inference. Weisheng Jin, Maojia Song, Tej Deep Pala, Yew Ken Chia, Amir Zadeh, Chuan Li, Soujanya Poria. Arxiv 2025.
-
SQuat: Subspace-orthogonal KV Cache Quantization. Hao Wang, Ligong Han, Kai Xu, Akash Srivastava. Arxiv 2025.
-
Rethinking Key-Value Cache Compression Techniques for Large Language Model Serving. Wei Gao, Xinyu Zhou, Peng Sun, Tianwei Zhang, Yonggang Wen. MLSys 2025.
-
SentenceKV: Efficient LLM Inference via Sentence-Level Semantic KV Caching. Yuxuan Zhu, Ali Falahati, David H. Yang, Mohammad Mohammadi Amiri. Arxiv 2025.
-
LagKV: Lag-Relative Information of the KV Cache Tells Which Tokens Are Important. Manlai Liang, JiaMing Zhang, Xiong Li, Jinlong Li. Arxiv 2025.
-
FlowKV: A Disaggregated Inference Framework with Low-Latency KV Cache Transfer and Load-Aware Scheduling. Weiqing Li, Guochao Jiang, Xiangyong Ding, Zhangcheng Tao, Chuzhan Hao, Chenfeng Xu, Yuewei Zhang, Hao Wang. Arxiv 2025.
-
Apt-Serve: Adaptive Request Scheduling on Hybrid Cache for Scalable LLM Inference Serving. Shihong Gao, Xin Zhang, Yanyan Shen, Lei Chen. Arxiv 2025.
-
KeepKV: Eliminating Output Perturbation in KV Cache Compression for Efficient LLMs Inference. Yuxuan Tian, Zihan Wang, Yebo Peng, Aomufei Yuan, Zhiming Wang, Bairen Yi, Xin Liu, Yong Cui, Tong Yang. Arxiv 2025.
-
MOM: Memory-Efficient Offloaded Mini-Sequence Inference for Long Context Language Models. Junyang Zhang, Tianyi Zhu, Cheng Luo, Anima Anandkumar. Arxiv 2025.
-
CAOTE: KV Caching through Attention Output Error based Token Eviction. Raghavv Goel, Junyoung Park, Mukul Gagrani, Dalton Jones, Matthew Morse, Harper Langston, Mingu Lee, Chris Lott. Arxiv 2025.
-
SlimPipe: Memory-Thrifty and Efficient Pipeline Parallelism for Long-Context LLM Training. Zhouyang Li, Yuliang Liu, Wei Zhang, Tailing Yuan, Bin Chen, Chengru Song, Di Zhang. Arxiv 2025.
-
FreqKV: Frequency Domain Key-Value Compression for Efficient Context Window Extension. Jushi Kai, Boyi Zeng, Yixuan Wang, Haoli Bai, Bo Jiang, Zhouhan Lin. Arxiv 2025.
-
dKV-Cache: The Cache for Diffusion Language Models. Xinyin Ma, Runpeng Yu, Gongfan Fang, Xinchao Wang. Arxiv 2025.
-
PM-KVQ: Progressive Mixed-precision KV Cache Quantization for Long-CoT LLMs. Tengxuan Liu, Shiyao Li, Jiayi Yang, Tianchen Zhao, Feng Zhou, Xiaohui Song, Guohao Dai, Shengen Yan, Huazhong Yang, Yu Wang. Arxiv 2025.
-
TailorKV: A Hybrid Framework for Long-Context Inference via Tailored KV Cache Optimization. Dingyu Yao, Bowen Shen, Zheng Lin, Wei Liu, Jian Luan, Bin Wang, Weiping Wang. Arxiv 2025.
-
R-KV: Redundancy-aware KV Cache Compression for Training-Free Reasoning Models Acceleration. Zefan Cai, Wen Xiao, Hanshi Sun, Cheng Luo, Yikai Zhang, Ke Wan, Yucheng Li, Yeyang Zhou, Li-Wen Chang, Jiuxiang Gu, Zhen Dong, Anima Anandkumar, Abedelkadir Asi, Junjie Hu. Arxiv 2025.
-
ReCalKV: Low-Rank KV Cache Compression via Head Reordering and Offline Calibration. Xianglong Yan, Zhiteng Li, Tianao Zhang, Linghe Kong, Yulun Zhang, Xiaokang Yang. Arxiv 2025.
-
VScan: Rethinking Visual Token Reduction for Efficient Large Vision-Language Models. Ce Zhang, Kaixin Ma, Tianqing Fang, Wenhao Yu, Hongming Zhang, Zhisong Zhang, Yaqi Xie, Katia Sycara, Haitao Mi, Dong Yu. Arxiv 2025.
-
KVzip: Query-Agnostic KV Cache Compression with Context Reconstruction. Jang-Hyun Kim, Jinuk Kim, Sangwoo Kwon, Jae W. Lee, Sangdoo Yun, Hyun Oh Song. Arxiv 2025.
-
Mustafar: Promoting Unstructured Sparsity for KV Cache Pruning in LLM Inference. Donghyeon Joo, Helya Hosseini, Ramyad Hadidi, Bahar Asgari. Arxiv 2025.
-
Lookahead Q-Cache: Achieving More Consistent KV Cache Eviction via Pseudo Query. Yixuan Wang, Shiyu Ji, Yijun Liu, Yuzhuang Xu, Yang Xu, Qingfu Zhu, Wanxiang Che. Arxiv 2025.
-
Hardware-Efficient Attention for Fast Decoding. Ted Zadouri, Hubert Strauss, Tri Dao. Arxiv 2025.
-
Accelerating Diffusion Language Model Inference via Efficient KV Caching and Guided Diffusion. Zhanqiu Hu, Jian Meng, Yash Akhauri, Mohamed S. Abdelfattah, Jae-sun Seo, Zhiru Zhang, Udit Gupta. Arxiv 2025.
-
AhaKV: Adaptive Holistic Attention-Driven KV Cache Eviction for Efficient Inference of Large Language Models. Yifeng Gu, Zicong Jiang, Jianxiu Jin, Kailing Guo, Ziyang Zhang, Xiangmin Xu. Arxiv 2025.
-
Inference-Time Hyper-Scaling with KV Cache Compression. Adrian Łańcucki, Konrad Staniszewski, Piotr Nawrot, Edoardo M. Ponti. Arxiv 2025.
-
TaDA: Training-free recipe for Decoding with Adaptive KV Cache Compression and Mean-centering. Vinay Joshi, Pratik Prabhanjan Brahma, Zicheng Liu, Emad Barsoum. Arxiv 2025.
-
Homogeneous Keys, Heterogeneous Values: Exploiting Local KV Cache Asymmetry for Long-Context LLMs. Wanyun Cui, Mingwei Xu. Arxiv 2025.
-
Paged Attention Meets FlexAttention: Unlocking Long-Context Efficiency in Deployed Inference. Thomas Joshi, Herman Saini, Neil Dhillon, Antoni Viros i Martin, Kaoutar El Maghraoui. Arxiv 2025.
-
KVmix: Gradient-Based Layer Importance-Aware Mixed-Precision Quantization for KV Cache. Fei Li, Song Liu, Weiguo Wu, Shiqiang Nie, Jinyu Wang. Arxiv 2025.
-
Efficient Long-Context LLM Inference via KV Cache Clustering. Jie Hu, Shengnan Wang, Yutong He, Ping Gong, Jiawei Yi, Juncheng Zhang, Youhui Bai, Renhai Chen, Gong Zhang, Cheng Li, Kun Yuan. Arxiv 2025.
-
Beyond Homogeneous Attention: Memory-Efficient LLMs via Fourier-Approximated KV Cache. Xiaoran Liu, Siyang He, Qiqi Wang, Ruixiao Li, Yuerong Song, Zhigeng Liu, Linlin Li, Qun Liu, Zengfeng Huang, Qipeng Guo, Ziwei He, Xipeng Qiu. Arxiv 2025.
-
Latent Multi-Head Attention for Small Language Models. Sushant Mehta, Raj Dandekar, Rajat Dandekar, Sreedath Panat. Arxiv 2025.
-
Multipole Attention for Efficient Long Context Reasoning. Coleman Hooper, Sebastian Zhao, Luca Manolache, Sehoon Kim, Michael W. Mahoney, Yakun Sophia Shao, Kurt Keutzer, Amir Gholami. Arxiv 2025.
-
Mixture of Weight-shared Heterogeneous Group Attention Experts for Dynamic Token-wise KV Optimization. Guanghui Song, Dongping Liao, Yiren Zhao, Kejiang Ye, Cheng-zhong Xu, Xitong Gao. Arxiv 2025.
-
Cache Me If You Can: How Many KVs Do You Need for Effective Long-Context LMs?. Adithya Bhaskar, Alexander Wettig, Tianyu Gao, Yihe Dong, Danqi Chen. Arxiv 2025.
-
LazyEviction: Lagged KV Eviction with Attention Pattern Observation for Efficient Long Reasoning. Haoyue Zhang, Hualei Zhang, Xiaosong Ma, Jie Zhang, Song Guo. Arxiv 2025.
-
CommVQ: Commutative Vector Quantization for KV Cache Compression. Junyan Li, Yang Zhang, Muhammad Yusuf Hassan, Talha Chafekar, Tianle Cai, Zhile Ren, Pengsheng Guo, Foroozan Karimzadeh, Colorado Reed, Chong Wang, Chuang Gan. Arxiv 2025.
-
X-EcoMLA: Upcycling Pre-Trained Attention into MLA for Efficient and Extreme KV Compression. Guihong Li, Mehdi Rezagholizadeh, Mingyu Yang, Vikram Appia, Emad Barsoum. Arxiv 2025.
-
OmniKV: Dynamic Context Selection for Efficient Long-Context LLMs Jitai Hao, Yuke Zhu, Tian Wang, Jun Yu, Xin Xin, Bo Zheng, Zhaochun Ren, Sheng Guo. ICLR 2025.
-
XAttention: Block Sparse Attention with Antidiagonal Scoring. Ruyi Xu, Guangxuan Xiao, Haofeng Huang, Junxian Guo, Song Han. Arxiv 2025.
-
The Sparse Frontier: Sparse Attention Trade-offs in Transformer LLMs. Piotr Nawrot, Robert Li, Renjie Huang, Sebastian Ruder, Kelly Marchisio, Edoardo M. Ponti. Arxiv 2025.
-
Mixture of Sparse Attention: Content-Based Learnable Sparse Attention via Expert-Choice Routing. Piotr Piękos, Róbert Csordás, Jürgen Schmidhuber. Arxiv 2025.
-
Hierarchical Context Merging: Better Long Context Understanding for Pre-trained LLMs. Woomin Song, Seunghyuk Oh, Sangwoo Mo, Jaehyung Kim, Sukmin Yun, Jung-Woo Ha, Jinwoo Shin. ICLR 2024.
-
Sparsified State-Space Models are Efficient Highway Networks. Woomin Song, Jihoon Tack, Sangwoo Mo, Seunghyuk Oh, Jinwoo Shin. TMLR 2025.
-
Compress, Gather, and Recompute: REFORMing Long-Context Processing in Transformers. Woomin Song, Sai Muralidhar Jayanthi, Srikanth Ronanki, Kanthashree Mysore Sathyendra, Jinwoo Shin, Aram Galstyan, Shubham Katiyar, Sravan Babu Bodapati. Arxiv 2025.
-
Multi-head Temporal Latent Attention. Keqi Deng, Philip C. Woodland. Arxiv 2025.
-
Scale-invariant Attention. Ben Anson, Xi Wang, Laurence Aitchison. Arxiv 2025.
-
SageAttention2++: A More Efficient Implementation of SageAttention2. Jintao Zhang, Xiaoming Xu, Jia Wei, Haofeng Huang, Pengle Zhang, Chendong Xiang, Jun Zhu, Jianfei Chen. Arxiv 2025.
-
HATA: Trainable and Hardware-Efficient Hash-Aware Top-k Attention for Scalable Large Model Inference. Ping Gong, Jiawei Yi, Shengnan Wang, Juncheng Zhang, Zewen Jin, Ouxiang Zhou, Ruibo Liu, Guanbin Xu, Youhui Bai, Bowen Ye, Kun Yuan, Tong Yang, Gong Zhang, Renhai Chen, Feng Wu, Cheng Li. Arxiv 2025.
-
Rectified Sparse Attention. Yutao Sun, Tianzhu Ye, Li Dong, Yuqing Xia, Jian Chen, Yizhao Gao, Shijie Cao, Jianyong Wang, Furu Wei. Arxiv 2025.
-
SeerAttention-R: Sparse Attention Adaptation for Long Reasoning. Yizhao Gao, Shuming Guo, Shijie Cao, Yuqing Xia, Yu Cheng, Lei Wang, Lingxiao Ma, Yutao Sun, Tianzhu Ye, Li Dong, Hayden Kwok-Hay So, Yu Hua, Ting Cao, Fan Yang, Mao Yang. Arxiv 2025.
-
Lag-Relative Sparse Attention In Long Context Training. Manlai Liang, Wanyi Huang, Mandi Liu, Huaijun Li, Jinlong Li. Arxiv 2025.
-
DAM: Dynamic Attention Mask for Long-Context Large Language Model Inference Acceleration. Hanzhi Zhang, Heng Fan, Kewei Sha, Yan Huang, Yunhe Feng. Arxiv 2025.
-
GTA: Grouped-head latenT Attention. Luoyang Sun, Jiwen Jiang, Cheng Deng, Xinjian Wu, Haifeng Zhang, Lei Chen, Lionel Ni, Jun Wang. Arxiv 2025.
-
Fast and Simplex: 2-Simplicial Attention in Triton. Aurko Roy, Timothy Chou, Sai Surya Duvvuri, Sijia Chen, Jiecao Yu, Xiaodong Wang, Manzil Zaheer, Rohan Anil. Arxiv 2025.
-
Mitigating Posterior Salience Attenuation in Long-Context LLMs with Positional Contrastive Decoding. Zikai Xiao, Ziyang Wang, Wen Ma, Yan Zhang, Wei Shen, Yan Wang, Luqi Gong, Zuozhu Liu. Arxiv 2025.
-
Long-Short Alignment for Effective Long-Context Modeling in LLMs. Tianqi Du, Haotian Huang, Yifei Wang, Yisen Wang. Arxiv 2025.
-
Arctic Long Sequence Training: Scalable And Efficient Training For Multi-Million Token Sequences. Stas Bekman, Samyam Rajbhandari, Michael Wyatt, Jeff Rasley, Tunji Ruwase, Zhewei Yao, Aurick Qiao, Yuxiong He. Arxiv 2025.
-
Long-Context Generalization with Sparse Attention. Pavlo Vasylenko, Marcos Treviso, André F. T. Martins. Arxiv 2025.
-
Elastic Attention: Test-time Adaptive Sparsity Ratios for Efficient Transformers. Zecheng Tang, Quantong Qiu, Yi Yang, Zhiyi Hong, Haiya Xiang, Kebin Liu, Qingqing Dang, Juntao Li, Min Zhang. Arxiv 2025.
-
TimeViper: A Hybrid Mamba-Transformer Vision-Language Model for Efficient Long Video Understanding. Boshen Xu, Zihan Xiao, Jiaze Li, Jianzhong Ju, Zhenbo Luo, Jian Luan, Qin Jin. Arxiv 2025.
-
Speed Always Wins: A Survey on Efficient Architectures for Large Language Models Weigao Sun, Jiaxi Hu, Yucheng Zhou, Jusen Du, Disen Lan, Kexin Wang, Tong Zhu, Xiaoye Qu, Yu Zhang, Xiaoyu Mo, Daizong Liu, Yuxuan Liang, Wenliang Chen, Guoqi Li, Yu Cheng. Arxiv 2025.
-
Speed Always Wins: A Survey on Efficient Architectures for Large Language Models Xinda Jia, Jinpeng Li, Zezhong Wang, Jingjing Li, Xingshan Zeng, Yasheng Wang, Weinan Zhang, Yong Yu, Weiwen Liu. Arxiv 2025.
-
Trainable Dynamic Mask Sparse Attention Jingze Shi, Yifan Wu, Bingheng Wu, Yiran Peng, Liangdong Wang, Guang Liu, Yuyu Luo. Arxiv 2025.
-
Less Is More: Training-Free Sparse Attention with Global Locality for Efficient Reasoning Lijie Yang, Zhihao Zhang, Arti Jain, Shijie Cao, Baihong Yuan, Yiwei Chen, Zhihao Jia, Ravi Netravali. Arxiv 2025.
-
Every Attention Matters: An Efficient Hybrid Architecture for Long-Context Reasoning Ling Team, Bin Han, Caizhi Tang, Chen Liang, Donghao Zhang, Fan Yuan, Feng Zhu, Jie Gao, Jingyu Hu, Longfei Li, Meng Li, Mingyang Zhang, Peijie Jiang, Peng Jiao, Qian Zhao, Qingyuan Yang, Wenbo Shen, Xinxing Yang, Yalin Zhang, Yankun Ren, Yao Zhao, Yibo Cao, Yixuan Sun, Yue Zhang, Yuchen Fang, Zibin Lin, Zixuan Cheng, Jun Zhou. Arxiv 2025.
-
Alleviating Forgetfulness of Linear Attention by Hybrid Sparse Attention and Contextualized Learnable Token Eviction Mutian He, Philip N. Garner. Arxiv 2025.
-
Retrospective Sparse Attention for Efficient Long-Context Generation Seonghwan Choi, Beomseok Kang, Dongwon Jo, Jae-Joon Kim. Arxiv 2025.
-
ProxyAttn: Guided Sparse Attention via Representative Heads Yixuan Wang, Huang He, Siqi Bao, Hua Wu, Haifeng Wang, Qingfu Zhu, Wanxiang Che. Arxiv 2025.
-
Frequency-Aware Token Reduction for Efficient Vision Transformer Dong-Jae Lee, Jiwan Hur, Jaehyun Choi, Jaemyung Yu, Junmo Kim. Arxiv 2025.
-
Gated Associative Memory: A Parallel O(N) Architecture for Efficient Sequence Modeling Rishiraj Acharya. Arxiv 2025.
-
Mamba Modulation: On the Length Generalization of Mamba Peng Lu, Jerry Huang, Qiuhao Zeng, Xinyu Wang, Boxing Wang, Philippe Langlais, Yufei Cui. Arxiv 2025.
-
Causal Attention with Lookahead Keys Zhuoqing Song, Peng Sun, Huizhuo Yuan, Quanquan Gu. Arxiv 2025.
-
DTRNet: Dynamic Token Routing Network to Reduce Quadratic Costs in Transformers Aman Sharma, Saeed Najafi, Parsa Farinneya, Benyamin Jamialahmadi, Marzieh S. Tahaei, Yuhe Fan, Mehdi Rezagholizadeh, Boxing Chen, Aref Jafari. Arxiv 2025.
-
HiPrune: Training-Free Visual Token Pruning via Hierarchical Attention in Vision-Language Models Jizhihui Liu, Feiyi Du, Guangdao Zhu, Niu Lian, Jun Li, Bin Chen. Arxiv 2025.
-
VideoNSA: Native Sparse Attention Scales Video Understanding Enxin Song, Wenhao Chai, Shusheng Yang, Ethan Armand, Xiaojun Shan, Haiyang Xu, Jianwen Xie, Zhuowen Tu. Arxiv 2025.
-
SparseVILA: Decoupling Visual Sparsity for Efficient VLM Inference Samir Khaki, Junxian Guo, Jiaming Tang, Shang Yang, Yukang Chen, Konstantinos N. Plataniotis, Yao Lu, Song Han, Zhijian Liu. Arxiv 2025.
-
Accelerating Vision Transformers with Adaptive Patch Sizes Rohan Choudhury, JungEun Kim, Jinhyung Park, Eunho Yang, László A. Jeni, Kris M. Kitani. Arxiv 2025.
-
NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model NVIDIA: Aarti Basant, Abhijit Khairnar, Abhijit Paithankar, Abhinav Khattar, Adi Renduchintala, Adithya Renduchintala, Aditya Malte, Akhiad Bercovich, Akshay Hazare, Alejandra Rico, Aleksander Ficek, Alex Kondratenko, Alex Shaposhnikov, Ali Taghibakhshi, Amelia Barton, Ameya Sunil Mahabaleshwarkar, Amy Shen, Andrew Tao, Ann Guan, Anna Shors, Anubhav Mandarwal, Arham Mehta, Arun Venkatesan, Ashton Sharabiani, Ashwath Aithal, Ashwin Poojary, Ayush Dattagupta, Balaram Buddharaju, Banghua Zhu, Barnaby Simkin, Bilal Kartal, Bita Darvish Rouhani, Bobby Chen, Boris Ginsburg, Brandon Norick, Brian Yu, Bryan Catanzaro, Charles Wang, Charlie Truong, Chetan Mungekar, Chintan Patel, Chris Alexiuk, Christian Munley, Christopher Parisien, Dan Su, Daniel Afrimi, Daniel Korzekwa, Daniel Rohrer, Daria Gitman, David Mosallanezhad, Deepak Narayanan, Dima Rekesh, Dina Yared, Dmytro Pykhtar, Dong Ahn, Duncan Riach, Eileen Long, Elliott Ning, Eric Chung, Erick Galinkin, Evelina Bakhturina, Gargi Prasad, Gerald Shen, Haim Elisha, Harsh Sharma, Hayley Ross, Helen Ngo, Herman Sahota, Hexin Wang, Hoo Chang Shin, Hua Huang, Iain Cunningham, Igor Gitman, Ivan Moshkov, Jaehun Jung, Jan Kautz, Jane Polak Scowcroft, Jared Casper, Jimmy Zhang, Jinze Xue, Jocelyn Huang, Joey Conway, John Kamalu, Jonathan Cohen, Joseph Jennings, Julien Veron Vialard, Junkeun Yi, Jupinder Parmar, Kari Briski, Katherine Cheung, Katherine Luna, Keith Wyss, Keshav Santhanam, Kezhi Kong, Krzysztof Pawelec, Kumar Anik, Kunlun Li, Kushan Ahmadian, Lawrence McAfee et al. Arxiv 2025.
-
HISA: Efficient Hierarchical Indexing for Fine-Grained Sparse Attention. Yufei Xu, Fanxu Meng, Fan Jiang, Yuxuan Wang, Ruijie Zhou, Jiexi Wu, Zhixin Pan, Zhaohui Wang, Xiaojuan Tang, Wenjie Pei, Tongxuan Liu, Di yin, Xing Sun, Muhan Zhang. Arxiv 2026.
-
Why Attend to Everything? Focus is the Key. Hengshuai Yao, Xing Chen, Ahmed Murtadha, Jin Li, Shuai Shao, Yasin Abbasi Yadkori, Guan Wang, Mingli Yuan, William Chen, Sen Song. Arxiv 2026.
-
MHLA: Restoring Expressivity of Linear Attention via Token-Level Multi-Head. Kewei Zhang, Ye Huang, Yufan Deng, Jincheng Yu, Junsong Chen, Huan Ling, Enze Xie, Daquan Zhou. Arxiv 2026.
-
Olmo 3. Team Olmo, Allyson Ettinger, Amanda Bertsch, Bailey Kuehl, David Graham, David Heineman, Dirk Groeneveld, Faeze Brahman, Finbarr Timbers, Hamish Ivison, Jacob Morrison, Jake Poznanski, Kyle Lo, Luca Soldaini, Matt Jordan, Mayee Chen, Michael Noukhovitch, Nathan Lambert, Pete Walsh, Pradeep Dasigi, Robert Berry, Saumya Malik, Saurabh Shah, Scott Geng, Shane Arora, Shashank Gupta, Taira Anderson, Teng Xiao, Tyler Murray, Tyler Romero, Victoria Graf, Akari Asai, Akshita Bhagia, Alexander Wettig, Alisa Liu, Aman Rangapur, Chloe Anastasiades, Costa Huang, Dustin Schwenk, Harsh Trivedi, Ian Magnusson, Jaron Lochner, Jiacheng Liu, Lester James V. Miranda, Maarten Sap, Malia Morgan, Michael Schmitz, Michal Guerquin, Michael Wilson, Regan Huff, Ronan Le Bras, Rui Xin, Rulin Shao, Sam Skjonsberg, Shannon Zejiang Shen, Shuyue Stella Li, Tucker Wilde, Valentina Pyatkin, Will Merrill, Yapei Chang, Yuling Gu, Zhiyuan Zeng, Ashish Sabharwal, Luke Zettlemoyer, Pang Wei Koh, Ali Farhadi, Noah A. Smith, Hannaneh Hajishirzi. Arxiv 2025.
-
UNIQUE: Universal Top-k Sparse Attention for Training-free Inference and Sparsity-aware Training. Keqi Deng, Shaoshi Ling, Ruchao Fan, Jinyu Li. Arxiv 2026.
-
Tensor Memory: Fixed-Size Recurrent State for Long-Horizon Transformers. Kabir Swain, Sijie Han, Daniel Karl I. Weidele, Mauro Martino, Antonio Torralba. Arxiv 2026.
-
Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention. Ali Hatamizadeh, Yejin Choi, Jan Kautz. Arxiv 2026.
-
LongCat Sparse Attention: Taming the Lightning via Streaming-aware Hierarchical Cross-Layer Indexing. Wen Zan, Jiaqi Zhang, Jianchao Tan, Hong Liu, Cunguang Wang, Xiang Li, Duyue Ma, Guanyu Wu, Yifan Lu, Fengcun Li, Yerui Sun, Peng Pei, Yuchen Xie, Xunliang Cai. Arxiv 2026.
-
HiSparse: Scaling Sparse-Attention Decoding with Hierarchical KV Cache Management. Zhiqiang Xie, Zhangheng Huang, Tingwei Huang, Ziyi Xu, Ruiyang Ma, Christos Kozyrakis. Arxiv 2026.
-
Autonomy-of-Heads: Data-Free Sparse Attention from Frozen Query-Key Geometry. Yehan Yang, Junyuan Shang, Yang Li, Guanqun Zhao, Shuohuan Wang, Dianhai Yu. Arxiv 2026.
-
CoSA: Accelerating Long-Context Inference via Proxy-Kernel Co-Designed Sparse Attention. Yufei Xue, Lin Niu, Hong Liu, Siran Liu, Hanyong Shao, Wei Liu, Guanghua Yu, Jianchen Zhu, Jun Zhang. Arxiv 2026.
-
PIVOT: Efficient Query-Group Indexing for Token-Level Sparse Attention. Hong Liu, Yuan Cheng, Lin Niu, Yi Su, Yufei Xue, Anmin Liu, Guanghua Yu, Jianchen Zhu. Arxiv 2026.
-
LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration. Enhuai Liu, Yunke Wang, Yutong Wang, Changming Sun, Chang Xu. Arxiv 2026.
-
SPADE: An Input-Adaptive Sparse Attention Engine for Fast Video Diffusion Models Inference. Shanghao Liu, Renze Chen, Size Zheng, Yuanqiang Liu, Yun Liang, Hailong Yang. Arxiv 2026.
-
ATFlash: Per-RoPE-Wavelength Attention Windows for Compute/Memory-Efficient LLM Inference. Shun-ichiro Hayashi, Daichi Mukunoki, Tetsuya Hoshino, Takahiro Katagiri. Arxiv 2026.
-
Understanding Sparse Attention Selectivity in Long-Context Foundation Models via Counterfactual Evaluation. Xingyu Ren, Youran Sun, Chugang Yi, Haizhao Yang. Arxiv 2026.
-
Recall Before You Rank: Similarity-Guided Top-$K$ Reuse for Efficient Long-Context Attention. Wenshuai Yao, Wenyong Zhou, Hanyong Shao, Yizhe Chen, Zhiyuan Ning, Yuannuo Feng, Ru Huang, Kechao Tang. Arxiv 2026.
-
The Query Knows What to Forget: A Second Erase Direction for Linear Attention. Dhruman Gupta, Aritra Das, Debayan Gupta. Arxiv 2026.
-
MixFormer: Linear Transformer with Mixture of Memory Experts. Yu Guo, Lei Duan. Arxiv 2026.
-
Hybrid Gated Attention. Zekun Zhou, Ruobing Xie, Lanrui Wang, Weixuan Sun. Arxiv 2026.
-
SpotAttention: Plug-In Block-Sparse Routing for Pretrained Long-Context Transformers. Huzama Ahmad, Se-Young Yun. Arxiv 2026.
-
MATCH: Modulating Attention via In-Context Retrieval for Long-Context Transformers. Linrui Ma, Chun Hei Lo, Xinyu Wang, Peng Lu, Xihao Yuan, Hanting Chen, Kai Han, Xinghao Chen, Chengjun Zhan, Hanlin Xu, Yichun Yin, Lifeng Shang, Feng Wen, Boxing Chen, Yufei Cui. ACL 2026.
-
ConSA: Controllable Sparsity in Hybrid Attention via Learnable Allocation. Yao Chen, Yinqi Yang, Junyuan Shang, Xiangzhao Hao, Simeng Zhang, Yilong Chen, Tingwen Liu, Shuohuan Wang, Dianhai Yu. Arxiv 2026.
-
Training-free sparse attention based on cumulative energy filtering. Chunlu Li, Yixuan Pan, Bai Du, Zhenyuan Chen, Yanzhao Li, Hui Dong, Hui Wang, Zhiqiang Zou. Arxiv 2026.
-
SCOPE: Subspace Clustering with Online Per-Head Top-K Estimation for Sparse Video Attention. Qi Zhao, Qirui Li, Hanlin Tang, Yiduo Li, Zhen Guo, Cuifeng Shen, Chao Xu, Zhaosheng Chi, Xiaojin Lu, Kan Liu, Tao Lan, Lin Qu, Xi Li. Arxiv 2026.
-
SparSTAR: Sparse Attention for SpaceTime AutoRegressive Video Synthesis. Jongbeom Lee, Hyunwoo Yu, Jincheol Yang, Jaemin Choi, Suk-Ju Kang. Arxiv 2026.
-
Sol-Attn: Accelerating Video Generation Inference via On-the-Fly Attention Sparsification. Haopeng Li, Yitong Li, Junsong Chen, Tian Ye, Haozhe Liu, Jincheng Yu, Duomin Wang, Ruihua Zhang, Zeke Xie, Enze Xie, Song Han. Arxiv 2026.
Hybrid Architecture
-
C4AI Command R7B: A 7 Billion Parameter Multilingual Model. Cohere, Cohere For AI. Arxiv 2024
-
Jamba: A hybrid transformer-mamba language model. Opher Lieber and Barak Lenz and Hofit Bata and Gal Cohen and Jhonathan Osin and Itay Dalmedigos and Erez Safahi and Shaked Meirom and Yonatan Belinkov and Shai Shalev-Shwartz and Omri Abend and Raz Alon and Tomer Asida and Amir Bergman and Roman Glozman and Michael Gokhman and Avashalom Manevich and Nir Ratner and Noam Rozen and Erez Shwartz and Mor Zusman and Yoav Shoham. Arxiv 2024
-
Hymba: A hybrid-head architecture for small language models. Xin Dong and Yonggan Fu and Shizhe Diao and Wonmin Byeon and Zijia Chen and Ameya Sunil Mahabaleshwarkar and Shih-Yang Liu and Matthijs Van Keirsbilck and Min-Hung Chen and Yoshi Suhara and Yingyan Lin and Jan Kautz and Pavlo Molchanov. Arxiv 2024
-
Zamba: A compact 7b ssm hybrid model. Paolo Glorioso and Quentin Anthony and Yury Tokpanov and James Whittington and Jonathan Pilault and Adam Ibrahim and Beren Millidge. Arxiv 2024
-
Goldfinch: High performance rwkv/transformer hybrid with linear pre-fill and extreme kv-cache compression. Daniel Goldstein and Fares Obeid and Eric Alcaide and Guangyu Song and Eugene Cheah. Arxiv 2024
-
Gemma 2: Improving open language models at a practical size. Gemma Team and Morgane Riviere and Shreya Pathak and Pier Giuseppe Sessa and Cassidy Hardin and Surya Bhupatiraju and Léonard Hussenot and Thomas Mesnard and Bobak Shahriari and Alexandre Ramé and Johan Ferret and Peter Liu and Pouya Tafti and Abe Friesen and Michelle Casbon and Sabela Ramos and Ravin Kumar and Charline Le Lan and Sammy Jerome and Anton Tsitsulin and Nino Vieillard and Piotr Stanczyk and Sertan Girgin and Nikola Momchev and Matt Hoffman and Shantanu Thakoor and Jean-Bastien Grill and Behnam Neyshabur and Olivier Bachem and Alanna Walton and Aliaksei Severyn and Alicia Parrish and Aliya Ahmad and Allen Hutchison and Alvin Abdagic and Amanda Carl and Amy Shen and Andy Brock and Andy Coenen and Anthony Laforge and Antonia Paterson and Ben Bastian and Bilal Piot and Bo Wu and Brandon Royal and Charlie Chen and Chintu Kumar and Chris Perry and Chris Welty and Christopher A. Choquette-Choo and Danila Sinopalnikov and David Weinberger and Dimple Vijaykumar and Dominika Rogozińska and Dustin Herbison and Elisa Bandy and Emma Wang and Eric Noland and Erica Moreira and Evan Senter and Evgenii Eltyshev and Francesco Visin and Gabriel Rasskin and Gary Wei and Glenn Cameron and Gus Martins and Hadi Hashemi and Hanna Klimczak-Plucińska and Harleen Batra and Harsh Dhand and Ivan Nardini and Jacinda Mein and Jack Zhou and James Svensson and Jeff Stanway and Jetha Chan and Jin Peng Zhou and Joana Carrasqueira and Joana Iljazi and Jocelyn Becker and Joe Fernandez and Joost van Amersfoort and Josh Gordon and Josh Lipschultz and Josh Newlan and Ju-yeong Ji and Kareem Mohamed and Kartikeya Badola and Kat Black and Katie Millican and Keelin McDonell and Kelvin Nguyen and Kiranbir Sodhia and Kish Greene and Lars Lowe Sjoesund and Lauren Usui and Laurent Sifre and Lena Heuermann and Leticia Lago and Lilly McNealus and Livio Baldini Soares and Logan Kilpatrick and Lucas Dixon and Luciano Martins and Machel Reid and Manvinder Singh and Mark Iverson and Martin Görner and Mat Velloso and Mateo Wirth and Matt Davidow and Matt Miller and Matthew Rahtz and Matthew Watson and Meg Risdal and Mehran Kazemi and Michael Moynihan and Ming Zhang and Minsuk Kahng and Minwoo Park and Mofi Rahman and Mohit Khatwani and Natalie Dao and Nenshad Bardoliwalla and Nesh Devanathan and Neta Dumai and Nilay Chauhan and Oscar Wahltinez and Pankil Botarda and Parker Barnes and Paul Barham and Paul Michel and Pengchong Jin and Petko Georgiev and Phil Culliton and Pradeep Kuppala and Ramona Comanescu and Ramona Merhej and Reena Jana and Reza Ardeshir Rokni and Rishabh Agarwal and Ryan Mullins and Samaneh Saadat and Sara Mc Carthy and Sarah Cogan and Sarah Perrin and Sébastien M. R. Arnold and Sebastian Krause and Shengyang Dai and Shruti Garg and Shruti Sheth and Sue Ronstrom and Susan Chan and Timothy Jordan and Ting Yu and Tom Eccles and Tom Hennigan and Tomas Kocisky and Tulsee Doshi and Vihan Jain and Vikas Yadav and Vilobh Meshram and Vishal Dharmadhikari and Warren Barkley and Wei Wei and Wenming Ye and Woohyun Han and Woosuk Kwon and Xiang Xu and Zhe Shen and Zhitao Gong and Zichuan Wei and Victor Cotruta and Phoebe Kirk and Anand Rao and Minh Giang and Ludovic Peran and Tris Warkentin and Eli Collins and Joelle Barral and Zoubin Ghahramani and Raia Hadsell and D. Sculley and Jeanine Banks and Anca Dragan and Slav Petrov and Oriol Vinyals and Jeff Dean and Demis Hassabis and Koray Kavukcuoglu and Clement Farabet and Elena Buchatskaya and Sebastian Borgeaud and Noah Fiedel and Armand Joulin and Kathleen Kenealy and Robert Dadashi and Alek Andreev. Arxiv 2024
-
Jamba-1.5: Hybrid transformer-mamba models at scale. Jamba Team and Barak Lenz and Alan Arazi and Amir Bergman and Avshalom Manevich and Barak Peleg and Ben Aviram and Chen Almagor and Clara Fridman and Dan Padnos and Daniel Gissin and Daniel Jannai and Dor Muhlgay and Dor Zimberg and Edden M Gerber and Elad Dolev and Eran Krakovsky and Erez Safahi and Erez Schwartz and Gal Cohen and Gal Shachaf and Haim Rozenblum and Hofit Bata and Ido Blass and Inbal Magar and Itay Dalmedigos and Jhonathan Osin and Julie Fadlon and Maria Rozman and Matan Danos and Michael Gokhman and Mor Zusman and Naama Gidron and Nir Ratner and Noam Gat and Noam Rozen and Oded Fried and Ohad Leshno and Omer Antverg and Omri Abend and Opher Lieber and Or Dagan and Orit Cohavi and Raz Alon and Ro'i Belson and Roi Cohen and Rom Gilad and Roman Glozman and Shahar Lev and Shaked Meirom and Tal Delbari and Tal Ness and Tomer Asida and Tom Ben Gal and Tom Braude and Uriya Pumerantz and Yehoshua Cohen and Yonatan Belinkov and Yuval Globerson and Yuval Peleg Levy and Yoav Shoham. Arxiv 2024
-
RecurrentGemma: Moving Past Transformers for Efficient Open Language Models. Aleksandar Botev and Soham De and Samuel L Smith and Anushan Fernando and George-Cristian Muraru and Ruba Haroun and Leonard Berrada and Razvan Pascanu and Pier Giuseppe Sessa and Robert Dadashi and Léonard Hussenot and Johan Ferret and Sertan Girgin and Olivier Bachem and Alek Andreev and Kathleen Kenealy and Thomas Mesnard and Cassidy Hardin and Surya Bhupatiraju and Shreya Pathak and Laurent Sifre and Morgane Rivière and Mihir Sanjay Kale and Juliette Love and Pouya Tafti and Armand Joulin and Noah Fiedel and Evan Senter and Yutian Chen and Srivatsan Srinivasan and Guillaume Desjardins and David Budden and Arnaud Doucet and Sharad Vikram and Adam Paszke and Trevor Gale and Sebastian Borgeaud and Charlie Chen and Andy Brock and Antonia Paterson and Jenny Brennan and Meg Risdal and Raj Gundluru and Nesh Devanathan and Paul Mooney and Nilay Chauhan and Phil Culliton and Luiz Gustavo Martins and Elisa Bandy and David Huntsperger and Glenn Cameron and Arthur Zucker and Tris Warkentin and Ludovic Peran and Minh Giang and Zoubin Ghahramani and Clément Farabet and Koray Kavukcuoglu and Demis Hassabis and Raia Hadsell and Yee Whye Teh and Nando de Frietas. Arxiv 2024
-
The Zamba2 Suite: Technical Report. Paolo Glorioso and Quentin Anthony and Yury Tokpanov and Anna Golubeva and Vasudev Shyam and James Whittington and Jonathan Pilault and Beren Millidge. Arxiv 2024
-
You only cache once: Decoder-decoder architectures for language models. Yutao Sun and Li Dong and Yi Zhu and Shaohan Huang and Wenhui Wang and Shuming Ma and Quanlu Zhang and Jianyong Wang and Furu Wei. Arxiv 2024
-
Artificial Hippocampus Networks for Efficient Long-Context Modeling. Yunhao Fang, Weihao Yu, Shu Zhong, Qinghao Ye, Xuehan Xiong, Lai Wei. Arxiv 2025.
-
Massive Activations in Hybrid Linear Attention Large Language Models: Pre-Attention Spikes and Inter-Spike Plateaus. Zunhai Su, Bohan Sun, Xialie Zhuang, Shuibai Zhang, He Xiao, Jing Xiong, Hengyuan Zhang, Zhongzhu Zhou, Tiantian Zhang, Ngai Wong, Chuan-Wei Kuo. Arxiv 2026.
-
Mamba with Hierarchical Memory: Solving Representation Bottleneck in Long Sequence Modeling. Qinwen Wang, Jieping Luo, Aoxiang Qin, Ruoyu Zhao, Jianxiong Tang, Wei Zhang, Zhichao Lu, Luziwei Leng. Arxiv 2026.
-
Retrofitting Linear Attention into Diffusion Language Models. Jinha Kim, Younghun Roh, Jaeyeon Kim. Arxiv 2026.
-
Muon Meets Mamba: Spectral Optimization for State Space Models. Arslan Battalov, Karim Kramin, Alexander Markotenko, Sofia Sinitsina. Arxiv 2026.
-
DART: Decoded Attention over Recurrent States for Efficient Long-Context Sequence Modeling. Yixiao Qian, Song Chen, Pengkai Wang, Jiaxu Liu, Shengze Cai, Chao Xu. Arxiv 2026.
-
MARCH: Scaling Recurrent Memory with Content-Routed State Anchors. Ming Zhang, Kaisen Yang, Shu Yu, Ermo Hua, Ning Ding, Xia Hu, Bowen Zhou, Chaochao Lu, Youbang Sun. Arxiv 2026.
-
StateFlow: Sequence Pipeline Parallelism for Long-Context Modeling with Linear Recurrence. Wenxuan Zhao, Yingfa Chen, Xu Han, Wenjing Han, Tianbo Huang, Zhiyu Li, Ao Sun, Jingheng Xu, Lin Gan, Guangwen Yang. Arxiv 2026.
Workflow Design
Prompt Compression
- Prompt Compression for Large Language Models: A Survey. Zongqian Li, Yinhong Liu, Yixuan Su, Nigel Collier. Arxiv 2024.
Hard Prompt Compression
-
LLMLingua: Compressing Prompts for Accelerated Inference of Large Language Models. Huiqiang Jiang, Qianhui Wu, Chin-Yew Lin, Yuqing Yang, Lili Qiu. Arxiv 2023.
-
LongLLMLingua: Accelerating and Enhancing LLMs in Long Context Scenarios via Prompt Compression. Huiqiang Jiang, Qianhui Wu, Xufang Luo, Dongsheng Li, Chin-Yew Lin, Yuqing Yang, Lili Qiu. Arxiv 2023.
-
LLMLingua-2: Data Distillation for Efficient and Faithful Task-Agnostic Prompt Compression. Zhuoshi Pan, Qianhui Wu, Huiqiang Jiang, Menglin Xia, Xufang Luo, Jue Zhang, Qingwei Lin, Victor Rühle, Yuqing Yang, Chin-Yew Lin, H. Vicky Zhao, Lili Qiu, Dongmei Zhang. Arxiv 2024.
-
Compressing Context to Enhance Inference Efficiency of Large Language Models. Yucheng Li, Bo Dong, Chenghua Lin, Frank Guerin. Arxiv 2023.
-
TACO-RL: Task Aware Prompt Compression Optimization with Reinforcement Learning. Shivam Shandilya, Menglin Xia, Supriyo Ghosh, Huiqiang Jiang, Jue Zhang, Qianhui Wu, Victor Rühle. Arxiv 2024.
-
Prompt Compression with Context-Aware Sentence Encoding for Fast and Improved LLM Inference. Barys Liskavets, Maxim Ushakov, Shuvendu Roy, Mark Klibanov, Ali Etemad, Shane Luke. Arxiv 2024.
-
AdaComp: Extractive Context Compression with Adaptive Predictor for Retrieval-Augmented Large Language Models. Qianchi Zhang, Hainan Zhang, Liang Pang, Hongwei Zheng, Zhiming Zheng. Arxiv 2024.
-
Learning to Compress Prompt in Natural Language Formats. Yu-Neng Chuang, Tianwei Xing, Chia-Yuan Chang, Zirui Liu, Xun Chen, Xia Hu. Arxiv 2024.
-
{TCRA}-{LLM}: Token Compression Retrieval Augmented Large Language Model for Inference Cost Reduction. Junyi Liu, Liangzhi Li, Tong Xiang, Bowen Wang, Yiming Qian. Arxiv 2023
-
Familiarity-Aware Evidence Compression for Retrieval-Augmented Generation. Dongwon Jung, Qin Liu, Tenghao Huang, Ben Zhou, Muhao Chen. Arxiv 2024
-
Discrete Prompt Compression With Reinforcement Learning. Hoyoun Jung, Kyung-Joong Kim. Arxiv 2024
-
CompAct: Compressing Retrieved Documents Actively for Question Answering. Chanwoong Yoon, Taewhoo Lee, Hyeon Hwang, Minbyul Jeong, Jaewoo Kang. Arxiv 2024
-
EXIT: Context-Aware Extractive Compression for Enhancing Retrieval-Augmented Generation. Taeho Hwang, Sukmin Cho, Soyeong Jeong, Hoyun Song, SeungYoon Han, Jong C. Park. Arxiv 2024.
-
Selection-p: Self-Supervised Task-Agnostic Prompt Compression for Faithfulness and Transferability. Tsz Ting Chung, Leyang Cui, Lemao Liu, Xinting Huang, Shuming Shi, Dit-Yan Yeung. EMNLP 2024.
-
Visual Text Compression as Measure Transport. Lv Tang, Tianyi Zheng, Yang Liu, Bo Li, Xingyu Li. Arxiv 2026.
-
AgentOCR: Reimagining Agent History via Optical Self-Compression. Lang Feng, Fuchao Yang, Feng Chen, Xin Cheng, Haiyang Xu, Zhenglin Wan, Ming Yan, Bo An. Arxiv 2026.
-
ZipRL: Adaptive Multi-Turn Context Compression with Hindsight Response Replay. Zhexin Hu, Li Wang, Xiaohan Wang, Jiajun Chai, Xiaojun Guo, Wei Lin, Guojun Yin. Arxiv 2026.
-
Relevant but Incomplete: Referential Dangling as a Paradigm-Level Failure Mode in Hard Prompt Compression. Zhengpei Hu, Kai Li, Dapeng Fu, Xuechao Zou, Yuanhao Tang, Yue Li, Tengfei Cao, Jianqiang Huang. Arxiv 2026.
-
SALT: Salience-Aware Lexical Trie for Long-Context Compression. Oteo Mamo, Hyunjin Yi, Joydhriti Choudhury, Shangqian Gao, Weikuan Yu. Arxiv 2026.
-
Every Time I Hire a Linguist, Inference Costs Go Down: On Linguistic Rules as Effective Prompt Compressors. Jianfei Ma, Zhaoxin Feng, Emmanuele Chersoni, Si Chen. Arxiv 2026.
-
PReM: Learning What to Preserve and When to Refresh for Context Compression. Bohan Yu, Lei Shen, Chenxi Zhou, Chen Han, Junlin Liu, Wenbo Su, Yu Cheng, Bo Zheng. Arxiv 2026.
-
Context Compression Is Not One Thing: Readable Symbolic Re-expression vs. Coherent Summary at Matched Budget. Sisong Bei, Mikhail L. Arbuzov, Ziwei Dong, Dmitri Kalaev, Alexey Shvets. Arxiv 2026.
Soft Prompt Compression
-
Adapting Language Models to Compress Contexts. Alexis Chevalier, Alexander Wettig, Anirudh Ajith, Danqi Chen. Arxiv 2023.
-
xRAG: Extreme Context Compression for Retrieval-augmented Generation with One Token. Xin Cheng, Xun Wang, Xingxing Zhang, Tao Ge, Si-Qing Chen, Furu Wei, Huishuai Zhang, Dongyan Zhao. Arxiv 2024.
-
In-context Autoencoder for Context Compression in a Large Language Model. Tao Ge, Hu Jing, Lei Wang, Xun Wang, Si-Qing Chen, Furu Wei. ICLR 2024.
-
The Power of Scale for Parameter-Efficient Prompt Tuning. Brian Lester, Rami Al-Rfou, Noah Constant. Arxiv 2021
-
Prompt Compression and Contrastive Conditioning for Controllability and Toxicity Reduction in Language Models. David Wingate, Mohammad Shoeybi, Taylor Sorensen. Arxiv 2022
-
Learning to Compress Prompts with Gist Tokens. Jesse Mu, Xiang Lisa Li, Noah Goodman. Arxiv 2024
-
Unifying Demonstration Selection and Compression for In-Context Learning. Jun Gao, Ziqiang Cao, Wenjie Li. Arxiv 2024
-
Long Context Compression with Activation Beacon. Peitian Zhang, Zheng Liu, Shitao Xiao, Ninglu Shao, Qiwei Ye, Zhicheng Dou. Arxiv 2024
-
500xCompressor: Generalized Prompt Compression for Large Language Models. Zongqian Li, Yixuan Su, Nigel Collier. Arxiv 2024
-
DivPrune: Diversity-based Visual Token Pruning for Large Multimodal Models. Saeed Ranjbar Alvar, Gursimran Singh, Mohammad Akbari, Yong Zhang. Arxiv 2025.
-
EFPC: Towards Efficient and Flexible Prompt Compression. Yun-Hao Cao, Yangsong Wang, Shuzheng Hao, Zhenxing Li, Chengjun Zhan, Sichao Liu, Yi-Qi Hu. Arxiv 2025.
-
AttentionRAG: Attention-Guided Context Pruning in Retrieval-Augmented Generation. Yixiong Fang, Tianran Sun, Yuling Shi, Xiaodong Gu. Arxiv 2025.
-
Limits of KV Cache Compression for Tensor Attention based Autoregressive Transformers. Yifang Chen, Xiaoyu Li, Yingyu Liang, Zhenmei Shi, Zhao Song, Yu Tian. Arxiv 2025.
-
Hybrid-Level Instruction Injection for Video Token Compression in Multi-modal Large Language Models. Zhihang Liu, Chen-Wei Xie, Pandeng Li, Liming Zhao, Longxiang Tang, Yun Zheng, Chuanbin Liu, Hongtao Xie. CVPR 2025.
-
Token Dynamics: Towards Efficient and Dynamic Video Token Representation for Video Large Language Models. Haichao Zhang, Zhuowei Li, Dimitris Metaxas, Yun Fu. Arxiv 2025.
-
A Silver Bullet or a Compromise for Full Attention? A Comprehensive Study of Gist Token-based Context Compression. Chenlong Deng, Zhisong Zhang, Kelong Mao, Shuaiyi Li, Xinting Huang, Dong Yu, Zhicheng Dou. Arxiv 2024.
-
Layer- and Timestep-Adaptive Differentiable Token Compression Ratios for Efficient Diffusion Transformers. Haoran You, Connelly Barnes, Yuqian Zhou, Yan Kang, Zhenbang Du, Wei Zhou, Lingzhi Zhang, Yotam Nitzan, Xiaoyang Liu, Zhe Lin, Eli Shechtman, Sohrab Amirghodsi, Yingyan Celine Lin. Arxiv 2024.
-
Efficient Prompt Compression with Evaluator Heads for Long-Context Transformer Inference. Weizhi Fei, Xueyan Niu, Guoqing Xie, Yingqing Liu, Bo Bai, Wei Han. Arxiv 2025.
-
Understanding and Improving Information Preservation in Prompt Compression for LLMs. Weronika Łajewska, Momchil Hardalov, Laura Aina, Neha Anna John, Hang Su, Lluís Màrquezu. Arxiv 2025.
-
Fwd2Bot: LVLM Visual Token Compression with Double Forward Bottleneck. Adrian Bulat, Yassine Ouali, Georgios Tzimiropoulos. Arxiv 2025.
-
Efficient Dynamic Clustering-Based Document Compression for Retrieval-Augmented-Generation. Weitao Li, Kaiming Liu, Xiangyu Zhang, Xuanyu Lei, Weizhi Ma, Yang Liu. Arxiv 2025.
-
Saliency-driven Dynamic Token Pruning for Large Language Models. Yao Tao, Yehui Tang, Yun Wang, Mingjian Zhu, Hailin Hu, Yunhe Wang. Arxiv 2025.
-
Dynamic Compressing Prompts for Efficient Inference of Large Language Models. Jinwu Hu, Wei Zhang, Yufeng Wang, Yu Hu, Bin Xiao, Mingkui Tan, Qing Du. Arxiv 2025.
-
ACoRN: Noise-Robust Abstractive Compression in Retrieval-Augmented Language Models. Singon Kim, Gunho Jung, Seong-Whan Lee. Arxiv 2025.
-
MOOSComp: Improving Lightweight Long-Context Compressor via Mitigating Over-Smoothing and Incorporating Outlier Scores. Fengwei Zhou, Jiafei Song, Wenjin Jason Li, Gengjian Xue, Zhikang Zhao, Yichao Lu, Bailin Na. Arxiv 2025.
-
Token Sequence Compression for Efficient Multimodal Computing. Yasmine Omri, Parth Shroff, Thierry Tambe. Arxiv 2025.
-
An Empirical Study on Prompt Compression for Large Language Models. Zheng Zhang, Jinyi Li, Yihuai Lan, Xiang Wang, Hao Wang. Arxiv 2025.
-
Video Compression Commander: Plug-and-Play Inference Acceleration for Video Large Language Models. Xuyang Liu, Yiyu Wang, Junpeng Ma, Linfeng Zhang. Arxiv 2025.
-
Beyond Hard and Soft: Hybrid Context Compression for Balancing Local and Global Information Retention. Huanxuan Liao, Wen Hu, Yao Xu, Shizhu He, Jun Zhao, Kang Liu. Arxiv 2025.
-
QwenLong-CPRS: Towards ∞-LLMs with Dynamic Context Optimization. Weizhou Shen, Chenliang Li, Fanqi Wan, Shengyi Liao, Shaopeng Lai, Bo Zhang, Yingcheng Shi, Yuning Wu, Gang Fu, Zhansheng Li, Bin Yang, Ji Zhang, Fei Huang, Jingren Zhou, Ming Yan. Arxiv 2025.
-
Lossless Token Sequence Compression via Meta-Tokens. John Harvill, Ziwei Fan, Hao Wang, Yizhou Sun, Hao Ding, Luke Huan, Anoop Deoras. Arxiv 2025.
-
Sentinel: Attention Probing of Proxy Models for LLM Context Compression with an Understanding Perspective. Yong Zhang, Yanwen Huang, Ning Cheng, Yang Guo, Yun Zhu, Yanmeng Wang, Shaojun Wang, Jing Xiao. Arxiv 2025.
-
METok: Multi-Stage Event-based Token Compression for Efficient Long Video Understanding. Mengyue Wang, Shuo Chen, Kristian Kersting, Volker Tresp, Yunpu Ma. Arxiv 2025.
-
SecurityLingua: Efficient Defense of LLM Jailbreak Attacks via Security-Aware Prompt Compression. Yucheng Li, Surin Ahn, Huiqiang Jiang, Amir H. Abdi, Yuqing Yang, Lili Qiu. Arxiv 2025.
-
Chain-of-Thought Compression Should Not Be Blind: V-Skip for Efficient Multimodal Reasoning via Dual-Path Anchoring. Dongxu Zhang, Yiding Sun, Cheng Tan, Wenbiao Yan, Ning Yang, Jihua Zhu, Hiajun Zhang. Arxiv 2025.
-
Context Cascade Compression: Exploring the Upper Limits of Text Compression. Fanfan Liu, Haibo Qiu. Arxiv 2025.
-
CompressKV: Semantic Retrieval Heads Know What Tokens are Not Important Before Generation Xiaolin Lin, Jingcun Wang, Olga Kondrateva, Yiyu Shi, Bing Li, Grace Li Zhang. Arxiv 2025.
-
UniGist: Towards General and Hardware-aligned Sequence-level Long Context Compression Chenlong Deng, Zhisong Zhang, Kelong Mao, Shuaiyi Li, Tianqing Fang, Hongming Zhang, Haitao Mi, Dong Yu, Zhicheng Dou. Arxiv 2025.
-
ProCut: LLM Prompt Compression via Attribution Estimation Zhentao Xu, Fengyi Li, Albert Chen, Xiaofeng Wang. Arxiv 2025.
-
DSPC: Dual-Stage Progressive Compression Framework for Efficient Long-Context Reasoning Yaxin Gao, Yao Lu, Zongfei Zhang, Jiaqi Nie, Shanqing Yu, Qi Xuan. Arxiv 2025.
-
AttnComp: Attention-Guided Adaptive Context Compression for Retrieval-Augmented Generation Lvzhou Luo, Yixuan Cao, Ping Luo. Arxiv 2025.
-
LongCodeZip: Compress Long Context for Code Language Models Yuling Shi, Yichun Qian, Hongyu Zhang, Beijun Shen, Xiaodong Gu. Arxiv 2025.
-
ILRe: Intermediate Layer Retrieval for Context Compression in Causal Language Models Manlai Liang, Mandi Liu, Jiangzhou Ji, Huaijun Li, Haobo Yang, Yaohan He, Jinlong Li. Arxiv 2025.
-
DeepSeek-OCR: Contexts Optical Compression Haoran Wei, Yaofeng Sun, Yukun Li. Arxiv 2025.
-
Simple Context Compression: Mean-Pooling and Multi-Ratio Training Yair Feldman, Yoav Artzi. Arxiv 2025.
-
LLM Compression: How Far Can We Go in Balancing Size and Performance? Sahil Sk, Debasish Dhal, Sonal Khosla, Sk Shahid, Sambit Shekhar, Akash Dhaka, Shantipriya Parida, Dilip K. Prasad, Ondřej Bojar. Arxiv 2025.
-
One Shot vs. Iterative: Rethinking Pruning Strategies for Model Compression Mikołaj Janusz, Tomasz Wojnar, Yawei Li, Luca Benini, Kamil Adamczewski. Arxiv 2025.
-
Reasoning Efficiently Through Adaptive Chain-of-Thought Compression: A Self-Optimizing Framework Kerui Huang, Shuhan Liu, Xing Hu, Tongtong Xu, Lingfeng Bao, Xin Xia. Arxiv 2025.
-
From Long to Lean: Performance-aware and Adaptive Chain-of-Thought Compression via Multi-round Refinement Jianzhi Yan, Le Liu, Youcheng Pan, Shiwei Chen, Zike Yuan, Yang Xiang, Buzhou Tang. Arxiv 2025.
-
R-Capsule: Compressing High-Level Plans for Efficient Large Language Model Reasoning Hongyu Shan, Mingyang Song, Chang Dai, Di Liang, Han Chen. Arxiv 2025.
-
Representation Shift: Unifying Token Compression with FlashAttention Joonmyung Choi, Sanghyeok Lee, Byungoh Ko, Eunseo Kim, Jihyung Kil, Hyunwoo J. Kim. Arxiv 2025.
-
A Glimpse to Compress: Dynamic Visual Token Pruning for Large Vision-Language Models Quan-Sheng Zeng, Yunheng Li, Qilong Wang, Peng-Tao Jiang, Zuxuan Wu, Ming-Ming Cheng, Qibin Hou. Arxiv 2025.
-
Fourier-VLM: Compressing Vision Tokens in the Frequency Domain for Large Vision-Language Models Huanyu Wang, Jushi Kai, Haoli Bai, Lu Hou, Bo Jiang, Ziwei He, Zhouhan Lin. Arxiv 2025.
-
Seeing More, Saying More: Lightweight Language Experts are Dynamic Video Token Compressors Arxiv 2025.
-
MARC: Memory-Augmented RL Token Compression for Efficient Video Understanding Peiran Wu, Zhuorui Yu, Yunze Liu, Chi-Hao Wu, Enmin Zhou, Junxiao Shen. Arxiv 2025.
-
VisionSelector: End-to-End Learnable Visual Token Compression for Efficient Multimodal LLMs Jiaying Zhu, Yurui Zhu, Xin Lu, Wenrui Yan, Dong Li, Kunlin Liu, Xueyang Fu, Zheng-Jun Zha. Arxiv 2025.
-
StreamingTOM: Streaming Token Compression for Efficient Video Understanding Xueyi Chen, Keda Tao, Kele Shao, Huan Wang. Arxiv 2025.
-
FLoC: Facility Location-Based Efficient Visual Token Compression for Long Video Understanding Janghoon Cho, Jungsoo Lee, Munawar Hayat, Kyuwoong Hwang, Fatih Porikli, Sungha Choi. Arxiv 2025.
-
Can Visual Input Be Compressed? A Visual Token Compression Benchmark for Large Multimodal Models Tianfan Peng, Yuntao Du, Pengzhou Ji, Shijie Dong, Kailin Jiang, Mingchuan Ma, Yijun Tian, Jinhe Bi, Qian Li, Wei Du, Feng Xiao, Lizhen Cui. Arxiv 2025.
-
VideoCompressa: Data-Efficient Video Understanding via Joint Temporal Compression and Spatial Reconstruction Shaobo Wang, Tianle Niu, Runkang Yang, Deshan Liu, Xu He, Zichen Wen, Conghui He, Xuming Hu, Linfeng Zhang. Arxiv 2025.
-
LLaVA-UHD v3: Progressive Visual Compression for Efficient Native-Resolution Encoding in MLLMs Shichu Sun, Yichen Zhang, Haolin Song, Zonghao Guo, Chi Chen, Yidan Zhang, Yuan Yao, Zhiyuan Liu, Maosong Sun. Arxiv 2025.
-
Compressor-VLA: Instruction-Guided Visual Token Compression for Efficient Robotic Manipulation Juntao Gao, Feiyang Ye, Jing Zhang, Wenjing Qian. Arxiv 2025.
-
UniComp: Rethinking Video Compression Through Informational Uniqueness Chao Yuan, Shimin Chen, Minliang Lin, Limeng Qiao, Guanglu Wan, Lin Ma. Arxiv 2025.
-
SSPO: Self-traced Step-wise Preference Optimization for Process Supervision and Reasoning Compression Yuyang Xu, Yi Cheng, Haochao Ying, Zhuoyun Du, Renjun Hu, Xing Shi, Wei Lin, Jian Wu. Arxiv 2025.
-
LeanK: Learnable K Cache Channel Pruning for Efficient Decoding Yike Zhang, Zhiyuan He, Huiqiang Jiang, Chengruidong Zhang, Yuqing Yang, Jianyong Wang, Lili Qiu. Arxiv 2025.
-
SlimInfer: Accelerating Long-Context LLM Inference via Dynamic Token Pruning Lingkun Long, Rubing Yang, Yushi Huang, Desheng Hui, Ao Zhou, Jianlei Yang. Arxiv 2025.
-
E3-Pruner: Towards Efficient, Economical, and Effective Layer Pruning for Large Language Models Tao Yuan, Haoli Bai, Yinfei Pan, Xuyang Cao, Tianyu Zhang, Lu Hou, Ting Hu, Xianzhi Yu. Arxiv 2025.
-
SCOPE: Saliency-Coverage Oriented Token Pruning for Efficient Multimodel LLMs Jinhong Deng, Wen Li, Joey Tianyi Zhou, Yang He. Arxiv 2025.
-
Pruning the Unsurprising: Efficient Code Reasoning via First-Token Surprisal Wenhao Zeng, Yaoning Wang, Chao Hu, Yuling Shi, Chengcheng Wan, Hongyu Zhang, Xiaodong Gu. Arxiv 2025.
-
Large Language Model as Token Compressor and Decompressor. Wenbing Li, Zikai Song, Jielei Zhang, Tianhao Zhao, Junkai Lin, Yiran Wang, Wei Yang. Arxiv 2026.
-
Density-aware Soft Context Compression with Semi-Dynamic Compression Ratio. Yijiong Yu, Shuai Yuan, Jie Zheng, Huazheng Wang, Ji Pei. Arxiv 2026.
-
Latent Context Compilation: Distilling Long Context into Compact Portable Memory. Zeju Li, Yizhou Zhou, Qiang Xu. Arxiv 2026.
-
The Sleeping Agent: What Gist-Based Context Compression Loses and Why. Nicholas E. Kyrkewood. Arxiv 2026.
-
VLZip: Unified Visual and Textual Compression for Interleaved Long-Context Modeling. Yuqi Zhang, Cheng Chen, Yuyu Guo, Wenjie Yang, Lingchen Meng, Peng Di, Hang Yu, Zuxuan Wu, Yu-Gang Jiang. Arxiv 2026.
Memory-Based
-
Towards Teachable Reasoning Systems: Using a Dynamic Memory of User Feedback for Continual System Improvement. Bhavana Dalvi Mishra, Oyvind Tafjord, Peter Clark. EMNLP 2022
-
Augmenting Language Models with Long-Term Memory. Weizhi Wang, Li Dong, Hao Cheng, Xiaodong Liu, Xifeng Yan, Jianfeng Gao, Furu Wei. NeurIPS 2023
-
{MEMORYLLM:} Towards Self-Updatable Large Language Models. Yu Wang, Yifan Gao, Xiusi Chen, Haoming Jiang, Shiyang Li, Jingfeng Yang, Qingyu Yin, Zheng Li, Xian Li, Bing Yin, Jingbo Shang, Julian J. McAuley. ICML 2024
-
MemoryBank: Enhancing Large Language Models with Long-Term Memory. Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, Yanlin Wang. Arxiv 2023.
-
You Only Read Once (YORO): Learning to Internalize Database Knowledge for Text-to-SQL. Hideo Kobayashi, Wuwei Lan, Peng Shi, Shuaichen Chang, Jiang Guo, Henghui Zhu, Zhiguo Wang, Patrick Ng. NAACL 2025
-
KVSink: Understanding and Enhancing the Preservation of Attention Sinks in KV Cache Quantization for LLMs Zunhai Su, Kehong Yuan. Arxiv 2025.
-
XQuant: Breaking the Memory Wall for LLM Inference with KV Cache Rematerialization Aditya Tomar, Coleman Hooper, Minjae Lee, Haocheng Xi, Rishabh Tiwari, Wonjun Kang, Luca Manolache, Michael W. Mahoney, Kurt Keutzer, Amir Gholami. Arxiv 2025.
-
Sparse Attention across Multiple-context KV Cache Ziyi Cao, Qingyi Si, Jingbin Zhang, Bingquan Liu. Arxiv 2025.
-
SparK: Query-Aware Unstructured Sparsity with Recoverable KV Cache Channel Pruning Huanxuan Liao, Yixing Xu, Shizhu He, Guanchen Li, Xuanwu Yin, Dong Li, Emad Barsoum, Jun Zhao, Kang Liu. Arxiv 2025.
-
Spotlight Attention: Towards Efficient LLM Generation via Non-linear Hashing-based KV Cache Retrieval Wenhao Li, Yuxin Zhang, Gen Luo, Haiyuan Wan, Ziyang Gong, Fei Chao, Rongrong Ji. Arxiv 2025.
-
GraphKV: Breaking the Static Selection Paradigm with Graph-Based KV Cache Eviction Xuelin Li, Xiangqi Jin, Linfeng Zhang. Arxiv 2025.
-
KVCompose: Efficient Structured KV Cache Compression with Composite Tokens Dmitry Akulov, Mohamed Sana, Antonio De Domenico, Tareq Si Salem, Nicola Piovesan, Fadhel Ayed. Arxiv 2025.
-
EvolKV: Evolutionary KV Cache Compression for LLM Inference Bohan Yu, Yekun Chai. Arxiv 2025.
-
LAVa: Layer-wise KV Cache Eviction with Dynamic Budget Allocation Yiqun Shen, Song Yuan, Zhengze Zhang, Xiaoliang Wang, Daxin Jiang, Nguyen Cam-Tu. Arxiv 2025.
-
EpiCache: Episodic KV Cache Management for Long Conversational Question Answering Arxiv 2025.
-
OjaKV: Context-Aware Online Low-Rank KV Cache Compression with Oja's Rule Yuxuan Zhu, David H. Yang, Mohammad Mohammadi Amiri, Keerthiram Murugesan, Tejaswini Pedapati, Pin-Yu Chen. Arxiv 2025.
-
StreamKV: Streaming Video Question-Answering with Segment-based KV Cache Retrieval and Compression Yilong Chen, Xiang Bai, Zhibin Wang, Chengyu Bai, Yuhan Dai, Ming Lu, Shanghang Zhang. Arxiv 2025.
-
Revisiting Multimodal KV Cache Compression: A Frequency-Domain-Guided Outlier-KV-Aware Approach Yaoxin Yang, Peng Ye, Xudong Tan, Chongjun Tu, Maosen Zhao, Jia Hao, Tao Chen. Arxiv 2025.
-
LightVLM: Acceleraing Large Multimodal Models with Pyramid Token Merging and KV Cache Compression Arxiv 2025.
-
δ-mem: Efficient Online Memory for Large Language Models. Jingdi Lei, Di Zhang, Junxian Li, Weida Wang, Kaixuan Fan, Xiang Liu, Qihan Liu, Xiaoteng Ma, Baian Chen, Soujanya Poria. Arxiv 2026.
-
Omni-SimpleMem: Autoresearch-Guided Discovery of Lifelong Multimodal Agent Memory. Jiaqi Liu, Zipeng Ling, Shi Qiu, Yanqing Liu, Siwei Han, Peng Xia, Haoqin Tu, Zeyu Zheng, Cihang Xie, Charles Fleming, Mingyu Ding, Huaxiu Yao. Arxiv 2026.
-
Thinking Ahead: Prospection-Guided Retrieval of Memory with Language Models. Harshita Chopra et al. Arxiv 2026.
-
Cognifold: Always-On Proactive Memory via Cognitive Folding. Suli Wang, Yiqun Duan, Yu Deng, Rundong Zhao, Dai Shi, Xinliang Zhou. Arxiv 2026.
-
A Heterogeneous Temporal Memory Governance Framework for Long-Term LLM Persona Consistency. Zhao Yang, Wang Huan, Li Yingshuo, Tu Haomiao, Lin Hujite. Arxiv 2026.
-
Improving Multi-turn Dialogue Consistency with Self-Recall Thinking. Renning Pang, Tian Lan, Leyuan Liu, Xiaoming Huang, Piao Tong, Xiaosong Zhang. Arxiv 2026.
-
Fast-weight Product Key Memory. Tianyu Zhao, Llion Jones. Arxiv 2026.
-
Human-Like Lifelong Memory: A Neuroscience-Grounded Architecture for Infinite Interaction. Diego C. Lerma-Torres. Arxiv 2026.
-
Explore with Long-term Memory: A Benchmark and Multimodal LLM-based Reinforcement Learning Framework for Embodied Exploration. Sen Wang, Bangwei Liu, Zhenkun Gao, Lizhuang Ma, Xuhong Wang, Yuan Xie, Xin Tan. Arxiv 2026.
-
Can Coding Agents Externalize Long-Context Processing? Weili Cao, Xunjian Yin, Bhuwan Dhingra, Shuyan Zhou. Arxiv 2026.
-
Metis: Memory Foundation Model. Zeyu Zhang, Ziliang Guo, Yihang Sun, Xichong Zhang, Xixuan Hao, Zehao Lin, Yang Zhang, Xiaoyan Zhao, Tong Shen, Bo Tang, Zhi-Qin John Xu, Junchi Yan, Haofen Wang, Xu Chen, Feiyu Xiong, Zhiyu Li, Tat-Seng Chua. Arxiv 2026.
-
PI-Mem: Pushing Long-Context Reasoning to 3.6M Tokens with Parallel-Iterative Memory. Dawei Liu, Haixu Song, Shuang Cheng, Shijie Wang, Haozheng Hou, Kaifeng Liu, Ermo Hua, Zhonghang Yuan, Zhijie Zhong, Yuchen Fan, Biqing Qi, Bowen Zhou. Arxiv 2026.
-
RippleMem: From Isolated Retrieval to Associative Recollection for Long-Term Agent Memory. Jingbo Ji, Lingyi Li, Xilong Cheng, Yuhao Zhou, Wenji Zhang, Yuting Tan, Yunxiao Qin. Arxiv 2026.
-
MemoryLake on MemoryArena: A Matched Study of Agent Memory Backends. Chaoqun Zhan, Qiang Zhou, Guannan Li, Zhenqiang Huang, Qianjin Wang. Arxiv 2026.
-
LycheeMemory V2: Efficient Long-Term Memory for LLM Agents via Semantic Segment-Level Consolidation. Dongfang Li, Zixuan Liu, Junmai Wang, Jiahe Huang, Fuhao Li, Bonian Jia, Baotian Hu, Min Zhang. Arxiv 2026.
-
MESA:Task-Adaptive Multi-Structure Evidence Selection for Long-Horizon Agent Memory. Beidi Zhao, Yaoqi Chen, Yuru Feng, Menghao Li, Qianxi Zhang, Baotong Lu, Jianan Lu, Zhirui Wang, Xinjiang Wang, Shusen Xu, Zengzhong Li, Xiaoxiao Li, Qi Chen. Arxiv 2026.
-
MemoryCPT: An End-to-End Agent Memory Framework for Cost-Performance Trade-off. Songxin Lei, Kun Ouyang, Weilin Ruan, Yuqian Wu, Zhijiang Guo, Yushi Sun, Fugee Tsung. Arxiv 2026.
-
Caching for the Future: Scrub Jay Episodic Memory Principles for Agent Memory Systems. Kartikey Singh Bhandari, Aarya Wadhwani, Dhruv Kumar, Pratik Narang. Arxiv 2026.
-
Towards a Formal Definition of Agent Memory: Basis, Span, Optimality, and the Sequential Memory Problem. Hongyao Tang. Arxiv 2026.
-
SeDeM: Selective Decompression of Hidden-State Memories for Long-Context Question Answering. Maryam Haghifam, Jason Cong, Yizhou Sun. Arxiv 2026.
RAG-Based
-
{BERT}: Pre-training of Deep Bidirectional Transformers for Language Understanding. Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova. ACL 2019
-
Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering. Gautier Izacard, Edouard Grave. ACL 2021
-
RepoCoder: Repository-Level Code Completion Through Iterative Retrieval and Generation. Fengji Zhang, Bei Chen, Yue Zhang, Jacky Keung, Jin Liu, Daoguang Zan, Yi Mao, Jian{-}Guang Lou, Weizhu Chen. EMNLP 2023
-
Query Rewriting in Retrieval-Augmented Large Language Models. Xinbei Ma, Yeyun Gong, Pengcheng He, hai zhao, Nan Duan. EMNLP 2023
-
{REPLUG}: Retrieval-Augmented Black-Box Language Models. Weijia Shi, Sewon Min, Michihiro Yasunaga, Minjoon Seo, Richard James, Mike Lewis, Luke Zettlemoyer, Wen-tau Yih. ACL 2024
-
{BGE} M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation. Jianlv Chen, Shitao Xiao, Peitian Zhang, Kun Luo, Defu Lian, Zheng Liu. Arxiv 2024
-
Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. Benjamin Warner, Antoine Chaffin, Benjamin Clavié, Orion Weller, Oskar Hallström, Said Taghadouini, Alexis Gallagher, Raja Biswas, Faisal Ladhak, Tom Aarsen, Nathan Cooper, Griffin Adams, Jeremy Howard, Iacopo Poli. Arxiv 2024
-
Beyond RAG: Task-Aware KV Cache Compression for Comprehensive Knowledge Reasoning. Giulio Corallo, Orion Weller, Fabio Petroni, Paolo Papotti. Arxiv 2025.
-
Efficient Many-Shot In-Context Learning with Dynamic Block-Sparse Attention. Emily Xiao, Chin-Jou Li, Yilin Zhang, Graham Neubig, Amanda Bertsch. Arxiv 2025.
-
Conflict-Aware Soft Prompting for Retrieval-Augmented Generation Arxiv 2025.
-
Why Neighborhoods Matter: Traversal Context and Provenance in Agentic GraphRAG. Riccardo Terrenzi, Maximilian von Zastrow, Serkan Ayvaz. Arxiv 2026.
-
Why Retrieval-Augmented Generation Fails: A Graph Perspective. Kai Guo, Xinnan Dai, Zhibo Zhang, Nuohan Lin, Shenglai Zeng, Jie Ren, Haoyu Han, Jiliang Tang. Arxiv 2026.
-
Is Grep All You Need? How Agent Harnesses Reshape Agentic Search. Sahil Sen, Akhil Kasturi, Elias Lumer, Anmol Gulati, Vamse Kumar Subbiah. Arxiv 2026.
-
Stop Overthinking: Unlocking Efficient Listwise Reranking with Minimal Reasoning. Danyang Liu, Kan Li. Arxiv 2026.
Agent-Based
-
Re3: Generating Longer Stories With Recursive Reprompting and Revision. Kevin Yang, Yuandong Tian, Nanyun Peng, Dan Klein. EMNLP 2022
-
Walking Down the Memory Maze: Beyond Context Limit through Interactive Reading. Howard Chen, Ramakanth Pasunuru, Jason Weston, Asli Celikyilmaz. Arxiv 2023.
-
PEARL: Prompting Large Language Models to Plan and Execute Actions Over Long Documents. Simeng Sun, Yang Liu, Shuohang Wang, Dan Iter, Chenguang Zhu, Mohit Iyyer. EACL 2024.
-
Learning to Reason and Memorize with Self-Notes. Jack Lanchantin, Shubham Toshniwal, Jason Weston, arthur szlam, Sainbayar Sukhbaatar. NeurIPS 2023
-
GraphReader: Building Graph-based Agent to Enhance Long-Context Abilities of Large Language Models. Shilong Li, Yancheng He, Hangyu Guo, Xingyuan Bu, Ge Bai, Jie Liu, Jiaheng Liu, Xingwei Qu, Yangguang Li, Wanli Ouyang, Wenbo Su, Bo Zheng. Arxiv 2024.
-
A Human-Inspired Reading Agent with Gist Memory of Very Long Contexts. Kuang-Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, Ian Fischer. Arxiv 2024.
-
RoleAgent: Building, Interacting, and Benchmarking High-quality Role-Playing Agents from Scripts. Jiaheng Liu, Zehao Ni, Haoran Que, Tao Sun, Noah Wang, Jian Yang, JiakaiWang, Hongcheng Guo, Z.Y. Peng, Ge Zhang, Jiayi Tian, Xingyuan Bu, Ke Xu, Wenge Rong, Junran Peng, Zhaoxiang Zhang. NeurIPS 2024
-
Chain of Agents: Large Language Models Collaborating on Long-Context Tasks. Yusen Zhang, Ruoxi Sun, Yanfei Chen, Tomas Pfister, Rui Zhang, Sercan Ö. Arik. Arxiv 2024.
-
LongAgent: Scaling Language Models to 128k Context through Multi-Agent Collaboration. Jun Zhao, Can Zu, Hao Xu, Yi Lu, Wei He, Yiwen Ding, Tao Gui, Qi Zhang, Xuanjing Huang. Arxiv 2024.
-
MEMENTO: Teaching LLMs to Manage Their Own Context. Vasilis Kontonis, Yuchen Zeng, Shivam Garg, Lingjiao Chen, Hao Tang, Ziyan Wang, Ahmed Awadallah, Eric Horvitz, John Langford, Dimitris Papailiopoulos. Arxiv 2026.
-
Escaping the Context Bottleneck: Active Context Curation for LLM Agents via Reinforcement Learning. Xiaozhe Li, Tianyi Lyu, Yizhao Yang, Liang Shan, Siyi Yang, Ligao Zhang, Zhuoyi Huang, Qingwen Liu, Yang Li. Arxiv 2026.
-
GenericAgent: A Token-Efficient Self-Evolving LLM Agent via Contextual Information Density Maximization. Jiaqing Liang et al. Arxiv 2026.
-
Brief Is Better: Non-Monotonic Chain-of-Thought Budget Effects in Function-Calling Language Agents. Xuan Qi. Arxiv 2026.
-
LongHorizon-Harness: Advancing Long-Horizon Agents for Real-World Tasks. Ziyu Ma, Hailang Huang, Shun Zou, Yong Wang, Shidong Yang, Yiming Hu, Fei Wei, XiangXiang Chu. Arxiv 2026.
-
AgentRewind: Recoverable Execution for Long-Horizon LLM Agents. Yu Zhuang, Kefei Chen, Yitong Duan, Shuxin Zheng, Jian Li, Xu-Yao Zhang. Arxiv 2026.
-
The Horizon Gap: Planning, Memory, Execution, Training, and Evaluation for Long-Horizon LLM Agents. Mingguang Chen, Licheng Wang, Bo Qu. Arxiv 2026.
-
ACM: Agentic Context Management for Long Horizon Tasks. Xiaochuan Li, Ryan Ming, Meng Chu, Shuai Shao, Rong Jin, Chenyan Xiong. Arxiv 2026.
-
Recursive Synthesis for Long-Horizon Terminal Tasks. Zhongzhi Li, Yucheng Shi, Zongxia Li, Ruhan Wang, Anhao Li, Zixun Huang, Junyao Yang, Lei Ke, Ninghao Liu, Haitao Mi, Leowei Liang. Arxiv 2026.
-
AutoDesign: Meta-Harness Optimization for Long-Horizon Agentic Design. Yaxin Luo, Haobin Jiang, Jialv Zou, Xu Huang, Wenhao Yan, Haodong Li, Zhengrong Yue, Jing Li, Xiaofu Chen, Xiaohan Zhao, Jiacheng Liu, Jiacheng Cui, Zhiqiang Shen, Xiaotong Li. Arxiv 2026.
-
OneDayAgent: Towards a Long-Horizon Harness for Autonomous Agents. Jingsheng Zheng, Xinyuan Fang, Jintian Zhang, Zhengke Gui, Huajun Chen, Ningyu Zhang. Arxiv 2026.
-
Toward Reliable Context Compression for Long-Horizon Agents: An Empirical Study of Execution Instability. Guanghui Min, Liang Wu, Mayank Darbari, Chen Chen, Liangjie Hong. Arxiv 2026.
-
CHILL-Harness: Counterfactual Harness Learning for Efficient Reasoning in Long-Horizon Agents. Jiarun Fu, Lizhong Ding, Sida Chen, Honglei Xin, Chunhui Zhang, Pengqi Li, Qiuning Wei, Ye Yuan, Guoren Wang. Arxiv 2026.
-
Efficient Reinforcement Learning for Long-Horizon Tool-Use Agentic Tasks. Zelei Cheng, Amritansh Mishra, Sambit Sahu, William Campbell. COLM 2026.
Evaluation
Long-Context Comprehension
-
Ada-LEval: Evaluating long-context LLMs with length-adaptable benchmarks. Chonghua Wang, Haodong Duan, Songyang Zhang, Dahua Lin, Kai Chen. Arxiv 2024.
-
BABILong: Testing the Limits of LLMs with Long Context Reasoning-in-a-Haystack. Yuri Kuratov, Aydar Bulatov, Petr Anokhin, Ivan Rodkin, Dmitry Sorokin, Artyom Sorokin, Mikhail Burtsev. Arxiv 2024.
-
DENIAHL: In-Context Features Influence LLM Needle-In-A-Haystack Abilities. Hui Dai, Dan Pechi, Xinyi Yang, Garvit Banga, Raghav Mantri. Arxiv 2024.
-
Holistic Reasoning with Long-Context LMs: A Benchmark for Database Operations on Massive Textual Data. Seiji Maekawa, Hayate Iso, Nikita Bhutani. Arxiv 2024.
-
LongIns: A Challenging Long-context Instruction-based Exam for LLMs. Shawn Gavin, Tuney Zheng, Jiaheng Liu, Quehry Que, Noah Wang, Jian Yang, Chenchen Zhang, Wenhao Huang, Wenhu Chen, Ge Zhang. Arxiv 2024.
-
Distance between Relevant Information Pieces Causes Bias in Long-Context LLMs. Runchu Tian, Yanghao Li, Yuepeng Fu, Siyang Deng, Qinyu Luo, Cheng Qian, Shuo Wang, Xin Cong, Zhong Zhang, Yesai Wu, Yankai Lin, Huadong Wang, Xiaojiang Liu. Arxiv 2024.
-
LIFBench: Evaluating the Instruction Following Performance and Stability of Large Language Models in Long-Context Scenarios. Xiaodong Wu, Minhao Wang, Yichen Liu, Xiaoming Shi, He Yan, Xiangju Lu, Junmin Zhu, Wei Zhang. Arxiv 2024.
-
Long Range Arena: A Benchmark for Efficient Transformers. Yi Tay, Mostafa Dehghani, Samira Abnar, Yikang Shen, Dara Bahri, Philip Pham, Jinfeng Rao, Liu Yang, Sebastian Ruder, Donald Metzler. Arxiv 2020
-
LongReason: A Synthetic Long-Context Reasoning Benchmark via Context Expansion. Zhan Ling, Kang Liu, Kai Yan, Yifan Yang, Weijian Lin, Ting-Han Fan, Lingfeng Shen, Zhengyin Du, Jiecao Chen. Arxiv 2025.
-
Evaluating Multilingual Long-Context Models for Retrieval and Reasoning. Agrawal, Ameeta and Dang, Andy and Nezhad, Sina Bagheri and Pokharel, Rhitabrat and Scheinberg, Russell. ACL 2024.
-
M4le: A multi-ability multi-range multi-task multi-domain long-context evaluation benchmark for large language models. Kwan, Wai-Chung and Zeng, Xingshan and Wang, Yufei and Sun, Yusen and Li, Liangyou and Shang, Lifeng and Liu, Qun and Wong, Kam-Fai. ACL 2024.
-
Michelangelo: Long context evaluations beyond haystacks via latent structure queries. Vodrahalli, Kiran and Ontanon, Santiago and Tripuraneni, Nilesh and Xu, Kelvin and Jain, Sanil and Shivanna, Rakesh and Hui, Jeffrey and Dikkala, Nishanth and Kazemi, Mehran and Fatemi, Bahare and others. Arxiv 2024.
-
Multilingual Needle in a Haystack: Investigating Long-Context Behavior of Multilingual Large Language Models. Amey Hengle, Prasoon Bajpai, Soham Dan, Tanmoy Chakraborty. Arxiv 2024.
-
Needle Threading: Can LLMs Follow Threads through Near-Million-Scale Haystacks?. Jonathan Roberts, Kai Han, Samuel Albanie. Arxiv 2024.
-
NoLiMa: Long-Context Evaluation Beyond Literal Matching. Ali Modarressi, Hanieh Deilamsalehy, Franck Dernoncourt, Trung Bui, Ryan A. Rossi, Seunghyun Yoon, Hinrich Schütze. Arxiv 2025.
-
RULER: What’s the Real Context Size of Your Long-Context Language Models?. Hsieh, Cheng-Ping and Sun, Simeng and Kriman, Samuel and Acharya, Shantanu and Rekesh, Dima and Jia, Fei and Ginsburg, Boris. COLM 2024.
-
S3Eval: A Synthetic, Scalable, Systematic Evaluation Suite for Large Language Model. Lei, Fangyu and Liu, Qian and Huang, Yiming and He, Shizhu and Zhao, Jun and Liu, Kang. NAACL 2024.
-
Summary of a Haystack: A Challenge to Long-Context LLMs and RAG Systems. Philippe Laban, Alexander R. Fabbri, Caiming Xiong, Chien-Sheng Wu. Arxiv 2024.
-
LongHealth: A Question Answering Benchmark with Long Clinical Documents. Lisa Adams, Felix Busch, Tianyu Han, Jean-Baptiste Excoffier, Matthieu Ortala, Alexander Löser, Hugo JWL. Aerts, Jakob Nikolas Kather, Daniel Truhn, Keno Bressem. Arxiv 2024.
-
Mathhay: An automated benchmark for long-context mathematical reasoning in llms. Wang, Lei and Dong, Shan and Xu, Yuhui and Dong, Hanze and Wang, Yalu and Saha, Amrita and Lim, Ee-Peng and Xiong, Caiming and Sahoo, Doyen. Arxiv 2024.
-
RepoQA: Evaluating Long Context Code Understanding. Jiawei Liu, Jia Le Tian, Vijay Daita, Yuxiang Wei, Yifeng Ding, Yuhan Katherine Wang, Jun Yang, Lingming Zhang. Arxiv 2024.
-
Bamboo: A comprehensive benchmark for evaluating long text modeling capacities of large language models. Dong, Zican and Tang, Tianyi and Li, Junyi and Zhao, Wayne Xin and Wen, Ji-Rong. ACL 2024.
-
Clongeval: A chinese benchmark for evaluating long-context large language models. Qiu, Zexuan and Li, Jingjing and Huang, Shijue and Jiao, Xiaoqi and Zhong, Wanjun and King, Irwin. EMNLP 2024.
-
Detectiveqa: Evaluating long-context reasoning on detective novels. Xu, Zhe and Ye, Jiasheng and Liu, Xiangyang and Sun, Tianxiang and Liu, Xiaoran and Guo, Qipeng and Li, Linlin and Liu, Qun and Huang, Xuanjing and Qiu, Xipeng. Arxiv 2024.
-
ETHIC: Evaluating Large Language Models on Long-Context Tasks with High Information Coverage. Taewhoo Lee, Chanwoong Yoon, Kyochul Jang, Donghyeon Lee, Minju Song, Hyunjae Kim, Jaewoo Kang. Arxiv 2024.
-
Extending long context evaluation beyond 100k tokens. Zhang, Xinrong and Chen, Yingfa and Hu, Shengding and Xu, Zihang and Chen, Junhao and Hao, Moo and Han, Xu and Thai, Zhen and Wang, Shuo and Liu, Zhiyuan and others. ACL 2024.
-
Helmet: How to evaluate long-context language models effectively and thoroughly. Yen, Howard and Gao, Tianyu and Hou, Minmin and Ding, Ke and Fleischer, Daniel and Izsak, Peter and Wasserblat, Moshe and Chen, Danqi. ICLR 2025.
-
L-CiteEval: Do Long-Context Models Truly Leverage Context for Responding?. Zecheng Tang and Keyan Zhou and Juntao Li and Baibei Ji and Jianye Hou and Min Zhang. Arxiv 2024.
-
L-eval: Instituting standardized evaluation for long context language models. An, Chenxin and Gong, Shansan and Zhong, Ming and Zhao, Xingjian and Li, Mukai and Zhang, Jun and Kong, Lingpeng and Qiu, Xipeng. ACL 2024.
-
Long Input Benchmark for Russian Analysis. Igor Churin, Murat Apishev, Maria Tikhonova, Denis Shevelev, Aydar Bulatov, Yuri Kuratov, Sergej Averkiev, Alena Fenogenova. Arxiv 2024.
-
Can Long-Context Language Models Subsume Retrieval, RAG, SQL, and More?. Jinhyuk Lee, Anthony Chen, Zhuyun Dai, Dheeru Dua, Devendra Singh Sachan, Michael Boratko, Yi Luan, Sébastien M. R. Arnold, Vincent Perot, Siddharth Dalmia, Hexiang Hu, Xudong Lin, Panupong Pasupat, Aida Amini, Jeremy R. Cole, Sebastian Riedel, Iftekhar Naim, Ming-Wei Chang, Kelvin Guu. Arxiv 2024.
-
LONG2RAG: Evaluating Long-Context & Long-Form Retrieval-Augmented Generation with Key Point Recall. Qi, Zehan and Xu, Rongwu and Guo, Zhijiang and Wang, Cunxiang and Zhang, Hao and Xu, Wei. ACL 2024.
-
Longbench: A bilingual, multitask benchmark for long context understanding. Bai, Yushi and Lv, Xin and Zhang, Jiajie and Lyu, Hongchang and Tang, Jiankai and Huang, Zhidian and Du, Zhengxiao and Liu, Xiao and Zeng, Aohan and Hou, Lei and others. ACL 2024.
-
LongBench v2: Towards Deeper Understanding and Reasoning on Realistic Long-context Multitasks. Yushi Bai, Shangqing Tu, Jiajie Zhang, Hao Peng, Xiaozhi Wang, Xin Lv, Shulin Cao, Jiazheng Xu, Lei Hou, Yuxiao Dong, Jie Tang, Juanzi Li. Arxiv 2024.
-
Longcite: Enabling llms to generate fine-grained citations in long-context qa. Zhang, Jiajie and Bai, Yushi and Lv, Xin and Gu, Wanjun and Liu, Danqing and Zou, Minhao and Cao, Shulin and Hou, Lei and Dong, Yuxiao and Feng, Ling and others. Arxiv 2024.
-
Long-context llms struggle with long in-context learning. Li, Tianle and Zhang, Ge and Do, Quy Duc and Yue, Xiang and Chen, Wenhu. TMLR.
-
LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. Di Wu, Hongwei Wang, Wenhao Yu, Yuwei Zhang, Kai-Wei Chang, Dong Yu. Arxiv 2024.
-
Leave no document behind: Benchmarking long-context llms with extended multi-doc qa. Wang, Minzheng and Chen, Longze and Cheng, Fu and Liao, Shengyi and Zhang, Xinghua and Wu, Bingli and Yu, Haiyang and Xu, Nan and Zhang, Lei and Luo, Run and others. EMNLP 2024.
-
LooGLE: Can Long-Context Language Models Understand Long Contexts?. Li, Jiaqi and Wang, Mengmeng and Zheng, Zilong and Zhang, Muhan. ACL 2024.
-
LV-Eval: A Balanced Long-Context Benchmark with 5 Length Levels Up to 256K. Tao Yuan, Xuefei Ning, Dong Zhou, Zhijie Yang, Shiyao Li, Minghui Zhuang, Zheyue Tan, Zhuyu Yao, Dahua Lin, Boxun Li, Guohao Dai, Shengen Yan, Yu Wang. Arxiv 2024.
-
Retrieval or Global Context Understanding? On Many-Shot In-Context Learning for Long-Context Evaluation. Kaijian Zou, Muhammad Khalifa, Lu Wang. Arxiv 2024.
-
Marathon: A race through the realm of long context with large language models. Zhang, Lei and Li, Yunshui and Liu, Ziqiang and Liu, Junhao and Chen, Longze and Luo, Run and Yang, Min and others. ACL 2024.
-
One Thousand and One Pairs: A "novel" challenge for long-context language models. Marzena Karpinska, Katherine Thai, Kyle Lo, Tanya Goyal, Mohit Iyyer. Arxiv 2024.
-
Analyzing Temporal Complex Events with Large Language Models? A Benchmark towards Temporal, Long Context Understanding. Zhihan Zhang, Yixin Cao, Chenchen Ye, Yunshan Ma, Lizi Liao, Tat-Seng Chua. Arxiv 2024.
-
Zeroscrolls: A zero-shot benchmark for long text understanding. Shaham, Uri and Ivgi, Maor and Efrat, Avia and Berant, Jonathan and Levy, Omer. EMNLP 2023.
-
DocFinQA: {A} Long-Context Financial Reasoning Dataset. Varshini Reddy, Rik Koncel{-}Kedziorski, Viet Dac Lai, Michael Krumdick, Charles Lovering, Chris Tanner. ACL 2024
-
FinTextQA: A Dataset for Long-form Financial Question Answering. Jian Chen, Peilin Zhou, Yining Hua, Yingxin Loh, Kehui Chen, Ziyuan Li, Bing Zhu, Junwei Liang. Arxiv 2024.
-
Long Code Arena: a Set of Benchmarks for Long-Context Code Models. Bogomolov, Egor and Eliseeva, Aleksandra and Galimzyanov, Timur and Glukhov, Evgeniy and Shapkin, Anton and Tigina, Maria and Golubev, Yaroslav and Kovrigin, Alexander and van Deursen, Arie and Izadi, Maliheh and others. Arxiv 2024.
-
MedOdyssey: A Medical Domain Benchmark for Long Context Evaluation Up to 200K Tokens. Yongqi Fan, Hongli Sun, Kui Xue, Xiaofan Zhang, Shaoting Zhang, Tong Ruan. Arxiv 2024.
-
Examining Long-Context Large Language Models for Environmental Review Document Comprehension. Phan, Hung and Acharya, Anurag and Meyur, Rounak and Chaturvedi, Sarthak and Sharma, Shivam and Parker, Mike and Nally, Dan and Jannesari, Ali and Pazdernik, Karl and Halappanavar, Mahantesh and others. Arxiv 2024.
-
Train short, test long: Attention with linear biases enables input length extrapolation. Ofir Press and Noah A. Smith and Mike Lewis. Arxiv 2022
-
PoSE: Efficient Context Window Extension of LLMs via Positional Skip-wise Training. Dawei Zhu,Nan Yang,Liang Wang,Yifan Song,Wenhao Wu,Furu Wei,Sujian Li. Arxiv 2023.
-
Landmark Attention: Random-Access Infinite Context Length for Transformers. Amirkeivan Mohtashami, Martin Jaggi Arxiv 2023.
-
NeedleBench: Can LLMs Do Retrieval and Reasoning in 1 Million Context Window?. Mo Li, Songyang Zhang, Yunxin Liu, Kai Chen. Arxiv 2024.
-
Multi-News: A Large-Scale Multi-Document Summarization Dataset and Abstractive Hierarchical Model. Fabbri, Alexander Richard and Li, Irene and She, Tianwei and Li, Suyi and Radev, Dragomir. ACL 2019.
-
Ms marco: A human-generated machine reading comprehension dataset. Nguyen, Tri and Rosenberg, Mir and Song, Xia and Gao, Jianfeng and Tiwary, Saurabh and Majumder, Rangan and Deng, Li. Arxiv 2016.
-
U-NIAH: Unified RAG and LLM Evaluation for Long Context Needle-In-A-Haystack. Yunfan Gao, Yun Xiong, Wenlong Wu, Zijing Huang, Bohan Li, Haofen WangYunfan Gao, Yun Xiong, Wenlong Wu, Zijing Huang, Bohan Li, Haofen Wang. Arxiv 2025.
-
L2M: Mutual Information Scaling Law for Long-Context Language Modeling. Zhuo Chen, Oriol Mayné i Comas, Zhuotao Jin, Di Luo, Marin Soljačić. Arxiv 2025.
-
MMLongBench: Benchmarking Long-Context Vision-Language Models Effectively and Thoroughly. Zhaowei Wang, Wenhao Yu, Xiyu Ren, Jipeng Zhang, Yu Zhao, Rohit Saxena, Liang Cheng, Ginny Wong, Simon See, Pasquale Minervini, Yangqiu Song, Mark Steedman. Arxiv 2025.
-
VideoZeroBench: Probing the Limits of Video MLLMs with Spatio-Temporal Evidence Verification. Jiahao Meng, Tan Yue, Qi Xu, Haochen Wang, Zhongwei Ren, Weisong Liu, Yuhao Wang, Renrui Zhang, Yunhai Tong, Haodong Duan. Arxiv 2026.
-
MemLens: Benchmarking Multimodal Long-Term Memory in Large Vision-Language Models. Xiyu Ren, Zhaowei Wang, Yiming Du, Zhongwei Xie, Chi Liu, Xinlin Yang, Haoyue Feng, Wenjun Pan, Tianshi Zheng, Baixuan Xu, Zhengnan Li, Yangqiu Song, Ginny Wong, Simon See. Arxiv 2026.
-
GroupMemBench: Benchmarking LLM Agent Memory in Multi-Party Conversations. Jingbo Yang, Kwei-Herng Lai, Xiaowen Wang, Shiyu Chang, Yaar Harari, Evgeniy Gabrilovich. Arxiv 2026.
-
MemEye: A Visual-Centric Evaluation Framework for Multimodal Agent Memory. Minghao Guo, Qingyue Jiao, Zeru Shi, Yihao Quan, Boxuan Zhang, Danrui Li, Liwei Che, Wujiang Xu, Shilong Liu, Zirui Liu, Mubbasir Kapadia, Vladimir Pavlovic, Jiang Liu, Mengdi Wang, Yiyu Shi, Dimitris N. Metaxas, Ruixiang Tang. Arxiv 2026.
-
Beyond Accuracy: Evaluating Grounded Visual Evidence in Thinking with Images (ViEBench). Xuchen Li, Xuzhao Li, Renjie Pi, Shiyu Hu, Jian Zhao, Jiahui Gao. Arxiv 2026.
-
StreamingEval: A Unified Evaluation Framework for Streaming Video Understanding. Guowei Tang, Tianwen Qian, Huanran Zheng, Yifei Wang, Xiaoling Wang. Arxiv 2026.
-
KVDiagnosis: A Diagnostic Benchmark for KV-Cache Compression in Long-Context Language Models. Chen Qiu, Ziwu Liu, Chao Fei, Guozhong Li, Panos Kalnis. Arxiv 2026.
-
Distractor-Aware Truncation: Disentangling Context-Length Effects from Signal Loss in Long-Context LLM Benchmarks. Mohsen Arjmandi. Arxiv 2026.
-
Cracks in the Foundation: Seemingly Minor Architectural Choices Impact Long Context Extension. Amanda Bertsch, Luca Soldaini, Matthew R. Gormley, Graham Neubig, Hannaneh Hajishirzi, Kyle Lo, Dirk Groeneveld. COLM 2026.
-
Information Abundance Paradox: Long-Context Training Undermines Parametric Knowledge. Arda Uzunoglu, Benjamin Van Durme, Daniel Khashabi. Arxiv 2026.
Long-Form Generation
-
ELI5: Long form question answering. Fan, Angela and Jernite, Yacine and Perez, Ethan and Grangier, David and Weston, Jason and Auli, Michael. Arxiv 2019.
-
Ms marco: A human-generated machine reading comprehension dataset. Nguyen, Tri and Rosenberg, Mir and Song, Xia and Gao, Jianfeng and Tiwary, Saurabh and Majumder, Rangan and Deng, Li. Arxiv 2016.
-
Expertqa: Expert-curated questions and attributed answers. Malaviya, Chaitanya and Lee, Subin and Chen, Sihao and Sieber, Elizabeth and Yatskar, Mark and Roth, Dan. NAACL 2024.
-
Proxyqa: An alternative framework for evaluating long-form text generation with large language models. Tan, Haochen and Guo, Zhijiang and Shi, Zhan and Xu, Lu and Liu, Zhili and Feng, Yunlong and Li, Xiaoguang and Wang, Yasheng and Shang, Lifeng and Liu, Qun and others. ACL 2024
-
LongGenBench: Long-context Generation Benchmark. Xiang Liu, Peijie Dong, Xuming Hu, Xiaowen Chu. EMNLP 2024.
-
ASQA: Factoid questions meet long-form answers. Stelmakh, Ivan and Luan, Yi and Dhingra, Bhuwan and Chang, Ming-Wei. EMNLP 2022.
-
Qasa: advanced question answering on scientific articles. Lee, Yoonjoo and Lee, Kyungjae and Park, Sunghyun and Hwang, Dasol and Kim, Jaehyeon and Lee, Hong-in and Lee, Moontae. PMLR 2023.
-
CLAPNQ: Cohesive Long-form Answers from Passages in Natural Questions for RAG systems. Sara Rosenthal, Avirup Sil, Radu Florian, Salim Roukos. Arxiv 2024.
-
LONG2RAG: Evaluating Long-Context & Long-Form Retrieval-Augmented Generation with Key Point Recall. Qi, Zehan and Xu, Rongwu and Guo, Zhijiang and Wang, Cunxiang and Zhang, Hao and Xu, Wei. ACL 2024.
-
A Benchmark for Long-Form Medical Question Answering. Pedram Hosseini, Jessica M. Sin, Bing Ren, Bryceton G. Thomas, Elnaz Nouri, Ali Farahanchi, Saeed Hassanpour. NeurIPS 2024.
-
OLAPH: Improving Factuality in Biomedical Long-form Question Answering. Minbyul Jeong, Hyeon Hwang, Chanwoong Yoon, Taewhoo Lee, Jaewoo Kang. Arxiv 2024.
-
Factscore: Fine-grained atomic evaluation of factual precision in long form text generation. Min, Sewon and Krishna, Kalpesh and Lyu, Xinxi and Lewis, Mike and Yih, Wen-tau and Koh, Pang Wei and Iyyer, Mohit and Zettlemoyer, Luke and Hajishirzi, Hannaneh. EMNLP 2023.
-
Long-form factuality in large language models. Jerry Wei, Chengrun Yang, Xinying Song, Yifeng Lu, Nathan Hu, Dustin Tran, Daiyi Peng, Ruibo Liu, Da Huang, Cosmo Du, Quoc V. Le. Arxiv 2024.
-
Large Language Models Still Exhibit Bias in Long Text. Wonje Jeung, Dongjae Jeon, Ashkan Yousefpour, Jonghyun Choi. Arxiv 2024.
-
Aquamuse: Automatically generating datasets for query-based multi-document summarization. Kulkarni, Sayali and Chammas, Sheide and Zhu, Wan and Sha, Fei and Ie, Eugene. Arxiv 2020.
-
Multi-News: A Large-Scale Multi-Document Summarization Dataset and Abstractive Hierarchical Model. Fabbri, Alexander Richard and Li, Irene and She, Tianwei and Li, Suyi and Radev, Dragomir. ACL 2019.
-
LCFO: Long Context and Long Form Output Dataset and Benchmarking. Marta R. Costa-jussà, Pierre Andrews, Mariano Coria Meglioli, Joy Chen, Joe Chuang, David Dale, Christophe Ropers, Alexandre Mourachko, Eduardo Sánchez, Holger Schwenk, Tuan Tran, Arina Turkatenko, Carleigh Wood. Arxiv 2024.
-
LongForm: Effective Instruction Tuning with Reverse Instructions. Koksal, Abdullatif and Schick, Timo and Korhonen, Anna and Schutze, Hinrich. EMNLP 2024.
-
Suri: Multi-constraint Instruction Following for Long-form Text Generation. Chau Minh Pham, Simeng Sun, Mohit Iyyer. EMNLP 2024.
-
LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs. Yushi Bai, Jiajie Zhang, Xin Lv, Linzhi Zheng, Siqi Zhu, Lei Hou, Yuxiao Dong, Jie Tang, Juanzi Li. Arxiv 2024.
-
Language Models can Self-Lengthen to Generate Long Texts. Shanghaoran Quan, Tianyi Tang, Bowen Yu, An Yang, Dayiheng Liu, Bofei Gao, Jianhong Tu, Yichang Zhang, Jingren Zhou, Junyang Lin. Arxiv 2024.
-
LOT: A story-centric benchmark for evaluating Chinese long text understanding and generation. Guan, Jian and Feng, Zhuoer and Chen, Yamei and He, Ruilin and Mao, Xiaoxi and Fan, Changjie and Huang, Minlie. TACL 2022.
-
Longlamp: A benchmark for personalized long-form text generation. Kumar, Ishita and Viswanathan, Snigdha and Yerra, Sushrita and Salemi, Alireza and Rossi, Ryan A and Dernoncourt, Franck and Deilamsalehy, Hanieh and Chen, Xiang and Zhang, Ruiyi and Agarwal, Shubham and others. Arxiv 2o24.
-
DOLOMITES: Domain-Specific Long-Form Methodical Tasks. Chaitanya Malaviya, Priyanka Agrawal, Kuzman Ganchev, Pranesh Srinivasan, Fantine Huot, Jonathan Berant, Mark Yatskar, Dipanjan Das, Mirella Lapata, Chris Alberti. Arxiv 2024.
-
LongGenBench: Benchmarking Long-Form Generation in Long Context LLMs. Yuhao Wu, Ming Shan Hee, Zhiqing Hu, Roy Ka-Wei Lee. Arxiv 2024.
-
LongProc: Benchmarking Long-Context Language Models on Long Procedural Generation. Xi Ye, Fangcong Yin, Yinghui He, Joie Zhang, Howard Yen, Tianyu Gao, Greg Durrett, Danqi Chen. Arxiv 2025.
-
Hellobench: Evaluating long text generation capabilities of large language models. Que, Haoran and Duan, Feiyu and He, Liqun and Mou, Yutao and Zhou, Wangchunshu and Liu, Jiaheng and Rong, Wenge and Wang, Zekun Moore and Yang, Jian and Zhang, Ge and others. Arxiv 2024.
-
The FACTS Grounding Leaderboard: Benchmarking LLMs' Ability to Ground Responses to Long-Form Input. Alon Jacovi, Andrew Wang, Chris Alberti, Connie Tao, Jon Lipovetz, Kate Olszewska, Lukas Haas, Michelle Liu, Nate Keating, Adam Bloniarz, Carl Saroufim, Corey Fry, Dror Marcus, Doron Kukliansky, Gaurav Singh Tomar, James Swirhun, Jinwei Xing, Lily Wang, Madhu Gurumurthy, Michael Aaron, Moran Ambar, Rachana Fellinger, Rui Wang, Zizhao Zhang, Sasha Goldshtein, Dipanjan Das. Arxiv 2025.
-
RAPID: Efficient Retrieval-Augmented Long Text Generation with Writing Planning and Information Discovery. Hongchao Gu, Dexun Li, Kuicai Dong, Hao Zhang, Hang Lv, Hao Wang, Defu Lian, Yong Liu, Enhong Chen. Arxiv 2025.
-
[DeFine: A Decomposed and Fine-Grained Annotated Dataset for Long-form Article Generation.](https://arxiv.org/abs
Truncated — view the full README on GitHub.