通过收集数据去训练下游的中医文本NER标注模型,在上游使用了Bert作为特征提取器,减少了下游模型的数据需求。
Python
5
20 commits
updated Sep 24, 2026
面向中医药古籍文献的高性能命名实体抽取模型(Named Entity Recognition for Ancient TCM Texts)




中医药古籍文献凝结了中华民族千百年来的医疗防病经验与理论精华。随着数字人文(Digital Humanities)与中医药信息学研究的深入推进,如何从海量非结构化的古籍医案与典籍文献中实现精准实体识别与知识抽取,已成为构建中医药知识图谱、支撑辅助诊疗推演的关键技术底座。
然而,中医古籍文本具有字句精炼晦涩、文白词义演变显著、专有名词偏长、实体嵌套重叠以及篇章强话题性等鲜明特点。传统基于 BIO/BMES 标签序列与条件随机场(CRF)的标注方案在面对长跨度实体、重叠实体及模糊边界时往往受限于标签转移约束与解码瓶颈。
针对上述挑战,TCM-NER 采用专为古代文言文预训练的古汉语语言模型(GuwenBERT)作为深层语义编码器,融合**双向指针网络(Pointer Network)**设计,提出实体边界“半指针-半标注”预测架构:
ethanyt/guwenbert-base 模型,显著强化对古籍通假字、古今异义词及医籍专有术语的表征能力。本项目构建的中医古籍文本标注语料库,聚焦临床诊疗与理论推演的核心要素:
| 实体类别 | 英文标识 | 类别描述 | 古籍文本示例 |
|---|---|---|---|
| 中药名称 | DRUG | 单味中药材、饮片名、炮制品 | 白术、黄连、陈皮、青葱、生姜、砂糖、鹿首根 |
| 方剂名称 | FORMULA | 经方、时方、成方及临床经验方 | 平胃散、牛黄清心凉膈丸、活幼方 |
| 身体部位 | BODY | 人体脏腑、经络、官窍及解剖部位 | 心、舌、胃肠、肺、大肠、两颊 |
| 年龄特征 | AGE | 患者就诊时的年龄或时序生理特征 | 七十、小儿、壮年 |
语料采用专业开源标注平台 Doccano 进行多阶段协同标注与质检清洗,代表性标注场景如下:
脏腑与官窍部位标注场景:

示例:“心者,在天为热,在地为火,在人为心【身体部位】,在时为夏……通窍于舌【身体部位】。”
方剂与病案处置标注场景:
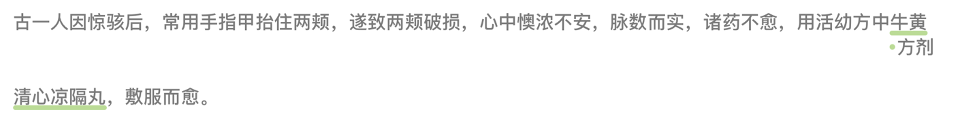
示例:“诸药不愈,用活幼方中牛黄清心凉膈丸【方剂】,敷服而愈。”
在实际文本挖掘与标注研究中,中医古籍呈现出以下深具挑战性的语言学与领域特性:
篇章高度话题性(Topical Discourse Cohesion)
古籍医案通常以特定病案或证候为核心展开系统论述,行文具备天然的话题聚合性。医家通常先记录患者主诉、体征脉象,随后展开辨证推演与病机论述,最终确立治则治法与遣药组方。在局部篇章中,证候词汇与方药实体高度共现并紧密关联。
中医理论与现代医学的概念异构(Domain Semantic Discrepancy)
中医术语体系根植于传统哲理与动态辨证观,与现代病理学词义存在深层差异:
本项目整体结构由文言预训练编码层与双指针分类解码层两部分构成:
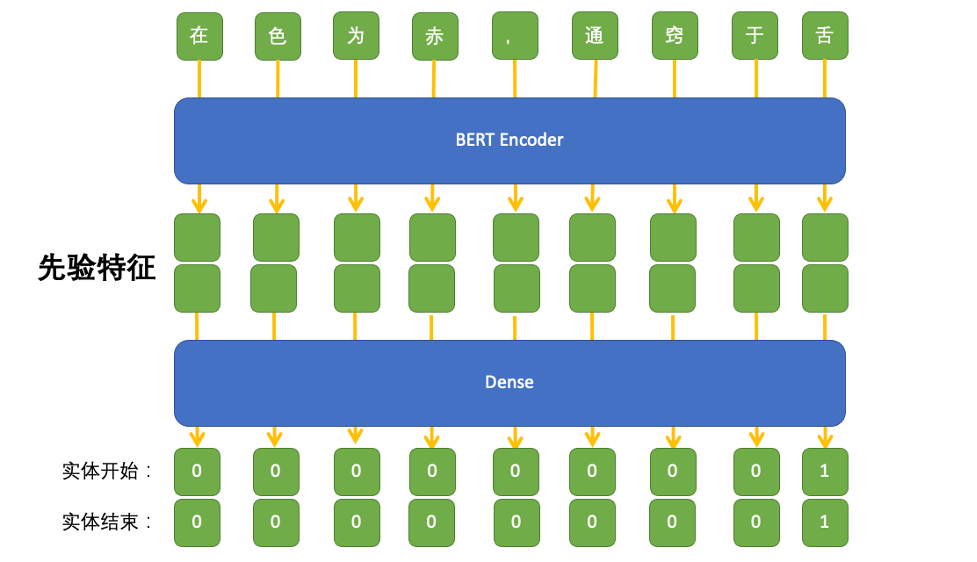
对于输入的文言字序列 $X = (x_1, x_2, \dots, x_n)$,经由古汉语预训练语言模型(Transformer 架构)提取深层上下文双向表征: $$H = \text{GuwenBERT}(X) \in \mathbb{R}^{n \times d}$$ 其中 $d = 768$ 为模型隐藏层维度。
为了有效预测任意长度实体的边界并支持重叠抽取,模型设计了起始位置与终止位置两个平行的分类头:
在推理阶段,通过预设置信度阈值(如 $P_{start} \ge 0.7, P_{end} \ge 0.6$)分别筛选出合法的起始索引集 $\mathcal{S}$ 与终止索引集 $\mathcal{E}$。针对每一个起始索引 $i \in \mathcal{S}$,在终止候选集 $\mathcal{E}$ 中检索满足 $j \ge i$ 的终止边界,并截取对应的文本片段 $[i, j]$ 作为候选实体输出。
模型采用双路多标签二值交叉熵(Binary Cross-Entropy Loss)联合优化: $$\mathcal{L} = \frac{1}{2} \left( \mathcal{L}{BCE}(P{start}, Y_{start}) + \mathcal{L}{BCE}(P{end}, Y_{end}) \right)$$
.
├── DataFormat/                  # 数据处理工具与格式转换脚本
│   ├── Format.py                # 文本清洗与格式预处理
│   ├── NER_Format.py            # Doccano 原始标注转换为模型标准格式
│   └── Split_File.py            # 数据集切分脚本
├── data/                        # 数据集存放目录
│   └── 4-3.zip                  # 原始标注压缩数据
├── img/                         # 架构图与说明配图
│   ├── Picture1.png             # 实体标注示例图 1(身体部位)
│   ├── Picture2.png             # 实体标注示例图 2(方剂)
│   ├── Picture3.png             # 模型架构原理图
│   └── loge-1.png               # 项目 Logo 标志
├── dataloder.py                 # 数据加载器与动态 Padding 模块
├── main.py                      # 模型构建、训练循环与综合评估主入口
├── test_Modules.py              # 辅助组件测试脚本
├── test_generator.py            # 数据生成器测试脚本
├── Example of data labeling.txt # 详细的数据标注样例集合
├── README.md                    # 中文说明文档
└── README_EN.md                 # 英文说明文档 (English Documentation)
推荐使用 Python 3.8+ 及 CUDA 11.0+ 环境:
git clone https://github.com/KuoChing-cmd/ZhongYi-NER2.git
cd ZhongYi-NER2
pip install torch torchvision transformers numpy tqdm
模型依托古汉语文言文预训练模型 ethanyt/guwenbert-base。可在项目根目录下创建 guwenbert-base 文件夹并下载权重,或直接通过 HuggingFace Hub 加载:
# 从 HuggingFace Hub 下载预训练权重(可选)
git lfs install
git clone https://huggingface.co/ethanyt/guwenbert-base
本项目标准输入格式为包含 text 和 ner 列表的 JSON 结构,样例文件可见 Example of data labeling.txt:
[
  {
    "text": "族叔祖年七十,禀甚壮,形甚瘦。夏末患泄利至深秋,百方不应……以荣萸、陈皮、青葱、鹿首根、生姜煎浓汤,和以砂糖,饮一碗许……又与平胃散加白术、黄连,旬日而安。",
    "ner": [
      "七十",
      "胃肠",
      "肺",
      "大肠",
      "陈皮",
      "青葱",
      "生姜",
      "砂糖",
      "平胃散",
      "白术",
      "黄连"
    ]
  }
]
若使用 Doccano 导出的原始标注数据,可运行转换脚本进行一键清洗格式化:
python DataFormat/NER_Format.py
执行主训练程序:
python main.py
训练过程将基于分布式训练架构进行前向传播与反向优化,并在验证集上自动评测,保存效果最佳的模型权重文件 NER_best.pth。
模型训练完成后,可运行如下推理函数进行古籍文本实体识别:
import torch
import numpy as np
from transformers import BertTokenizer

# 初始化 Tokenizer 与加载模型
tokenizer = BertTokenizer.from_pretrained("ethanyt/guwenbert-base")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = torch.load("NER_best.pth", map_location=device)
model.eval()

def extract_entities(text: str, start_threshold=0.7, end_threshold=0.6):
    token_ids = tokenizer.encode(text)
    inputs = torch.as_tensor([token_ids], device=device)

    with torch.no_grad():
        pn1, pn2 = model(inputs)
        pn1 = pn1.squeeze(0).squeeze(-1).cpu().numpy()
        pn2 = pn2.squeeze(0).squeeze(-1).cpu().numpy()

    start_indices = np.where(pn1 > start_threshold)[0]
    end_indices = np.where(pn2 > end_threshold)[0]

    entities = set()
    for s in start_indices:
        e_candidates = end_indices[end_indices >= s]
        for e in e_candidates:
            span = text[s:e]
            if span:
                entities.add(span)
    return entities

# 示例验证
sample_text = "心者,在天为热,在地为火,在人为心,在时为夏,在方为志,在色为赤,通窍于舌。"
print("抽取结果:", extract_entities(sample_text))
主评估脚本在验证集上自动计算标准的序列抽取评测指标(Precision、Recall 及 F1-Score):
$$Precision = \frac{|R \cap T|}{|R|}, \quad Recall = \frac{|R \cap T|}{|T|}, \quad F1 = \frac{2 \times Precision \times Recall}{Precision + Recall}$$
其中 $R$ 为模型预测实体集合,$T$ 为真实标注实体集合。评估详情将保存于 ./data/eval.csv,记录内容包括:
text:原始古籍医案文本ner_list:真实标准实体列表ner_list_pred:模型预测抽取的实体列表new:模型预测但未在标注中的新增实体(用于挖掘潜在漏标)lack:人工标注但模型遗漏的实体(用于分析难点案例)本项目基于 MIT License 许可协议开源。
通过收集数据去训练下游的中医文本NER标注模型,在上游使用了Bert作为特征提取器,减少了下游模型的数据需求。
Python
5
20 commits
updated Sep 24, 2026
面向中医药古籍文献的高性能命名实体抽取模型(Named Entity Recognition for Ancient TCM Texts)
中医药古籍文献凝结了中华民族千百年来的医疗防病经验与理论精华。随着数字人文(Digital Humanities)与中医药信息学研究的深入推进,如何从海量非结构化的古籍医案与典籍文献中实现精准实体识别与知识抽取,已成为构建中医药知识图谱、支撑辅助诊疗推演的关键技术底座。
然而,中医古籍文本具有字句精炼晦涩、文白词义演变显著、专有名词偏长、实体嵌套重叠以及篇章强话题性等鲜明特点。传统基于 BIO/BMES 标签序列与条件随机场(CRF)的标注方案在面对长跨度实体、重叠实体及模糊边界时往往受限于标签转移约束与解码瓶颈。
针对上述挑战,TCM-NER 采用专为古代文言文预训练的古汉语语言模型(GuwenBERT)作为深层语义编码器,融合**双向指针网络(Pointer Network)**设计,提出实体边界“半指针-半标注”预测架构:
ethanyt/guwenbert-base 模型,显著强化对古籍通假字、古今异义词及医籍专有术语的表征能力。本项目构建的中医古籍文本标注语料库,聚焦临床诊疗与理论推演的核心要素:
| 实体类别 | 英文标识 | 类别描述 | 古籍文本示例 |
|---|---|---|---|
| 中药名称 | DRUG | 单味中药材、饮片名、炮制品 | 白术、黄连、陈皮、青葱、生姜、砂糖、鹿首根 |
| 方剂名称 | FORMULA | 经方、时方、成方及临床经验方 | 平胃散、牛黄清心凉膈丸、活幼方 |
| 身体部位 | BODY | 人体脏腑、经络、官窍及解剖部位 | 心、舌、胃肠、肺、大肠、两颊 |
| 年龄特征 | AGE | 患者就诊时的年龄或时序生理特征 | 七十、小儿、壮年 |
语料采用专业开源标注平台 Doccano 进行多阶段协同标注与质检清洗,代表性标注场景如下:
脏腑与官窍部位标注场景:
示例:“心者,在天为热,在地为火,在人为心【身体部位】,在时为夏……通窍于舌【身体部位】。”
方剂与病案处置标注场景:
示例:“诸药不愈,用活幼方中牛黄清心凉膈丸【方剂】,敷服而愈。”
在实际文本挖掘与标注研究中,中医古籍呈现出以下深具挑战性的语言学与领域特性:
篇章高度话题性(Topical Discourse Cohesion)
古籍医案通常以特定病案或证候为核心展开系统论述,行文具备天然的话题聚合性。医家通常先记录患者主诉、体征脉象,随后展开辨证推演与病机论述,最终确立治则治法与遣药组方。在局部篇章中,证候词汇与方药实体高度共现并紧密关联。
中医理论与现代医学的概念异构(Domain Semantic Discrepancy)
中医术语体系根植于传统哲理与动态辨证观,与现代病理学词义存在深层差异:
本项目整体结构由文言预训练编码层与双指针分类解码层两部分构成:
对于输入的文言字序列 $X = (x_1, x_2, \dots, x_n)$,经由古汉语预训练语言模型(Transformer 架构)提取深层上下文双向表征: $$H = \text{GuwenBERT}(X) \in \mathbb{R}^{n \times d}$$ 其中 $d = 768$ 为模型隐藏层维度。
为了有效预测任意长度实体的边界并支持重叠抽取,模型设计了起始位置与终止位置两个平行的分类头:
在推理阶段,通过预设置信度阈值(如 $P_{start} \ge 0.7, P_{end} \ge 0.6$)分别筛选出合法的起始索引集 $\mathcal{S}$ 与终止索引集 $\mathcal{E}$。针对每一个起始索引 $i \in \mathcal{S}$,在终止候选集 $\mathcal{E}$ 中检索满足 $j \ge i$ 的终止边界,并截取对应的文本片段 $[i, j]$ 作为候选实体输出。
模型采用双路多标签二值交叉熵(Binary Cross-Entropy Loss)联合优化: $$\mathcal{L} = \frac{1}{2} \left( \mathcal{L}{BCE}(P{start}, Y_{start}) + \mathcal{L}{BCE}(P{end}, Y_{end}) \right)$$
.
├── DataFormat/                  # 数据处理工具与格式转换脚本
│   ├── Format.py                # 文本清洗与格式预处理
│   ├── NER_Format.py            # Doccano 原始标注转换为模型标准格式
│   └── Split_File.py            # 数据集切分脚本
├── data/                        # 数据集存放目录
│   └── 4-3.zip                  # 原始标注压缩数据
├── img/                         # 架构图与说明配图
│   ├── Picture1.png             # 实体标注示例图 1(身体部位)
│   ├── Picture2.png             # 实体标注示例图 2(方剂)
│   ├── Picture3.png             # 模型架构原理图
│   └── loge-1.png               # 项目 Logo 标志
├── dataloder.py                 # 数据加载器与动态 Padding 模块
├── main.py                      # 模型构建、训练循环与综合评估主入口
├── test_Modules.py              # 辅助组件测试脚本
├── test_generator.py            # 数据生成器测试脚本
├── Example of data labeling.txt # 详细的数据标注样例集合
├── README.md                    # 中文说明文档
└── README_EN.md                 # 英文说明文档 (English Documentation)
推荐使用 Python 3.8+ 及 CUDA 11.0+ 环境:
git clone https://github.com/KuoChing-cmd/ZhongYi-NER2.git
cd ZhongYi-NER2
pip install torch torchvision transformers numpy tqdm
模型依托古汉语文言文预训练模型 ethanyt/guwenbert-base。可在项目根目录下创建 guwenbert-base 文件夹并下载权重,或直接通过 HuggingFace Hub 加载:
# 从 HuggingFace Hub 下载预训练权重(可选)
git lfs install
git clone https://huggingface.co/ethanyt/guwenbert-base
本项目标准输入格式为包含 text 和 ner 列表的 JSON 结构,样例文件可见 Example of data labeling.txt:
[
  {
    "text": "族叔祖年七十,禀甚壮,形甚瘦。夏末患泄利至深秋,百方不应……以荣萸、陈皮、青葱、鹿首根、生姜煎浓汤,和以砂糖,饮一碗许……又与平胃散加白术、黄连,旬日而安。",
    "ner": [
      "七十",
      "胃肠",
      "肺",
      "大肠",
      "陈皮",
      "青葱",
      "生姜",
      "砂糖",
      "平胃散",
      "白术",
      "黄连"
    ]
  }
]
若使用 Doccano 导出的原始标注数据,可运行转换脚本进行一键清洗格式化:
python DataFormat/NER_Format.py
执行主训练程序:
python main.py
训练过程将基于分布式训练架构进行前向传播与反向优化,并在验证集上自动评测,保存效果最佳的模型权重文件 NER_best.pth。
模型训练完成后,可运行如下推理函数进行古籍文本实体识别:
import torch
import numpy as np
from transformers import BertTokenizer

# 初始化 Tokenizer 与加载模型
tokenizer = BertTokenizer.from_pretrained("ethanyt/guwenbert-base")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = torch.load("NER_best.pth", map_location=device)
model.eval()

def extract_entities(text: str, start_threshold=0.7, end_threshold=0.6):
    token_ids = tokenizer.encode(text)
    inputs = torch.as_tensor([token_ids], device=device)

    with torch.no_grad():
        pn1, pn2 = model(inputs)
        pn1 = pn1.squeeze(0).squeeze(-1).cpu().numpy()
        pn2 = pn2.squeeze(0).squeeze(-1).cpu().numpy()

    start_indices = np.where(pn1 > start_threshold)[0]
    end_indices = np.where(pn2 > end_threshold)[0]

    entities = set()
    for s in start_indices:
        e_candidates = end_indices[end_indices >= s]
        for e in e_candidates:
            span = text[s:e]
            if span:
                entities.add(span)
    return entities

# 示例验证
sample_text = "心者,在天为热,在地为火,在人为心,在时为夏,在方为志,在色为赤,通窍于舌。"
print("抽取结果:", extract_entities(sample_text))
主评估脚本在验证集上自动计算标准的序列抽取评测指标(Precision、Recall 及 F1-Score):
$$Precision = \frac{|R \cap T|}{|R|}, \quad Recall = \frac{|R \cap T|}{|T|}, \quad F1 = \frac{2 \times Precision \times Recall}{Precision + Recall}$$
其中 $R$ 为模型预测实体集合,$T$ 为真实标注实体集合。评估详情将保存于 ./data/eval.csv,记录内容包括:
text:原始古籍医案文本ner_list:真实标准实体列表ner_list_pred:模型预测抽取的实体列表new:模型预测但未在标注中的新增实体(用于挖掘潜在漏标)lack:人工标注但模型遗漏的实体(用于分析难点案例)本项目基于 MIT License 许可协议开源。