Ce projet s'inscrit dans le cadre du cours "Outils de Traitement de Corpus" du Master 1 Plurital.
Le dataset et le modèle sont tous les deux disponibles sur 🤗Hugging Face : Dataset, Model
Ce projet utilise uv pour la gestion de l'environnement.
Pour exécuter les scripts (assurez-vous d'avoir installé uv):
uv run chemin/vers/le/script.py
L'objectif de ce projet est d'effectuer une classification textuelle sur un corpus de poèmes chinois classiques (à l'exclusion des formes ci(词) et qu(曲)). Le but est de prédire la dynastie (par ordre chronologique : WeiJin 魏晋, NanBei 南北朝, Tang 唐, Song 宋, Yuan 元, Ming 明, Qing 清) à laquelle un poème donné appartient.
Bien que les formes de la poésie chinoise classique soient restées relativement stables après la dynastie Tang, ce projet s'inspire de deux observations principales :
Linguistique : Les caractéristiques linguistiques et l'usage des mots présentent des variations distinctes d'une dynastie à l'autre.
Stylistique et théorie littéraire : En stylistique et selon la théorie littéraire chinoise ancienne, la poésie de chaque dynastie possède un style distinctif, souvent décrit comme un "zeitgeist".
Les données du projet proviennent du site sou-yun.cn, qui n'interdit pas l'extraction de données.
Ce site a déjà classifié les poèmes par dynastie et fournit un index de tous les poèmes par auteur. Par conséquent, le projet utilise request et bs4 pour analyser la structure HTML du site et extraire les données poétiques des sept dynasties sélectionnées. Pour des raisons d'efficacité lors de l'entraînement, le script d'extraction récupère les 20 premiers poèmes de chaque poète (ou le maximum disponible si inférieur à 20) pour les dynasties comptant moins de 1000 poètes, et seulement les 20 premiers poèmes des 1000 premiers poètes pour les dynasties plus prolifiques.
Les données obtenues sont sauvegardées en format .csv, puis fusionnées en un seul grand ensemble de données qui est ensuite mélangé et divisé en trois sous-ensembles : entraînement/validation/test (selon un ratio 7 : 1.5 : 1.5, avec une répartition réelle des données de 17418 : 3733 : 3738). Ces ensembles sont stockés au format dataset de HuggingFace.
| Ensemble de données | Ratio | Quantité réelle |
|---|---|---|
| Entraînement | 7 | 17 418 |
| Validation | 1,5 | 3 733 |
| Test | 1,5 | 3 738 |
| Total | 10 | 24 889 |
La visualisation des données est présentée ci-dessous :
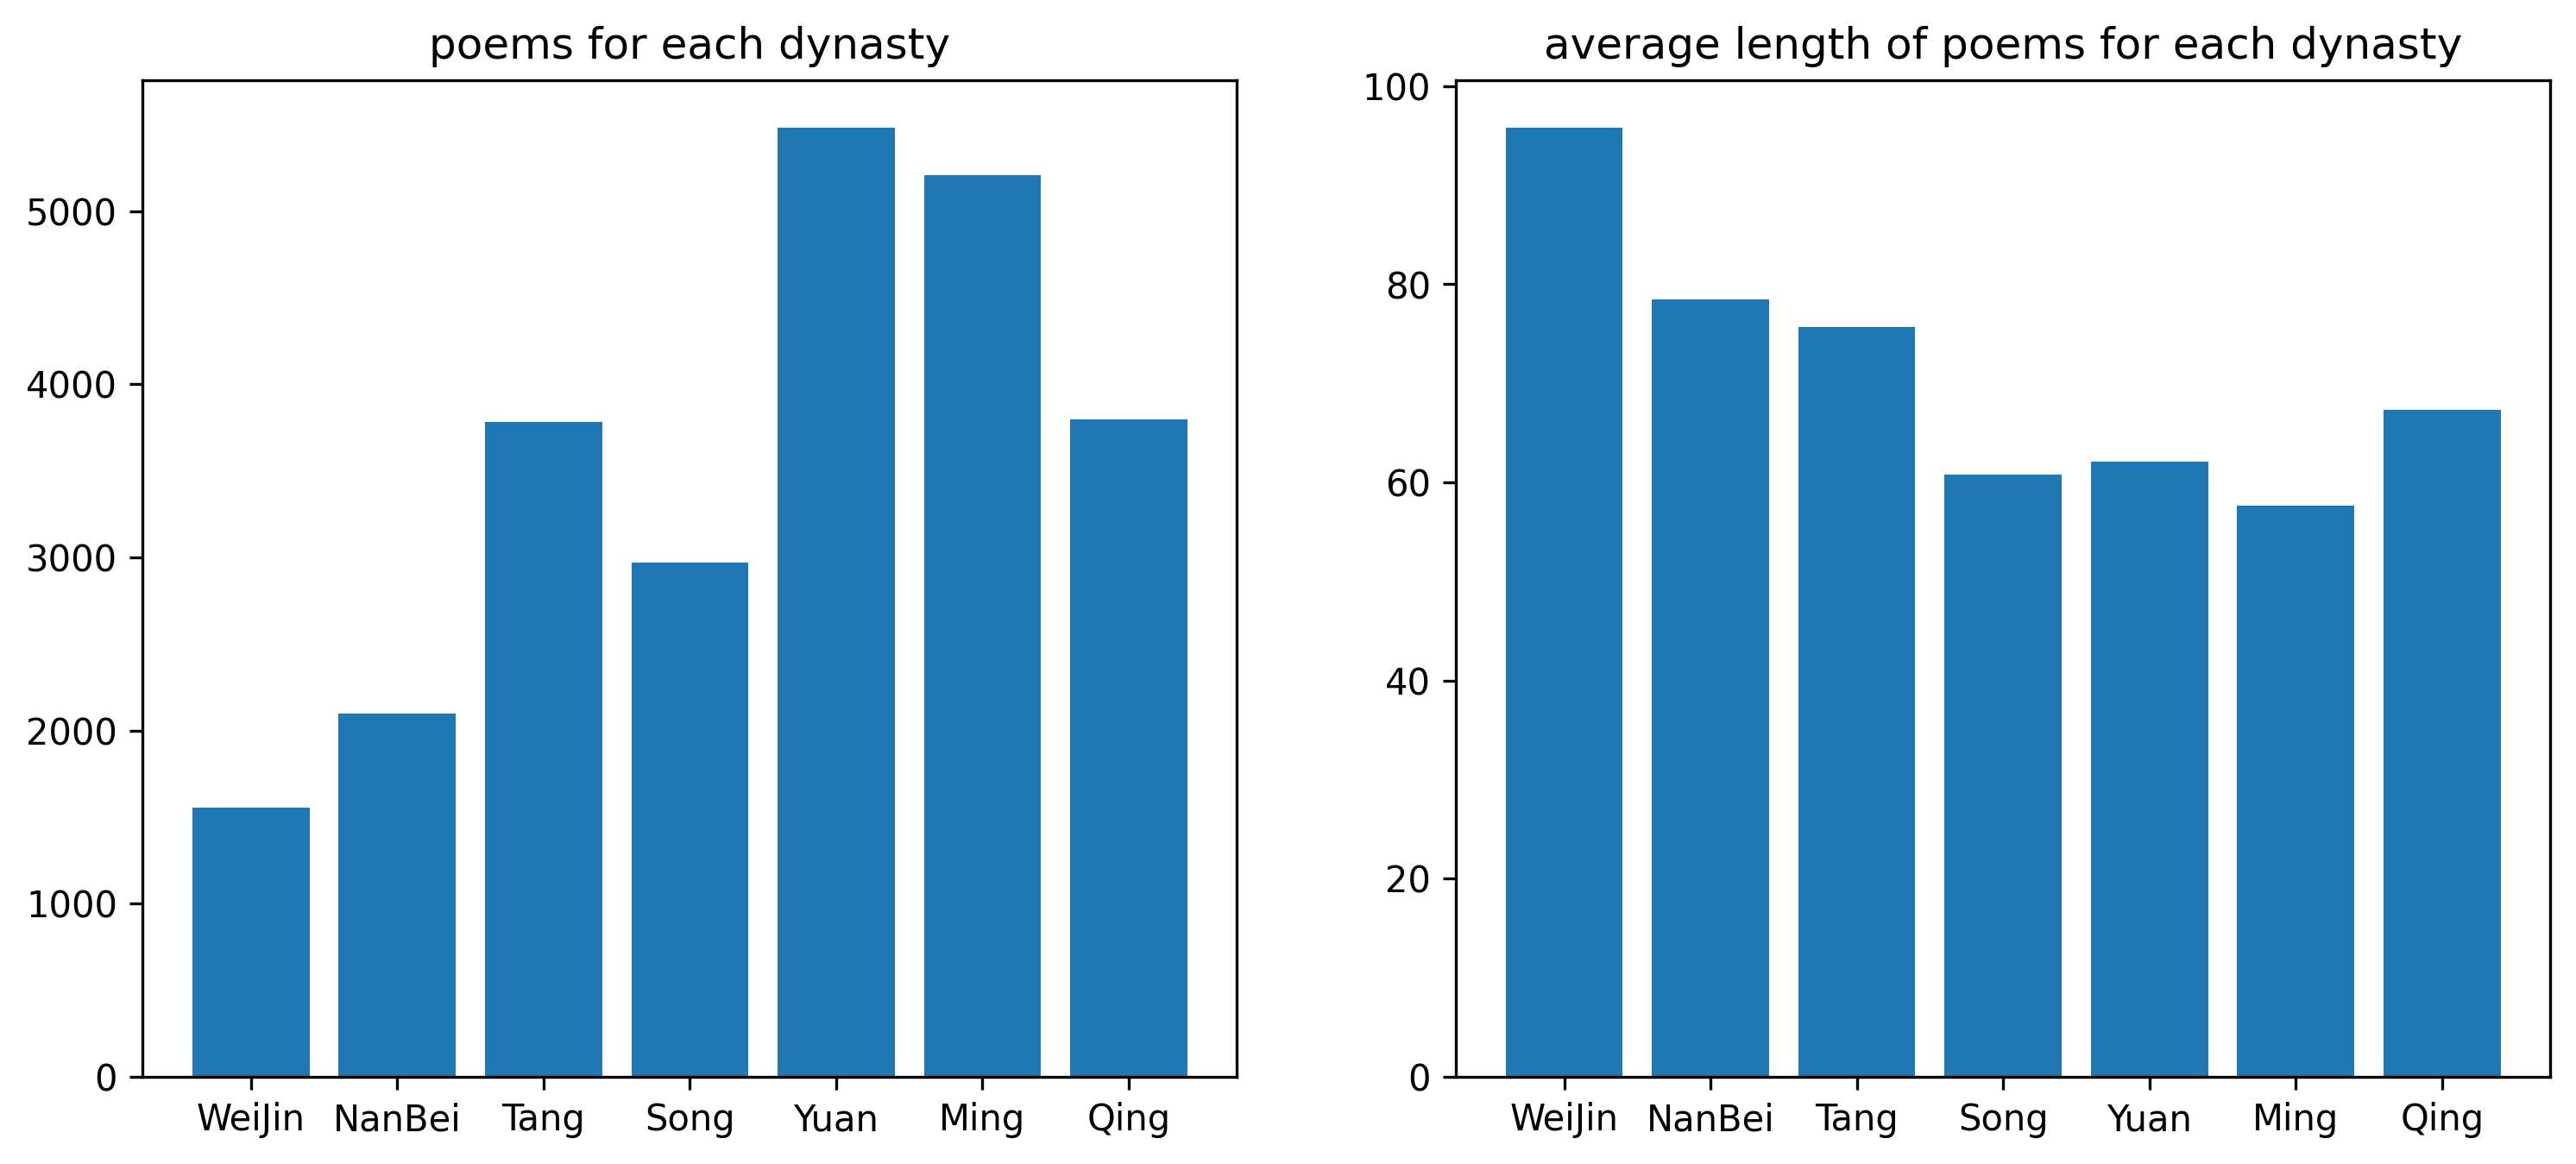
Les deux premières dynasties (Weijin et Nanbei) présentent le plus petit nombre de poèmes, ce qui est logique car ce sont les dynasties les plus anciennes et donc celles dont le moins d'œuvres ont été conservées. La dynastie Weijin montre la longueur moyenne de poèmes la plus élevée, car dans notre corpus, les fu 赋 sont également considérés comme des poèmes. Durant cette période, la création de poèmes en quatre mots et de fu était proportionnellement plus fréquente que dans les six autres dynasties. Ces dernières, particulièrement après la dynastie Tang, privilégiaient les formes poétiques jueju 绝句 (24 ou 32 caractères, ponctuation incluse) et lüshi 律诗 (48 ou 64 caractères). Considérant que les poèmes de style ancien et les "fu" étaient occasionnellement créés et qu'ils sont beaucoup plus longs que les "jueju" et les "lüshi", la longueur moyenne obtenue (60-80 caractères) paraît raisonnable.
Ce projet utilise la HuggingFace Text Classification comme référence pour effectuer le fine-tuning des modèles de classification textuelle.
Le jeu de données a été entraîné sur trois modèles pré-entraînés de type BERT :
distilled-bert-multilingual: un modèle BERT multilingue distillé, permettant un entraînement rapidebert-case-chinese: un modèle BERT pour le chinoisethanyt/guwenbert-base: un modèle basé sur bert-case-chinese ayant déjà été fine-tuné sur un grand corpus de textes chinois classiquesLe nombre d'époques (epoch) du premier modèle est fixé à 3. Afin de réduire le temps d'entraînement, il est fixé à 2 pour les deux autres modèles plus grands. Les autres paramètres restent inchangés.
En analysant les journaux de logs durant l'entraînement, on a obtenu l'évolution de la perte (Loss) par époque (Epoch) et les performances de chaque modèle sur l'ensemble de validation :
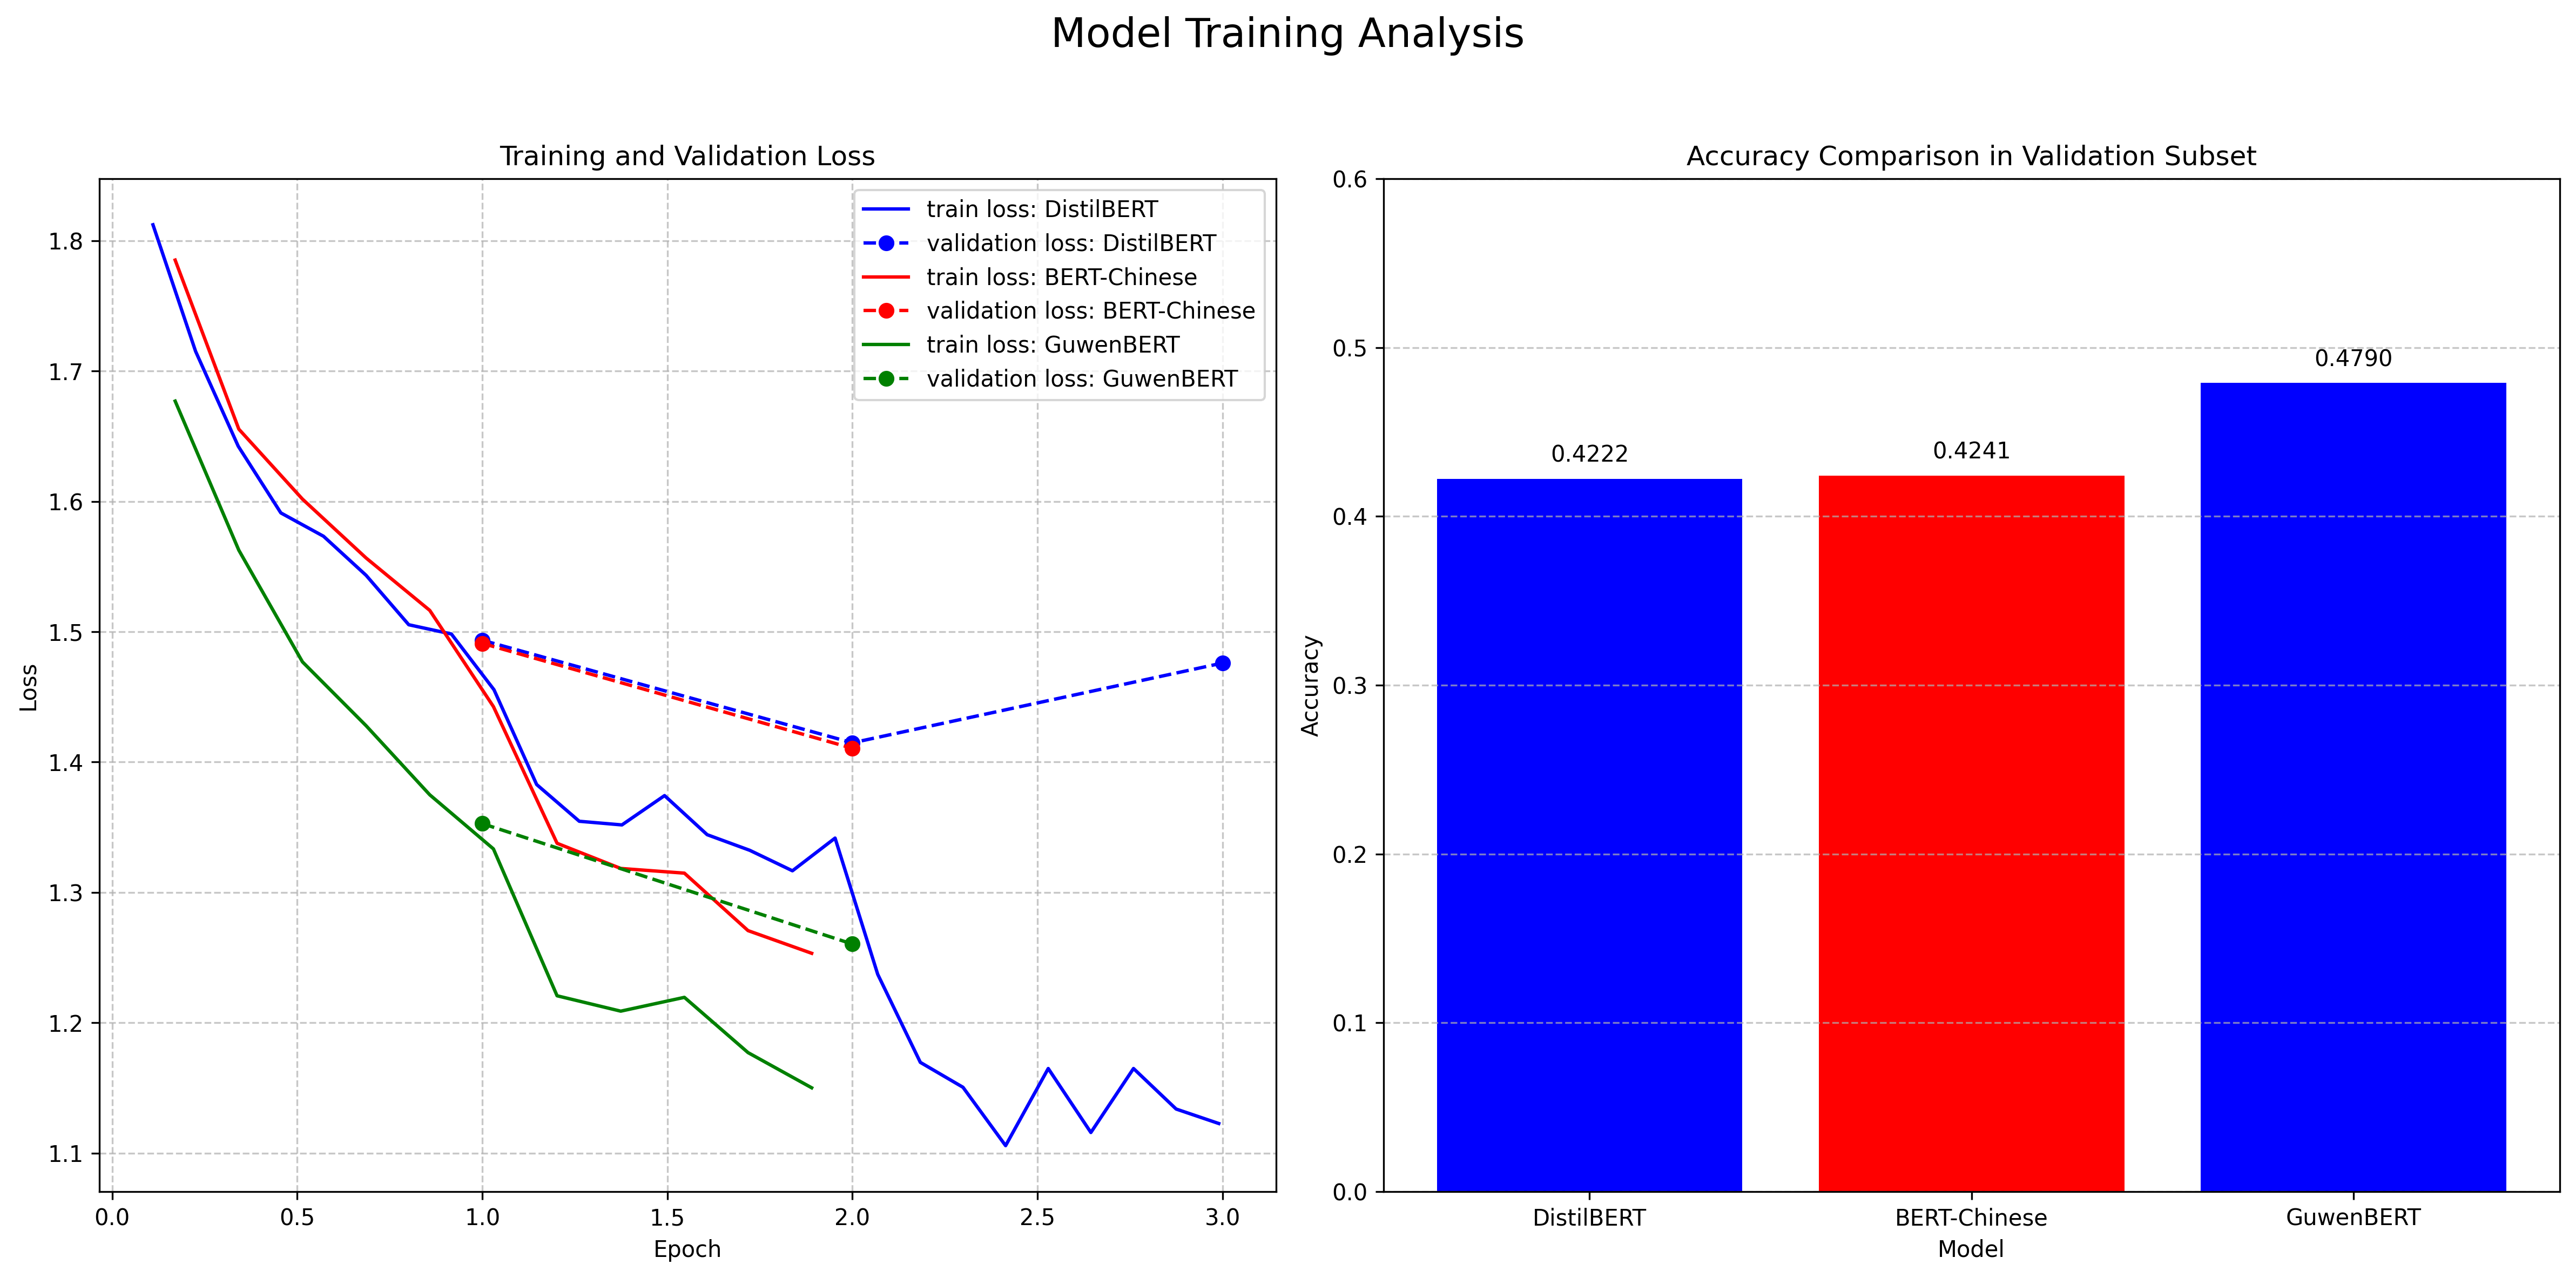
On peut observer que la tendance des pertes (loss) des trois modèles est globalement similaire, et que bert-case-chinese et ethanyt/guwenbert-base présentent presque une évolution parallèle — ce qui peut s'expliquer par le fait que le second a été fine-tuné à partir du premier. Un autre fait intéressant est que, pour distillBERT, la perte de validation augmente après la deuxième époque ; cependant, par manque de temps et de ressources, il n’a pas été possible d’observer ce phénomène sur les deux autres modèles plus grands.
Après l'entraînement des trois modèles, une évaluation a été effectué sur le sous-ensemble de test. La classe classification_report de sklearn est utilisé pour obtenir une évaluation plus détaillée des tâches de classification.
Pour le modèle distilled-bert-multilingual, on a:
| Dynasty | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| WeiJin | 0.5627 | 0.8248 | 0.6690 | 234 |
| NanBei | 0.5986 | 0.5397 | 0.5676 | 315 |
| Tang | 0.4953 | 0.3680 | 0.4222 | 568 |
| Song | 0.3553 | 0.1211 | 0.1806 | 446 |
| Yuan | 0.4140 | 0.5115 | 0.4576 | 823 |
| Ming | 0.3389 | 0.3632 | 0.3506 | 782 |
| Qing | 0.3768 | 0.4509 | 0.4105 | 570 |
| accuracy | 0.4248 | 3738 | ||
| macro avg | 0.4488 | 0.4542 | 0.4369 | 3738 |
| weighted avg | 0.4228 | 0.4248 | 0.4121 | 3738 |
Pour le modèle bert-case-chinese, on a:
| Dynasty | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| WeiJin | 0.6565 | 0.7350 | 0.6935 | 234 |
| NanBei | 0.5994 | 0.6032 | 0.6013 | 315 |
| Tang | 0.4110 | 0.5898 | 0.4845 | 568 |
| Song | 0.3103 | 0.1413 | 0.1941 | 446 |
| Yuan | 0.4183 | 0.5322 | 0.4684 | 823 |
| Ming | 0.3789 | 0.4003 | 0.3893 | 782 |
| Qing | 0.5858 | 0.2754 | 0.3747 | 570 |
| accuracy | 0.4462 | 3738 | ||
| macro avg | 0.4800 | 0.4682 | 0.4580 | 3738 |
| weighted avg | 0.4518 | 0.4462 | 0.4326 | 3738 |
Pour le modèle ethanyt/guwenbert-base, on a:
| Dynasty | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| WeiJin | 0.7626 | 0.8376 | 0.7984 | 234 |
| NanBei | 0.7953 | 0.6413 | 0.7100 | 315 |
| Tang | 0.5686 | 0.5546 | 0.5615 | 568 |
| Song | 0.4163 | 0.2287 | 0.2952 | 446 |
| Yuan | 0.4060 | 0.6877 | 0.5106 | 823 |
| Ming | 0.3853 | 0.4361 | 0.4091 | 782 |
| Qing | 0.7718 | 0.2018 | 0.3199 | 570 |
| accuracy | 0.4914 | 3738 | ||
| macro avg | 0.5866 | 0.5125 | 0.5150 | 3738 |
| weighted avg | 0.5385 | 0.4914 | 0.4771 | 3738 |
En représentant le rappel (Recall) de chaque dynastie — c'est-à-dire le taux de bonne prédiction pour les poèmes de chaque dynastie — sous forme de graphique, des résultats obtenus sont intéressants :
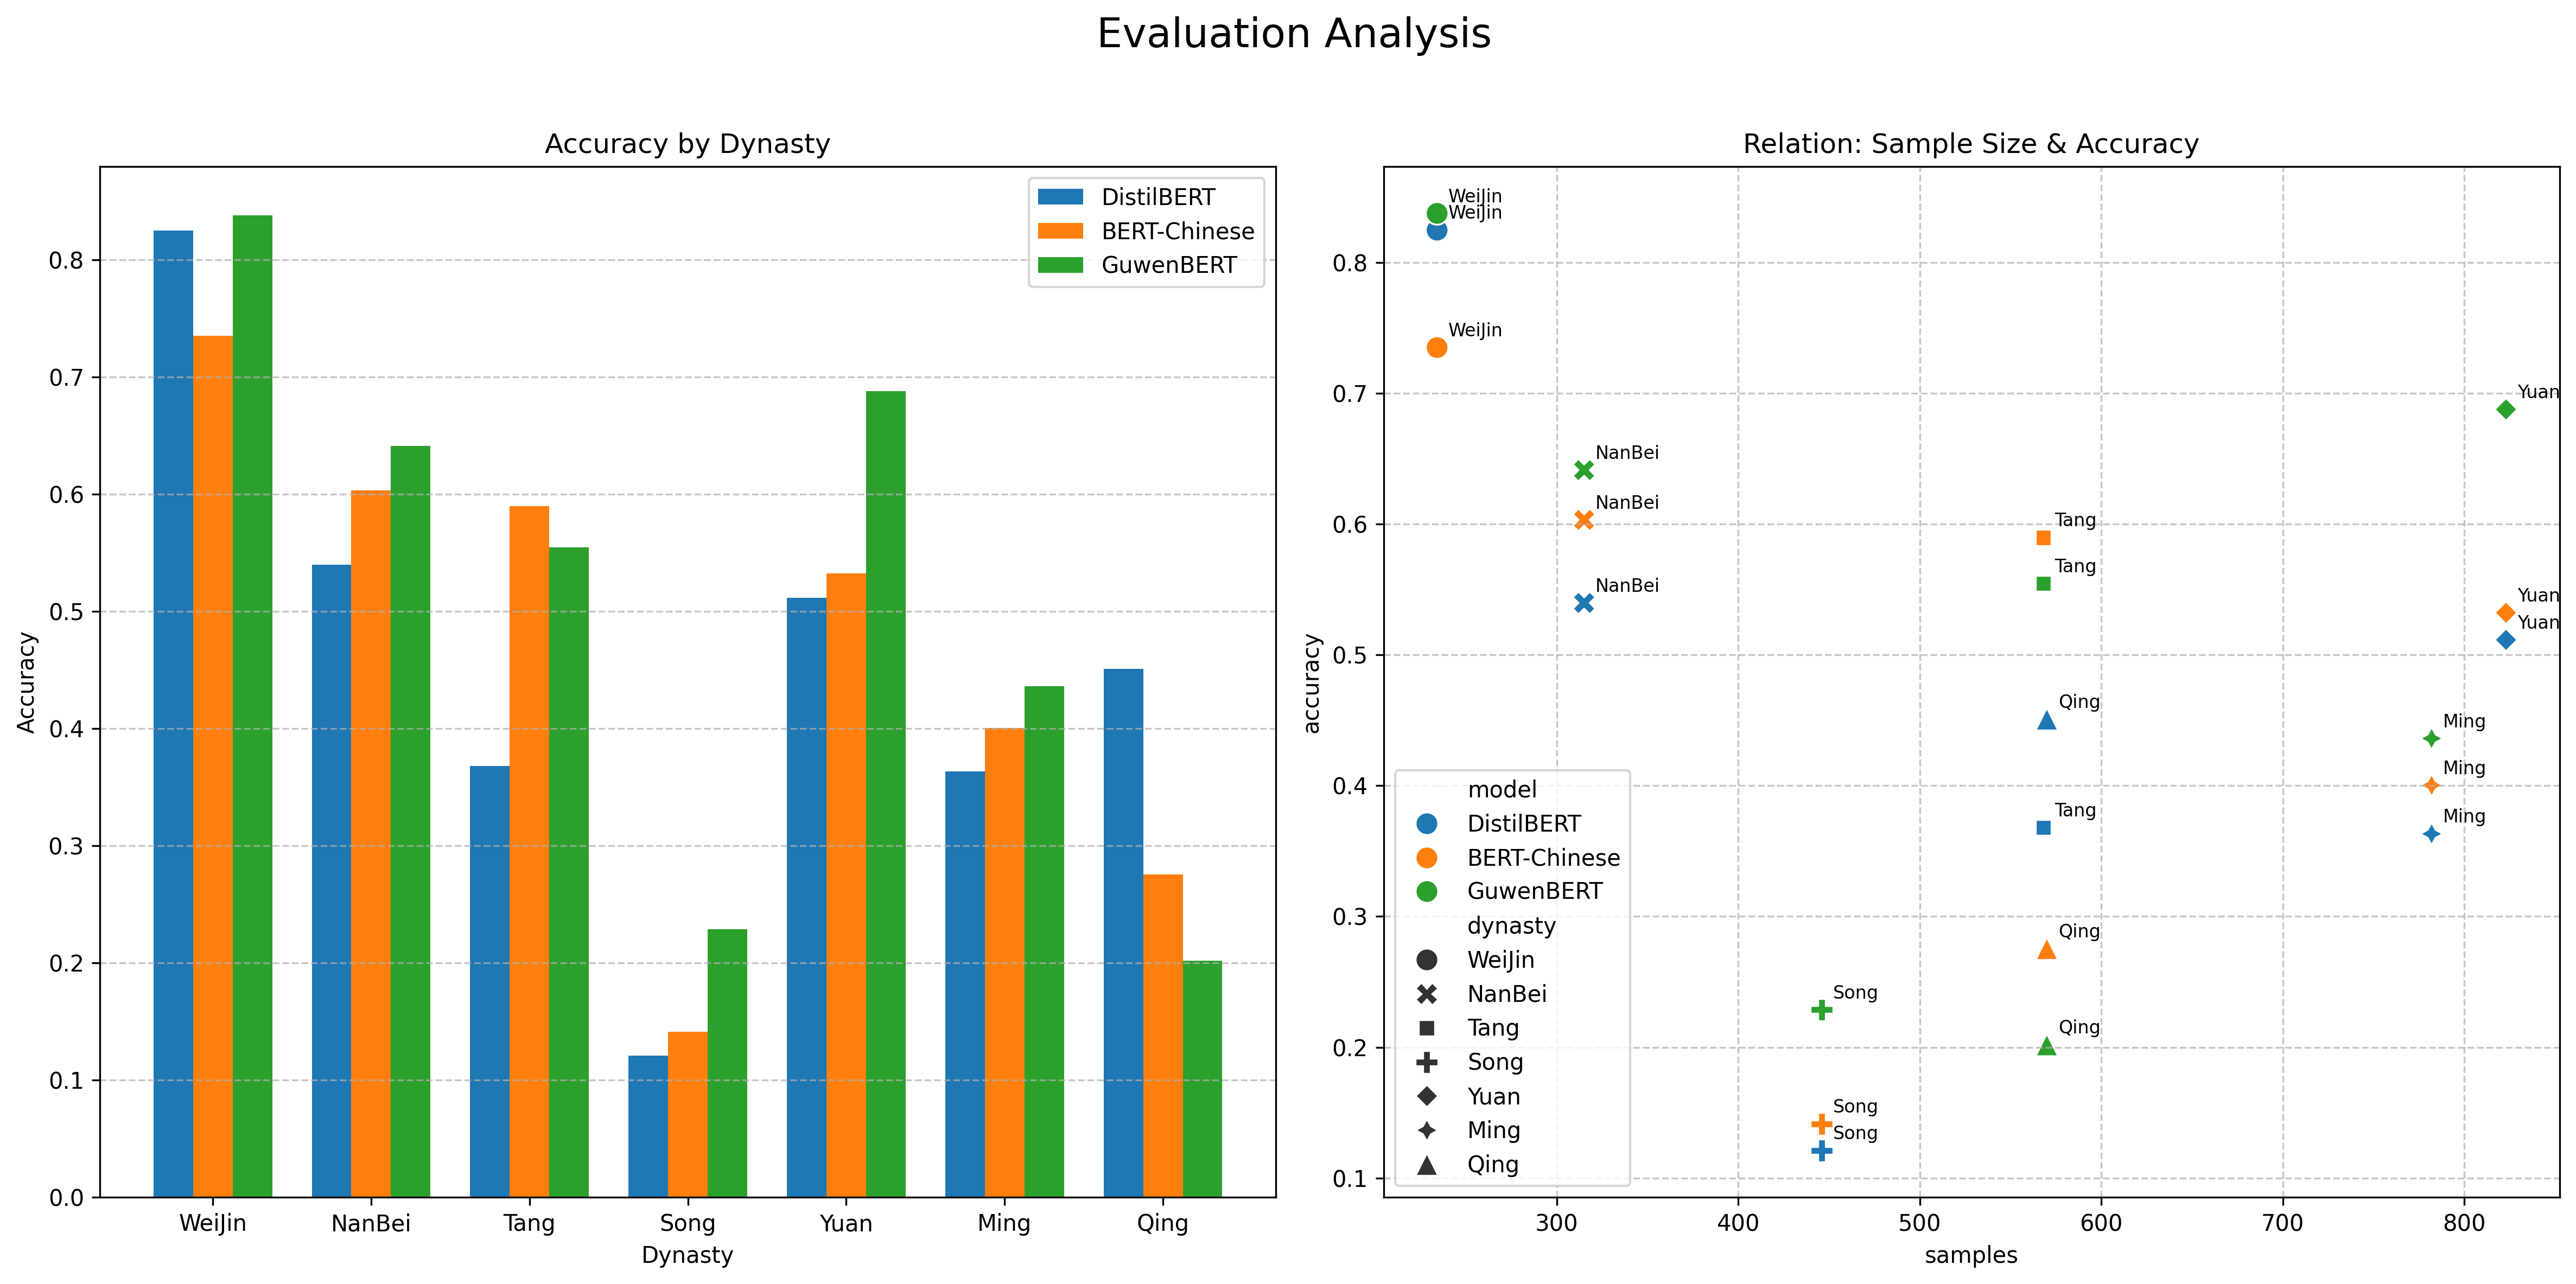
Le modèle ethanyt/guwenbert-base, spécialisé en chinois classique, affiche globalement les meilleures performances avec une exactitude (accuracy) de 0.4914 et un F1-score macro moyen de 0.5150. Il est suivi par bert-case-chinese (exactitude 0.4462, F1-macro 0.4580) puis distilled-bert-multilingual (exactitude 0.4248, F1-macro 0.4369).
Les poèmes de la dynastie WeiJin possèdent probablement des caractéristiques linguistiques ou stylistiques très distinctives qui les rendent plus faciles à identifier pour les modèles.
La difficulté à classifier correctement les poèmes de la dynastie Song pourrait indiquer que leurs traits stylistiques sont moins uniques, ou qu'ils partagent plus de similitudes avec les poèmes des dynasties adjacentes (Tang, Yuan, Ming), rendant la distinction plus complexe même pour un modèle spécialisé.
La performance plus faible du modèle ethanyt/guwenbert-base sur la poésie Qing pourrait suggérer que les caractéristiques sur lesquelles ce modèle a été finement ajusté (spécifiques au chinois "classique" plus ancien) sont moins prédominantes ou discriminantes pour la poésie Qing, ou que la poésie Qing présente une plus grande hétérogénéité stylistique non capturée efficacement.
Le code de ce projet a été révisé avec pycodestyle pour assurer sa conformité au PEP 8.
Ce projet s'inscrit dans le cadre du cours "Outils de Traitement de Corpus" du Master 1 Plurital.
Le dataset et le modèle sont tous les deux disponibles sur 🤗Hugging Face : Dataset, Model
Ce projet utilise uv pour la gestion de l'environnement.
Pour exécuter les scripts (assurez-vous d'avoir installé uv):
uv run chemin/vers/le/script.py
L'objectif de ce projet est d'effectuer une classification textuelle sur un corpus de poèmes chinois classiques (à l'exclusion des formes ci(词) et qu(曲)). Le but est de prédire la dynastie (par ordre chronologique : WeiJin 魏晋, NanBei 南北朝, Tang 唐, Song 宋, Yuan 元, Ming 明, Qing 清) à laquelle un poème donné appartient.
Bien que les formes de la poésie chinoise classique soient restées relativement stables après la dynastie Tang, ce projet s'inspire de deux observations principales :
Linguistique : Les caractéristiques linguistiques et l'usage des mots présentent des variations distinctes d'une dynastie à l'autre.
Stylistique et théorie littéraire : En stylistique et selon la théorie littéraire chinoise ancienne, la poésie de chaque dynastie possède un style distinctif, souvent décrit comme un "zeitgeist".
Les données du projet proviennent du site sou-yun.cn, qui n'interdit pas l'extraction de données.
Ce site a déjà classifié les poèmes par dynastie et fournit un index de tous les poèmes par auteur. Par conséquent, le projet utilise request et bs4 pour analyser la structure HTML du site et extraire les données poétiques des sept dynasties sélectionnées. Pour des raisons d'efficacité lors de l'entraînement, le script d'extraction récupère les 20 premiers poèmes de chaque poète (ou le maximum disponible si inférieur à 20) pour les dynasties comptant moins de 1000 poètes, et seulement les 20 premiers poèmes des 1000 premiers poètes pour les dynasties plus prolifiques.
Les données obtenues sont sauvegardées en format .csv, puis fusionnées en un seul grand ensemble de données qui est ensuite mélangé et divisé en trois sous-ensembles : entraînement/validation/test (selon un ratio 7 : 1.5 : 1.5, avec une répartition réelle des données de 17418 : 3733 : 3738). Ces ensembles sont stockés au format dataset de HuggingFace.
| Ensemble de données | Ratio | Quantité réelle |
|---|---|---|
| Entraînement | 7 | 17 418 |
| Validation | 1,5 | 3 733 |
| Test | 1,5 | 3 738 |
| Total | 10 | 24 889 |
La visualisation des données est présentée ci-dessous :
Les deux premières dynasties (Weijin et Nanbei) présentent le plus petit nombre de poèmes, ce qui est logique car ce sont les dynasties les plus anciennes et donc celles dont le moins d'œuvres ont été conservées. La dynastie Weijin montre la longueur moyenne de poèmes la plus élevée, car dans notre corpus, les fu 赋 sont également considérés comme des poèmes. Durant cette période, la création de poèmes en quatre mots et de fu était proportionnellement plus fréquente que dans les six autres dynasties. Ces dernières, particulièrement après la dynastie Tang, privilégiaient les formes poétiques jueju 绝句 (24 ou 32 caractères, ponctuation incluse) et lüshi 律诗 (48 ou 64 caractères). Considérant que les poèmes de style ancien et les "fu" étaient occasionnellement créés et qu'ils sont beaucoup plus longs que les "jueju" et les "lüshi", la longueur moyenne obtenue (60-80 caractères) paraît raisonnable.
Ce projet utilise la HuggingFace Text Classification comme référence pour effectuer le fine-tuning des modèles de classification textuelle.
Le jeu de données a été entraîné sur trois modèles pré-entraînés de type BERT :
distilled-bert-multilingual: un modèle BERT multilingue distillé, permettant un entraînement rapidebert-case-chinese: un modèle BERT pour le chinoisethanyt/guwenbert-base: un modèle basé sur bert-case-chinese ayant déjà été fine-tuné sur un grand corpus de textes chinois classiquesLe nombre d'époques (epoch) du premier modèle est fixé à 3. Afin de réduire le temps d'entraînement, il est fixé à 2 pour les deux autres modèles plus grands. Les autres paramètres restent inchangés.
En analysant les journaux de logs durant l'entraînement, on a obtenu l'évolution de la perte (Loss) par époque (Epoch) et les performances de chaque modèle sur l'ensemble de validation :
On peut observer que la tendance des pertes (loss) des trois modèles est globalement similaire, et que bert-case-chinese et ethanyt/guwenbert-base présentent presque une évolution parallèle — ce qui peut s'expliquer par le fait que le second a été fine-tuné à partir du premier. Un autre fait intéressant est que, pour distillBERT, la perte de validation augmente après la deuxième époque ; cependant, par manque de temps et de ressources, il n’a pas été possible d’observer ce phénomène sur les deux autres modèles plus grands.
Après l'entraînement des trois modèles, une évaluation a été effectué sur le sous-ensemble de test. La classe classification_report de sklearn est utilisé pour obtenir une évaluation plus détaillée des tâches de classification.
Pour le modèle distilled-bert-multilingual, on a:
| Dynasty | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| WeiJin | 0.5627 | 0.8248 | 0.6690 | 234 |
| NanBei | 0.5986 | 0.5397 | 0.5676 | 315 |
| Tang | 0.4953 | 0.3680 | 0.4222 | 568 |
| Song | 0.3553 | 0.1211 | 0.1806 | 446 |
| Yuan | 0.4140 | 0.5115 | 0.4576 | 823 |
| Ming | 0.3389 | 0.3632 | 0.3506 | 782 |
| Qing | 0.3768 | 0.4509 | 0.4105 | 570 |
| accuracy | 0.4248 | 3738 | ||
| macro avg | 0.4488 | 0.4542 | 0.4369 | 3738 |
| weighted avg | 0.4228 | 0.4248 | 0.4121 | 3738 |
Pour le modèle bert-case-chinese, on a:
| Dynasty | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| WeiJin | 0.6565 | 0.7350 | 0.6935 | 234 |
| NanBei | 0.5994 | 0.6032 | 0.6013 | 315 |
| Tang | 0.4110 | 0.5898 | 0.4845 | 568 |
| Song | 0.3103 | 0.1413 | 0.1941 | 446 |
| Yuan | 0.4183 | 0.5322 | 0.4684 | 823 |
| Ming | 0.3789 | 0.4003 | 0.3893 | 782 |
| Qing | 0.5858 | 0.2754 | 0.3747 | 570 |
| accuracy | 0.4462 | 3738 | ||
| macro avg | 0.4800 | 0.4682 | 0.4580 | 3738 |
| weighted avg | 0.4518 | 0.4462 | 0.4326 | 3738 |
Pour le modèle ethanyt/guwenbert-base, on a:
| Dynasty | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| WeiJin | 0.7626 | 0.8376 | 0.7984 | 234 |
| NanBei | 0.7953 | 0.6413 | 0.7100 | 315 |
| Tang | 0.5686 | 0.5546 | 0.5615 | 568 |
| Song | 0.4163 | 0.2287 | 0.2952 | 446 |
| Yuan | 0.4060 | 0.6877 | 0.5106 | 823 |
| Ming | 0.3853 | 0.4361 | 0.4091 | 782 |
| Qing | 0.7718 | 0.2018 | 0.3199 | 570 |
| accuracy | 0.4914 | 3738 | ||
| macro avg | 0.5866 | 0.5125 | 0.5150 | 3738 |
| weighted avg | 0.5385 | 0.4914 | 0.4771 | 3738 |
En représentant le rappel (Recall) de chaque dynastie — c'est-à-dire le taux de bonne prédiction pour les poèmes de chaque dynastie — sous forme de graphique, des résultats obtenus sont intéressants :
Le modèle ethanyt/guwenbert-base, spécialisé en chinois classique, affiche globalement les meilleures performances avec une exactitude (accuracy) de 0.4914 et un F1-score macro moyen de 0.5150. Il est suivi par bert-case-chinese (exactitude 0.4462, F1-macro 0.4580) puis distilled-bert-multilingual (exactitude 0.4248, F1-macro 0.4369).
Les poèmes de la dynastie WeiJin possèdent probablement des caractéristiques linguistiques ou stylistiques très distinctives qui les rendent plus faciles à identifier pour les modèles.
La difficulté à classifier correctement les poèmes de la dynastie Song pourrait indiquer que leurs traits stylistiques sont moins uniques, ou qu'ils partagent plus de similitudes avec les poèmes des dynasties adjacentes (Tang, Yuan, Ming), rendant la distinction plus complexe même pour un modèle spécialisé.
La performance plus faible du modèle ethanyt/guwenbert-base sur la poésie Qing pourrait suggérer que les caractéristiques sur lesquelles ce modèle a été finement ajusté (spécifiques au chinois "classique" plus ancien) sont moins prédominantes ou discriminantes pour la poésie Qing, ou que la poésie Qing présente une plus grande hétérogénéité stylistique non capturée efficacement.
Le code de ce projet a été révisé avec pycodestyle pour assurer sa conformité au PEP 8.



