基于向量数据库与GPT3.5的通用本地知识库方案(A universal local knowledge base solution based on vector database and GPT3.5)
Python
3,666
16 commits
updated May 12, 2023
基于向量数据库与GPT3.5的通用本地知识库方案(A universal local knowledge base solution based on vector database and GPT3.5)
code 目录中有本次MSD示例的相关示例代码
docs 目录主要是关于我在这个方向的一些思考和总结
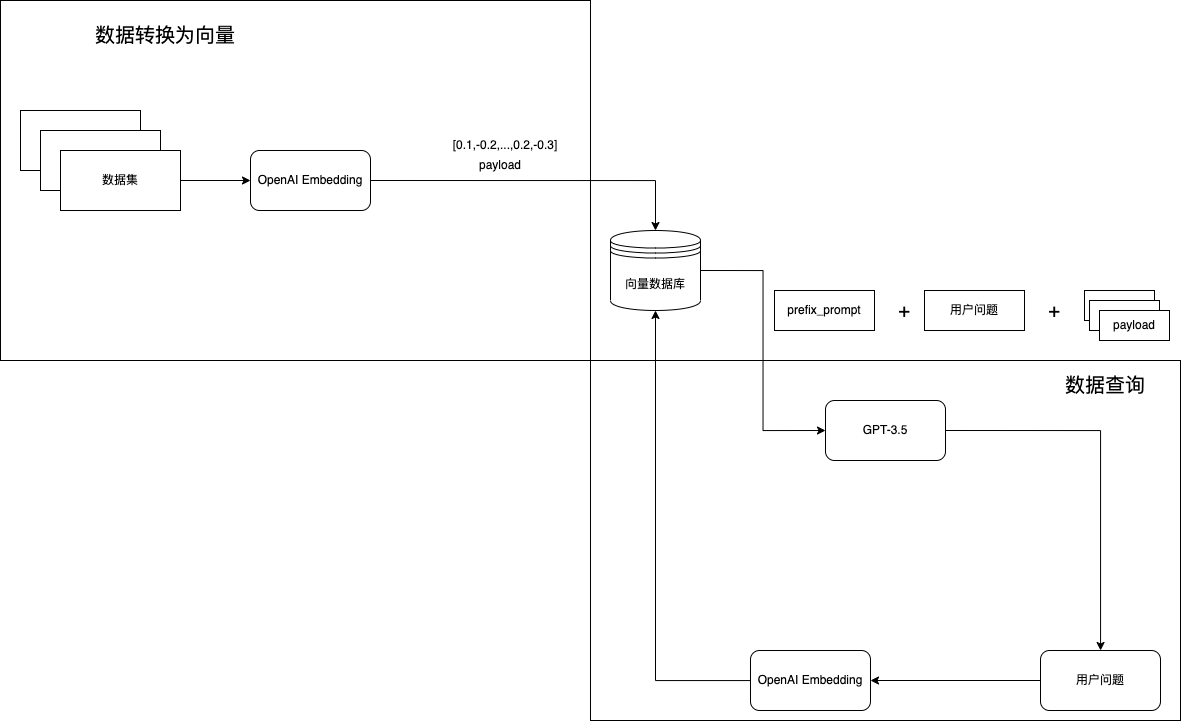
整个流程非常简单,也没有复杂的地方,相信关注GPT领域的都会看到过如上的流程。
主要就以下几个点:
请参考 OpenAI 的使用政策
https://openai.com/policies/usage-policies
我的 MSD 案例只是探索其中一个垂直领域的可行性,你可以把这个项目迁移到任何你熟悉的领域中,而不必拘泥于医疗领域
在上面的例子中,我们直接将问题和答案做匹配,有些时候因为问题的模糊性会导致匹配不相关的答案。
如果在已经有大量的问答映射数据的情况下,问题直接搜索问题集,然后基于已有映射返回当前问题匹配的问题集的答案,这样可以提升一定的问题准确性。
因为答案中有大量非答案的内容,可以通过抽取答案主题然后组合生成向量数据,也可以在一定程度上提升相似度,主题算法有LDA、LSA等。
openAI 的Embedding模型数据更多是基于普遍性数据训练,如果你要做问答的领域太过于专业有可能就会出现查询数据不准确的情况。
解决方案是自训练 Embedding 模型,在这里我推荐一个项目 text2vec ,shibing624 已经给出了一个模型基于 CoSENT + MacBERT +STS-B,shibing624/text2vec-base-chinese。
我也在前些日子训练了基于 CoSENT + LERT + STS-B的两个模型一个隐层大小是1024的text2vec-large-chinese,另一个是768的text2vec-base-chinese。也欢迎比对。
为了做这个Demo我还训练了两个医疗问答相关的模型基于cMedQQ数据集,其他与上面的一致分别是text2vec-cmedqq-lert-large和text2vec-cmedqq-lert-base。
目前我自身测试下来,使用问答数据集对GPT模型进行Fine-tune后,对于该类问题的准确性大幅提高。你可以理解为GPT通过大量的专业领域数据的训练后,当你对它提问的时候会更像在和这个领域的专家对话,然后配合调小接口中temperature参数,可以得到更确定的结果。
但 现在 Fine-tune 训练和使用成本还是太高,每天都会有新的数据,不可能高频的进行 Fine-tune。我的一个想法是每隔一个长周期对数据进行 Fine-tune ,然后配合外置的向量数据库的相似查询来补足 Fine-tune 模型本身的数据准确性问题。



2,552 followers · starred Mar 2023
1,456 followers · starred May 2023
1,863 followers · starred Apr 2023
1,697 followers · starred Mar 2023
基于向量数据库与GPT3.5的通用本地知识库方案(A universal local knowledge base solution based on vector database and GPT3.5)
Python
3,666
16 commits
updated May 12, 2023
基于向量数据库与GPT3.5的通用本地知识库方案(A universal local knowledge base solution based on vector database and GPT3.5)
code 目录中有本次MSD示例的相关示例代码
docs 目录主要是关于我在这个方向的一些思考和总结
整个流程非常简单,也没有复杂的地方,相信关注GPT领域的都会看到过如上的流程。
主要就以下几个点:
请参考 OpenAI 的使用政策
https://openai.com/policies/usage-policies
我的 MSD 案例只是探索其中一个垂直领域的可行性,你可以把这个项目迁移到任何你熟悉的领域中,而不必拘泥于医疗领域
在上面的例子中,我们直接将问题和答案做匹配,有些时候因为问题的模糊性会导致匹配不相关的答案。
如果在已经有大量的问答映射数据的情况下,问题直接搜索问题集,然后基于已有映射返回当前问题匹配的问题集的答案,这样可以提升一定的问题准确性。
因为答案中有大量非答案的内容,可以通过抽取答案主题然后组合生成向量数据,也可以在一定程度上提升相似度,主题算法有LDA、LSA等。
openAI 的Embedding模型数据更多是基于普遍性数据训练,如果你要做问答的领域太过于专业有可能就会出现查询数据不准确的情况。
解决方案是自训练 Embedding 模型,在这里我推荐一个项目 text2vec ,shibing624 已经给出了一个模型基于 CoSENT + MacBERT +STS-B,shibing624/text2vec-base-chinese。
我也在前些日子训练了基于 CoSENT + LERT + STS-B的两个模型一个隐层大小是1024的text2vec-large-chinese,另一个是768的text2vec-base-chinese。也欢迎比对。
为了做这个Demo我还训练了两个医疗问答相关的模型基于cMedQQ数据集,其他与上面的一致分别是text2vec-cmedqq-lert-large和text2vec-cmedqq-lert-base。
目前我自身测试下来,使用问答数据集对GPT模型进行Fine-tune后,对于该类问题的准确性大幅提高。你可以理解为GPT通过大量的专业领域数据的训练后,当你对它提问的时候会更像在和这个领域的专家对话,然后配合调小接口中temperature参数,可以得到更确定的结果。
但 现在 Fine-tune 训练和使用成本还是太高,每天都会有新的数据,不可能高频的进行 Fine-tune。我的一个想法是每隔一个长周期对数据进行 Fine-tune ,然后配合外置的向量数据库的相似查询来补足 Fine-tune 模型本身的数据准确性问题。
2,552 followers · starred Mar 2023
1,456 followers · starred May 2023
1,863 followers · starred Apr 2023
1,697 followers · starred Mar 2023