An advanced portfolio optimization system that leverages Large Language Models (LLMs) to analyze multi-source financial data and generate investment views for Black-Litterman portfolio optimization.
| Document | Description |
|---|---|
| README.md | Main project documentation (this file) |
| RESULTS_SUMMARY.md | Performance results and backtesting analysis |
| HYPERPARAMETER_GUIDE.md | Complete guide to hyperparameter optimization |
| PROJECT_PRESENTATION_SUMMARY.md | Comprehensive project summary for presentations |
| WORKFLOW_DIAGRAM_README.md | Workflow diagram generation and usage |
| README_political_news.md | Political news data collection documentation |
This system combines:
The complete system workflow is visualized in the following diagrams:
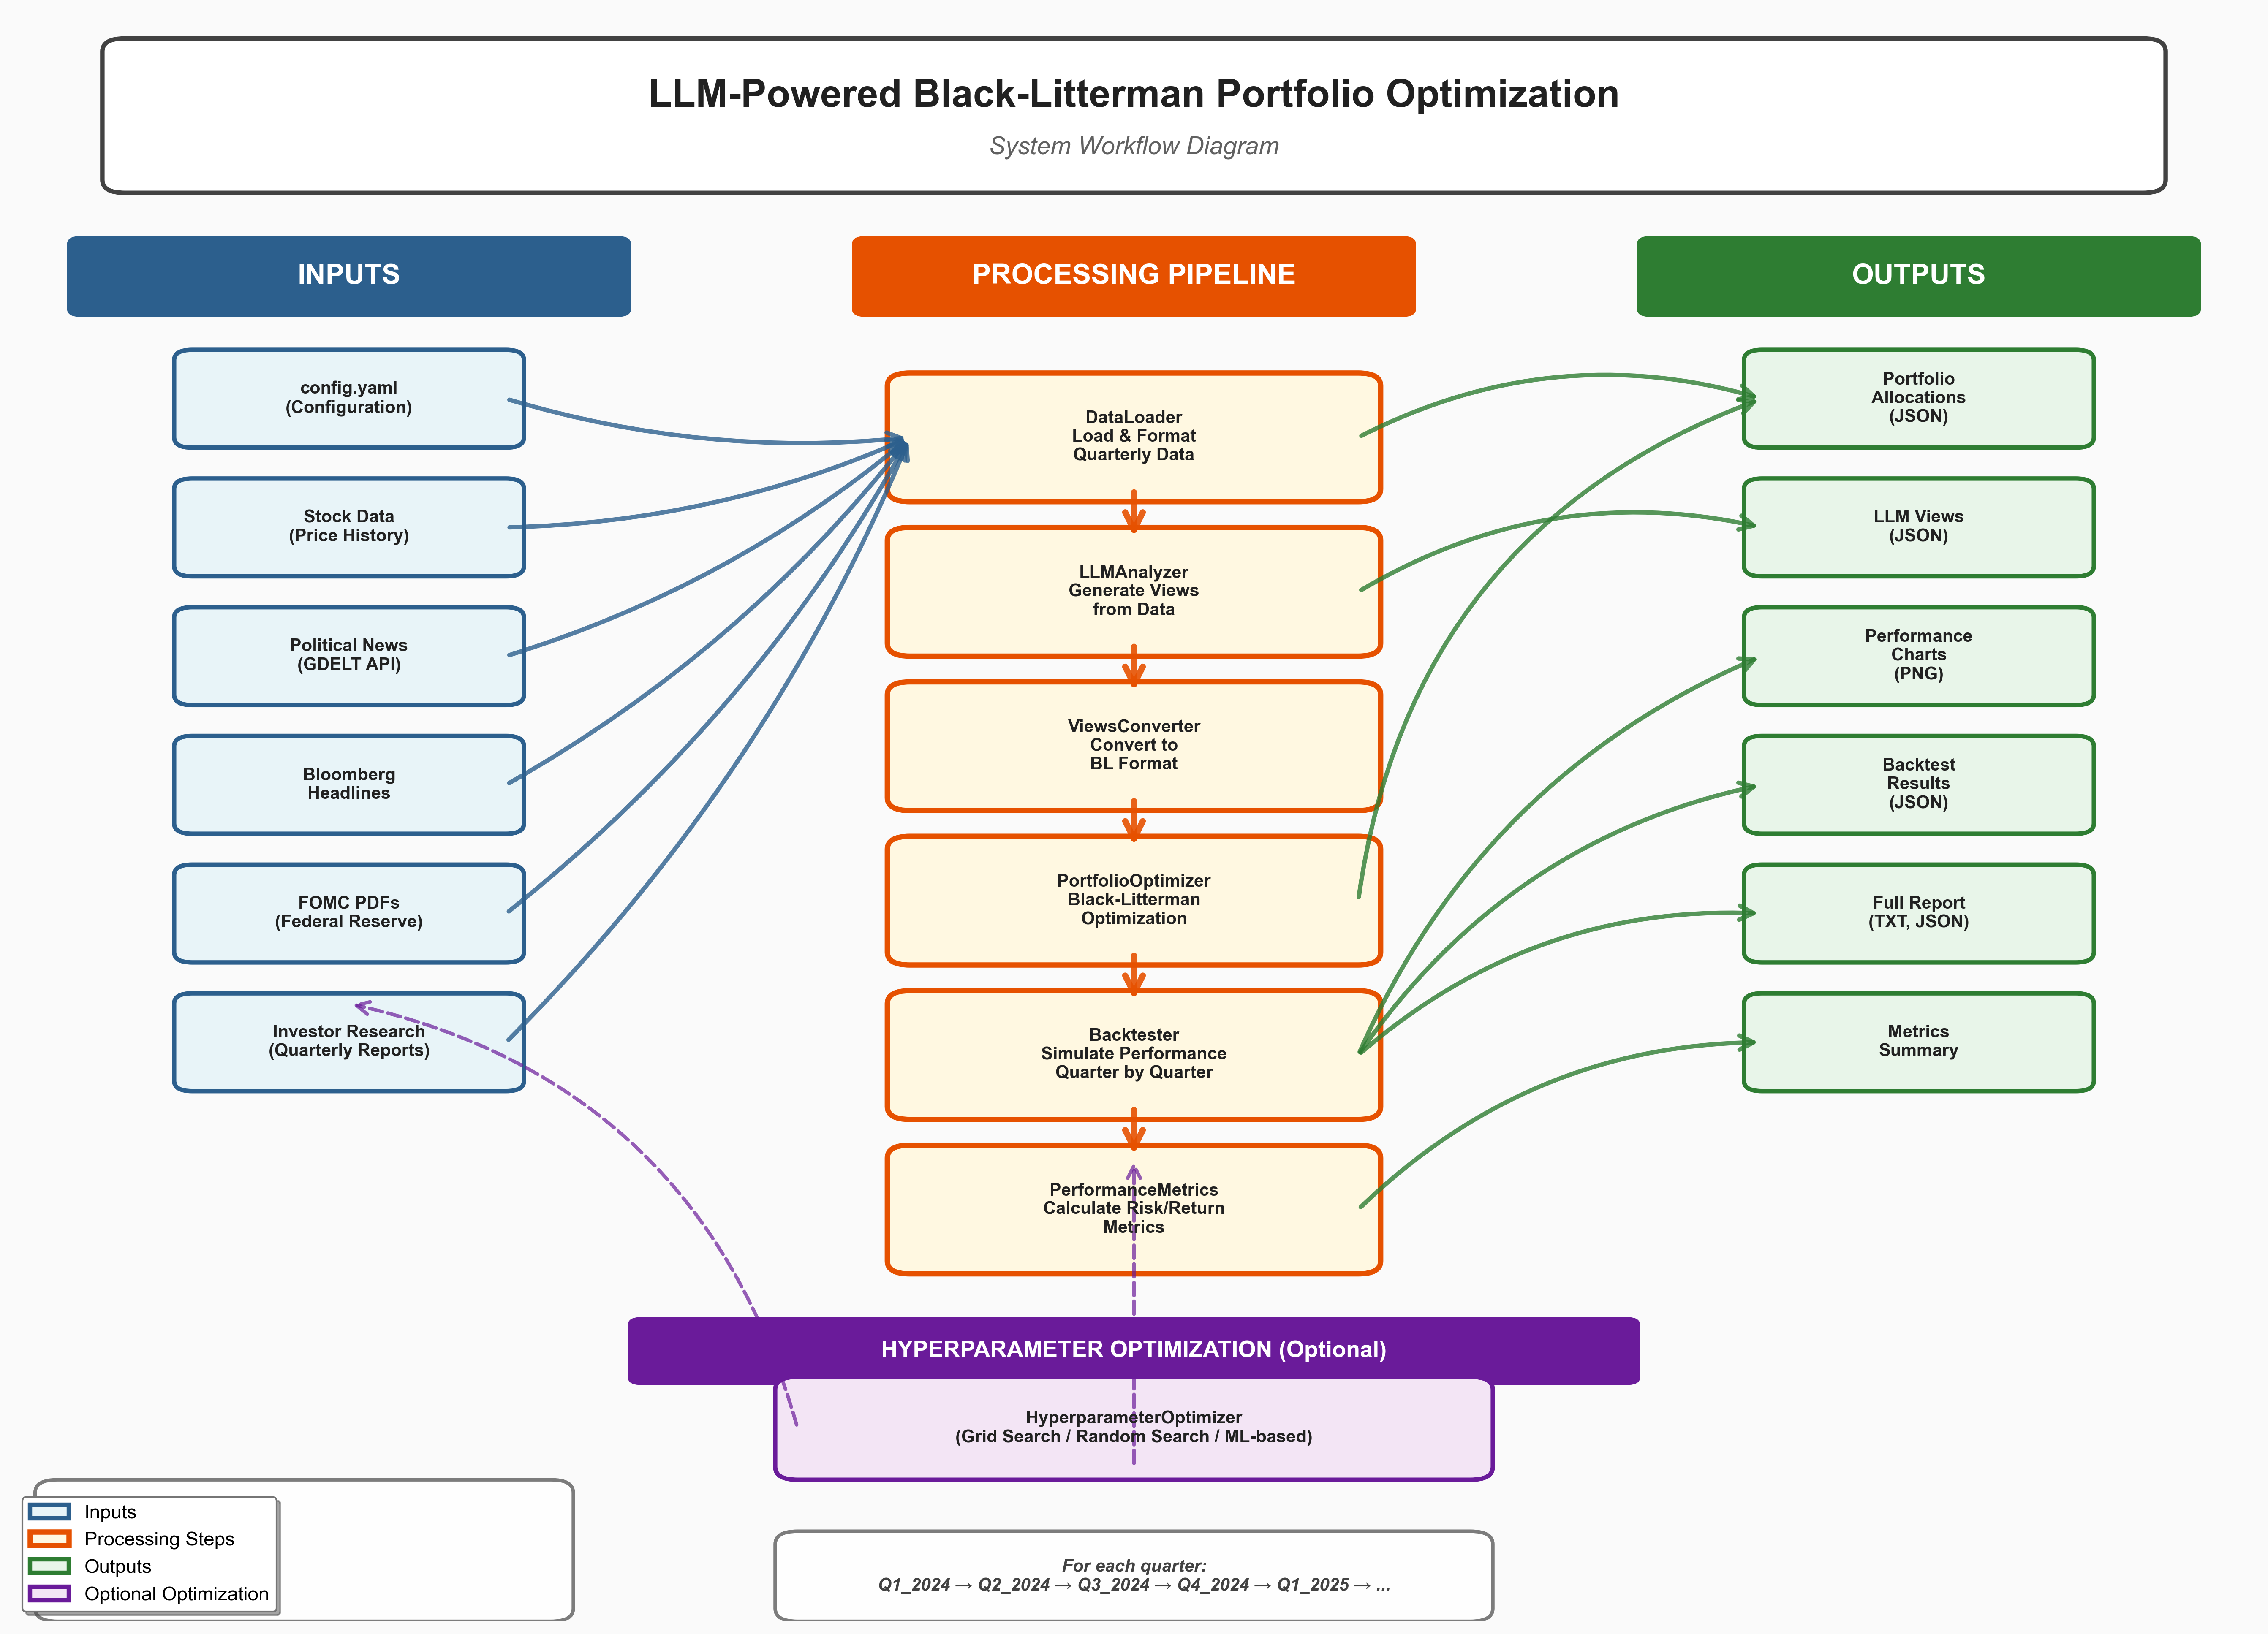
High-Level Overview (output/workflow_diagram.png):
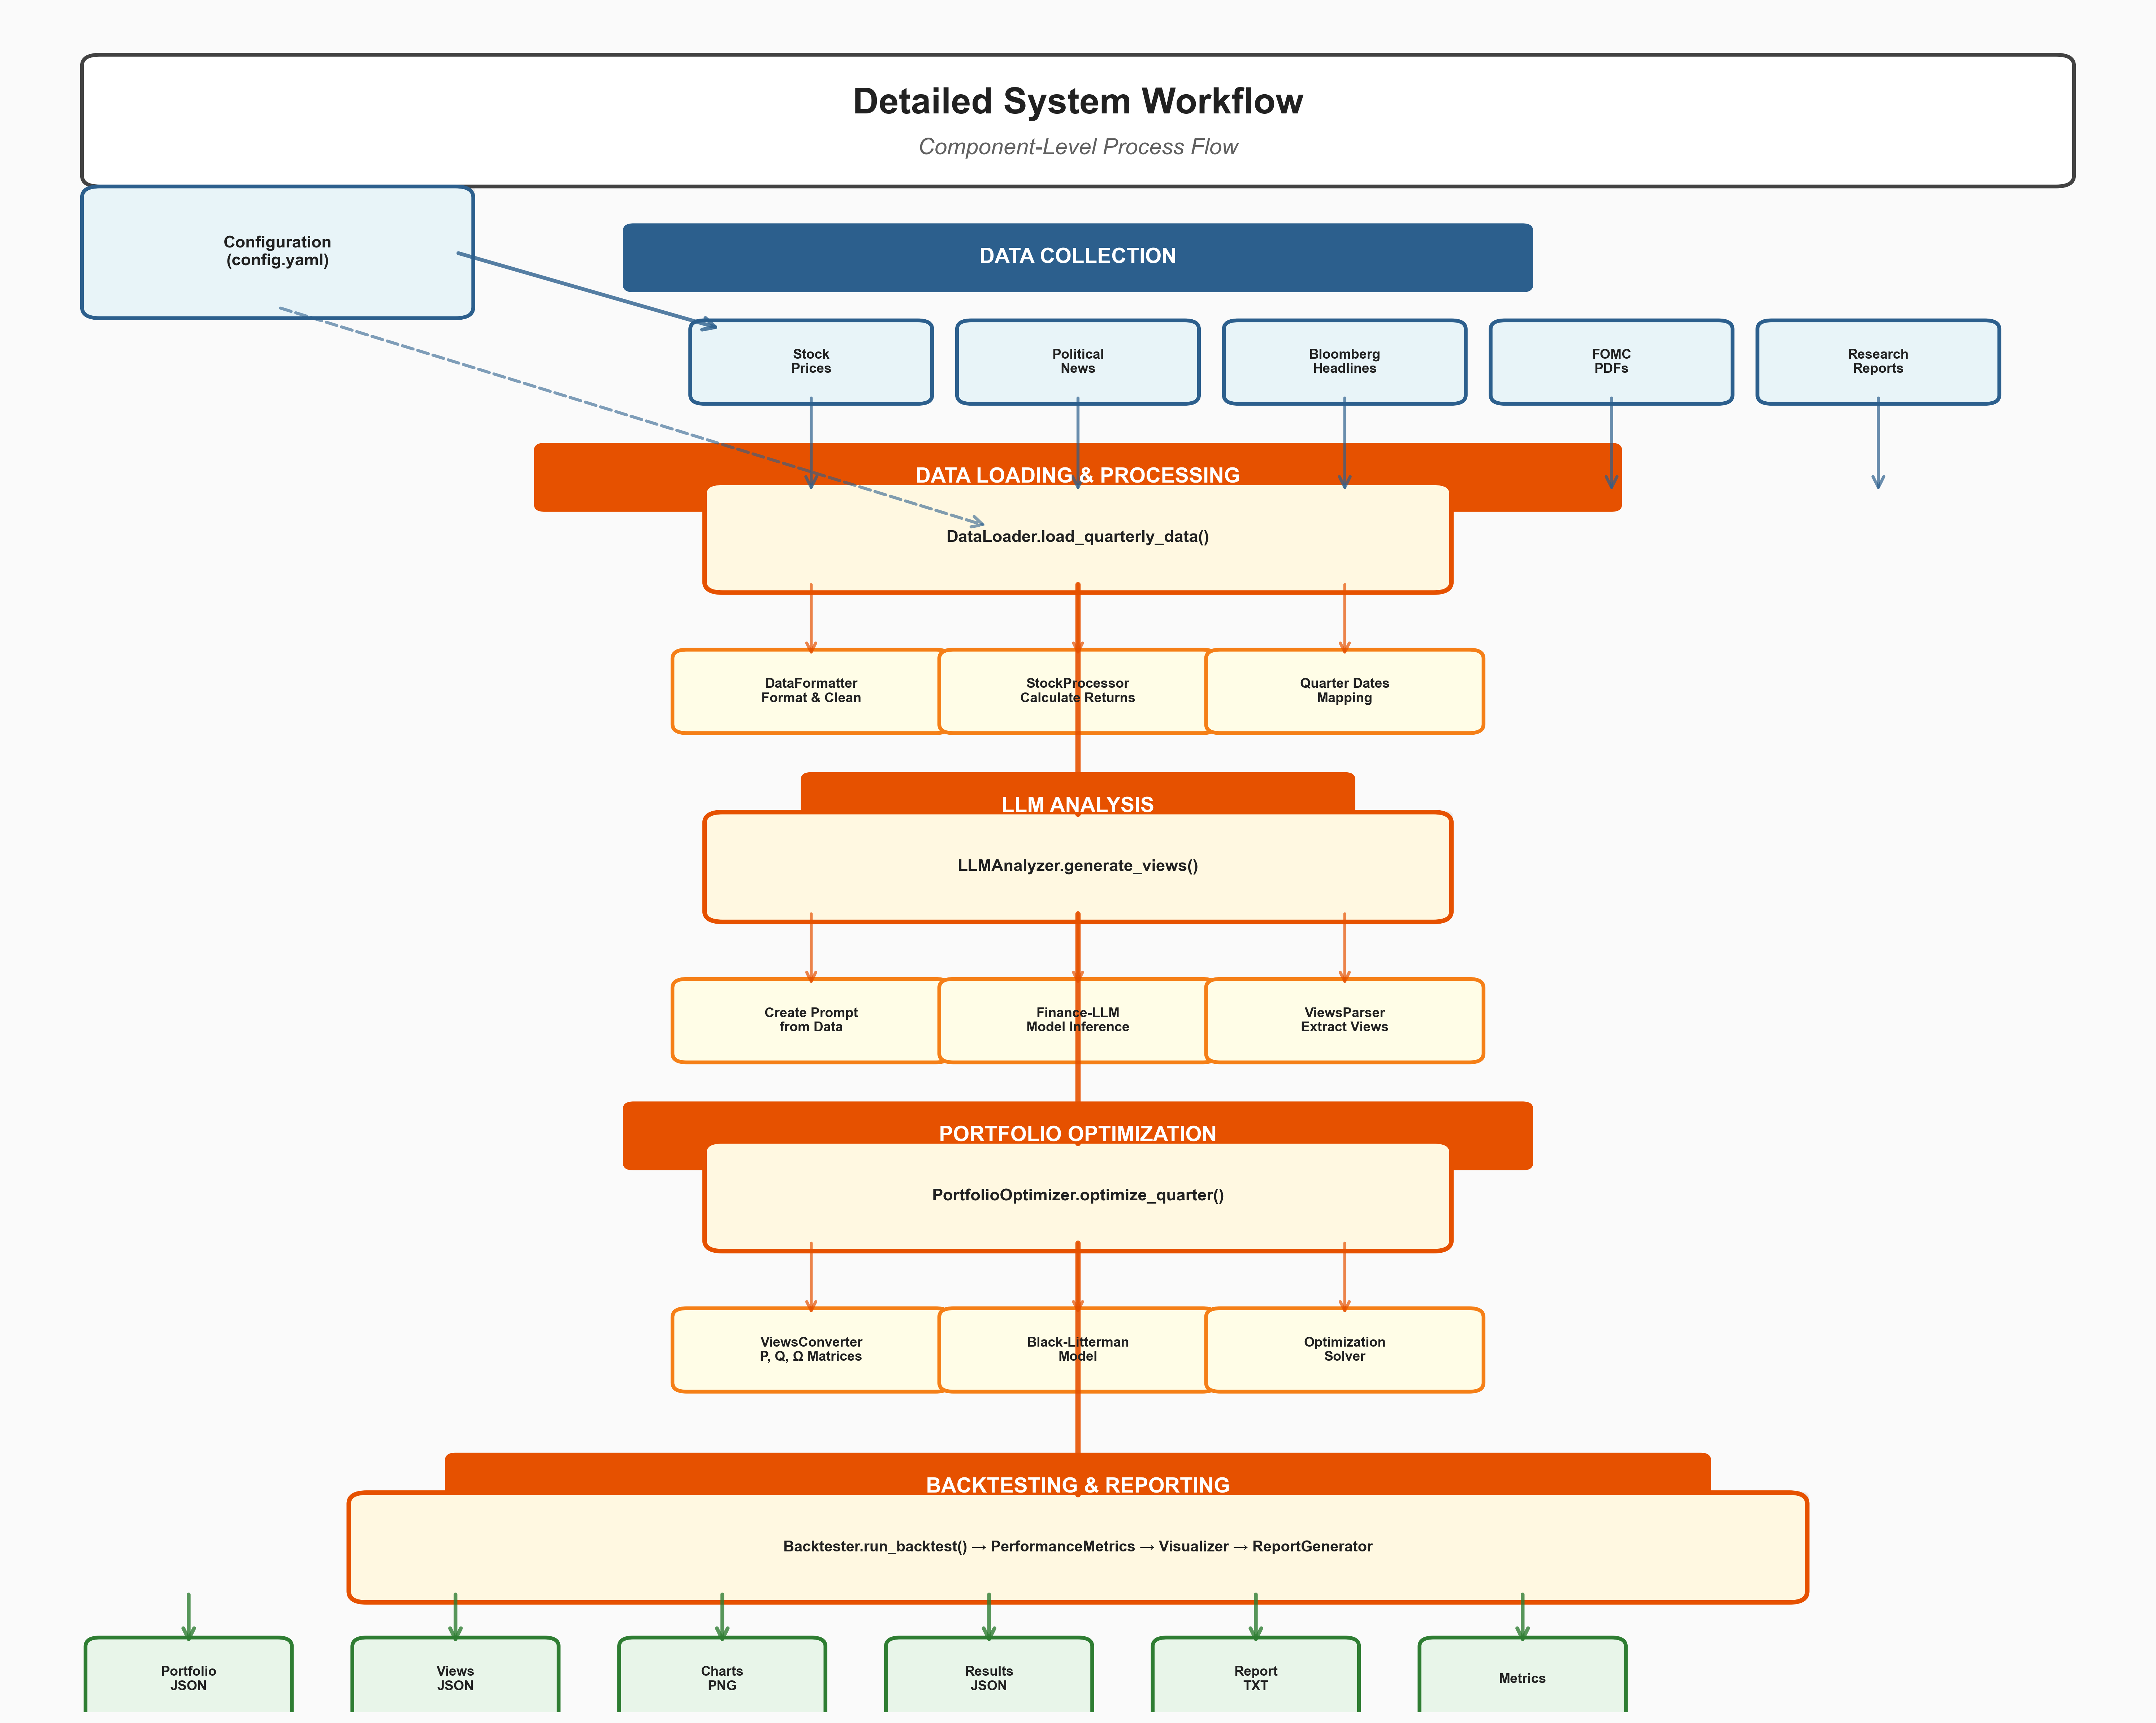
Detailed Component View (output/workflow_diagram_detailed.png):
For more information about generating and customizing these diagrams, see WORKFLOW_DIAGRAM_README.md.
Reference: See RESULTS_SUMMARY.md for detailed performance analysis and backtesting results.
Data Sources → Data Pipeline → LLM Analysis → Views Matrix → Black-Litterman → Portfolio → Backtesting → Reports
Data Pipeline (data/)
loader.py: Load all data sources (news, FOMC, research, stock prices)formatter.py: Format data for LLM consumptionstock_processor.py: Process stock data for optimizationLLM Analysis (llm/)
analyzer.py: Main LLM interface (Finance-Llama-8B model)prompts.py: System and user prompts optimized for Llama instruction formatviews_parser.py: Parse and validate LLM output with robust JSON extractionOptimization (optimization/)
portfolio_optimizer.py: Portfolio optimization wrapperviews_converter.py: Convert LLM views to P, Q, Ω matricesBlackLitterman/BlackLitterman.py implementationBacktesting (backtesting/)
backtester.py: Simulate portfolio performancemetrics.py: Calculate performance metricsvisualization.py: Generate chartsReporting (reports/)
report_generator.py: Create comprehensive reports# Install dependencies
pip install -r requirements.txt
# For local LLM (Finance-Llama-8B)
pip install transformers torch accelerate
This system uses Finance-Llama-8B (tarun7r/Finance-Llama-8B), a Llama-based model fine-tuned for financial analysis:
| Feature | Details |
|---|---|
| Model | tarun7r/Finance-Llama-8B |
| Size | ~16GB download |
| Format | Llama instruction format |
| Output | Structured JSON investment views |
| Hardware | GPU recommended (works on CPU) |
| Memory | ~16GB RAM/VRAM |
The model generates structured investment views with expected returns, confidence levels, and reasoning for each sector ETF.
Reference: See HYPERPARAMETER_GUIDE.md for temperature tuning and other LLM parameter optimization.
Run the complete pipeline with default settings (simulated LLM):
python main.py
# Use Finance-Llama-8B local model (default)
python main.py --llm-type finance-llama

# Use simulated mode (fallback, for testing)
python main.py --llm-type simulated

# Process specific quarters
python main.py --quarters Q1_2024 Q2_2024 Q3_2024

# Skip chart generation
python main.py --skip-charts
finance-llama (default): tarun7r/Finance-Llama-8B local model
transformers and torch packagessimulated: Rule-based views generation (fallback only)
The system uses your existing collected data:
political_news_data/ (GDELT articles) — See README_political_news.md for collection detailsFinance and Investments Group Final Project/FOMC data/Finance and Investments Group Final Project/Investor Research/Finance and Investments Group Final Project/Bloomberg Headlines/Finance and Investments Group Final Project/Stock Data.xlsxAfter running the pipeline, find results in:
output/portfolios/: Quarterly portfolio allocations (JSON)output/views/: LLM-generated investment views (JSON)output/charts/: Performance visualizations (PNG)output/reports/: Full analysis report (TXT, JSON)output/workflow_diagram.png: System workflow diagram (high-level)output/workflow_diagram_detailed.png: Detailed component workflow diagramReference: See RESULTS_SUMMARY.md for a detailed analysis of the backtesting results, performance metrics, and quarterly breakdowns.
config.yaml: System configuration parametersrequirements.txt: Python dependenciesmain.py: End-to-end execution pipelineBlackLitterman/BlackLitterman.py: Core optimization model (existing)For each quarter, the system loads:
Data Quality Checks:
The LLM analyzes all data sources using a structured framework and generates calibrated investment views:
Analysis Framework:
View Generation:
{
  "quarter": "Q1_2024",
  "views": [
    {
      "type": "absolute",
      "ticker": "XLK",
      "expected_return": 0.03,
      "confidence": 75,
      "reasoning": "Strong AI momentum, favorable Fed policy..."
    },
    {
      "type": "relative",
      "ticker1": "XLK",
      "ticker2": "XLY",
      "expected_outperformance": 0.05,
      "confidence": 80,
      "reasoning": "Technology expected to outperform consumer discretionary..."
    }
  ]
}
Confidence Calibration Principles:
Convert LLM views to Black-Litterman matrices with improved uncertainty modeling:
P Matrix: View specification matrix
P[i, ticker_idx] = 1.0P[i, ticker1_idx] = 1.0, P[i, ticker2_idx] = -1.0Q Vector: Expected returns/outperformance vector
Ω Matrix: View uncertainty matrix (diagonal)
uncertainty = base_variance * exp(-4.6 * confidence/100)Combine market equilibrium with LLM views:
Prior Distribution:
Posterior Distribution:
Optimization:
Validation:
Simulate quarterly rebalancing with realistic transaction costs:
Simulation Process:
Rebalancing Logic:
Calculate comprehensive metrics with statistical significance testing:
Return Metrics:
Risk Metrics:
Risk-Adjusted Metrics:
Statistical Significance:
Turnover Analysis:
The system calculates:
Reference: See RESULTS_SUMMARY.md for actual performance results showing +47.3% total return vs +32.4% benchmark over 7 quarters.
Generated charts include:
Edit config.yaml:
black_litterman:
  risk_aversion: 2.5      # Higher = more conservative
  tau_for_covariance: 0.025  # Prior uncertainty
  tau_omega: 0.05         # Views uncertainty
Edit llm/prompts.py to customize:
Edit optimization/portfolio_optimizer.py:
Run hyperparameter optimization to find best settings:
# Random search (recommended)
python hyperparameter_optimization.py --method random --n-trials 20

# Grid search
python hyperparameter_optimization.py --method grid --max-combinations 50
Results are saved to output/hyperparameter_optimization/ with:
Reference: See HYPERPARAMETER_GUIDE.md for the complete guide including temperature tuning (0.3-0.9 range), Black-Litterman parameter optimization, Bayesian and Optuna ML-based optimization methods, and best practices.
Generate graphs and analysis from optimization results:
# Visualize latest results
python hyperparameter_visualization.py

# Visualize specific results
python hyperparameter_visualization.py --results-file path/to/results.json --analysis-file path/to/analysis.json
Creates visualizations including:
project/
├── main.py                          # Main execution pipeline
├── config.yaml                      # System configuration (hyperparameters, paths, etc.)
├── config.yaml.backup               # Backup configuration
├── config_loader.py                 # Configuration loader with defaults
├── requirements.txt                 # Python dependencies
├── README.md                        # This file
│
├── Core Modules/
│   │
│   ├── data/                        # Data loading and processing
│   │   ├── __init__.py
│   │   ├── loader.py                # Multi-source data loader (news, FOMC, research, stocks)
│   │   ├── formatter.py             # Format data for LLM consumption
│   │   └── stock_processor.py       # Process stock prices and calculate returns
│   │
│   ├── llm/                         # LLM-powered analysis
│   │   ├── __init__.py
│   │   ├── analyzer.py              # LLM interface (supports multiple models)
│   │   ├── prompts.py               # System and user prompt templates
│   │   └── views_parser.py          # Parse and validate LLM-generated views
│   │
│   ├── optimization/                # Portfolio optimization
│   │   ├── __init__.py
│   │   ├── portfolio_optimizer.py   # Black-Litterman optimization wrapper
│   │   └── views_converter.py       # Convert LLM views to P, Q, Ω matrices
│   │
│   ├── backtesting/                 # Performance analysis and simulation
│   │   ├── __init__.py
│   │   ├── backtester.py            # Simulate portfolio performance over time
│   │   ├── metrics.py               # Calculate performance metrics (Sharpe, Sortino, etc.)
│   │   └── visualization.py        # Generate performance charts
│   │
│   ├── reports/                     # Report generation
│   │   ├── __init__.py
│   │   └── report_generator.py      # Generate comprehensive analysis reports
│   │
│   └── BlackLitterman/              # Existing Black-Litterman implementation
│       ├── BlackLitterman.py       # Core optimization algorithm
│       ├── BlackLittermanData.csv  # Sample data
│       └── main.py                  # BL standalone example
│
├── Analysis & Optimization/
│   ├── hyperparameter_optimization.py    # Grid/random/ML-based hyperparameter search
│   ├── hyperparameter_visualization.py   # Visualize optimization results
│   ├── update_config_from_optimization.py # Update config with optimal params
│   └── HYPERPARAMETER_GUIDE.md           # Guide for hyperparameter tuning
│
├── Utilities & Scripts/
│   ├── collect_multiple_quarters.py      # Batch data collection utility
│   ├── political_news_collector.py       # GDELT news collection script
│   ├── workflow_diagram.py               # Generate workflow diagrams
│   ├── test.py                          # Test scripts
│   └── llm.py                           # Legacy LLM script (if exists)
│
├── Documentation/
│   ├── RESULTS_SUMMARY.md               # Performance results and analysis
│   ├── HYPERPARAMETER_GUIDE.md          # Complete hyperparameter optimization guide
│   ├── PROJECT_PRESENTATION_SUMMARY.md  # Comprehensive presentation summary
│   ├── README_political_news.md          # Political news data documentation
│   └── WORKFLOW_DIAGRAM_README.md        # Workflow diagram generation guide
│
├── Data Sources/
│   └── Finance and Investments Group Final Project/
│       ├── Bloomberg Headlines/          # Bloomberg sector headlines
│       ├── FOMC data/                    # Federal Reserve meeting minutes (PDFs)
│       ├── Investor Research/           # Quarterly research reports (PDFs)
│       ├── political_news_data/         # GDELT political news (CSV/JSON)
│       └── Stock Data.xlsx              # Historical stock prices
│
├── Notebooks/                            # Jupyter notebooks for exploration
│   ├── Data_exploration.ipynb           # Data exploration and analysis
│   └── gdelt.ipynb                      # GDELT data analysis
│
└── output/                               # Generated results (created at runtime)
    ├── portfolios/                       # Quarterly portfolio allocations (JSON)
    ├── views/                            # LLM-generated investment views (JSON)
    ├── charts/                           # Performance visualizations (PNG)
    │   ├── cumulative_returns.png
    │   ├── quarterly_returns.png
    │   ├── allocation_heatmap.png
    │   ├── drawdown.png
    │   └── risk_return.png
    ├── reports/                          # Comprehensive analysis reports
    │   ├── full_report.txt
    │   └── full_report.json
    ├── hyperparameter_optimization/      # Hyperparameter search results
    │   ├── results_*.json                # Raw optimization results
    │   ├── analysis_*.json               # Statistical analysis
    │   └── visualizations/               # Optimization visualizations
    ├── workflow_diagram.png              # High-level workflow diagram
    └── workflow_diagram_detailed.png     # Detailed component diagram
Core Pipeline:
main.py: Orchestrates the complete pipeline from data loading through backtestingconfig.yaml: Centralized configuration for all system parametersconfig_loader.py: Handles configuration loading with sensible defaultsData Processing:
data/loader.py: Loads and integrates multiple data sources (news, FOMC, research, stocks)data/formatter.py: Formats unstructured data for LLM analysisdata/stock_processor.py: Processes historical prices and calculates returns/covarianceLLM Integration:
llm/analyzer.py: Main interface to Finance-Llama-8B model with cachingllm/prompts.py: Llama instruction-format prompts optimized for JSON outputllm/views_parser.py: Robust JSON extraction with fallback parsingOptimization:
optimization/portfolio_optimizer.py: Wraps Black-Litterman with constraints and objectivesoptimization/views_converter.py: Converts LLM views to mathematical matricesAnalysis:
backtesting/backtester.py: Simulates portfolio performance with quarterly rebalancingbacktesting/metrics.py: Calculates comprehensive performance metricsbacktesting/visualization.py: Generates publication-quality chartsreports/report_generator.py: Creates detailed analysis reportsHyperparameter Optimization:
hyperparameter_optimization.py: Systematic search for optimal parametershyperparameter_visualization.py: Visualizes optimization results and parameter importanceReference: For a complete research-ready summary, see PROJECT_PRESENTATION_SUMMARY.md, which includes methodology, results, and innovation highlights.
This system provides multiple layers of analysis for rigorous research:
Start with the standard pipeline to establish baseline performance:
python main.py
This generates:
Key Files to Review:
output/reports/full_report.txt: Comprehensive text reportoutput/reports/full_report.json: Structured data for further analysisoutput/charts/: Visual performance analysisUnderstand how parameters affect performance:
# Run random search to explore parameter space
python hyperparameter_optimization.py --method random --n-trials 50

# Visualize results
python hyperparameter_visualization.py
Analysis Questions:
Output Files:
output/hyperparameter_optimization/results_*.json: Raw resultsoutput/hyperparameter_optimization/analysis_*.json: Statistical analysisoutput/hyperparameter_optimization/visualizations/: Parameter importance plotsExamine the quality and consistency of LLM-generated views:
# Review generated views
cat output/views/Q1_2024_views.json
Analysis Dimensions:
Files:
output/views/*.json: LLM-generated views with reasoningoutput/llm_responses/: Raw LLM responses (if enabled in config)Understand which data sources drive decisions:
Method:
Implementation:
data/loader.py to selectively load sourcesReference: See README_political_news.md for details on GDELT political news collection and integration.
Examine performance across different market regimes:
Questions:
Tools:
output/charts/quarterly_returns.png: Quarter-by-quarter comparisonoutput/reports/full_report.txt: Quarterly breakdown sectionbacktesting/metrics.py functionsDeep dive into risk characteristics:
Metrics to Analyze:
Visualizations:
output/charts/risk_return.png: Risk-return scatteroutput/charts/drawdown.png: Drawdown over timebacktesting/metrics.pyUnderstand allocation patterns:
Questions:
Files:
output/portfolios/*.json: Quarterly allocationsoutput/charts/allocation_heatmap.png: Visual allocation historyTest the stability of results:
Tests:
Implementation:
# Test different lookback periods
# Edit config.yaml: data.lookback_days
python main.py

# Test long-only vs long-short
python main.py --long-only
python main.py --allow-shorts

# Compare LLM vs simulated
python main.py --llm-type finance-llama
python main.py --llm-type simulated
Compare against alternative approaches:
Baselines:
Implementation:
backtesting/backtester.py to add alternative strategiesValidate that results are statistically meaningful:
Tests:
Tools:
backtesting/metrics.py as foundationThe modular structure allows easy extension:
backtesting/metrics.pybacktesting/visualization.pyreports/report_generator.pybacktesting/backtester.pydata/loader.py with new sourcesThis system was developed for MGT 6078 (Georgia Tech). Key features for academic analysis:
Reference: See PROJECT_PRESENTATION_SUMMARY.md for a comprehensive project summary suitable for presentations, including executive summary, research questions, detailed system architecture, methodology, data source integration strategies, and technical implementation details.
Academic/Educational use for MGT 6078 course project.
For guidance on improving code quality, testing, and best practices:
pytest after installing dev dependencies (pip install -r requirements-dev.txt)black . to format code, isort . to sort importsflake8 . to check code quality| Document | Purpose |
|---|---|
| HYPERPARAMETER_GUIDE.md | Parameter tuning best practices |
| WORKFLOW_DIAGRAM_README.md | System architecture visualization |
| RESULTS_SUMMARY.md | Performance validation and metrics |
For questions about the system, refer to:
| Resource | Description |
|---|---|
output/reports/ | Generated analysis reports |
| RESULTS_SUMMARY.md | Performance results overview |
| HYPERPARAMETER_GUIDE.md | Parameter tuning guide |
| PROJECT_PRESENTATION_SUMMARY.md | Full project documentation |
| README_political_news.md | Data collection details |
| WORKFLOW_DIAGRAM_README.md | System architecture |
GitHub Repository: Elijah3756/MGT6078
An advanced portfolio optimization system that leverages Large Language Models (LLMs) to analyze multi-source financial data and generate investment views for Black-Litterman portfolio optimization.
| Document | Description |
|---|---|
| README.md | Main project documentation (this file) |
| RESULTS_SUMMARY.md | Performance results and backtesting analysis |
| HYPERPARAMETER_GUIDE.md | Complete guide to hyperparameter optimization |
| PROJECT_PRESENTATION_SUMMARY.md | Comprehensive project summary for presentations |
| WORKFLOW_DIAGRAM_README.md | Workflow diagram generation and usage |
| README_political_news.md | Political news data collection documentation |
This system combines:
The complete system workflow is visualized in the following diagrams:
High-Level Overview (output/workflow_diagram.png):
Detailed Component View (output/workflow_diagram_detailed.png):
For more information about generating and customizing these diagrams, see WORKFLOW_DIAGRAM_README.md.
Reference: See RESULTS_SUMMARY.md for detailed performance analysis and backtesting results.
Data Sources → Data Pipeline → LLM Analysis → Views Matrix → Black-Litterman → Portfolio → Backtesting → Reports
Data Pipeline (data/)
loader.py: Load all data sources (news, FOMC, research, stock prices)formatter.py: Format data for LLM consumptionstock_processor.py: Process stock data for optimizationLLM Analysis (llm/)
analyzer.py: Main LLM interface (Finance-Llama-8B model)prompts.py: System and user prompts optimized for Llama instruction formatviews_parser.py: Parse and validate LLM output with robust JSON extractionOptimization (optimization/)
portfolio_optimizer.py: Portfolio optimization wrapperviews_converter.py: Convert LLM views to P, Q, Ω matricesBlackLitterman/BlackLitterman.py implementationBacktesting (backtesting/)
backtester.py: Simulate portfolio performancemetrics.py: Calculate performance metricsvisualization.py: Generate chartsReporting (reports/)
report_generator.py: Create comprehensive reports# Install dependencies
pip install -r requirements.txt
# For local LLM (Finance-Llama-8B)
pip install transformers torch accelerate
This system uses Finance-Llama-8B (tarun7r/Finance-Llama-8B), a Llama-based model fine-tuned for financial analysis:
| Feature | Details |
|---|---|
| Model | tarun7r/Finance-Llama-8B |
| Size | ~16GB download |
| Format | Llama instruction format |
| Output | Structured JSON investment views |
| Hardware | GPU recommended (works on CPU) |
| Memory | ~16GB RAM/VRAM |
The model generates structured investment views with expected returns, confidence levels, and reasoning for each sector ETF.
Reference: See HYPERPARAMETER_GUIDE.md for temperature tuning and other LLM parameter optimization.
Run the complete pipeline with default settings (simulated LLM):
python main.py
# Use Finance-Llama-8B local model (default)
python main.py --llm-type finance-llama

# Use simulated mode (fallback, for testing)
python main.py --llm-type simulated

# Process specific quarters
python main.py --quarters Q1_2024 Q2_2024 Q3_2024

# Skip chart generation
python main.py --skip-charts
finance-llama (default): tarun7r/Finance-Llama-8B local model
transformers and torch packagessimulated: Rule-based views generation (fallback only)
The system uses your existing collected data:
political_news_data/ (GDELT articles) — See README_political_news.md for collection detailsFinance and Investments Group Final Project/FOMC data/Finance and Investments Group Final Project/Investor Research/Finance and Investments Group Final Project/Bloomberg Headlines/Finance and Investments Group Final Project/Stock Data.xlsxAfter running the pipeline, find results in:
output/portfolios/: Quarterly portfolio allocations (JSON)output/views/: LLM-generated investment views (JSON)output/charts/: Performance visualizations (PNG)output/reports/: Full analysis report (TXT, JSON)output/workflow_diagram.png: System workflow diagram (high-level)output/workflow_diagram_detailed.png: Detailed component workflow diagramReference: See RESULTS_SUMMARY.md for a detailed analysis of the backtesting results, performance metrics, and quarterly breakdowns.
config.yaml: System configuration parametersrequirements.txt: Python dependenciesmain.py: End-to-end execution pipelineBlackLitterman/BlackLitterman.py: Core optimization model (existing)For each quarter, the system loads:
Data Quality Checks:
The LLM analyzes all data sources using a structured framework and generates calibrated investment views:
Analysis Framework:
View Generation:
{
  "quarter": "Q1_2024",
  "views": [
    {
      "type": "absolute",
      "ticker": "XLK",
      "expected_return": 0.03,
      "confidence": 75,
      "reasoning": "Strong AI momentum, favorable Fed policy..."
    },
    {
      "type": "relative",
      "ticker1": "XLK",
      "ticker2": "XLY",
      "expected_outperformance": 0.05,
      "confidence": 80,
      "reasoning": "Technology expected to outperform consumer discretionary..."
    }
  ]
}
Confidence Calibration Principles:
Convert LLM views to Black-Litterman matrices with improved uncertainty modeling:
P Matrix: View specification matrix
P[i, ticker_idx] = 1.0P[i, ticker1_idx] = 1.0, P[i, ticker2_idx] = -1.0Q Vector: Expected returns/outperformance vector
Ω Matrix: View uncertainty matrix (diagonal)
uncertainty = base_variance * exp(-4.6 * confidence/100)Combine market equilibrium with LLM views:
Prior Distribution:
Posterior Distribution:
Optimization:
Validation:
Simulate quarterly rebalancing with realistic transaction costs:
Simulation Process:
Rebalancing Logic:
Calculate comprehensive metrics with statistical significance testing:
Return Metrics:
Risk Metrics:
Risk-Adjusted Metrics:
Statistical Significance:
Turnover Analysis:
The system calculates:
Reference: See RESULTS_SUMMARY.md for actual performance results showing +47.3% total return vs +32.4% benchmark over 7 quarters.
Generated charts include:
Edit config.yaml:
black_litterman:
  risk_aversion: 2.5      # Higher = more conservative
  tau_for_covariance: 0.025  # Prior uncertainty
  tau_omega: 0.05         # Views uncertainty
Edit llm/prompts.py to customize:
Edit optimization/portfolio_optimizer.py:
Run hyperparameter optimization to find best settings:
# Random search (recommended)
python hyperparameter_optimization.py --method random --n-trials 20

# Grid search
python hyperparameter_optimization.py --method grid --max-combinations 50
Results are saved to output/hyperparameter_optimization/ with:
Reference: See HYPERPARAMETER_GUIDE.md for the complete guide including temperature tuning (0.3-0.9 range), Black-Litterman parameter optimization, Bayesian and Optuna ML-based optimization methods, and best practices.
Generate graphs and analysis from optimization results:
# Visualize latest results
python hyperparameter_visualization.py

# Visualize specific results
python hyperparameter_visualization.py --results-file path/to/results.json --analysis-file path/to/analysis.json
Creates visualizations including:
project/
├── main.py                          # Main execution pipeline
├── config.yaml                      # System configuration (hyperparameters, paths, etc.)
├── config.yaml.backup               # Backup configuration
├── config_loader.py                 # Configuration loader with defaults
├── requirements.txt                 # Python dependencies
├── README.md                        # This file
│
├── Core Modules/
│   │
│   ├── data/                        # Data loading and processing
│   │   ├── __init__.py
│   │   ├── loader.py                # Multi-source data loader (news, FOMC, research, stocks)
│   │   ├── formatter.py             # Format data for LLM consumption
│   │   └── stock_processor.py       # Process stock prices and calculate returns
│   │
│   ├── llm/                         # LLM-powered analysis
│   │   ├── __init__.py
│   │   ├── analyzer.py              # LLM interface (supports multiple models)
│   │   ├── prompts.py               # System and user prompt templates
│   │   └── views_parser.py          # Parse and validate LLM-generated views
│   │
│   ├── optimization/                # Portfolio optimization
│   │   ├── __init__.py
│   │   ├── portfolio_optimizer.py   # Black-Litterman optimization wrapper
│   │   └── views_converter.py       # Convert LLM views to P, Q, Ω matrices
│   │
│   ├── backtesting/                 # Performance analysis and simulation
│   │   ├── __init__.py
│   │   ├── backtester.py            # Simulate portfolio performance over time
│   │   ├── metrics.py               # Calculate performance metrics (Sharpe, Sortino, etc.)
│   │   └── visualization.py        # Generate performance charts
│   │
│   ├── reports/                     # Report generation
│   │   ├── __init__.py
│   │   └── report_generator.py      # Generate comprehensive analysis reports
│   │
│   └── BlackLitterman/              # Existing Black-Litterman implementation
│       ├── BlackLitterman.py       # Core optimization algorithm
│       ├── BlackLittermanData.csv  # Sample data
│       └── main.py                  # BL standalone example
│
├── Analysis & Optimization/
│   ├── hyperparameter_optimization.py    # Grid/random/ML-based hyperparameter search
│   ├── hyperparameter_visualization.py   # Visualize optimization results
│   ├── update_config_from_optimization.py # Update config with optimal params
│   └── HYPERPARAMETER_GUIDE.md           # Guide for hyperparameter tuning
│
├── Utilities & Scripts/
│   ├── collect_multiple_quarters.py      # Batch data collection utility
│   ├── political_news_collector.py       # GDELT news collection script
│   ├── workflow_diagram.py               # Generate workflow diagrams
│   ├── test.py                          # Test scripts
│   └── llm.py                           # Legacy LLM script (if exists)
│
├── Documentation/
│   ├── RESULTS_SUMMARY.md               # Performance results and analysis
│   ├── HYPERPARAMETER_GUIDE.md          # Complete hyperparameter optimization guide
│   ├── PROJECT_PRESENTATION_SUMMARY.md  # Comprehensive presentation summary
│   ├── README_political_news.md          # Political news data documentation
│   └── WORKFLOW_DIAGRAM_README.md        # Workflow diagram generation guide
│
├── Data Sources/
│   └── Finance and Investments Group Final Project/
│       ├── Bloomberg Headlines/          # Bloomberg sector headlines
│       ├── FOMC data/                    # Federal Reserve meeting minutes (PDFs)
│       ├── Investor Research/           # Quarterly research reports (PDFs)
│       ├── political_news_data/         # GDELT political news (CSV/JSON)
│       └── Stock Data.xlsx              # Historical stock prices
│
├── Notebooks/                            # Jupyter notebooks for exploration
│   ├── Data_exploration.ipynb           # Data exploration and analysis
│   └── gdelt.ipynb                      # GDELT data analysis
│
└── output/                               # Generated results (created at runtime)
    ├── portfolios/                       # Quarterly portfolio allocations (JSON)
    ├── views/                            # LLM-generated investment views (JSON)
    ├── charts/                           # Performance visualizations (PNG)
    │   ├── cumulative_returns.png
    │   ├── quarterly_returns.png
    │   ├── allocation_heatmap.png
    │   ├── drawdown.png
    │   └── risk_return.png
    ├── reports/                          # Comprehensive analysis reports
    │   ├── full_report.txt
    │   └── full_report.json
    ├── hyperparameter_optimization/      # Hyperparameter search results
    │   ├── results_*.json                # Raw optimization results
    │   ├── analysis_*.json               # Statistical analysis
    │   └── visualizations/               # Optimization visualizations
    ├── workflow_diagram.png              # High-level workflow diagram
    └── workflow_diagram_detailed.png     # Detailed component diagram
Core Pipeline:
main.py: Orchestrates the complete pipeline from data loading through backtestingconfig.yaml: Centralized configuration for all system parametersconfig_loader.py: Handles configuration loading with sensible defaultsData Processing:
data/loader.py: Loads and integrates multiple data sources (news, FOMC, research, stocks)data/formatter.py: Formats unstructured data for LLM analysisdata/stock_processor.py: Processes historical prices and calculates returns/covarianceLLM Integration:
llm/analyzer.py: Main interface to Finance-Llama-8B model with cachingllm/prompts.py: Llama instruction-format prompts optimized for JSON outputllm/views_parser.py: Robust JSON extraction with fallback parsingOptimization:
optimization/portfolio_optimizer.py: Wraps Black-Litterman with constraints and objectivesoptimization/views_converter.py: Converts LLM views to mathematical matricesAnalysis:
backtesting/backtester.py: Simulates portfolio performance with quarterly rebalancingbacktesting/metrics.py: Calculates comprehensive performance metricsbacktesting/visualization.py: Generates publication-quality chartsreports/report_generator.py: Creates detailed analysis reportsHyperparameter Optimization:
hyperparameter_optimization.py: Systematic search for optimal parametershyperparameter_visualization.py: Visualizes optimization results and parameter importanceReference: For a complete research-ready summary, see PROJECT_PRESENTATION_SUMMARY.md, which includes methodology, results, and innovation highlights.
This system provides multiple layers of analysis for rigorous research:
Start with the standard pipeline to establish baseline performance:
python main.py
This generates:
Key Files to Review:
output/reports/full_report.txt: Comprehensive text reportoutput/reports/full_report.json: Structured data for further analysisoutput/charts/: Visual performance analysisUnderstand how parameters affect performance:
# Run random search to explore parameter space
python hyperparameter_optimization.py --method random --n-trials 50

# Visualize results
python hyperparameter_visualization.py
Analysis Questions:
Output Files:
output/hyperparameter_optimization/results_*.json: Raw resultsoutput/hyperparameter_optimization/analysis_*.json: Statistical analysisoutput/hyperparameter_optimization/visualizations/: Parameter importance plotsExamine the quality and consistency of LLM-generated views:
# Review generated views
cat output/views/Q1_2024_views.json
Analysis Dimensions:
Files:
output/views/*.json: LLM-generated views with reasoningoutput/llm_responses/: Raw LLM responses (if enabled in config)Understand which data sources drive decisions:
Method:
Implementation:
data/loader.py to selectively load sourcesReference: See README_political_news.md for details on GDELT political news collection and integration.
Examine performance across different market regimes:
Questions:
Tools:
output/charts/quarterly_returns.png: Quarter-by-quarter comparisonoutput/reports/full_report.txt: Quarterly breakdown sectionbacktesting/metrics.py functionsDeep dive into risk characteristics:
Metrics to Analyze:
Visualizations:
output/charts/risk_return.png: Risk-return scatteroutput/charts/drawdown.png: Drawdown over timebacktesting/metrics.pyUnderstand allocation patterns:
Questions:
Files:
output/portfolios/*.json: Quarterly allocationsoutput/charts/allocation_heatmap.png: Visual allocation historyTest the stability of results:
Tests:
Implementation:
# Test different lookback periods
# Edit config.yaml: data.lookback_days
python main.py

# Test long-only vs long-short
python main.py --long-only
python main.py --allow-shorts

# Compare LLM vs simulated
python main.py --llm-type finance-llama
python main.py --llm-type simulated
Compare against alternative approaches:
Baselines:
Implementation:
backtesting/backtester.py to add alternative strategiesValidate that results are statistically meaningful:
Tests:
Tools:
backtesting/metrics.py as foundationThe modular structure allows easy extension:
backtesting/metrics.pybacktesting/visualization.pyreports/report_generator.pybacktesting/backtester.pydata/loader.py with new sourcesThis system was developed for MGT 6078 (Georgia Tech). Key features for academic analysis:
Reference: See PROJECT_PRESENTATION_SUMMARY.md for a comprehensive project summary suitable for presentations, including executive summary, research questions, detailed system architecture, methodology, data source integration strategies, and technical implementation details.
Academic/Educational use for MGT 6078 course project.
For guidance on improving code quality, testing, and best practices:
pytest after installing dev dependencies (pip install -r requirements-dev.txt)black . to format code, isort . to sort importsflake8 . to check code quality| Document | Purpose |
|---|---|
| HYPERPARAMETER_GUIDE.md | Parameter tuning best practices |
| WORKFLOW_DIAGRAM_README.md | System architecture visualization |
| RESULTS_SUMMARY.md | Performance validation and metrics |
For questions about the system, refer to:
| Resource | Description |
|---|---|
output/reports/ | Generated analysis reports |
| RESULTS_SUMMARY.md | Performance results overview |
| HYPERPARAMETER_GUIDE.md | Parameter tuning guide |
| PROJECT_PRESENTATION_SUMMARY.md | Full project documentation |
| README_political_news.md | Data collection details |
| WORKFLOW_DIAGRAM_README.md | System architecture |
GitHub Repository: Elijah3756/MGT6078



