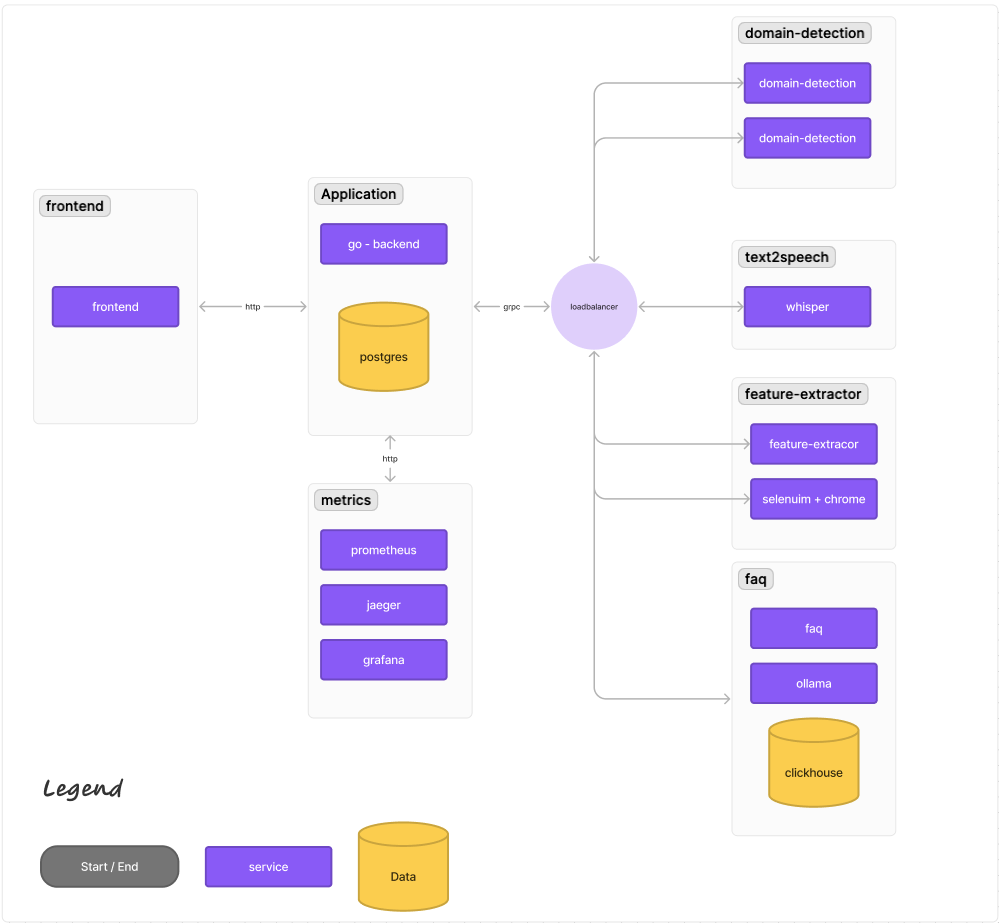
основная логика содержится в Application которое собой представляет приложение на Go. Оно связано с сервисами на python с использованием кастомного load balancer который позволяет легко масштабировать решение путем развертывания дополнительных контейнеров. Сервисы на python не содержат в себе никакого состояния все содержится в application. Из особенностей можно отметить использование clickhouse как векторное хранилище для документов и информации из faq (https://support.mts.ru).
документация для сервиса доступна по ссылке: https://api.larek.tech/swagger/index.html
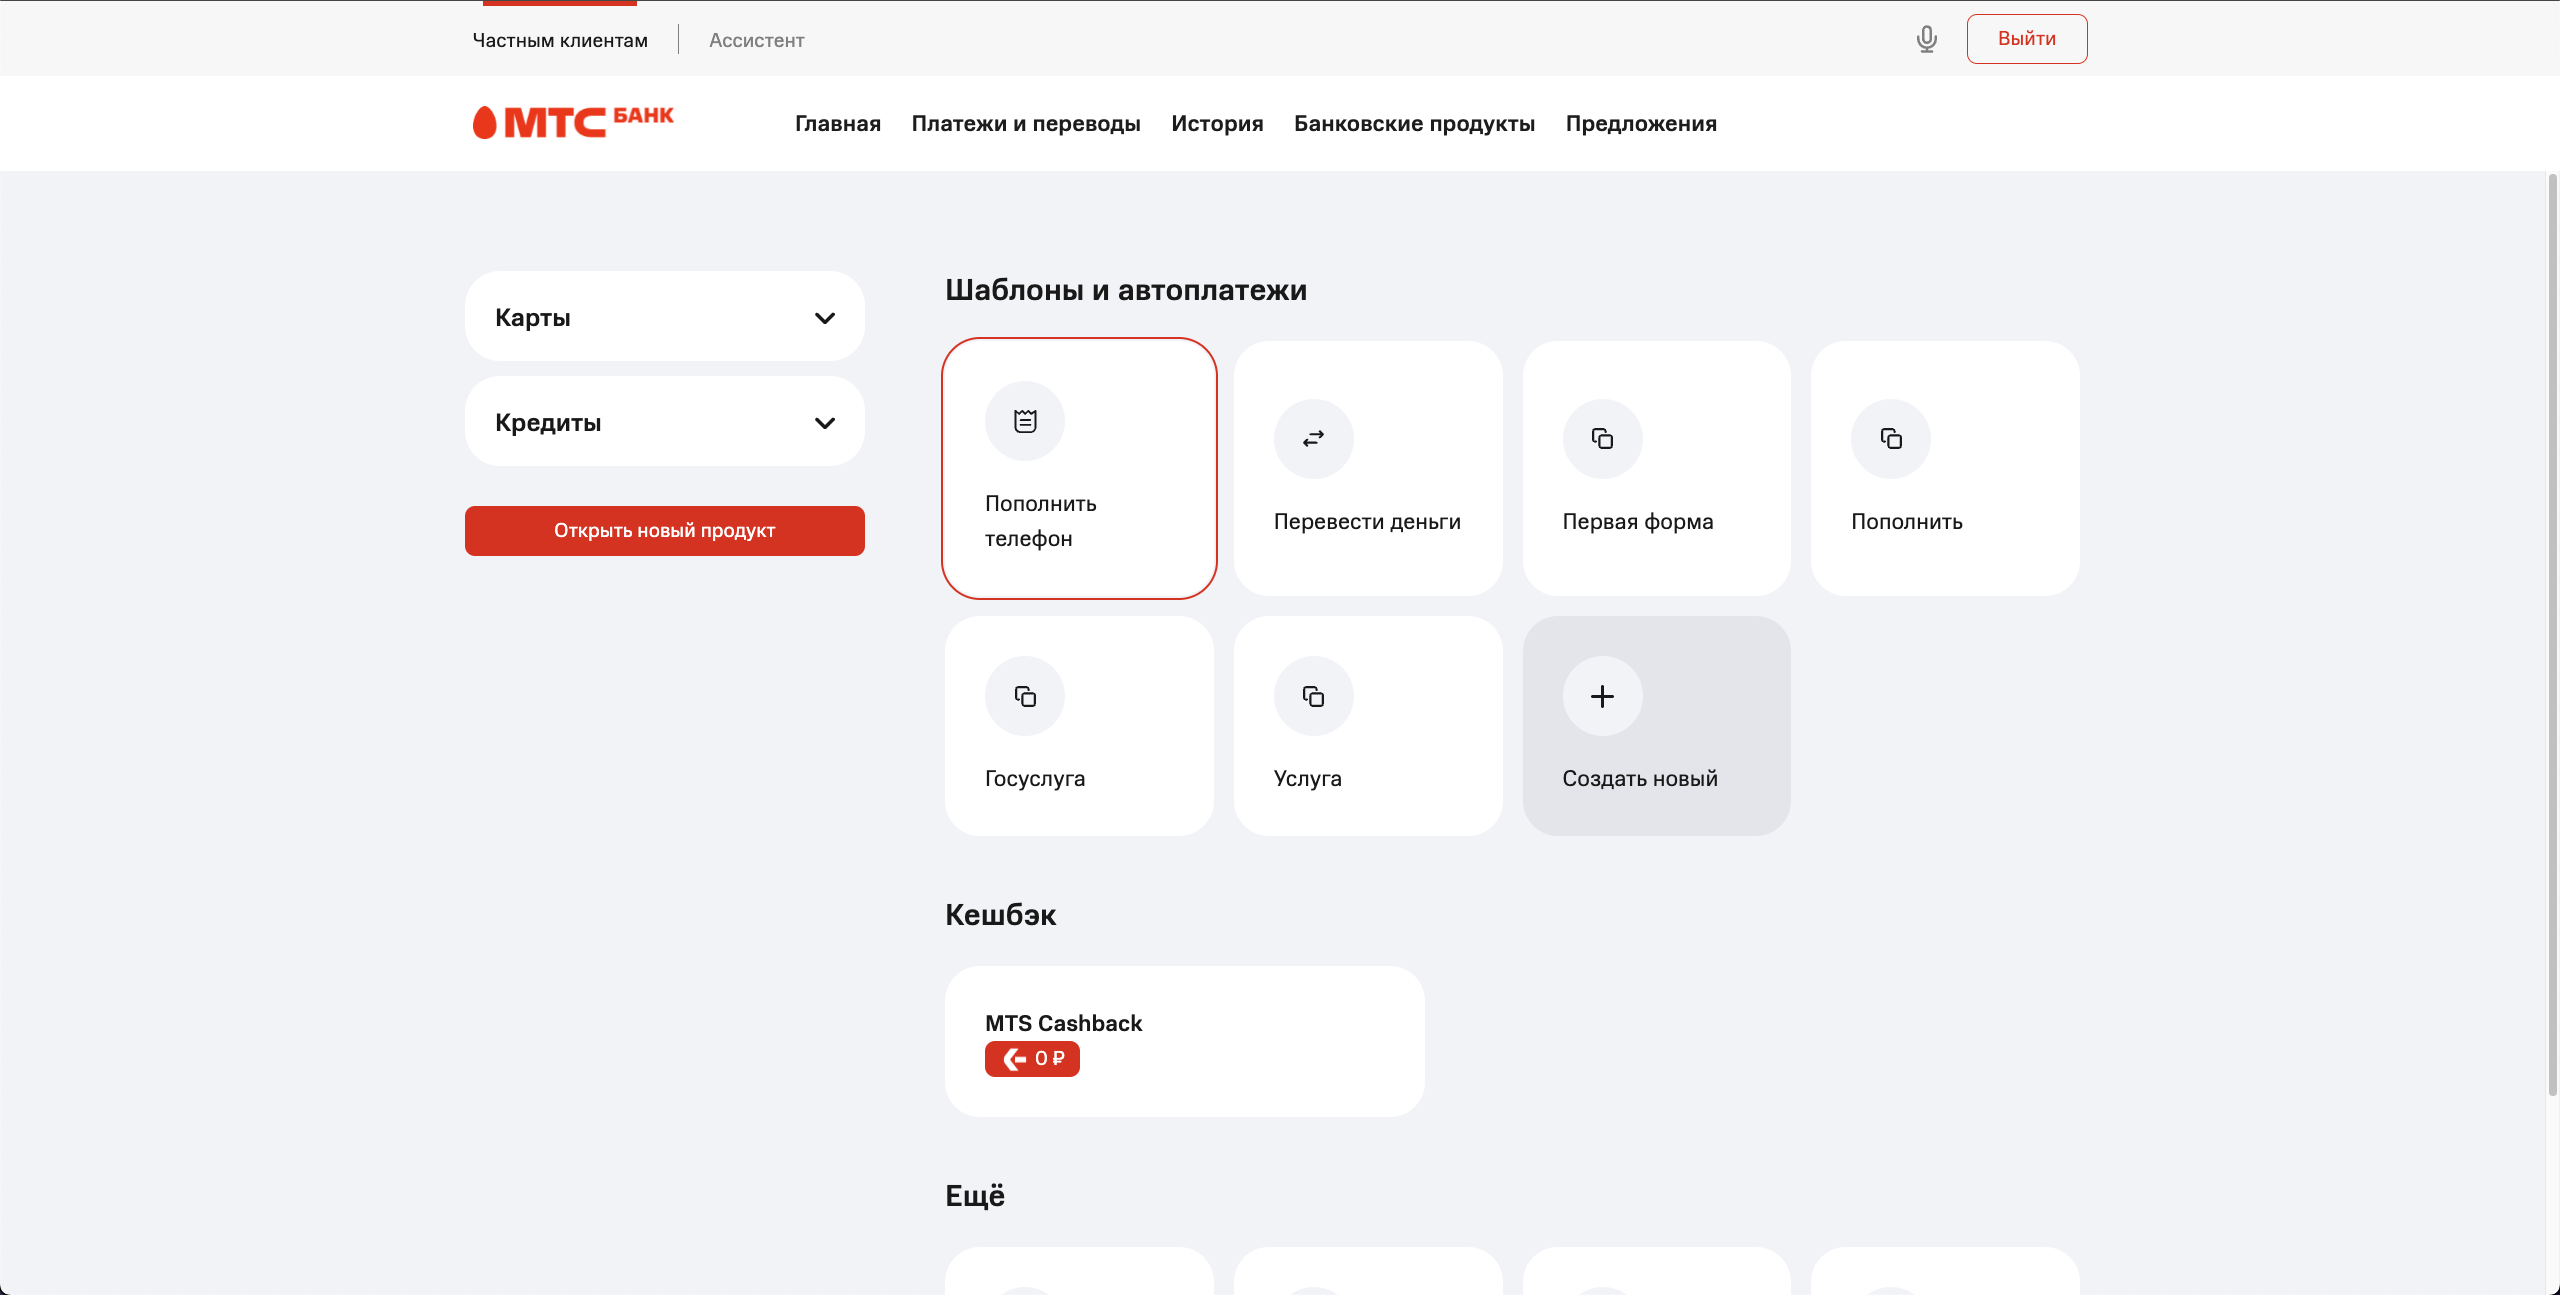
Главная страница
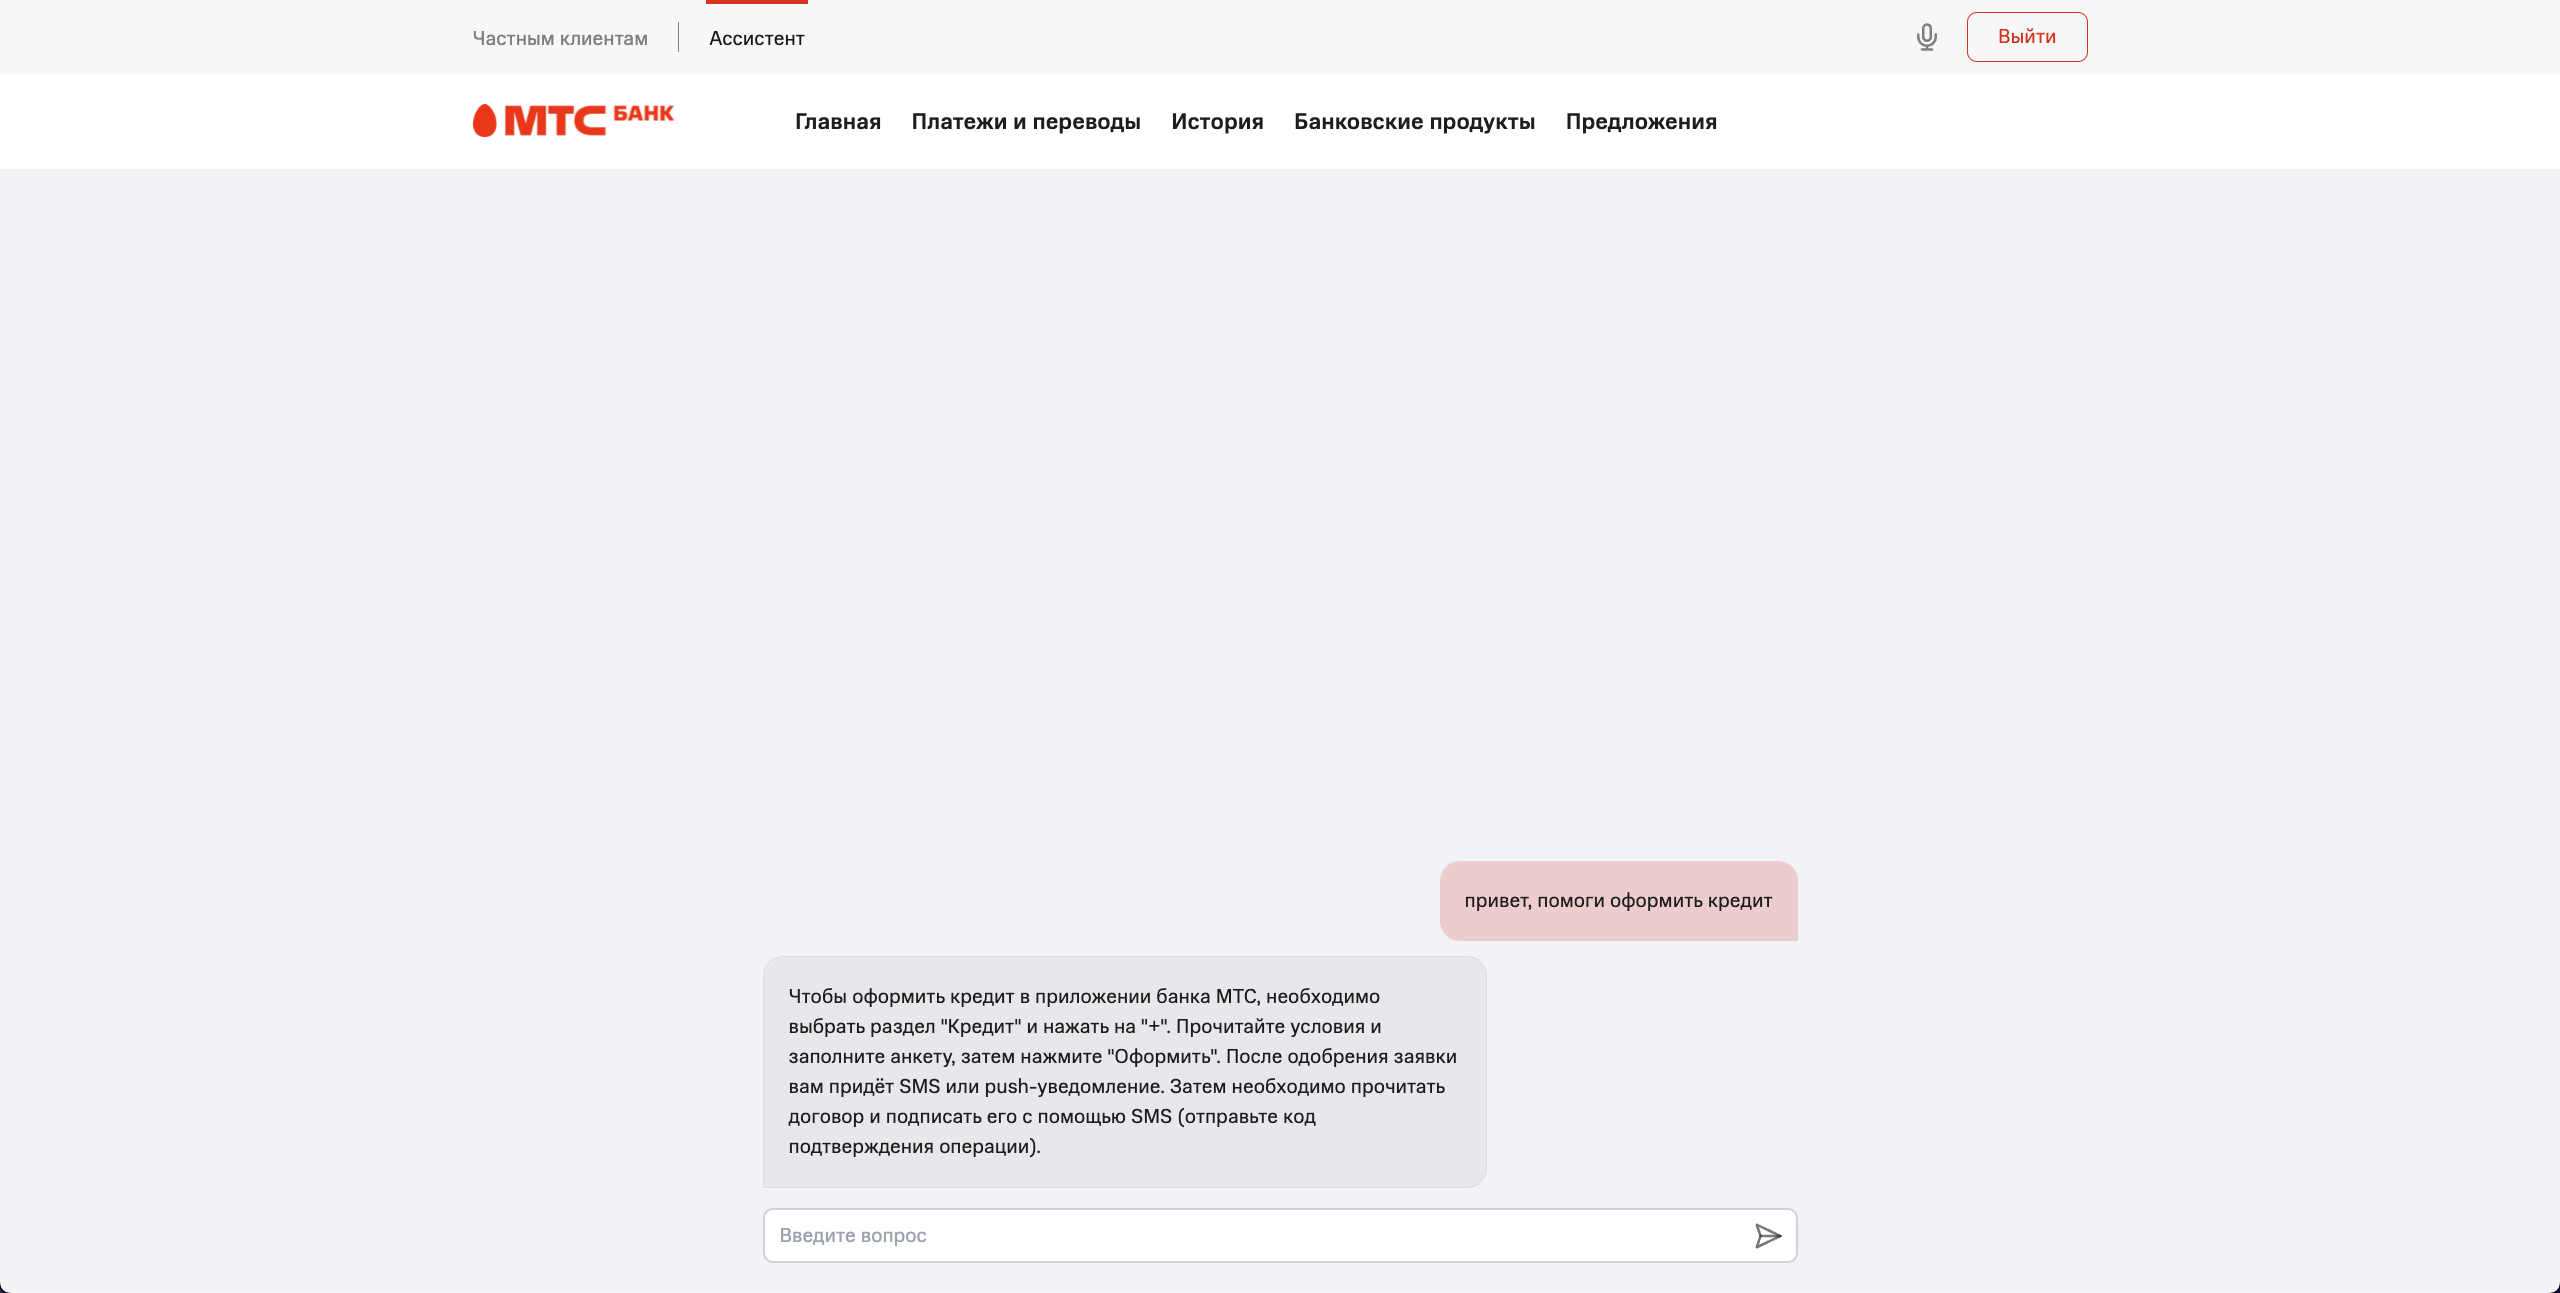
страница с ассистентом
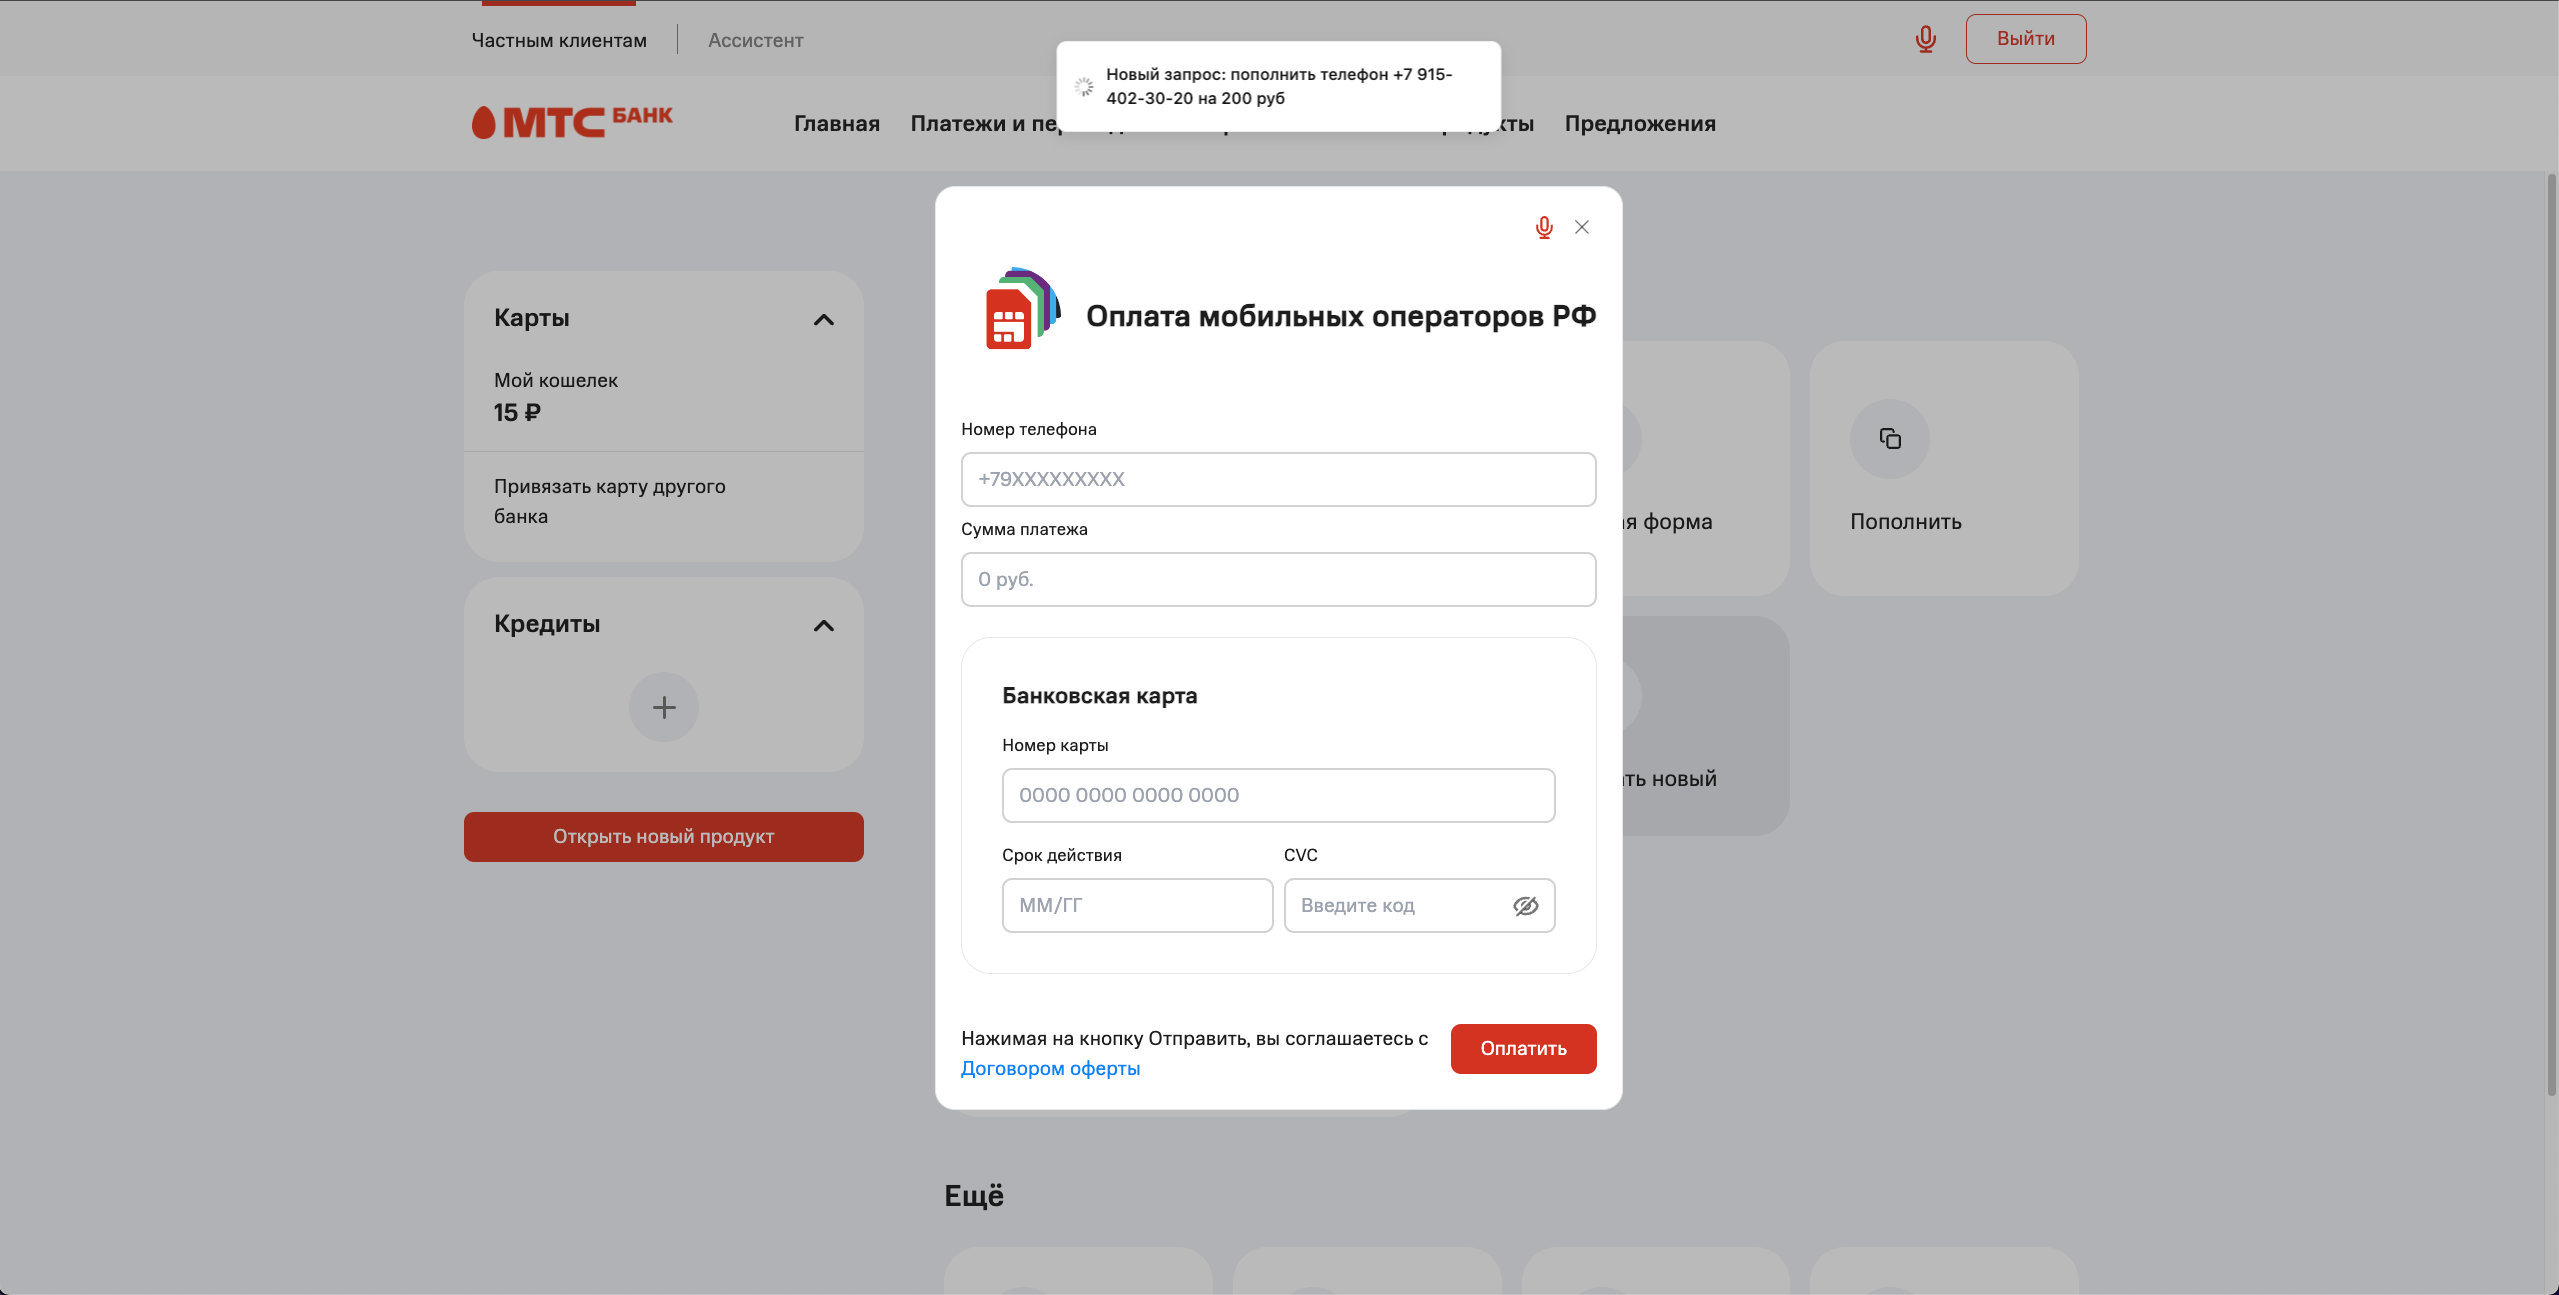
заполнения формы
демо версия доступна по ссылке: https://mts.larek.tech
скачивание моделей и расположение в папке domain-detection
установка параметров запуска в config.yaml и docker-compose.yaml
запуск приложения через docker compose / docker swarm
docker compose -f docker/docker-compose.yaml up -d --build
Модель предназначена для точного определения намерений пользователя.
0: ood (не относится к задаче)1: check_balance (проверка баланса)2: sbp3: card2card4: self5: abroad (зарубежные переводы)6: freepayment7: kvartplata, jkh (коммунальные платежи)8: mobile_phone (мобильная связь)9: transport10: ishop (интернет-магазины)import json
import os
import requests
from transformers import AutoModelForSequenceClassification, TextClassificationPipeline, AutoTokenizer
import warnings
import torch
warnings.filterwarnings("ignore")
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(device)
class SkillClassifier:
def __init__(self, base_path):
self.path = base_path
self.classifier = TextClassificationPipeline(model=self.load_model(), tokenizer=self.load_tokenizer())
def load_model(self):
return AutoModelForSequenceClassification.from_pretrained(self.path)
def load_tokenizer(self):
return AutoTokenizer.from_pretrained("ai-forever/ruRoberta-large")
def get_response(self, text: str) -> str:
label = self.classifier(text)[0]['label']
return label
classifier = SkillClassifier('path to directory')
print(classifier.get_response('your text here'))
Модель необходима для определения именованных сущностей, поступающих на вход.
from transformers import pipeline
classifier = pipeline("ner", model='path to directory', aggregation_strategy="max")

classfier(text)
основная логика содержится в Application которое собой представляет приложение на Go. Оно связано с сервисами на python с использованием кастомного load balancer который позволяет легко масштабировать решение путем развертывания дополнительных контейнеров. Сервисы на python не содержат в себе никакого состояния все содержится в application. Из особенностей можно отметить использование clickhouse как векторное хранилище для документов и информации из faq (https://support.mts.ru).
документация для сервиса доступна по ссылке: https://api.larek.tech/swagger/index.html
Главная страница
страница с ассистентом
заполнения формы
демо версия доступна по ссылке: https://mts.larek.tech
скачивание моделей и расположение в папке domain-detection
установка параметров запуска в config.yaml и docker-compose.yaml
запуск приложения через docker compose / docker swarm
docker compose -f docker/docker-compose.yaml up -d --build
Модель предназначена для точного определения намерений пользователя.
0: ood (не относится к задаче)1: check_balance (проверка баланса)2: sbp3: card2card4: self5: abroad (зарубежные переводы)6: freepayment7: kvartplata, jkh (коммунальные платежи)8: mobile_phone (мобильная связь)9: transport10: ishop (интернет-магазины)import json
import os
import requests
from transformers import AutoModelForSequenceClassification, TextClassificationPipeline, AutoTokenizer
import warnings
import torch
warnings.filterwarnings("ignore")
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(device)
class SkillClassifier:
def __init__(self, base_path):
self.path = base_path
self.classifier = TextClassificationPipeline(model=self.load_model(), tokenizer=self.load_tokenizer())
def load_model(self):
return AutoModelForSequenceClassification.from_pretrained(self.path)
def load_tokenizer(self):
return AutoTokenizer.from_pretrained("ai-forever/ruRoberta-large")
def get_response(self, text: str) -> str:
label = self.classifier(text)[0]['label']
return label
classifier = SkillClassifier('path to directory')
print(classifier.get_response('your text here'))
Модель необходима для определения именованных сущностей, поступающих на вход.
from transformers import pipeline
classifier = pipeline("ner", model='path to directory', aggregation_strategy="max")

classfier(text)



