
README
「原論文から解き明かす生成AI」学習管理リポジトリ
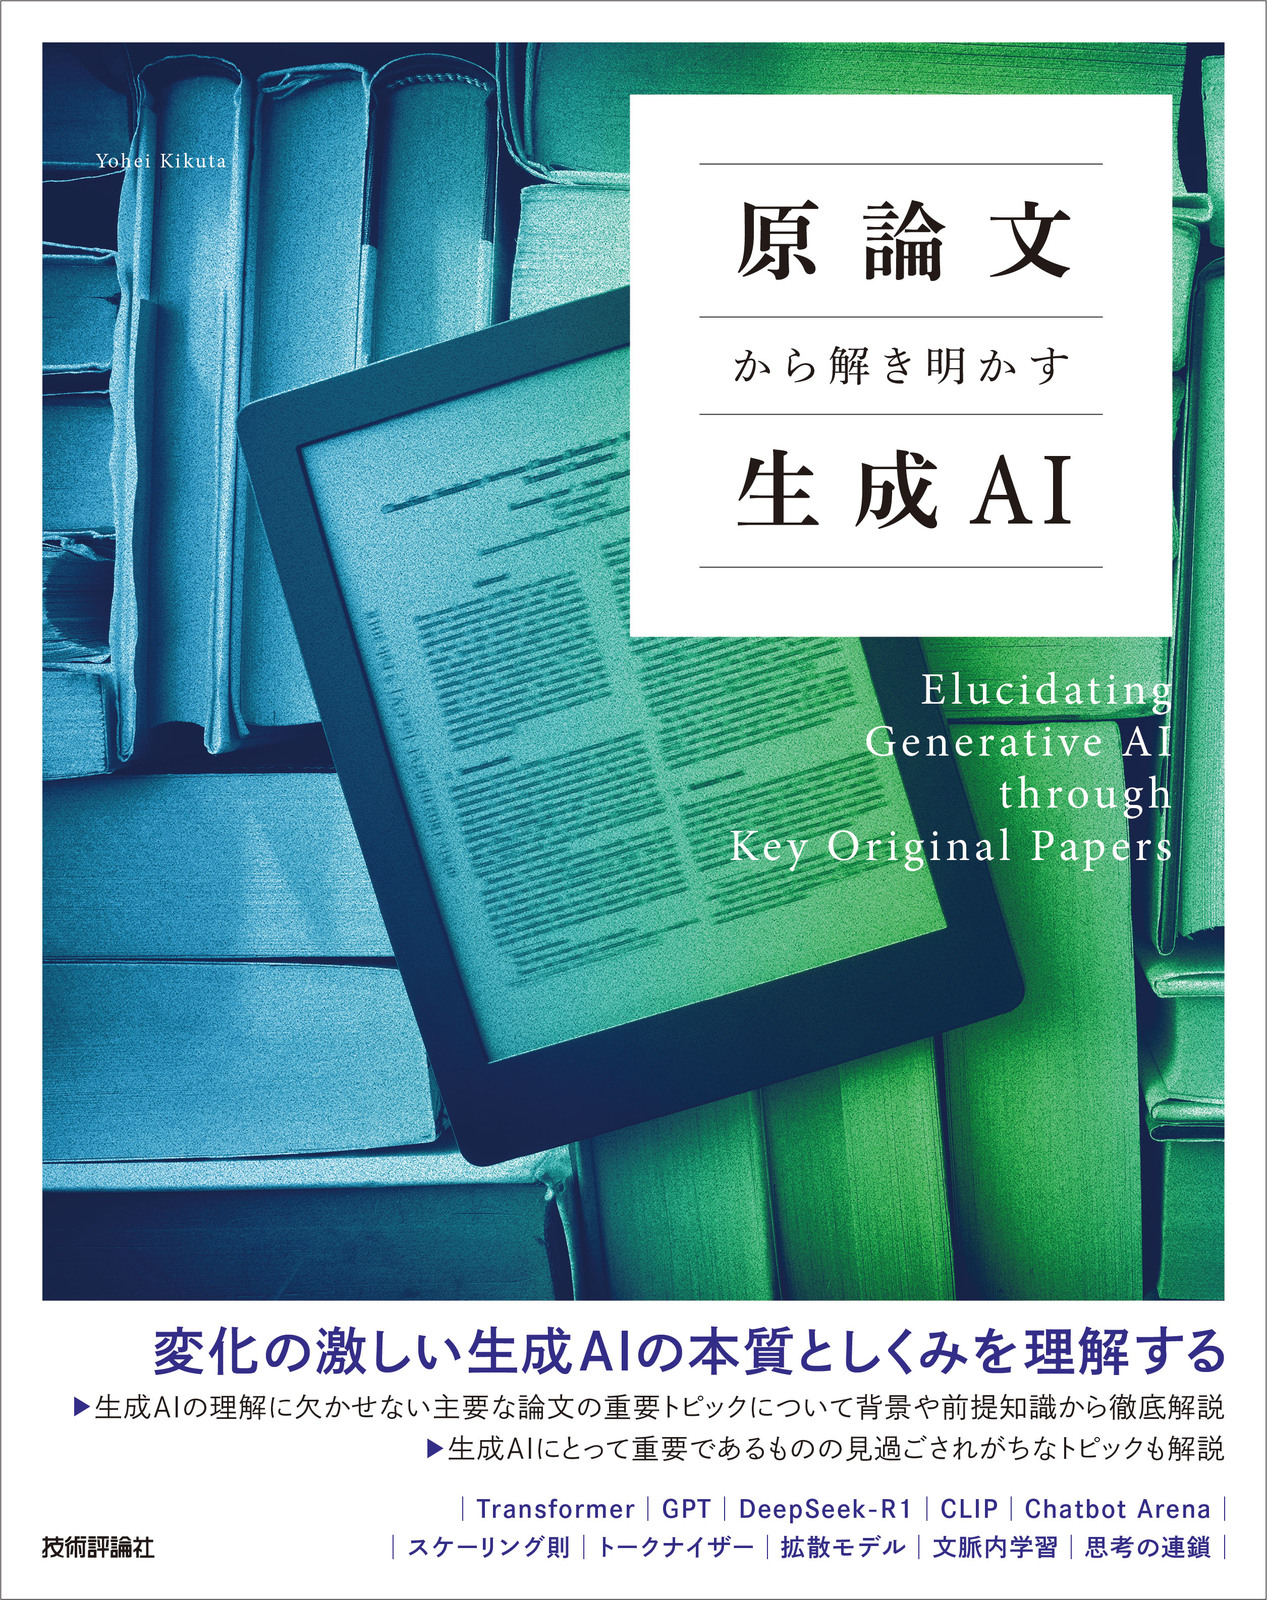
「原論文から解き明かす生成AI」(技術評論家)のリポジトリです。
本リポジトリでは、書籍を通して学んだ内容を整理し、マークダウンやコードを用いて学習内容を記録しています。
本リポジトリの使用方法
本リポジトリではVSCodeを使用した実行を想定しています。
各章で独立した管理を行うためにVSCodeのMulti-root workspaces(以降ワークスペース)を活用します。
ワークスペースでの作業は以下のいずれかの方法で行います。
- Finderやエクスプローラーで本リポジトリ内の
genai-from-papers-notes.code-workspaceファイルをダブルクリックしてVSCodeを起動する - VSCodeのメニューから
ファイル > ファイルでワークスペースを開くを選択し、genai-from-papers-notes.code-workspaceファイルを選択する
各章のコードは、chapter<章番号>ディレクトリに格納されており、ワークスペースとして個別に開くことができます。
実行する際はそれぞれの章のREADME.mdを参照し、環境構築や実行方法を確認してください。特にPythonの仮想環境はそれぞれの章のワークスペース内に作成することを想定しているのでご注意ください。
書籍目次
第1章 本書の読み方と論文を読み解く技術
1.1 本書の読み方
1.2 論文を読み解く技術
1.2.1 論文を読む環境の構築
1.2.1.1 論文を入手する
1.2.1.2 論文を電子媒体で読む
1.2.1.3 論文は人間が書いたものであることを認識する
1.2.2 自分の力で論文を読み解くための技術
1.2.2.1 議論が成立する条件を確認する
1.2.2.2 具体例を構成する
1.2.2.3 実装を読み解いて理解を深める
1.2.2.4 重要となる参考文献は踏み込んで調べる
1.2.2.5 アウトプットすることで理解を深める
1.2.3 自分以外の力も借りて論文を読み解くための技術
1.2.3.1 少人数で深く議論する
1.2.3.2 論文の著者に直接質問する
1.2.3.3 ウェブ上で議論する
1.2.3.4 生成AIを使う
1.3 本書における数式記法
第2章 入力データの特徴量化
2.1 埋め込みと分布仮説
2.2 サブワードの必要性とトークン化
2.3 バイト対符号化 (Byte Pair Encoding)
2.4 サブワードユニグラム言語モデル
2.5 SentencePiece
2.6 文字単位よりも細かいサブワード分割
2.7 トークナイザーは本当に必要なのか
第3章 生成AIモデルの大前提となるTransformer
3.1 Transformer の全体像
3.2 位置埋め込み (Positional Encoding)
3.3 マルチヘッド注意
3.3.1 注意機構 (Attention Mechanism)
3.3.2 クエリー・キー・バリューを用いた定式化
3.3.3 スケール化内積注意 (Scaled Dot-Product Attention)
3.3.4 マルチヘッド注意(Multi-Head Attention)
3.3.5 自己注意は何が優れているのか
3.4 エンコーダーとデコーダーの共通要素
3.5 デコーダーの出力部分
3.6 モデルの学習と実験結果
第4章 Generative Pre-trained Transformerとテキスト生成
4.1 複数タスクモデルとしての GPT-1, 2
4.1.1 GPT-1
4.1.2 GPT-2
4.2 生成モデルとしての GPT-3, 4
4.2.1 GPT-3
4.2.2 GPT-4
4.3 テキスト生成モデルの性能を高めるための要素
4.3.1 学習の新たなパラダイムとなる文脈内学習
4.3.2 Reinforcement Learning from Human Feedback
第5章 拡散モデルと画像生成
5.1 画像分類モデルとしての Vision Transformer
5.2 拡散モデル
5.2.1 拡散過程と逆拡散過程が同じ関数形で表現できる理由
5.2.2 Denoising Diffusion Probabilistic Models (DDPM)
5.3 画像生成モデル Diffusion Transformer
第6章 テキストと画像の融合
6.1 テキストと画像の特徴量を関係づけるCLIP
6.2 text-to-imageモデル unCLIP
6.3 text+image-to-imageモデル Imagic
6.4 text+image-to-text の実現方法
第7章 生成 AI モデルのスケーリング則
7.1 生成AIモデルの事前学習スケーリング則
7.1.1 テキスト生成モデルの事前学習のスケーリング則
7.1.2 様々なモデルや領域における事前学習のスケーリング則
7.1.3 テキスト生成モデルの学習データ量の限界
7.2 テキスト生成の推論スケーリング則
7.2.1 DeepSeek-V3
7.2.2 思考の連鎖 (Chain-of-Thought)
7.2.3 DeepSeek-R1
第8章 生成 AI モデルの評価
8.1 人間による相対評価
8.2 高い専門性を有するタスクでの評価
Appendix
A.1 参考文献の取り扱い
A.2 Landauのビッグオー記法と計算量
このリポジトリの使い方
本リポジトリでは、各セクションごとにブランチを作成して作業を行うようにしてください。
例:2.1のノートを記録する場合
- 最初に必ずブランチを作成して移動
git checkout -b chapter2/section1 - ノートやコードを記録し、都度コミット・リモートリポジトリのブランチにpush
git add chapter2/notes/2.1.md git commit -m "Add notes for section 2.1" git push origin chapter2/section1 - 作業が完了したら、リモートにpushし、Pull Request(PR)を作成
- 別の作業者が内容を確認し、問題なければ承認してメインブランチにマージ
5.プルリクエストが承認されたら、ブランチを削除
git checkout main
git branch -d chapter2/section1
git push origin --delete chapter2/section1
この流れを各セクションごとに繰り返します。
ルール
- 必ず、作業対象の章・節以外のMarkdownファイルは編集しないでください(コンフリクト防止のため)。
- ノートを取る際のブランチ名は、
chapter<章番号>/section<節番号>の形式で作成してください。- ノート以外でファイルを追加・編集する場合のブランチ名は、
change/<変更対象>の形式で作成してください。
Contributors

12 commits

6 commits
Similar repos


Languages
Jupyter Notebook
100.0%
README
「原論文から解き明かす生成AI」学習管理リポジトリ
「原論文から解き明かす生成AI」(技術評論家)のリポジトリです。
本リポジトリでは、書籍を通して学んだ内容を整理し、マークダウンやコードを用いて学習内容を記録しています。
本リポジトリの使用方法
本リポジトリではVSCodeを使用した実行を想定しています。
各章で独立した管理を行うためにVSCodeのMulti-root workspaces(以降ワークスペース)を活用します。
ワークスペースでの作業は以下のいずれかの方法で行います。
- Finderやエクスプローラーで本リポジトリ内の
genai-from-papers-notes.code-workspaceファイルをダブルクリックしてVSCodeを起動する - VSCodeのメニューから
ファイル > ファイルでワークスペースを開くを選択し、genai-from-papers-notes.code-workspaceファイルを選択する
各章のコードは、chapter<章番号>ディレクトリに格納されており、ワークスペースとして個別に開くことができます。
実行する際はそれぞれの章のREADME.mdを参照し、環境構築や実行方法を確認してください。特にPythonの仮想環境はそれぞれの章のワークスペース内に作成することを想定しているのでご注意ください。
書籍目次
第1章 本書の読み方と論文を読み解く技術
1.1 本書の読み方
1.2 論文を読み解く技術
1.2.1 論文を読む環境の構築
1.2.1.1 論文を入手する
1.2.1.2 論文を電子媒体で読む
1.2.1.3 論文は人間が書いたものであることを認識する
1.2.2 自分の力で論文を読み解くための技術
1.2.2.1 議論が成立する条件を確認する
1.2.2.2 具体例を構成する
1.2.2.3 実装を読み解いて理解を深める
1.2.2.4 重要となる参考文献は踏み込んで調べる
1.2.2.5 アウトプットすることで理解を深める
1.2.3 自分以外の力も借りて論文を読み解くための技術
1.2.3.1 少人数で深く議論する
1.2.3.2 論文の著者に直接質問する
1.2.3.3 ウェブ上で議論する
1.2.3.4 生成AIを使う
1.3 本書における数式記法
第2章 入力データの特徴量化
2.1 埋め込みと分布仮説
2.2 サブワードの必要性とトークン化
2.3 バイト対符号化 (Byte Pair Encoding)
2.4 サブワードユニグラム言語モデル
2.5 SentencePiece
2.6 文字単位よりも細かいサブワード分割
2.7 トークナイザーは本当に必要なのか
第3章 生成AIモデルの大前提となるTransformer
3.1 Transformer の全体像
3.2 位置埋め込み (Positional Encoding)
3.3 マルチヘッド注意
3.3.1 注意機構 (Attention Mechanism)
3.3.2 クエリー・キー・バリューを用いた定式化
3.3.3 スケール化内積注意 (Scaled Dot-Product Attention)
3.3.4 マルチヘッド注意(Multi-Head Attention)
3.3.5 自己注意は何が優れているのか
3.4 エンコーダーとデコーダーの共通要素
3.5 デコーダーの出力部分
3.6 モデルの学習と実験結果
第4章 Generative Pre-trained Transformerとテキスト生成
4.1 複数タスクモデルとしての GPT-1, 2
4.1.1 GPT-1
4.1.2 GPT-2
4.2 生成モデルとしての GPT-3, 4
4.2.1 GPT-3
4.2.2 GPT-4
4.3 テキスト生成モデルの性能を高めるための要素
4.3.1 学習の新たなパラダイムとなる文脈内学習
4.3.2 Reinforcement Learning from Human Feedback
第5章 拡散モデルと画像生成
5.1 画像分類モデルとしての Vision Transformer
5.2 拡散モデル
5.2.1 拡散過程と逆拡散過程が同じ関数形で表現できる理由
5.2.2 Denoising Diffusion Probabilistic Models (DDPM)
5.3 画像生成モデル Diffusion Transformer
第6章 テキストと画像の融合
6.1 テキストと画像の特徴量を関係づけるCLIP
6.2 text-to-imageモデル unCLIP
6.3 text+image-to-imageモデル Imagic
6.4 text+image-to-text の実現方法
第7章 生成 AI モデルのスケーリング則
7.1 生成AIモデルの事前学習スケーリング則
7.1.1 テキスト生成モデルの事前学習のスケーリング則
7.1.2 様々なモデルや領域における事前学習のスケーリング則
7.1.3 テキスト生成モデルの学習データ量の限界
7.2 テキスト生成の推論スケーリング則
7.2.1 DeepSeek-V3
7.2.2 思考の連鎖 (Chain-of-Thought)
7.2.3 DeepSeek-R1
第8章 生成 AI モデルの評価
8.1 人間による相対評価
8.2 高い専門性を有するタスクでの評価
Appendix
A.1 参考文献の取り扱い
A.2 Landauのビッグオー記法と計算量
このリポジトリの使い方
本リポジトリでは、各セクションごとにブランチを作成して作業を行うようにしてください。
例:2.1のノートを記録する場合
- 最初に必ずブランチを作成して移動
git checkout -b chapter2/section1 - ノートやコードを記録し、都度コミット・リモートリポジトリのブランチにpush
git add chapter2/notes/2.1.md git commit -m "Add notes for section 2.1" git push origin chapter2/section1 - 作業が完了したら、リモートにpushし、Pull Request(PR)を作成
- 別の作業者が内容を確認し、問題なければ承認してメインブランチにマージ
5.プルリクエストが承認されたら、ブランチを削除
git checkout main
git branch -d chapter2/section1
git push origin --delete chapter2/section1
この流れを各セクションごとに繰り返します。
ルール
- 必ず、作業対象の章・節以外のMarkdownファイルは編集しないでください(コンフリクト防止のため)。
- ノートを取る際のブランチ名は、
chapter<章番号>/section<節番号>の形式で作成してください。- ノート以外でファイルを追加・編集する場合のブランチ名は、
change/<変更対象>の形式で作成してください。
Similar repos
Contributors
12 commits
6 commits
Languages
Jupyter Notebook
100.0%