
README
TurnSense
🎯 轻量 · 精准 · 三分类 — 重新定义语音轮次判别
47M 参数 | 中英双语轮次判别 | F1 高达 96.35% | 无效语义过滤


语言: English | 中文
⭐ 如果 TurnSense 对你有帮助,请给我们一个 Star! 这将帮助我们持续改进模型与文档。
📖 目录
📰 News
- 2026.05.22:发布 TurnSense 1.1。该版本重点增强英文轮次判别能力,尤其提升
complete与incomplete语义状态的区分能力。模型已发布至 Hugging Face:brgroup/TurnSense。
🏆 为什么选择 TurnSense
| 维度 | TurnSense 表现 |
|---|---|
| 🎯 准确率 | 在 easyturn_real_test_ZH 上 F1 达 96.35% — 同类模型中表现最优 |
| 🌐 语言支持 | TurnSense 1.1 增强英文轮次判别能力,同时支持中文与英文场景 |
| 📦 模型体积 | 仅 47M 参数,INT8 版本约 50MB |
| 🧠 分类能力 | 首个原生支持 complete / incomplete / invalid 三分类检测的开源模型 |
| 🚫 无效过滤 | 无效语义 F1 达 94.34%,有效降低噪声误触发 |
| 🤗 开源友好 | 提供 FP32 / INT8 ONNX 模型,开箱即用 |
📌 项目简介
TurnSense 是一个面向人机语音交互场景的 三分类语义轮次判别模型。它专注解决对话系统中的一个核心问题:
用户说话过程中,系统应该立即响应,还是继续等待?
传统方案通常只做二分类的“是否结束”判断。TurnSense 更进一步,同时建模语义完整度与无效输入识别,帮助系统在复杂真实场景下实现更自然的轮次衔接,并显著减少误打断、抢话和无效触发。
🎬 演示视频
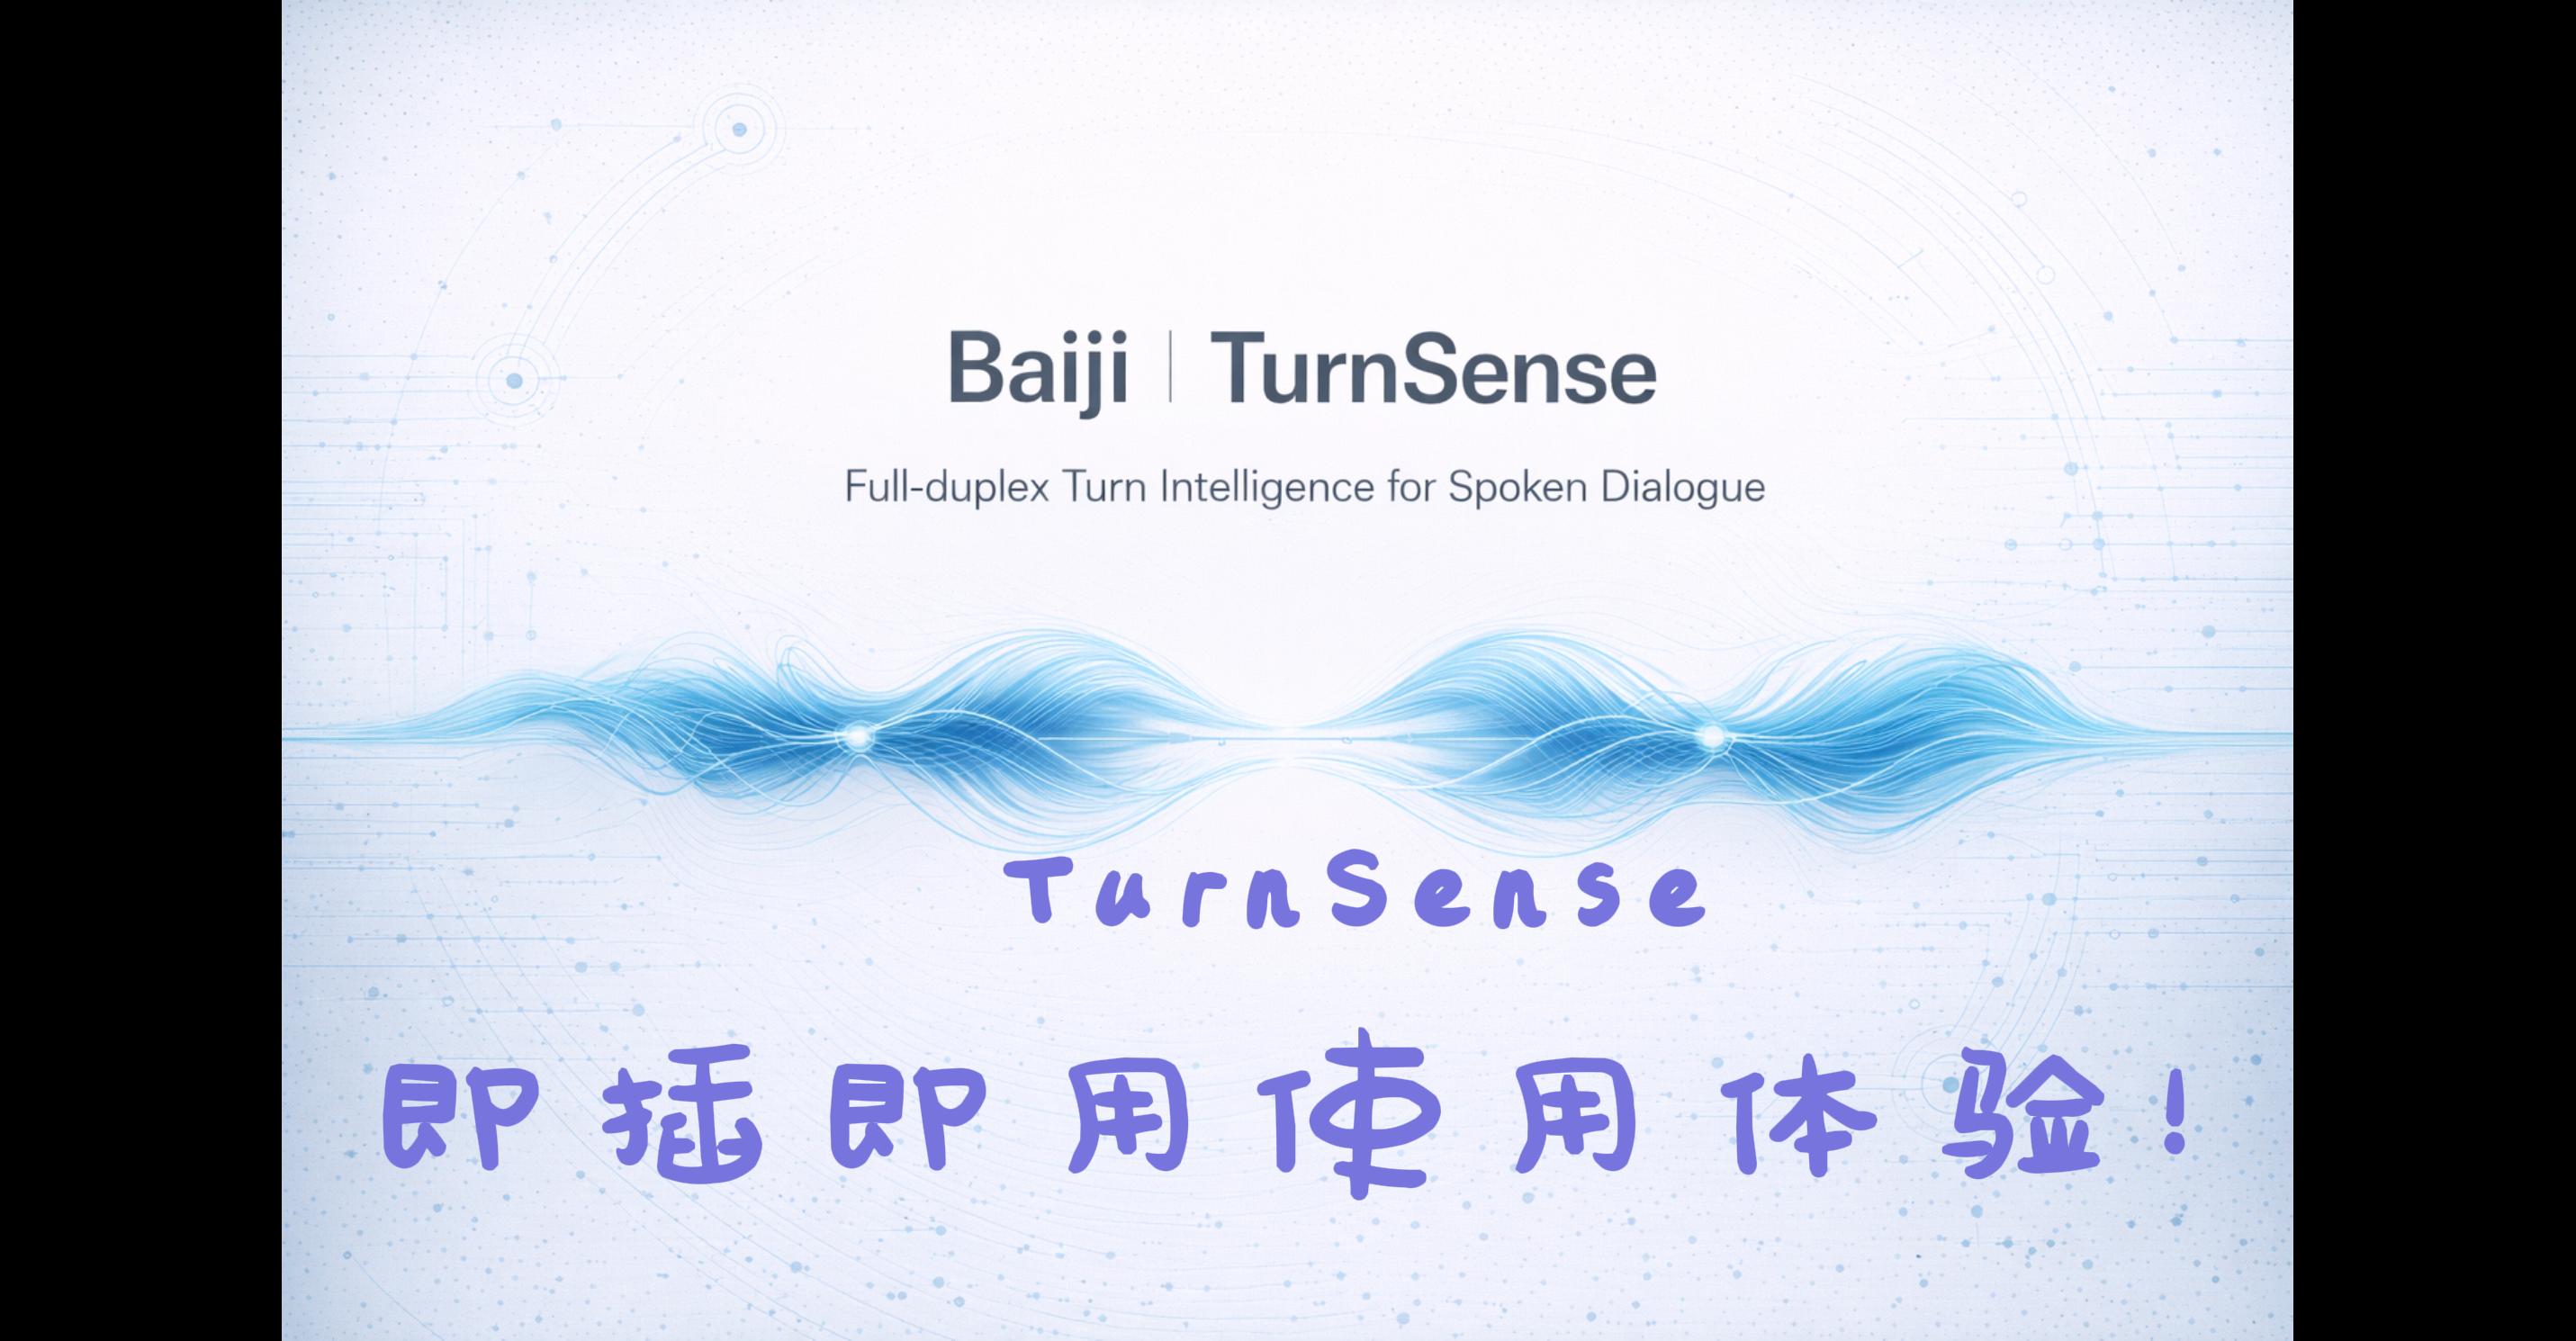
TurnSense 将用户输入划分为三种语义状态:
| 状态 | 含义 | 示例 |
|---|---|---|
| ✅ 完整语义 (complete) | 用户表达已形成完整意图,系统可以响应 | "帮我查一下明天上海天气。" |
| ⏳ 不完整语义 (incomplete) | 用户表达尚未完成,可能在停顿或截断后继续 | "我想问一下那个订单就是昨天..." |
| 🔇 无效语义 (invalid) | 输入不构成有效语义,不应触发系统响应 | "...(持续噪声 / 非语义发声)" |
这三类标签让系统不仅能判断 “是否该接话”,还能识别 “输入是否值得响应”,从而在语音助手、实时通话、智能客服等语音交互场景中提升交互自然度与系统稳定性。
✨ 核心特性
🧠 语义级三分类
TurnSense 同时建模 complete / incomplete / invalid 三种状态。相比传统二分类轮次检测,这一设计更贴近真实对话行为,也是目前唯一原生支持无效语义检测的开源方案。
🌐 TurnSense 1.1:英文能力增强
TurnSense 1.1 在保持 complete / incomplete / invalid 三分类能力的基础上,重点增强英文场景下的语义完整度判断能力。
相比初版,TurnSense 1.1 更适合用于双语语音助手、英文客服、实时会议转写与跨语言人机交互场景,能够更稳定地区分英文表达中的完整意图与未完成表达。
📦 轻量化部署
TurnSense 保持轻量化设计,参数量约 47M,并提供 FP32 / INT8 ONNX 版本,便于集成到 CPU 环境与边缘部署场景中。
🎯 精度表现强
在 easyturn_real_test_ZH 300 条测试样本上,TurnSense 在 complete 上取得 F1 96.35%,在 incomplete 上取得 F1 96.32%。在 semantic_test_ZH 2000 条测试样本上,complete F1 达 92.30%,incomplete F1 达 91.62%,达到同类模型中的最优或次优水平。
🚫 无效输入过滤
在 NonverbalVocalization 数据集上,无效语义检测达到 100% precision、90.37% recall 和 94.34% F1,能够有效抑制非语义发声和噪声导致的误触发。
⚖️ 更稳健的轮次决策
TurnSense 在语义模糊、停顿、口语化表达等场景下兼顾 precision 与 recall,减少过早响应和漏响应。
📊 可复现评测体系
项目提供完整的评测流程与脚本,支持统一指标对比与性能回归分析,确保实验结果可复现。
🤗 开源友好,即插即用
TurnSense 提供标准化仓库结构与 FP32 / INT8 ONNX 模型,从安装到推理只需几分钟。
📐 模型参数量对比
| 模型 | 参数量 | 三分类 | 链接 |
|---|---|---|---|
| TEN-Turn | 7B | ❌ | TEN-framework/TEN_Turn_Detection |
| Easy-Turn | 850M | ❌ | ASLP-lab/Easy-Turn |
| NAMO-Turn-Detector (ZH) | 66M | ❌ | videosdk-live/Namo-Turn-Detector-v1-Multilingual |
| ⭐ TurnSense | 47M | ✅ | Baiji-Team/TurnSense |
| Smart-Turn-v3 | 8M | ❌ | pipecat-ai/smart-turn-v3 |
| FireRedChat-turn-detector | -- | ❌ | FireRedTeam/FireRedChat-turn-detector |
💡 TurnSense 以仅 47M 的参数量实现原生三分类能力,在精度与模型体积之间取得了较好的平衡。
📊 基准测试结果
以下结果覆盖中文、英文与无效语义测试集。中文结果主要展示 TurnSense 初版能力,英文结果用于展示 TurnSense 1.1 的增强效果。
📋 easyturn_real_test_ZH(300 条)
数据来源:Easy-Turn-Testset 真实数据样本
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) | p50 延迟 | p90 延迟 |
|---|---|---|---|---|---|---|---|---|
| Easy-Turn | 97.26% | 94.67% | 95.95% | 94.81% | 97.33% | 96.05% | 183.87 (GPU) | 300.37 (GPU) |
| Smart-Turn-v3 | 64.97% | 76.67% | 70.34% | 71.54% | 58.67% | 64.47% | 36.84 | 39.10 |
| TEN-Turn | 99.25% | 88.00% | 93.29% | 89.22% | 99.33% | 94.01% | 17.66 (GPU) | 19.41 (GPU) |
| FireRedChat | 70.65% | 94.67% | 80.91% | 91.92% | 60.67% | 73.09% | 98.30 | 99.42 |
| NAMO-Turn | 81.53% | 85.33% | 83.39% | 84.62% | 80.67% | 82.59% | 3.60 | 83.44 |
| ⭐ TurnSense | 96.03% | 96.67% | 🏆 96.35% | 96.64% | 96.00% | 🏆 96.32% | 54.65 | 58.00 |
🔍 关键发现: TurnSense 在
complete和incomplete两类上均取得最高 F1,并且是唯一在 CPU p50 延迟低于 60ms 的同时 F1 超过 96% 的模型。
📋 semantic_test_ZH(2000 条)
数据来源:KE-Team/SemanticVAD-Dataset 中文测试集
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) | p50 延迟 | p90 延迟 |
|---|---|---|---|---|---|---|---|---|
| Easy-Turn | 78.14% | 98.30% | 87.07% | 97.64% | 70.30% | 81.74% | 183.87 (GPU) | 300.37 (GPU) |
| Smart-Turn-v3 | 59.25% | 88.10% | 70.85% | 76.80% | 39.40% | 52.08% | 36.84 | 39.10 |
| TEN-Turn | 85.25% | 99.60% | 91.87% | 99.52% | 82.70% | 90.33% | 17.66 (GPU) | 19.41 (GPU) |
| FireRedChat | 66.76% | 99.40% | 79.87% | 98.83% | 50.50% | 66.84% | 98.30 | 99.42 |
| NAMO-Turn | 71.48% | 86.70% | 78.36% | 83.10% | 65.40% | 73.20% | 3.60 | 83.44 |
| ⭐ TurnSense | 88.96% | 95.90% | 🏆 92.30% | 95.55% | 88.00% | 🏆 91.62% | 54.65 | 58.00 |
🔍 关键发现: 在 2000 条的大规模测试集上,TurnSense 依然保持最佳 F1 表现,体现出较强的泛化能力。
📋 TurnSense 1.1 英文增强结果
TurnSense 1.1 重点增强英文场景下的语义完整度判断能力。以下结果展示其在英文测试集上的
complete / incomplete表现。
ten_test_EN
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) |
|---|---|---|---|---|---|---|
| Smart-Turn-v3 | 70.66% | 72.46% | 71.55% | 65.05% | 63.02% | 64.02% |
| TEN-Turn | 98.61% | 90.25% | 94.25% | 89.15% | 98.44% | 93.56% |
| FireRedChat | 76.41% | 97.46% | 85.66% | 95.28% | 63.02% | 75.86% |
| NAMO-Turn | 92.65% | 26.69% | 41.45% | 51.94% | 97.40% | 67.75% |
| ⭐ TurnSense 1.1 int8 | 83.01% | 91.10% | 86.87% | 87.57% | 77.08% | 81.99% |
semantic_test_EN
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) |
|---|---|---|---|---|---|---|
| Smart-Turn-v3 | 68.18% | 75.00% | 71.43% | 72.22% | 65.00% | 68.42% |
| TEN-Turn | 97.98% | 97.00% | 97.49% | 97.03% | 98.00% | 97.51% |
| FireRedChat | 72.06% | 98.00% | 83.05% | 96.88% | 62.00% | 75.61% |
| NAMO-Turn | 93.55% | 87.00% | 90.16% | 87.85% | 94.00% | 90.82% |
| ⭐ TurnSense 1.1 int8 | 74.60% | 94.00% | 83.19% | 91.89% | 68.00% | 78.16% |
📋 NonverbalVocalization_invalid(728 条)
数据来源:OpenSLR Deeply Nonverbal Vocalization Dataset(SLR99)
| 模型 | R (invalid) |
|---|---|
| ⭐ TurnSense | 90.37% |
🔍 关键发现: TurnSense 支持无效语义检测,能够有效减少非语义发声或噪声触发的系统响应。
🚀 快速开始
1. 安装
git clone https://github.com/Bairong-Xdynamics/TurnSense.git
cd TurnSense

pip install -U numpy onnxruntime torch librosa soundfile pandas scikit-learn huggingface_hub
2. 获取模型权重
TurnSense 模型权重已发布在 Hugging Face:brgroup/TurnSense
| 版本 | 说明 | 适用场景 |
|---|---|---|
| TurnSense | 初版三分类轮次判别模型 | 中文轮次判别与无效语义过滤 |
| TurnSense 1.1 | 英文增强版本 | 英文 / 中英混合轮次判别 |
| FP32 | 全精度版本 | 精度优先场景 |
| INT8 | 量化版本 | 部署优先场景 |
下载方式:
方式一:自动下载(推荐)
推理脚本内置 Hugging Face 下载逻辑,首次运行时会自动下载并缓存模型。
方式二:Git LFS
git lfs install
git clone https://huggingface.co/brgroup/TurnSense
方式三:Hugging Face Hub
from huggingface_hub import snapshot_download
snapshot_download(repo_id="brgroup/TurnSense")
3. 推理
python infer.py
示例输出:
Loading model from brgroup/TurnSense...
Running inference on: "我想问一下那个订单就是昨天..."

Results:
  Input: "我想问一下那个订单就是昨天..."
  TurnSense Detection Result: "incomplete"
🧪 评测说明
1. 评测流程
- 读取
.jsonl格式的测试数据集。 - 每个模型先进行预热,默认参数为
warmup_iters=20。 - 逐样本推理,并统计分类指标与性能指标。
- 自动导出汇总报告和详细结果文件。
输出文件包括:
| 文件 | 说明 |
|---|---|
report.md | 汇总评测报告 |
results.json | 结构化评测结果 |
config.json | 评测配置 |
per_sample__*.jsonl | 逐样本预测结果 |
2. 数据格式要求(JSONL)
每一行应为一个 JSON 对象,至少包含以下字段:
| 字段 | 说明 |
|---|---|
audio_path | 音频文件路径 |
text | 文本内容 |
label | 标签:complete / incomplete / invalid |
示例:
{"audio_path":"/001.wav","text":"帮我查一下明天上海天气。","label":"complete"}
{"audio_path":"/002.wav","text":"我想问一下那个订单就是昨天...","label":"incomplete"}
{"audio_path":"/003.wav","text":"啊... 嗯... 持续噪声","label":"invalid"}
3. 运行评测
python TurnSense/Turn_benchmark/benchmark.py
📚 引用
如果你在研究或产品中使用了 TurnSense,请引用:
@misc{turnsense2026,
  author       = {Baiji Team},
  title        = {TurnSense and TurnSense 1.1: Three-Class Semantic Turn Detection for Chinese and English Speech Interaction},
  year         = {2026},
  publisher    = {Hugging Face},
  howpublished = {\url{https://huggingface.co/brgroup/TurnSense}},
}
❓ 问题与交流
如果有问题或建议,欢迎通过以下方式联系我们:
| 渠道 | 联系方式 |
|---|---|
| 📧 邮箱 | huan.shen@brgroup.com ・ yingao.wang@brgroup.com ・ wei.zou@brgroup.com |
| 💬 微信 | h2538406363 |
| 👥 微信群聊 | 扫码加入群聊 |
| 🐛 Issues | GitHub Issues |
| 🔀 PR | Pull Requests |
📄 许可证
本项目基于 Apache License 2.0 发布,并附加特定限制条件。详情请参见 LICENSE。
由 Baiji Team 用 ❤️ 打造
Contributors

87 commits
Languages
Python
100.0%
README
TurnSense
🎯 轻量 · 精准 · 三分类 — 重新定义语音轮次判别
47M 参数 | 中英双语轮次判别 | F1 高达 96.35% | 无效语义过滤
语言: English | 中文
⭐ 如果 TurnSense 对你有帮助,请给我们一个 Star! 这将帮助我们持续改进模型与文档。
📖 目录
📰 News
- 2026.05.22:发布 TurnSense 1.1。该版本重点增强英文轮次判别能力,尤其提升
complete与incomplete语义状态的区分能力。模型已发布至 Hugging Face:brgroup/TurnSense。
🏆 为什么选择 TurnSense
| 维度 | TurnSense 表现 |
|---|---|
| 🎯 准确率 | 在 easyturn_real_test_ZH 上 F1 达 96.35% — 同类模型中表现最优 |
| 🌐 语言支持 | TurnSense 1.1 增强英文轮次判别能力,同时支持中文与英文场景 |
| 📦 模型体积 | 仅 47M 参数,INT8 版本约 50MB |
| 🧠 分类能力 | 首个原生支持 complete / incomplete / invalid 三分类检测的开源模型 |
| 🚫 无效过滤 | 无效语义 F1 达 94.34%,有效降低噪声误触发 |
| 🤗 开源友好 | 提供 FP32 / INT8 ONNX 模型,开箱即用 |
📌 项目简介
TurnSense 是一个面向人机语音交互场景的 三分类语义轮次判别模型。它专注解决对话系统中的一个核心问题:
用户说话过程中,系统应该立即响应,还是继续等待?
传统方案通常只做二分类的“是否结束”判断。TurnSense 更进一步,同时建模语义完整度与无效输入识别,帮助系统在复杂真实场景下实现更自然的轮次衔接,并显著减少误打断、抢话和无效触发。
🎬 演示视频
TurnSense 将用户输入划分为三种语义状态:
| 状态 | 含义 | 示例 |
|---|---|---|
| ✅ 完整语义 (complete) | 用户表达已形成完整意图,系统可以响应 | "帮我查一下明天上海天气。" |
| ⏳ 不完整语义 (incomplete) | 用户表达尚未完成,可能在停顿或截断后继续 | "我想问一下那个订单就是昨天..." |
| 🔇 无效语义 (invalid) | 输入不构成有效语义,不应触发系统响应 | "...(持续噪声 / 非语义发声)" |
这三类标签让系统不仅能判断 “是否该接话”,还能识别 “输入是否值得响应”,从而在语音助手、实时通话、智能客服等语音交互场景中提升交互自然度与系统稳定性。
✨ 核心特性
🧠 语义级三分类
TurnSense 同时建模 complete / incomplete / invalid 三种状态。相比传统二分类轮次检测,这一设计更贴近真实对话行为,也是目前唯一原生支持无效语义检测的开源方案。
🌐 TurnSense 1.1:英文能力增强
TurnSense 1.1 在保持 complete / incomplete / invalid 三分类能力的基础上,重点增强英文场景下的语义完整度判断能力。
相比初版,TurnSense 1.1 更适合用于双语语音助手、英文客服、实时会议转写与跨语言人机交互场景,能够更稳定地区分英文表达中的完整意图与未完成表达。
📦 轻量化部署
TurnSense 保持轻量化设计,参数量约 47M,并提供 FP32 / INT8 ONNX 版本,便于集成到 CPU 环境与边缘部署场景中。
🎯 精度表现强
在 easyturn_real_test_ZH 300 条测试样本上,TurnSense 在 complete 上取得 F1 96.35%,在 incomplete 上取得 F1 96.32%。在 semantic_test_ZH 2000 条测试样本上,complete F1 达 92.30%,incomplete F1 达 91.62%,达到同类模型中的最优或次优水平。
🚫 无效输入过滤
在 NonverbalVocalization 数据集上,无效语义检测达到 100% precision、90.37% recall 和 94.34% F1,能够有效抑制非语义发声和噪声导致的误触发。
⚖️ 更稳健的轮次决策
TurnSense 在语义模糊、停顿、口语化表达等场景下兼顾 precision 与 recall,减少过早响应和漏响应。
📊 可复现评测体系
项目提供完整的评测流程与脚本,支持统一指标对比与性能回归分析,确保实验结果可复现。
🤗 开源友好,即插即用
TurnSense 提供标准化仓库结构与 FP32 / INT8 ONNX 模型,从安装到推理只需几分钟。
📐 模型参数量对比
| 模型 | 参数量 | 三分类 | 链接 |
|---|---|---|---|
| TEN-Turn | 7B | ❌ | TEN-framework/TEN_Turn_Detection |
| Easy-Turn | 850M | ❌ | ASLP-lab/Easy-Turn |
| NAMO-Turn-Detector (ZH) | 66M | ❌ | videosdk-live/Namo-Turn-Detector-v1-Multilingual |
| ⭐ TurnSense | 47M | ✅ | Baiji-Team/TurnSense |
| Smart-Turn-v3 | 8M | ❌ | pipecat-ai/smart-turn-v3 |
| FireRedChat-turn-detector | -- | ❌ | FireRedTeam/FireRedChat-turn-detector |
💡 TurnSense 以仅 47M 的参数量实现原生三分类能力,在精度与模型体积之间取得了较好的平衡。
📊 基准测试结果
以下结果覆盖中文、英文与无效语义测试集。中文结果主要展示 TurnSense 初版能力,英文结果用于展示 TurnSense 1.1 的增强效果。
📋 easyturn_real_test_ZH(300 条)
数据来源:Easy-Turn-Testset 真实数据样本
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) | p50 延迟 | p90 延迟 |
|---|---|---|---|---|---|---|---|---|
| Easy-Turn | 97.26% | 94.67% | 95.95% | 94.81% | 97.33% | 96.05% | 183.87 (GPU) | 300.37 (GPU) |
| Smart-Turn-v3 | 64.97% | 76.67% | 70.34% | 71.54% | 58.67% | 64.47% | 36.84 | 39.10 |
| TEN-Turn | 99.25% | 88.00% | 93.29% | 89.22% | 99.33% | 94.01% | 17.66 (GPU) | 19.41 (GPU) |
| FireRedChat | 70.65% | 94.67% | 80.91% | 91.92% | 60.67% | 73.09% | 98.30 | 99.42 |
| NAMO-Turn | 81.53% | 85.33% | 83.39% | 84.62% | 80.67% | 82.59% | 3.60 | 83.44 |
| ⭐ TurnSense | 96.03% | 96.67% | 🏆 96.35% | 96.64% | 96.00% | 🏆 96.32% | 54.65 | 58.00 |
🔍 关键发现: TurnSense 在
complete和incomplete两类上均取得最高 F1,并且是唯一在 CPU p50 延迟低于 60ms 的同时 F1 超过 96% 的模型。
📋 semantic_test_ZH(2000 条)
数据来源:KE-Team/SemanticVAD-Dataset 中文测试集
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) | p50 延迟 | p90 延迟 |
|---|---|---|---|---|---|---|---|---|
| Easy-Turn | 78.14% | 98.30% | 87.07% | 97.64% | 70.30% | 81.74% | 183.87 (GPU) | 300.37 (GPU) |
| Smart-Turn-v3 | 59.25% | 88.10% | 70.85% | 76.80% | 39.40% | 52.08% | 36.84 | 39.10 |
| TEN-Turn | 85.25% | 99.60% | 91.87% | 99.52% | 82.70% | 90.33% | 17.66 (GPU) | 19.41 (GPU) |
| FireRedChat | 66.76% | 99.40% | 79.87% | 98.83% | 50.50% | 66.84% | 98.30 | 99.42 |
| NAMO-Turn | 71.48% | 86.70% | 78.36% | 83.10% | 65.40% | 73.20% | 3.60 | 83.44 |
| ⭐ TurnSense | 88.96% | 95.90% | 🏆 92.30% | 95.55% | 88.00% | 🏆 91.62% | 54.65 | 58.00 |
🔍 关键发现: 在 2000 条的大规模测试集上,TurnSense 依然保持最佳 F1 表现,体现出较强的泛化能力。
📋 TurnSense 1.1 英文增强结果
TurnSense 1.1 重点增强英文场景下的语义完整度判断能力。以下结果展示其在英文测试集上的
complete / incomplete表现。
ten_test_EN
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) |
|---|---|---|---|---|---|---|
| Smart-Turn-v3 | 70.66% | 72.46% | 71.55% | 65.05% | 63.02% | 64.02% |
| TEN-Turn | 98.61% | 90.25% | 94.25% | 89.15% | 98.44% | 93.56% |
| FireRedChat | 76.41% | 97.46% | 85.66% | 95.28% | 63.02% | 75.86% |
| NAMO-Turn | 92.65% | 26.69% | 41.45% | 51.94% | 97.40% | 67.75% |
| ⭐ TurnSense 1.1 int8 | 83.01% | 91.10% | 86.87% | 87.57% | 77.08% | 81.99% |
semantic_test_EN
| 模型 | P (complete) | R (complete) | F1 (complete) | P (incomplete) | R (incomplete) | F1 (incomplete) |
|---|---|---|---|---|---|---|
| Smart-Turn-v3 | 68.18% | 75.00% | 71.43% | 72.22% | 65.00% | 68.42% |
| TEN-Turn | 97.98% | 97.00% | 97.49% | 97.03% | 98.00% | 97.51% |
| FireRedChat | 72.06% | 98.00% | 83.05% | 96.88% | 62.00% | 75.61% |
| NAMO-Turn | 93.55% | 87.00% | 90.16% | 87.85% | 94.00% | 90.82% |
| ⭐ TurnSense 1.1 int8 | 74.60% | 94.00% | 83.19% | 91.89% | 68.00% | 78.16% |
📋 NonverbalVocalization_invalid(728 条)
数据来源:OpenSLR Deeply Nonverbal Vocalization Dataset(SLR99)
| 模型 | R (invalid) |
|---|---|
| ⭐ TurnSense | 90.37% |
🔍 关键发现: TurnSense 支持无效语义检测,能够有效减少非语义发声或噪声触发的系统响应。
🚀 快速开始
1. 安装
git clone https://github.com/Bairong-Xdynamics/TurnSense.git
cd TurnSense

pip install -U numpy onnxruntime torch librosa soundfile pandas scikit-learn huggingface_hub
2. 获取模型权重
TurnSense 模型权重已发布在 Hugging Face:brgroup/TurnSense
| 版本 | 说明 | 适用场景 |
|---|---|---|
| TurnSense | 初版三分类轮次判别模型 | 中文轮次判别与无效语义过滤 |
| TurnSense 1.1 | 英文增强版本 | 英文 / 中英混合轮次判别 |
| FP32 | 全精度版本 | 精度优先场景 |
| INT8 | 量化版本 | 部署优先场景 |
下载方式:
方式一:自动下载(推荐)
推理脚本内置 Hugging Face 下载逻辑,首次运行时会自动下载并缓存模型。
方式二:Git LFS
git lfs install
git clone https://huggingface.co/brgroup/TurnSense
方式三:Hugging Face Hub
from huggingface_hub import snapshot_download
snapshot_download(repo_id="brgroup/TurnSense")
3. 推理
python infer.py
示例输出:
Loading model from brgroup/TurnSense...
Running inference on: "我想问一下那个订单就是昨天..."

Results:
  Input: "我想问一下那个订单就是昨天..."
  TurnSense Detection Result: "incomplete"
🧪 评测说明
1. 评测流程
- 读取
.jsonl格式的测试数据集。 - 每个模型先进行预热,默认参数为
warmup_iters=20。 - 逐样本推理,并统计分类指标与性能指标。
- 自动导出汇总报告和详细结果文件。
输出文件包括:
| 文件 | 说明 |
|---|---|
report.md | 汇总评测报告 |
results.json | 结构化评测结果 |
config.json | 评测配置 |
per_sample__*.jsonl | 逐样本预测结果 |
2. 数据格式要求(JSONL)
每一行应为一个 JSON 对象,至少包含以下字段:
| 字段 | 说明 |
|---|---|
audio_path | 音频文件路径 |
text | 文本内容 |
label | 标签:complete / incomplete / invalid |
示例:
{"audio_path":"/001.wav","text":"帮我查一下明天上海天气。","label":"complete"}
{"audio_path":"/002.wav","text":"我想问一下那个订单就是昨天...","label":"incomplete"}
{"audio_path":"/003.wav","text":"啊... 嗯... 持续噪声","label":"invalid"}
3. 运行评测
python TurnSense/Turn_benchmark/benchmark.py
📚 引用
如果你在研究或产品中使用了 TurnSense,请引用:
@misc{turnsense2026,
  author       = {Baiji Team},
  title        = {TurnSense and TurnSense 1.1: Three-Class Semantic Turn Detection for Chinese and English Speech Interaction},
  year         = {2026},
  publisher    = {Hugging Face},
  howpublished = {\url{https://huggingface.co/brgroup/TurnSense}},
}
❓ 问题与交流
如果有问题或建议,欢迎通过以下方式联系我们:
| 渠道 | 联系方式 |
|---|---|
| 📧 邮箱 | huan.shen@brgroup.com ・ yingao.wang@brgroup.com ・ wei.zou@brgroup.com |
| 💬 微信 | h2538406363 |
| 👥 微信群聊 | 扫码加入群聊 |
| 🐛 Issues | GitHub Issues |
| 🔀 PR | Pull Requests |
📄 许可证
本项目基于 Apache License 2.0 发布,并附加特定限制条件。详情请参见 LICENSE。
由 Baiji Team 用 ❤️ 打造
Contributors
87 commits
Languages
Python
100.0%