AI 기반 정보 수집, 요약, 개인화 시스템 개발 프로젝트입니다.
LLM과 RAG(Retrieval-Augmented Generation) 구조를 활용하여 사용자가 원하는 정보를 빠르게 가공하고 전달하는 것을 목표로 합니다.
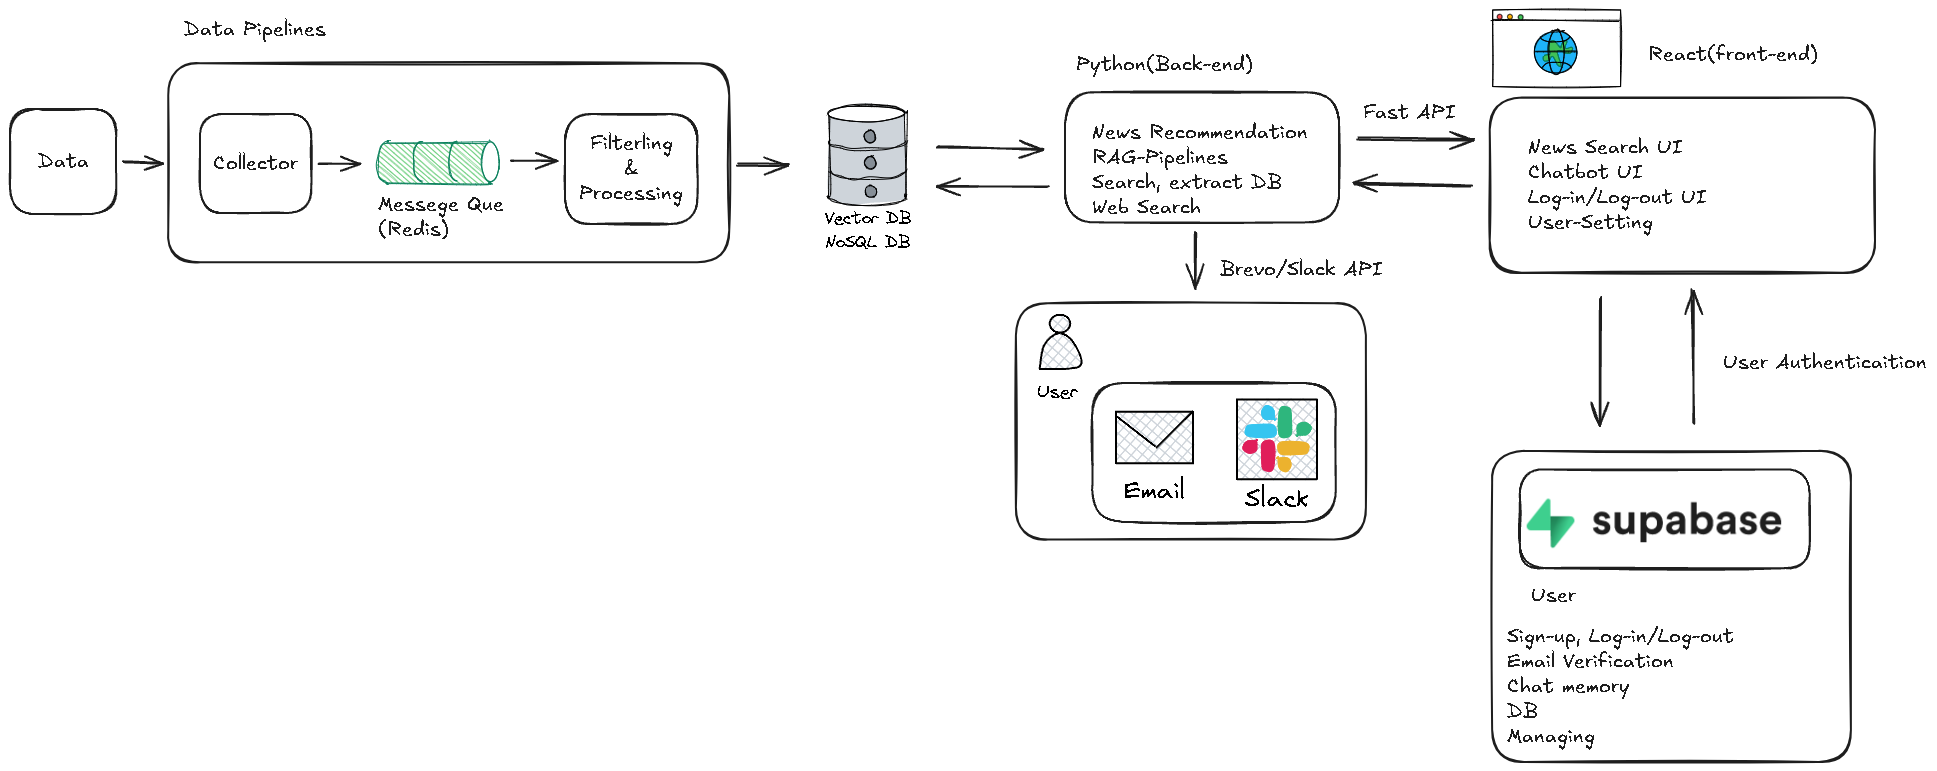
Aigen_science/
├── README.md
├── .gitignore
├── env.template                      # 환경 변수 템플릿
├── config/                           # 설정 파일들
│   └── config.yaml.template         # API 키, 모델 경로 등 설정 템플릿
├── data/                             # 수집된 데이터
│   └── data.txt                     # 데이터 파일
├── database/                         # 데이터베이스 스키마
│   ├── create_rag_tables.sql        # RAG 테이블 생성 스크립트
│   └── create_workspace.sql         # 워크스페이스 테이블 생성 스크립트
├── docker/                           # Docker 설정
│   ├── docker-compose.yml           # 멀티 컨테이너 설정
│   ├── Dockerfile                   # 각 서비스별 Dockerfile
│   ├── requirements-base.txt        # 기본 Python 패키지
│   ├── requirements-llm.txt         # LLM 관련 패키지
│   ├── requirements-rag.txt         # RAG 관련 패키지
│   └── requirements-web.txt         # 웹 관련 패키지
├── docs/                             # 문서
│   ├── DOCKER_OPTIMIZATION_README.md
│   ├── PDF_PROCESSOR_README.md
│   └── SIMPLE_NOTIFICATION_GUIDE.md
├── frontend/                         # Next.js 프론트엔드
│   ├── app/                         # App Router 페이지
│   ├── components/                  # React 컴포넌트
│   ├── lib/                         # 유틸리티 함수
│   ├── supabase/                    # 데이터베이스 스키마
│   └── package.json
├── logs/                             # 로그 파일
├── notebooks/                        # Jupyter 노트북
│   └── exploratory_analysis.ipynb
├── scripts/                          # 유틸리티 스크립트
│   ├── deploy.sh                    # 배포 스크립트
│   ├── fix_notification_query.js    # 알림 쿼리 수정 스크립트
│   ├── notification-system.service  # 알림 시스템 서비스
│   ├── start_notification_system.sh # 알림 시스템 시작 스크립트
│   └── upodate_embeddings.py        # 임베딩 업데이트 스크립트
├── src/                              # 핵심 소스 코드
│   ├── __init__.py
│   ├── celery_app.py                # Celery 애플리케이션 및 태스크 정의
│   ├── config_loader/               # 설정 로더
│   │   ├── __init__.py
│   │   ├── redis.py                 # Redis 설정
│   │   └── settings.py              # 환경 설정
│   ├── db/                          # 데이터베이스 인터페이스
│   │   └── vector_db.py             # Pinecone 벡터 DB 관리
│   ├── news_collector/              # 뉴스 수집기
│   │   ├── __init__.py
│   │   └── news_collector.py        # RSS, API 크롤러
│   ├── pipeline_stages/             # Celery 파이프라인 단계
│   │   ├── __init__.py
│   │   ├── initial_checks.py        # 1단계: 초기 유효성 검사
│   │   ├── content_extraction.py    # 2단계: 콘텐츠 추출 및 요약
│   │   ├── categorization.py        # 3단계: 기사 분류 및 키워드 추출
│   │   ├── content_analysis.py      # 4단계: 품질 분석
│   │   ├── embedding_generator.py   # 5단계: 임베딩 생성
│   │   ├── finalization.py          # 6단계: 최종 DB 저장
│   │   ├── data_extractor.py        # 데이터 추출 유틸리티
│   │   ├── intent_analyzer.py       # 의도 분석
│   │   └── dashboard_generator.py   # 대시보드 생성
│   ├── rag_graph/                   # RAG 워크플로우 (LangGraph)
│   │   ├── __init__.py
│   │   └── graph_rag.py             # RAG 그래프 정의
│   ├── services/                    # 비즈니스 로직 서비스
│   │   ├── __init__.py
│   │   ├── advanced_retrieval.py    # 고급 검색 서비스
│   │   ├── pdf_processor.py         # PDF 처리 서비스
│   │   └── web_search.py            # 웹검색 서비스
│   ├── app/                         # FastAPI 애플리케이션
│   │   ├── __init__.py
│   │   ├── news_recommendation.py   # 뉴스 추천 API
│   │   ├── news_article_api.py      # 기사 조회 API
│   │   ├── rag_api.py               # RAG 쿼리 API
│   │   ├── pdf_api.py               # PDF 처리 API
│   │   └── web_interface.py         # 웹 인터페이스
│   ├── api/                         # 테스트용 API 서버
│   │   ├── main.py                  # 간단한 쿼리 처리 API
│   │   └── Dockerfile               # API 서버용 Docker 설정
│   └── sources/                     # 외부 소스 설정
│       ├── api_sources.txt          # API 뉴스 소스 목록
│       └── rss_sources.txt          # RSS 뉴스 소스 목록
├── supabase/                        # Supabase 설정
│   ├── config.toml
│   ├── migrations/                  # 데이터베이스 마이그레이션
│   └── seed.sql
├── tests/                           # 테스트 코드
│   ├── main_test.py                 # 메인 테스트
│   ├── test_advanced_retrieval.py   # 고급 검색 테스트
│   ├── test_filter1.py              # 필터1 테스트
│   ├── test_langgraph.py            # LangGraph 테스트
│   ├── test_news_collector.py       # 뉴스 수집기 테스트
│   ├── test_news_system.py          # 뉴스 시스템 테스트
│   ├── test_news_system_production.py # 프로덕션 뉴스 시스템 테스트
│   ├── test_pdf_processor.py        # PDF 처리 테스트
│   ├── test_processor.py            # 프로세서 테스트
│   ├── test_processor_local.py      # 로컬 프로세서 테스트
│   ├── test_push_article.py         # 기사 푸시 테스트
│   └── test_simple_notification.py  # 알림 시스템 테스트
└── utils/                           # 유틸리티 스크립트
    ├── add_notification_query_column.py # 알림 쿼리 컬럼 추가
    ├── check_user_data.py           # 사용자 데이터 확인
    ├── install_gpu_driver.py        # GPU 드라이버 설치
    └── simple_notification_system.py # 간단한 알림 시스템
뉴스 소스 (RSS/API)
    ↓
뉴스 수집기 (news_collector.py)
    ↓
Stage 1: 초기 검사 (initial_checks.py)
    ├── URL 유효성 검사
    ├── 하드코딩된 URL 필터링
    ├── 발행 시간 검사 (24시간 이내)
    └── DB 중복 검사
    ↓
[통과] → Stage 2: 콘텐츠 추출 (content_extraction.py)
    ├── newspaper3k 기반 본문 추출
    ├── BeautifulSoup 기반 대체 추출
    ├── LLM 기반 HTML 분석
    └── LLM 기반 요약 생성
    ↓
[통과] → Stage 3: 분류 및 키워드 추출 (categorization.py)
    ├── LLM 기반 기사 분류
    ├── 주제별 카테고리 할당
    └── 키워드 추출
    ↓
[통과] → Stage 4: 콘텐츠 분석 (content_analysis.py)
    ├── 품질 분석
    ├── 불용어 필터링
    └── 유해 콘텐츠 검사
    ↓
[통과] → Stage 5: 임베딩 생성 (embedding_generator.py)
    ├── OpenAI 임베딩 생성
    └── 벡터 정규화
    ↓
[통과] → Stage 6: 최종 저장 (finalization.py)
    ├── 유사도 중복 검사 (Pinecone)
    ├── MongoDB 메인 DB 저장
    └── Pinecone 벡터 DB 저장
    ↓
완료
사용자 쿼리
    ↓
대화 기록 조회 (retrieve_from_chat_history)
    ↓
쿼리 재작성 (rewrite_query)
    ├── LLM 기반 쿼리 명확화
    └── 검색 최적화
    ↓
웹 검색 수행 (retrieve_web_chunks)
    ├── Google, DuckDuckGo 등 다중 소스 검색
    └── 최대 5개 결과 수집
    ↓
Meerkat 의료 모델 응답 (retrieve_meerkat_chunks)
    ├── 로컬 Meerkat-7B 모델 활용
    ├── 의료 전문가 역할 수행
    ↓
벡터 DB 검색 (retrieve_db_chunks)
    ├── Pinecone 기반 고급 검색
    ├── Dense Retrieval + Reranking
    └── 관련 문서 청크 추출
    ↓
통합 재순위화 (rerank_chunks)
    ├── Qwen3-Reranker로 모든 청크 점수화
    ├── 소스별 최고 점수 집계
    └── 관련성 순으로 재정렬
    ↓
최종 답변 생성 (generate_final_answer)
    ├── LLM 기반 통합 답변 생성
    ├── 출처 정보 포함
    └── 자연스러운 한국어 응답
    ↓
완료
`
src/sources/api_sources.txt 파일에서 다음 토큰들을 실제 값으로 교체:
https://api.thenewsapi.com/v1/news/top?api_token=<your-thenewsapi-token>&locale=kr
https://gnews.io/api/v4/top-headlines?token=<your-gnews-token>&lang=ko&country=kr
docker/docker-compose.yml 파일에서 MongoDB 비밀번호를 설정:
environment:
  - MONGO_INITDB_ROOT_PASSWORD=<your-mongo-password>
다음 서비스들의 API 키가 필요합니다:
OPENAI_API_KEY: OpenAI API 키OPENAI_RAG_MODEL: RAG 답변 생성용 모델 (기본값: gpt-4.1-nano)OPENAI_WEB_SEARCH_MODEL: 웹검색 답변 생성용 모델 (기본값: gpt-4.1-nano)OPENAI_ANALYSIS_MODEL: 정보 충족도 분석용 모델 (기본값: gpt-4.1-nano)PINECONE_API_KEY: Pinecone API 키SHARED_EMBEDDING_MODEL_NAME: 임베딩 모델명RERANKER_MODEL_NAME: Reranker 모델명 (기본값: Qwen/Qwen3-Reranker-0.6B)RERANKER_TOP_K: Reranker 선택 문서 수 (기본값: 3)DENSE_RETRIEVAL_TOP_K: Dense retrieval 검색 문서 수 (기본값: 5)AI 기반 정보 수집, 요약, 개인화 시스템 개발 프로젝트입니다.
LLM과 RAG(Retrieval-Augmented Generation) 구조를 활용하여 사용자가 원하는 정보를 빠르게 가공하고 전달하는 것을 목표로 합니다.
Aigen_science/
├── README.md
├── .gitignore
├── env.template                      # 환경 변수 템플릿
├── config/                           # 설정 파일들
│   └── config.yaml.template         # API 키, 모델 경로 등 설정 템플릿
├── data/                             # 수집된 데이터
│   └── data.txt                     # 데이터 파일
├── database/                         # 데이터베이스 스키마
│   ├── create_rag_tables.sql        # RAG 테이블 생성 스크립트
│   └── create_workspace.sql         # 워크스페이스 테이블 생성 스크립트
├── docker/                           # Docker 설정
│   ├── docker-compose.yml           # 멀티 컨테이너 설정
│   ├── Dockerfile                   # 각 서비스별 Dockerfile
│   ├── requirements-base.txt        # 기본 Python 패키지
│   ├── requirements-llm.txt         # LLM 관련 패키지
│   ├── requirements-rag.txt         # RAG 관련 패키지
│   └── requirements-web.txt         # 웹 관련 패키지
├── docs/                             # 문서
│   ├── DOCKER_OPTIMIZATION_README.md
│   ├── PDF_PROCESSOR_README.md
│   └── SIMPLE_NOTIFICATION_GUIDE.md
├── frontend/                         # Next.js 프론트엔드
│   ├── app/                         # App Router 페이지
│   ├── components/                  # React 컴포넌트
│   ├── lib/                         # 유틸리티 함수
│   ├── supabase/                    # 데이터베이스 스키마
│   └── package.json
├── logs/                             # 로그 파일
├── notebooks/                        # Jupyter 노트북
│   └── exploratory_analysis.ipynb
├── scripts/                          # 유틸리티 스크립트
│   ├── deploy.sh                    # 배포 스크립트
│   ├── fix_notification_query.js    # 알림 쿼리 수정 스크립트
│   ├── notification-system.service  # 알림 시스템 서비스
│   ├── start_notification_system.sh # 알림 시스템 시작 스크립트
│   └── upodate_embeddings.py        # 임베딩 업데이트 스크립트
├── src/                              # 핵심 소스 코드
│   ├── __init__.py
│   ├── celery_app.py                # Celery 애플리케이션 및 태스크 정의
│   ├── config_loader/               # 설정 로더
│   │   ├── __init__.py
│   │   ├── redis.py                 # Redis 설정
│   │   └── settings.py              # 환경 설정
│   ├── db/                          # 데이터베이스 인터페이스
│   │   └── vector_db.py             # Pinecone 벡터 DB 관리
│   ├── news_collector/              # 뉴스 수집기
│   │   ├── __init__.py
│   │   └── news_collector.py        # RSS, API 크롤러
│   ├── pipeline_stages/             # Celery 파이프라인 단계
│   │   ├── __init__.py
│   │   ├── initial_checks.py        # 1단계: 초기 유효성 검사
│   │   ├── content_extraction.py    # 2단계: 콘텐츠 추출 및 요약
│   │   ├── categorization.py        # 3단계: 기사 분류 및 키워드 추출
│   │   ├── content_analysis.py      # 4단계: 품질 분석
│   │   ├── embedding_generator.py   # 5단계: 임베딩 생성
│   │   ├── finalization.py          # 6단계: 최종 DB 저장
│   │   ├── data_extractor.py        # 데이터 추출 유틸리티
│   │   ├── intent_analyzer.py       # 의도 분석
│   │   └── dashboard_generator.py   # 대시보드 생성
│   ├── rag_graph/                   # RAG 워크플로우 (LangGraph)
│   │   ├── __init__.py
│   │   └── graph_rag.py             # RAG 그래프 정의
│   ├── services/                    # 비즈니스 로직 서비스
│   │   ├── __init__.py
│   │   ├── advanced_retrieval.py    # 고급 검색 서비스
│   │   ├── pdf_processor.py         # PDF 처리 서비스
│   │   └── web_search.py            # 웹검색 서비스
│   ├── app/                         # FastAPI 애플리케이션
│   │   ├── __init__.py
│   │   ├── news_recommendation.py   # 뉴스 추천 API
│   │   ├── news_article_api.py      # 기사 조회 API
│   │   ├── rag_api.py               # RAG 쿼리 API
│   │   ├── pdf_api.py               # PDF 처리 API
│   │   └── web_interface.py         # 웹 인터페이스
│   ├── api/                         # 테스트용 API 서버
│   │   ├── main.py                  # 간단한 쿼리 처리 API
│   │   └── Dockerfile               # API 서버용 Docker 설정
│   └── sources/                     # 외부 소스 설정
│       ├── api_sources.txt          # API 뉴스 소스 목록
│       └── rss_sources.txt          # RSS 뉴스 소스 목록
├── supabase/                        # Supabase 설정
│   ├── config.toml
│   ├── migrations/                  # 데이터베이스 마이그레이션
│   └── seed.sql
├── tests/                           # 테스트 코드
│   ├── main_test.py                 # 메인 테스트
│   ├── test_advanced_retrieval.py   # 고급 검색 테스트
│   ├── test_filter1.py              # 필터1 테스트
│   ├── test_langgraph.py            # LangGraph 테스트
│   ├── test_news_collector.py       # 뉴스 수집기 테스트
│   ├── test_news_system.py          # 뉴스 시스템 테스트
│   ├── test_news_system_production.py # 프로덕션 뉴스 시스템 테스트
│   ├── test_pdf_processor.py        # PDF 처리 테스트
│   ├── test_processor.py            # 프로세서 테스트
│   ├── test_processor_local.py      # 로컬 프로세서 테스트
│   ├── test_push_article.py         # 기사 푸시 테스트
│   └── test_simple_notification.py  # 알림 시스템 테스트
└── utils/                           # 유틸리티 스크립트
    ├── add_notification_query_column.py # 알림 쿼리 컬럼 추가
    ├── check_user_data.py           # 사용자 데이터 확인
    ├── install_gpu_driver.py        # GPU 드라이버 설치
    └── simple_notification_system.py # 간단한 알림 시스템
뉴스 소스 (RSS/API)
    ↓
뉴스 수집기 (news_collector.py)
    ↓
Stage 1: 초기 검사 (initial_checks.py)
    ├── URL 유효성 검사
    ├── 하드코딩된 URL 필터링
    ├── 발행 시간 검사 (24시간 이내)
    └── DB 중복 검사
    ↓
[통과] → Stage 2: 콘텐츠 추출 (content_extraction.py)
    ├── newspaper3k 기반 본문 추출
    ├── BeautifulSoup 기반 대체 추출
    ├── LLM 기반 HTML 분석
    └── LLM 기반 요약 생성
    ↓
[통과] → Stage 3: 분류 및 키워드 추출 (categorization.py)
    ├── LLM 기반 기사 분류
    ├── 주제별 카테고리 할당
    └── 키워드 추출
    ↓
[통과] → Stage 4: 콘텐츠 분석 (content_analysis.py)
    ├── 품질 분석
    ├── 불용어 필터링
    └── 유해 콘텐츠 검사
    ↓
[통과] → Stage 5: 임베딩 생성 (embedding_generator.py)
    ├── OpenAI 임베딩 생성
    └── 벡터 정규화
    ↓
[통과] → Stage 6: 최종 저장 (finalization.py)
    ├── 유사도 중복 검사 (Pinecone)
    ├── MongoDB 메인 DB 저장
    └── Pinecone 벡터 DB 저장
    ↓
완료
사용자 쿼리
    ↓
대화 기록 조회 (retrieve_from_chat_history)
    ↓
쿼리 재작성 (rewrite_query)
    ├── LLM 기반 쿼리 명확화
    └── 검색 최적화
    ↓
웹 검색 수행 (retrieve_web_chunks)
    ├── Google, DuckDuckGo 등 다중 소스 검색
    └── 최대 5개 결과 수집
    ↓
Meerkat 의료 모델 응답 (retrieve_meerkat_chunks)
    ├── 로컬 Meerkat-7B 모델 활용
    ├── 의료 전문가 역할 수행
    ↓
벡터 DB 검색 (retrieve_db_chunks)
    ├── Pinecone 기반 고급 검색
    ├── Dense Retrieval + Reranking
    └── 관련 문서 청크 추출
    ↓
통합 재순위화 (rerank_chunks)
    ├── Qwen3-Reranker로 모든 청크 점수화
    ├── 소스별 최고 점수 집계
    └── 관련성 순으로 재정렬
    ↓
최종 답변 생성 (generate_final_answer)
    ├── LLM 기반 통합 답변 생성
    ├── 출처 정보 포함
    └── 자연스러운 한국어 응답
    ↓
완료
`
src/sources/api_sources.txt 파일에서 다음 토큰들을 실제 값으로 교체:
https://api.thenewsapi.com/v1/news/top?api_token=<your-thenewsapi-token>&locale=kr
https://gnews.io/api/v4/top-headlines?token=<your-gnews-token>&lang=ko&country=kr
docker/docker-compose.yml 파일에서 MongoDB 비밀번호를 설정:
environment:
  - MONGO_INITDB_ROOT_PASSWORD=<your-mongo-password>
다음 서비스들의 API 키가 필요합니다:
OPENAI_API_KEY: OpenAI API 키OPENAI_RAG_MODEL: RAG 답변 생성용 모델 (기본값: gpt-4.1-nano)OPENAI_WEB_SEARCH_MODEL: 웹검색 답변 생성용 모델 (기본값: gpt-4.1-nano)OPENAI_ANALYSIS_MODEL: 정보 충족도 분석용 모델 (기본값: gpt-4.1-nano)PINECONE_API_KEY: Pinecone API 키SHARED_EMBEDDING_MODEL_NAME: 임베딩 모델명RERANKER_MODEL_NAME: Reranker 모델명 (기본값: Qwen/Qwen3-Reranker-0.6B)RERANKER_TOP_K: Reranker 선택 문서 수 (기본값: 3)DENSE_RETRIEVAL_TOP_K: Dense retrieval 검색 문서 수 (기본값: 5)


