
Multimodal chatbot with computer vision capabilities integrated, our 1st-gen LMM
Python
102
16 commits
updated May 17, 2024
README
SEEChat - 一见多模态对话模型
- “一见”取义自“百闻不如一见”,是一个侧重视觉能力的多模态对话大模型,基于单模态专家缝合路线(Single-modal Experts Efficient integration, SEEChat)。
- SEEChat项目的重点是将视觉能力与文本对话能力相集成,长期目标是赋予模型以文本/对话的方式解决视觉任务(图像理解,目标检测,跨模态,开放集)的能力
- “一见”多模态对话模型是SEEChat的开源版本,语言模型部分基于中文ChatGLM6B
- 2024-5-17:我们的新一代多模态模型更名为360VL,并在Github和Huggingface开源发布,地址:https://github.com/360CVGroup/360VL
能力展示
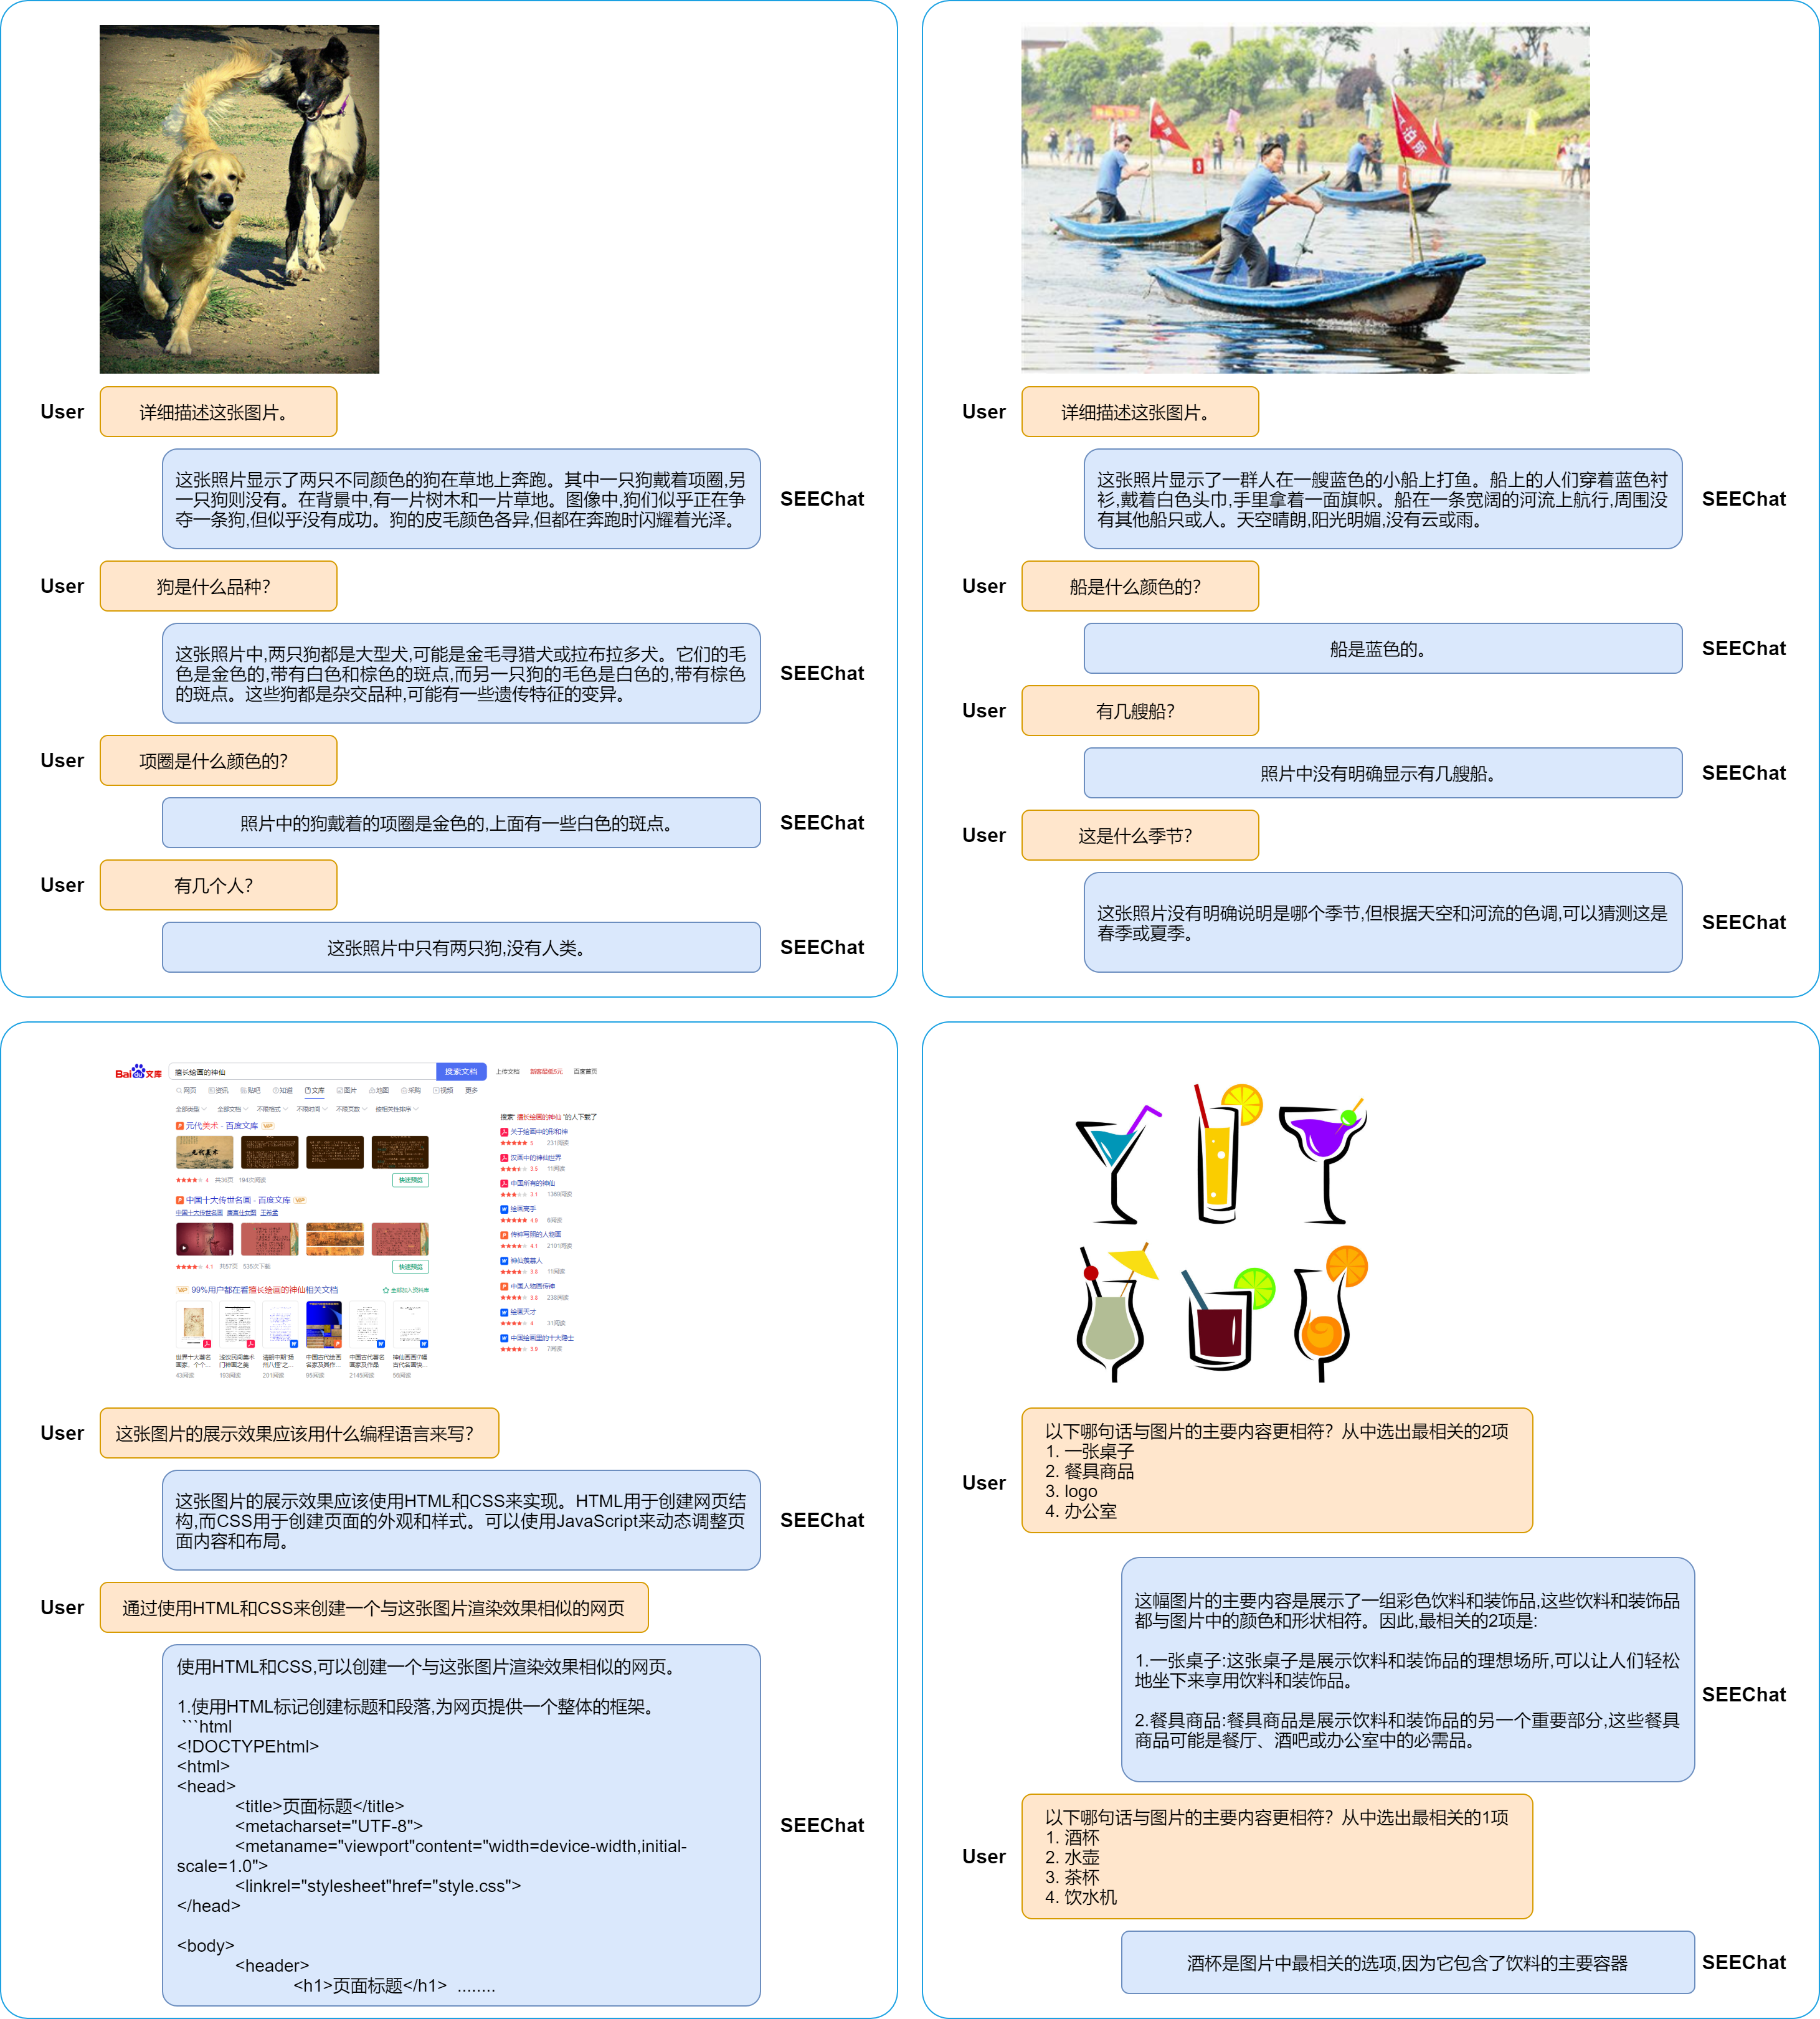
1. 多轮视觉问答、代码生成、目标分类
2. Image Captioning
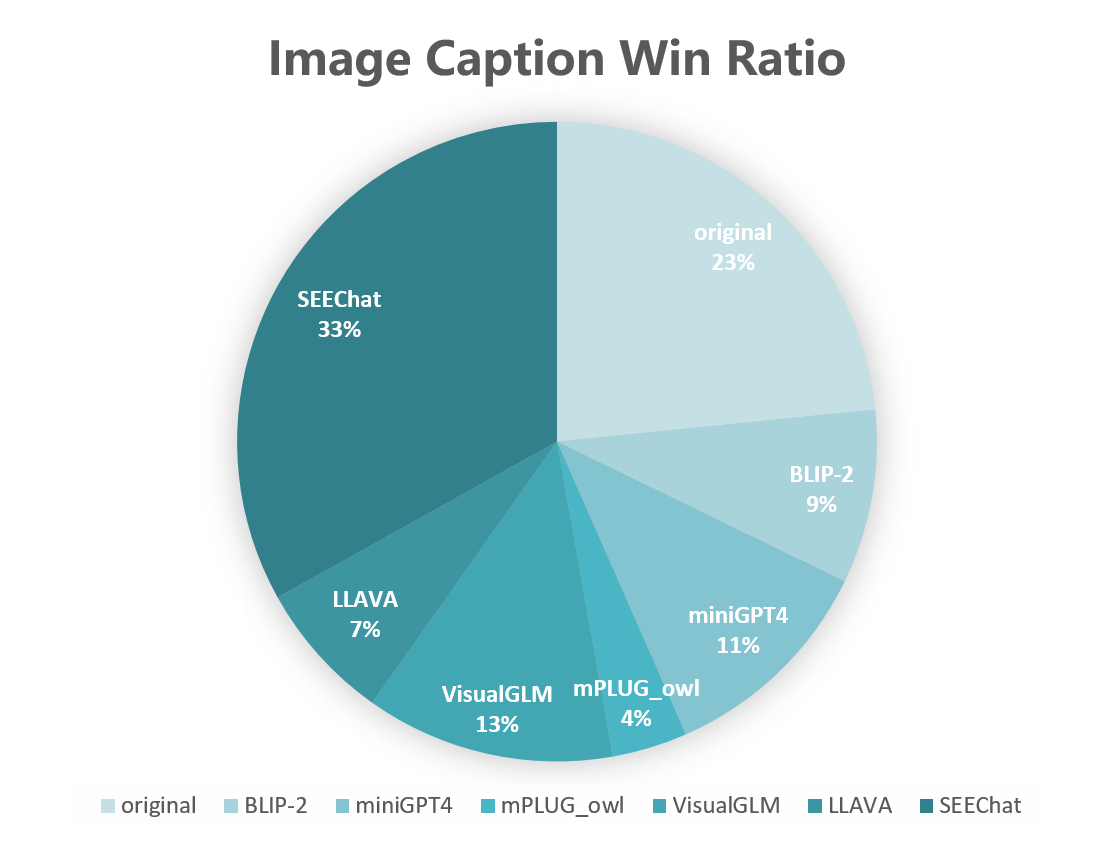
- 从中文Zero数据集中随机选取1000张中文互联网图像,已排除训练集数据
- 使用ChineseCLIP计算图文相关性得分
- 上图为七种公开方法(原生的互联网文本做为其中一种)的图文相关性得分胜出情况
- SEEChat胜出率甚至大比例超过原生文本
技术方案
SEEChat基于单模态专家缝合路线,通过可学习的桥接层将视觉模态的专家模型与文本模态的专家模型进行缝合,形成具备视觉理解能力的多模态对话模型。
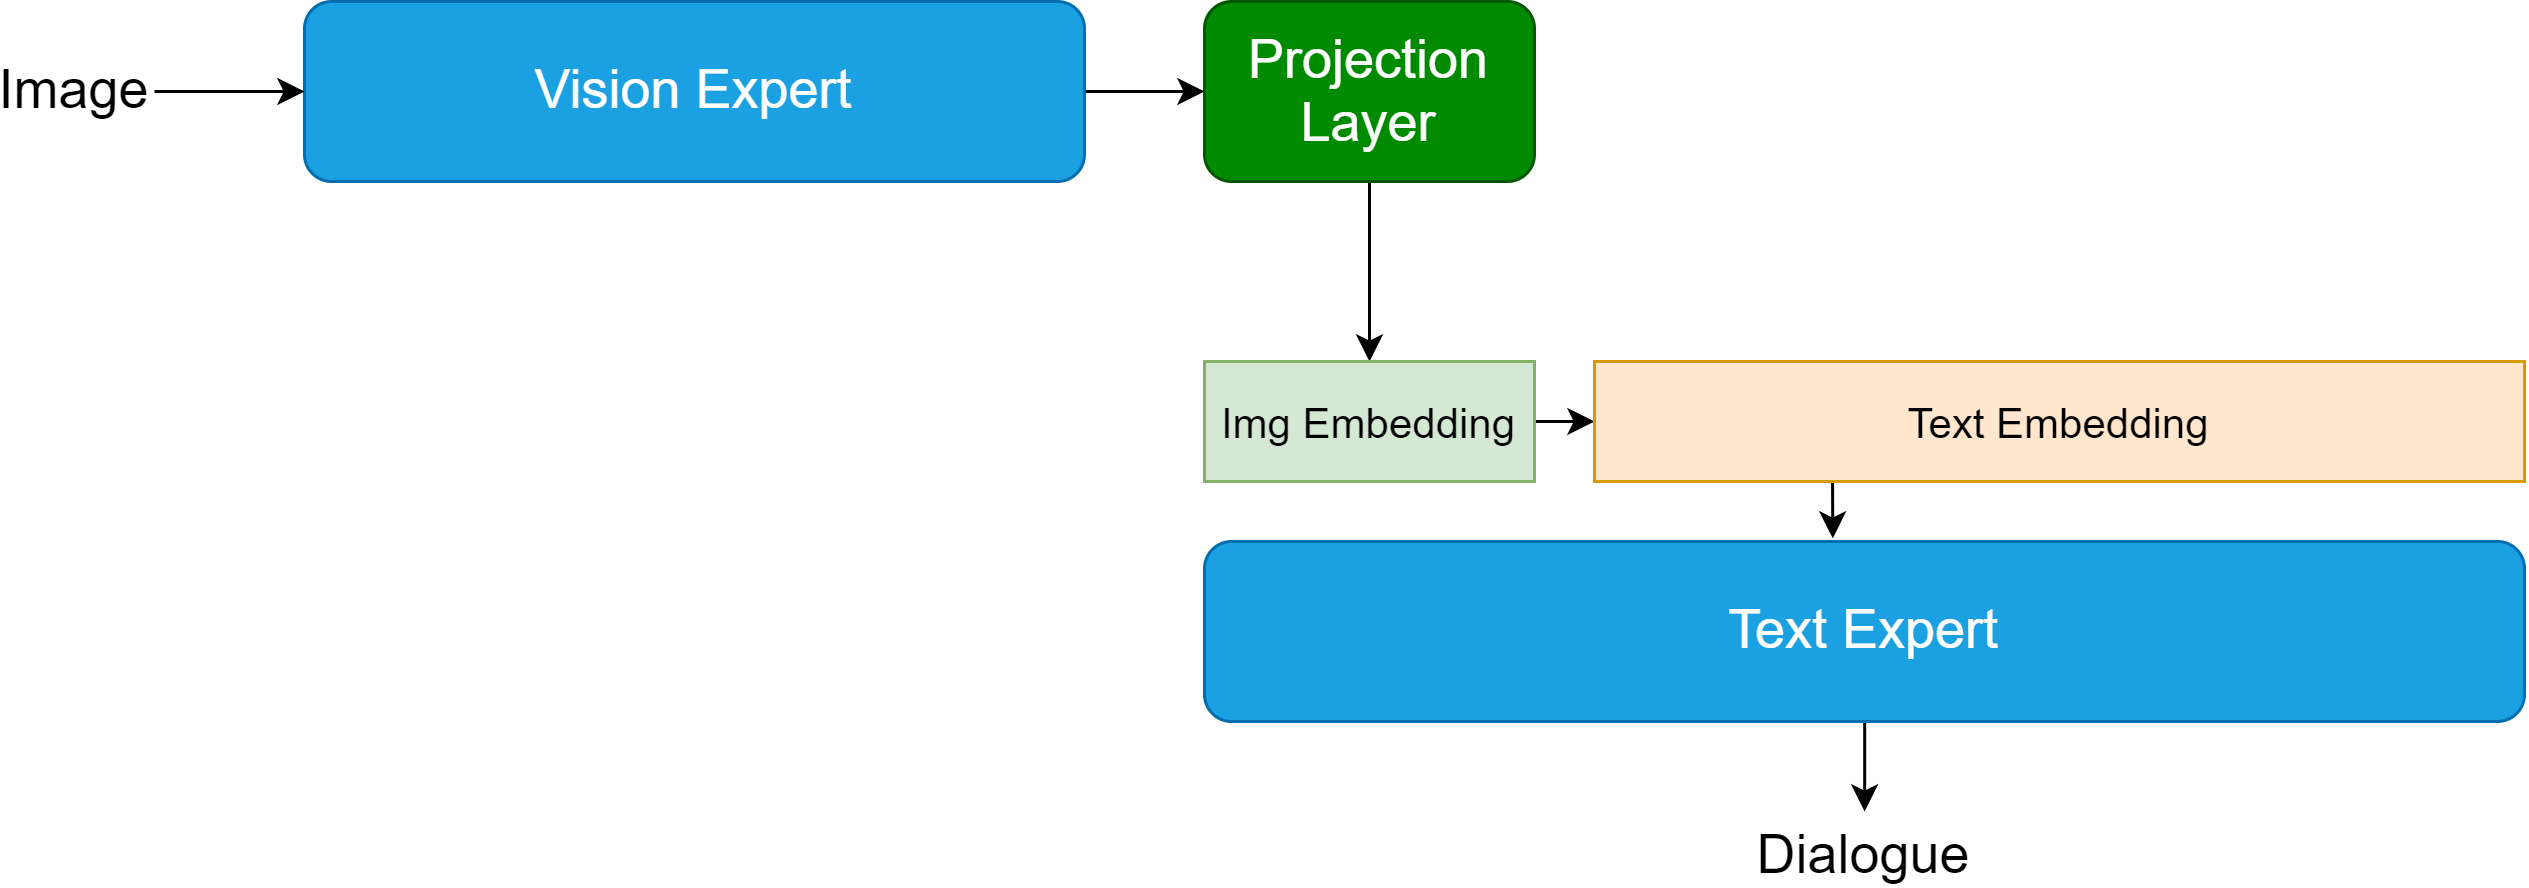
开源V1.0版本的SEEChat,视觉模态基于CLIP-ViT,文本模态基于ChatGLM,可学习的桥接层参考BLIP-2以及LLAVA等前期工作,进行如下的两阶段训练:
- Stage I 图文对齐: 使用360人工智能研究院开源的Zero数据集,共计2300万图文对桥接层进行训练
- Stage II 人机对齐:使用LLAVA开源的158K instruction数据经翻译后,对桥接层和语言模型部分进行微调
使用说明
硬件说明
GPU要求3090或者A100
环境安装
conda env create -f environment.yml
模型与数据
模型下载
从这里下载chatGLM所有的bin文件和ice_text.model,放于目录models/chatglm-6b中。
从百度云盘下载权重文件checkpoint_100.pth,放于目录models/chatglm-6b中。其中提取码为 qiho
运行推理脚本
进入到目录:
cd code
运行启动脚本:
sh demo_stage2.sh
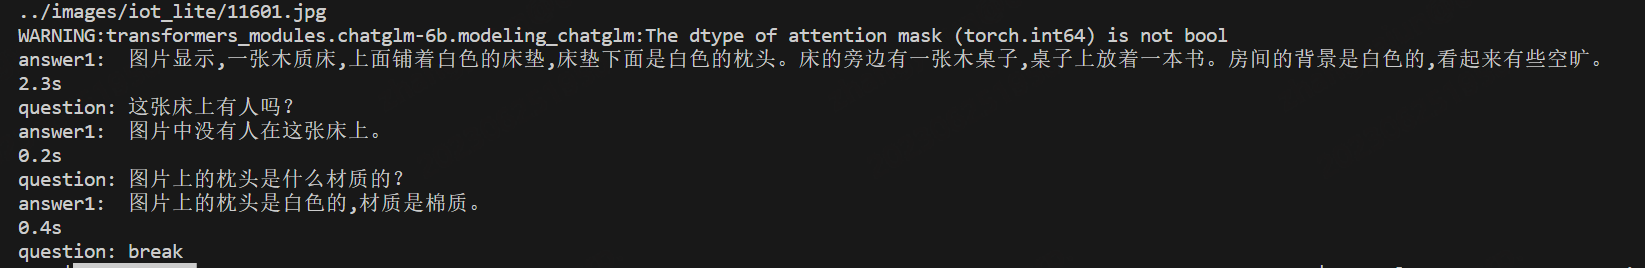
启动后,即将开始一轮对话。当命令行显示“question”时,用户可以在终端输入问题,由seechat回答。当输入“break”时,本轮对话结束,进行下一轮对话。
实测效果如下:
相关工作
中文
英文
Similar repos



Languages
Python
99.8%
Multimodal chatbot with computer vision capabilities integrated, our 1st-gen LMM
Python
102
16 commits
updated May 17, 2024
README
SEEChat - 一见多模态对话模型
- “一见”取义自“百闻不如一见”,是一个侧重视觉能力的多模态对话大模型,基于单模态专家缝合路线(Single-modal Experts Efficient integration, SEEChat)。
- SEEChat项目的重点是将视觉能力与文本对话能力相集成,长期目标是赋予模型以文本/对话的方式解决视觉任务(图像理解,目标检测,跨模态,开放集)的能力
- “一见”多模态对话模型是SEEChat的开源版本,语言模型部分基于中文ChatGLM6B
- 2024-5-17:我们的新一代多模态模型更名为360VL,并在Github和Huggingface开源发布,地址:https://github.com/360CVGroup/360VL
能力展示
1. 多轮视觉问答、代码生成、目标分类
2. Image Captioning
- 从中文Zero数据集中随机选取1000张中文互联网图像,已排除训练集数据
- 使用ChineseCLIP计算图文相关性得分
- 上图为七种公开方法(原生的互联网文本做为其中一种)的图文相关性得分胜出情况
- SEEChat胜出率甚至大比例超过原生文本
技术方案
SEEChat基于单模态专家缝合路线,通过可学习的桥接层将视觉模态的专家模型与文本模态的专家模型进行缝合,形成具备视觉理解能力的多模态对话模型。
开源V1.0版本的SEEChat,视觉模态基于CLIP-ViT,文本模态基于ChatGLM,可学习的桥接层参考BLIP-2以及LLAVA等前期工作,进行如下的两阶段训练:
- Stage I 图文对齐: 使用360人工智能研究院开源的Zero数据集,共计2300万图文对桥接层进行训练
- Stage II 人机对齐:使用LLAVA开源的158K instruction数据经翻译后,对桥接层和语言模型部分进行微调
使用说明
硬件说明
GPU要求3090或者A100
环境安装
conda env create -f environment.yml
模型与数据
模型下载
从这里下载chatGLM所有的bin文件和ice_text.model,放于目录models/chatglm-6b中。
从百度云盘下载权重文件checkpoint_100.pth,放于目录models/chatglm-6b中。其中提取码为 qiho
运行推理脚本
进入到目录:
cd code
运行启动脚本:
sh demo_stage2.sh
启动后,即将开始一轮对话。当命令行显示“question”时,用户可以在终端输入问题,由seechat回答。当输入“break”时,本轮对话结束,进行下一轮对话。
实测效果如下:
相关工作
中文
英文
Similar repos
Languages
Python
99.8%